Pruebas inestables: cuatro causas y sus pruebas
Atribuya una prueba inestable a estado compartido, tiempos, red o deriva de entorno con el artefacto que los separa, y haga que los reintentos registren en lugar de ocultar.
BotBrowser Team
Quieres la documentación estructurada de Documentación?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Una prueba inestable no es una prueba que falla a veces; es una prueba cuya falla todavía no ha atribuido. Reintentar hasta que pase produce una ejecución en verde y destruye la evidencia que habría dicho cuál de las cuatro causas estaba actuando. BotBrowser documenta el aislamiento de almacenamiento por lanzamiento y por contexto, que elimina un mecanismo detrás de la causa de estado compartido en lugar de la causa en general. No corrige causas de tiempos, de red ni de diseño de prueba, y no vuelve determinista una suite por sí solo.
Resumen
- Capture el primer intento fallido antes de cualquier reintento. Un reintento que lo sobrescribe ha eliminado la única evidencia que tenía.
- Atribuya la falla a una de cuatro causas: estado de navegador compartido, tiempos, red o deriva de entorno. Cada una deja un artefacto distinto.
- Dos fallas con la misma firma son una observación reproducible. Acota la causa pero no prueba que la falla no sea intermitente.
- Mantenga los reintentos como dispositivo de registro. Registre cada intento, luego corrija la causa y quite el reintento de esa prueba.
- BotBrowser elimina un mecanismo de estado compartido al aislar el almacenamiento por contexto o por lanzamiento. No corrige las otras tres causas.
Contenido
- Cuatro causas y el artefacto de cada una
- Por qué un reintento borra la evidencia
- Una política de reintentos que registra
- Una lista de aislamiento de estado
- Conclusión práctica
Cuatro causas y el artefacto de cada una
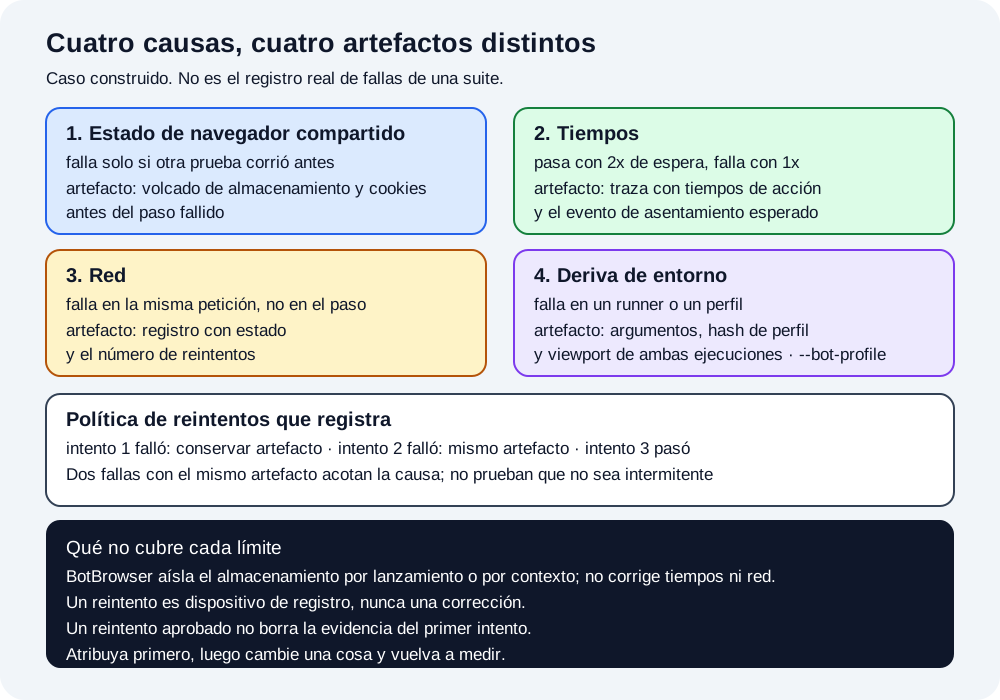
La primera pregunta útil no es «cuántas veces falla» sino «qué aspecto tiene la falla cuando ocurre». Cada una de las cuatro causas deja una firma, y cada firma necesita un artefacto concreto para confirmarse. Un artefacto propone una hipótesis; confirmarla exige una comparación de control, y recoger el artefacto equivocado produce una atribución segura y errónea.
| Causa | Firma | Artefacto que la confirma |
|---|---|---|
| Estado compartido | Falla solo cuando otra prueba se ejecutó antes | Volcado de almacenamiento, cookies y caché antes del paso |
| Tiempos | Pasa con un tiempo de espera mayor, falla con el normal | Traza con tiempos de acción y el evento esperado |
| Red | Falla en la misma petición, no en el mismo paso | Registro de peticiones con estados y número de reintentos |
| Deriva de entorno | Falla solo en un runner, perfil o viewport | Argumentos de lanzamiento, hash de perfil y viewport de ambas ejecuciones |
La causa de estado es la que una suite de navegador menos reporta, porque el artefacto es invisible en el mensaje de falla. La práctica de higiene de datos de prueba y estado del navegador cubre cómo evitar que ese estado se acumule. Una prueba que falla solo después de que otra se ejecutó suele fallar en una aserción sobre contenido, y el mensaje apunta a la aserción y no al almacenamiento sobrante. Volcar almacenamiento y cookies justo antes del paso fallido es lo que convierte eso en una atribución.
La causa de tiempos es la que más se «corrige» sin diagnosticar, y el análisis de esperas y pruebas estables cubre qué está esperando una espera correcta. Una prueba que pasa con un tiempo mayor ha demostrado que la espera era demasiado corta, lo cual es evidencia útil y no una reparación. La traza muestra si el elemento apareció tarde, si la red fue lenta o si la acción se disparó antes de que la página se asentara, y esas tres respuestas llevan a correcciones distintas.
La causa de red y la de tiempos se confunden fácilmente porque ambas aparecen como «el elemento no estaba». La distinción es que una causa de red se reproduce en la misma petición, mientras una de tiempos se reproduce en el mismo paso con una petición distinta. Registrar el estado de la petición y el número de reintentos las separa sin adivinar.
La causa de entorno es la que parece un fallo del framework. Una prueba que falla en un runner y pasa en otro suele fallar porque las dos ejecuciones tenían argumentos de lanzamiento, valores de perfil o viewport distintos. Registrar los tres para ambas ejecuciones es barato, y es el artefacto que hace posible la comparación.
Una quinta firma merece una nota porque a menudo se lee como una de las cuatro: la prueba depende de datos que cambian con el tiempo. Una aserción de precio contra un literal, una aserción de fecha que asume hoy o una aserción de lista que asume un número fijo fallan con calendario en lugar de intermitentemente. El artefacto son los datos de entrada y su marca temporal, y la corrección pertenece al fixture y no al navegador. Tratarla como causa de estado o de tiempos lleva a reintentos que pasan unos días y fallan otros, el resultado más caro posible.
El orden de investigación importa tanto como la tabla. Empiece por la causa más barata de descartar y de corregir, que casi siempre es el estado, porque un contexto nuevo reproduce la falla o no. Luego revise el entorno, porque comparar dos configuraciones de lanzamiento registradas es un diff y no un experimento. Tiempos y red van al final, porque diagnosticar cualquiera requiere una traza y un registro de peticiones que cuestan tiempo real.
También hay un punto de higiene que se aplica a las cuatro. Un artefacto solo sirve si se capturó en el momento de la falla y no se reconstruyó después. Una captura tomada cuando el framework ya navegó lejos, un volcado tomado después de que corriera el hook de limpieza o un registro filtrado solo a errores parecerán artefactos sin contener la evidencia. Capture en el hook de falla, antes de cualquier teardown, y registre qué hook produjo el artefacto.
Por qué un reintento borra la evidencia
Playwright documenta los reintentos como una función del runner que vuelve a ejecutar pruebas fallidas, y documenta fixtures y ejecución en paralelo como funciones separadas con sus propias reglas de alcance. Ninguno de esos documentos afirma que los reintentos vuelvan fiable una suite. La función vuelve a ejecutar una prueba; lo que ocurre con la evidencia del primer intento depende por completo de cómo esté configurada la suite para registrarla.
El modo de fallo por defecto es sutil, y se ve en un campo: status=passed con retries=1. Playwright informa una prueba reintentada que acaba pasando como flaky, con testInfo.status igual a passed, así que un informe que solo lee el campo de estado final ve un aprobado y nada más. El problema mayor es que el primer intento a menudo no tiene traza alguna: el valor por defecto trace: 'off' no registra nada, y on-first-retry empieza a registrar solo cuando arranca un reintento. El artefacto falta en vez de estar sobrescrito, salvo que una ruta de salida personalizada reutilice un mismo nombre de archivo entre intentos.
Por eso un reintento es un dispositivo de registro y no una corrección. Bien usado, dice qué pruebas son inestables y da una segunda observación de la misma falla. Mal usado, convierte un defecto real en una compilación verde y traslada el descubrimiento a producción, donde el artefacto ya no existe.
También hay una trampa estadística. Una prueba que falla en una de cada diez ejecuciones pasará un reintento único nueve de cada diez veces, así que una suite con reintentos parece mucho más estable de lo que es. La tasa de falla no ha cambiado; solo el reporte. Dos fallas seguidas con la misma firma es la señal más fuerte disponible, pero sigue siendo una hipótesis: una causa de red puede producir la misma firma dos veces y seguir siendo intermitente, así que la atribución necesita una comparación de control.
Una política de reintentos que registra
Una política que registra es pequeña: conservar cada intento, nombrar el artefacto por intento y negarse a resumir la primera falla hasta hacerla desaparecer. El constructor siguiente es un caso construido que muestra qué debería contener el registro.
// Constructed fixture: three attempts of one test, two failures with a matching artifact prefix.
const attempts = [
  { n: 1, status: 'failed', artifact: 'storage-dump:t1.json', at: '2026-11-10T09:00:12Z' },
  { n: 2, status: 'failed', artifact: 'storage-dump:t2.json', at: '2026-11-10T09:00:48Z' },
  { n: 3, status: 'passed', artifact: 'trace:t3.zip', at: '2026-11-10T09:01:30Z' },
];

const failures = attempts.filter(a => a.status === 'failed');
const sameArtifact = failures.length > 1 && failures[0].artifact.split(':')[0] === failures[1].artifact.split(':')[0];
const verdict = sameArtifact ? 'repeated_signature' : failures.length ? 'single_failure' : 'clean';

const lines = [
  `attempts=${attempts.length} failures=${failures.length}`,
  ...attempts.map(a => `attempt=${a.n} status=${a.status} artifact=${a.artifact} at=${a.at}`),
  `verdict=${verdict}`,
];
console.log(lines.join('\n'));
La salida construida es el punto: el tercer intento pasó, y el registro sigue diciendo que la firma se repitió.
attempts=3 failures=2
attempt=1 status=failed artifact=storage-dump:t1.json at=2026-11-10T09:00:12Z
attempt=2 status=failed artifact=storage-dump:t2.json at=2026-11-10T09:00:48Z
attempt=3 status=passed artifact=trace:t3.zip at=2026-11-10T09:01:30Z
verdict=repeated_signature
Tres reglas hacen que la política funcione en la práctica. Nombre el artefacto por causa y no por archivo, para que storage-dump y trace se distingan a simple vista. Mantenga los intentos en orden con sus marcas temporales, para que un revisor vea si la falla fue inmediata o tardía. Y haga del veredicto un campo derivado y no un juicio humano, para que el informe no pueda llamar en silencio inestable a una falla repetida.
Dos reglas más pertenecen al informe y no al constructor. Primero, publique el recuento de fallas junto al de aprobaciones, porque una suite que solo informa estados finales oculta las fallas que se reintentaron hasta desaparecer. Segundo, guarde el artefacto de cada intento y no solo del último, porque el primer intento corrió antes de cualquier limpieza propia del reintento, y una suite que limpia estado en un hook de reintento ya cambió las condiciones que produjeron la falla.
El alcance del reintento es una tercera consideración. Un reintento a nivel de prueba da observaciones repetidas de una prueba; un reintento a nivel de archivo solo reejecuta las pruebas fallidas, mientras que un reintento configurado para un grupo serial reejecuta todo el grupo, incluidas las pruebas que no fallaron, lo que cambia qué pruebas comparten estado y puede convertir el segundo intento en un experimento distinto. Playwright también documenta el reintento por grupo o por grupo serial, donde todas las pruebas del grupo se reintentan juntas, así que el segundo intento ejecuta otro conjunto de pruebas. Prefiera el alcance más estrecho que reproduzca la falla, y registre el alcance en el registro del intento para que un lector posterior sepa qué se reejecutó realmente.
Una política de reintentos también necesita un responsable y una condición de salida. El responsable es quien puede corregir la causa, y la condición de salida es una fecha antes de la cual el reintento debe quitarse o la prueba ponerse en cuarentena. Sin ambos, un reintento añadido durante un incidente se vuelve infraestructura permanente que nadie revisa, y la suite se llena lentamente de pruebas cuyo estado real se desconoce.
La cuarentena es la alternativa honesta a reintentar para siempre. Sacar una prueba sabidamente rota del conjunto obligatorio, con su artefacto adjunto y un responsable nombrado, mantiene intacta la señal de la suite mientras se investiga la causa. Es una falla visible y no oculta, y las fallas visibles se corrigen.
La política también necesita una regla de parada. Si dos intentos fallan con la misma firma, deje de reintentar y cambie una variable: la firma es reproducible, así que otro intento con la misma configuración no añade información. El siguiente paso es la comparación de control de la tabla, no un tercer reintento. Seguir reintentando después de ese punto gasta tiempo produciendo evidencia que ya existe, y empuja la suite hacia el estado verde por reintento que la política existe para evitar.
Una lista de aislamiento de estado
La causa de estado merece revisarse primero porque es la más barata de eliminar y la más fácil de confundir con otra cosa. Cada elemento produce una observación y no una creencia, así que la lista puede ejecutarse antes de diagnosticar las otras tres causas.
| Comprobación | Observación que produce |
|---|---|
| Contexto nuevo por prueba | Si la falla sobrevive a un contexto vacío |
| Almacenamiento limpiado antes de navegar | Si importaba el almacenamiento local o de sesión sobrante |
| Cookies limpiadas, no solo expiradas | Si una cookie persistida cambió el resultado |
| Sin perfil compartido entre workers | Si dos workers escribieron en un mismo perfil |
| Viewport y valores de dispositivo fijos | Si diferencias de diseño cambiaron el resultado |
| Argumentos de lanzamiento registrados | Si dos ejecuciones estaban configuradas igual |
El modelo de fixtures y aislamiento describe el alcance que hace práctico un contexto nuevo por prueba. La primera fila es la decisiva. Si una prueba falla en un contexto compartido y pasa en uno nuevo, la causa es estado, y ningún ajuste de tiempo de espera la resolverá. Si falla en ambos, la causa de estado es improbable y las dos siguientes merecen el esfuerzo.
La cuarta fila es la que la ejecución en paralelo vuelve urgente. Playwright documenta la ejecución en paralelo como pruebas en workers separados, y un worker que reutiliza un perfil entre pruebas puede dejar estado para la siguiente prueba de ese worker mientras deja limpios los demás. El resultado es un patrón de falla que parece aleatorio por número de worker y no por prueba.
La reutilización de worker produce una segunda señal más sutil: la falla se mueve. Si la misma prueba pasa en serie y falla solo en paralelo, y la aserción fallida cambia entre ejecuciones, la causa es casi con certeza estado compartido cruzando un límite de worker. Registrar el identificador de worker con cada intento convierte eso de sospecha en patrón, porque los intentos fallidos se agruparán en un worker en lugar de repartirse.
Limpiar el almacenamiento no es lo mismo que limpiar cookies, y ninguna de las dos es lo mismo que iniciar un contexto nuevo. Almacenamiento local, almacenamiento de sesión, IndexedDB, la caché del service worker y la caché HTTP sobreviven a reinicios distintos, y una prueba que depende de uno seguirá fallando después de limpiar los demás. El reinicio completo más barato es un contexto de navegador nuevo por prueba, que es también la observación que produce la primera fila de la lista.
Los service workers merecen su propia línea porque sobreviven a una recarga y pueden servir una respuesta obsoleta mucho después del almacenamiento que la prueba cree haber limpiado. Una prueba que falla en la primera ejecución tras un despliegue y pasa después suele estar leyendo una respuesta en caché de un worker registrado por una prueba anterior. Registrar si había un service worker registrado en el momento de la falla es el artefacto que separa esto de una causa de red.
El último elemento de la lista es el que hace reproducibles los otros cinco. Dos ejecuciones con argumentos distintos no son el mismo experimento, y una falla que aparece solo en una puede ser una diferencia de configuración y no de código. Registrar argumentos, hash de perfil y viewport juntos da al revisor una sola cadena comparable, y comparar dos de esas cadenas es un diff y no un debate.
La documentación de gestión de perfiles de BotBrowser indica que cada lanzamiento usa su propio user-data-dir, cookies y ajustes de sesión, y que dentro de un proceso el almacenamiento, las cookies y los ajustes del contexto se aíslan por BrowserContext. Su documentación de configuración de perfiles enumera las entradas de entorno que un perfil lleva, como configuración regional, zona horaria, pantalla y WebGL. Juntas eliminan un mecanismo de estado entre pruebas: un contexto o un lanzamiento nuevo no puede heredar el almacenamiento de la prueba anterior. Eso es más estrecho que eliminar la causa de estado en general, y no dice nada sobre tiempos, red ni diseño de prueba, así que una suite con un problema de tiempos sigue siendo inestable con un perfil perfecto.
Preguntas frecuentes
¿Una prueba que pasa al reintentar es una prueba inestable?
Es una prueba con una falla no atribuida. El reintento cambió el resultado, no la causa. Guarde el artefacto del primer intento y atribuya la falla antes de decidir que la prueba está sana.
¿Puedo eliminar la inestabilidad aumentando tiempos de espera?
Solo si la causa es de tiempos, y solo después de que la traza muestre que la espera era el factor limitante. Aumentar un tiempo de espera por una causa de estado o de red oculta la falla durante más tiempo sin cambiarla.
¿Por qué una prueba falla solo en un runner?
Esa firma apunta a deriva de entorno: argumentos de lanzamiento, perfil o viewport distintos. Registre los tres en ambas ejecuciones y compárelos antes de buscar un fallo del framework.
¿BotBrowser vuelve determinista una suite inestable?
No. Documenta el aislamiento de almacenamiento por lanzamiento y por contexto, que elimina un mecanismo detrás de la causa de estado compartido. Las causas de tiempos, red y diseño de prueba permanecen, y ninguna configuración de navegador vuelve determinista una suite por sí sola.
Fuentes
- Reintentos en Playwright
- Fixtures de Playwright
- Ejecución en paralelo de Playwright
- Gestión de perfiles de BotBrowser
- Configuración de perfiles de BotBrowser
- Consistencia de automatización en BotBrowser
Conclusión práctica
Capture el primer intento fallido antes de cualquier reintento, atribuya la falla a estado, tiempos, red o entorno usando el artefacto que los separa, y solo entonces cambie una cosa. Mantenga los reintentos como dispositivo de registro: cada intento con su artefacto y marca temporal, un veredicto derivado y una regla de parada cuando dos intentos fallen igual. Pruebe primero el mecanismo de estado compartido porque es el más barato de comprobar, y recuerde que el aislamiento de almacenamiento por contexto aborda solo ese mecanismo.
Artículos Relacionados
Selenium Grid: por qué dos nodos discrepan
ComparaciónProtección del motor frente a la API: una prueba reproducible
Primeros pasosCiclo de vida y almacenamiento de BrowserContext en Playwright
Huella digitalQué prueban realmente las suites de detección públicas
Primeros pasosPruebas limpias de carga y descarga en la automatización del navegador
IdentidadHigiene de datos y estado en pruebas de automatización del navegador
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.