Reglas de capa de red que una página no puede evaluar
Un conjunto público reparte 126 reglas: 95 que una página puede comprobar y 31 que necesitan la red. Los apretones reales muestran dónde viven las más pesadas.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
BotBrowser mantiene un perfil declarado coherente en las superficies que una página puede leer y puede guardar un registro acotado de lo que la página reportó, y no controla directamente el apretón de manos TLS, la trama de ajustes de HTTP/2 ni la dirección que un proxy presenta en el extremo remoto de una conexión. Este análisis lee un conjunto público de reglas como datos, separa sus reglas por la capa que cada una necesita y luego mide esos hechos de conexión en apretones reales, de modo que la separación se apoya en bytes observados y no en una suposición sobre lo que ve una red.
Resumen
- El conjunto tiene 126 reglas. Una página puede evaluar 95; las otras 31 necesitan un hecho que nunca llega a la página.
- Las 31 reglas de red leen al menos un valor fuera de la página, y 25 de ellas no leen nada más.
- Ese subconjunto son 23 reglas de coherencia, 4 de reputación, 3 de automatización y 1 de artefacto, repartidas en la capa de red 28 veces, la capa de navegador 14 veces y la de reputación 4 veces.
- Solo 6 de las 31 comparan un valor de página con un valor de red, y son las que una página puede responder a medias: aporta un lado y no tiene nada para el otro.
- Toda regla de red pesa al menos 0.5. Cuatro están en 0.85 o más, 8 entre 0.7 y 0.84, y 19 entre 0.5 y 0.69.
- Las tres más pesadas comparten peso 0.9 y las tres describen comportamiento de tramas HTTP/2, que ningún script de página puede leer.
- Dos apretones que solo difieren en la lista de protocolos producen
alpn=h2yalpn=http/1.1sobre la misma versión TLS 1.3, el mismo cifrado y el mismo grupo de intercambio de claves. - Una trama de ajustes con ventana inicial 1048576 y trama máxima 32768 llega como un registro de 18 bytes que el par lee directamente; la página que la envió no puede leer ninguno de los dos números.
- El lado servidor de una conexión real reportó ventana inicial 65536, trama máxima 16777215 y 256 flujos concurrentes, todo visible para la pila de red del cliente y para ningún script de la página.
- Un informe del lado de la página puede describir el entorno que expone, y no puede falsificar una regla cuyas entradas nunca ve.
Contenido
- Dónde se separa el conjunto de reglas
- Qué seis reglas se responden a medias
- Qué pone un apretón real en el cable
- Por qué las reglas más pesadas quedan al otro lado
- En qué se diferencia leer un hallazgo de red
- Registrar una lectura
Dónde se separa el conjunto de reglas
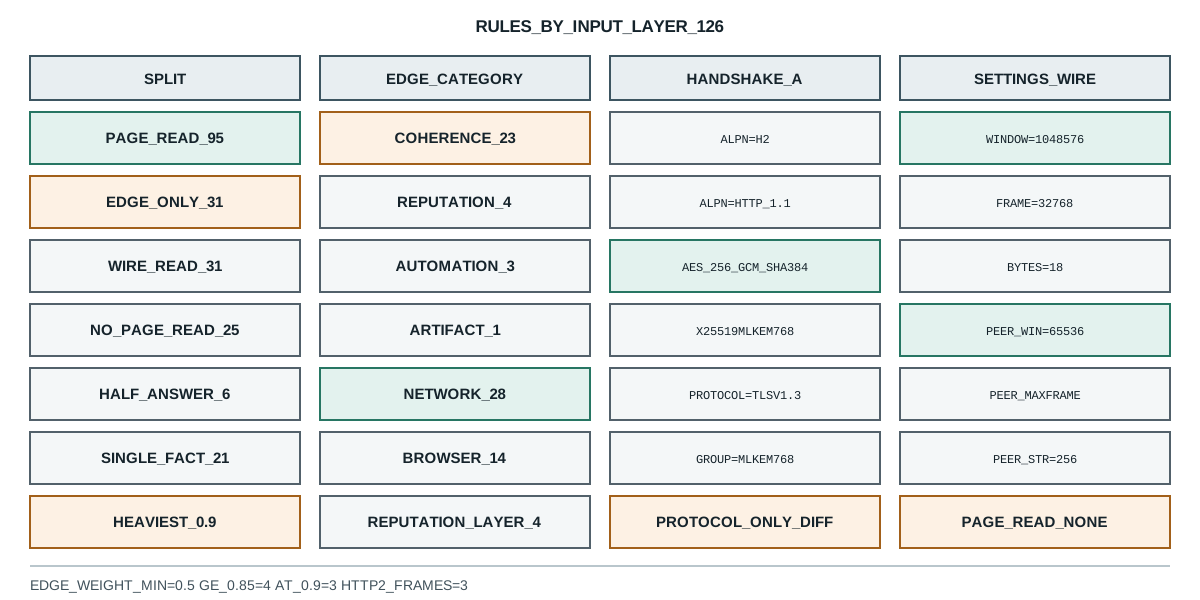
Un conjunto de reglas es una lista de afirmaciones, y cada afirmación nombra los valores que lee. La separación que importa aquí no es la categoría ni el peso, sino dónde viven esos valores. La sonda lee el conjunto publicado como datos y ordena cada regla según si un script dentro de la página podría leer las mismas entradas:
node=v26.9.0
ruleset=0.74.49 rules=126 digest=cf896731d6c894fb38266206bc121db1f235f536ffbf334aa2c0da7468cc0e59
split -> page_evaluable=95 edge_only=31
edge_categories -> coherence=23 reputation=4 automation=3 artifact=1
edge_layers -> network=28 browser=14 reputation=4
edge_rules_with_a_wire_only_read -> 31 of 31
every_edge_rule_needs_the_wire -> true
edge_rules_with_no_page_read_at_all -> 25
La primera línea de la separación decide cuánto de un detector puede razonar una página. Noventa y cinco reglas leen valores que existen en el documento: la cadena de agente de usuario, la lista de idiomas, la geometría de pantalla, la zona horaria, la forma de una función nativa. Una página que quiera saber qué dirán esas reglas puede leer los mismos valores y calcular la misma respuesta.
Las otras 31 leen otra cosa. Los recuentos por capa suman más de 31 porque una regla puede abarcar varias capas, y los recuentos por categoría muestran dónde se agrupan: coherencia con 23 es la mayor con diferencia, lo que encaja con el nombre, porque una regla de coherencia existe para comparar dos fuentes que deberían coincidir. Reputación con 4 pregunta si la dirección o la red pertenece a un rango de alojamiento o a una salida de proxy conocida. Automatización con 3 y artefacto con 1 completan el conjunto.
La línea que sostiene el argumento es every_edge_rule_needs_the_wire -> true. Cada una de las 31 nombra al menos una entrada que no es un valor de página, así que ninguna puede decidirse desde dentro del documento. La línea siguiente lo estrecha más: 25 de las 31 no leen nada que no sea de red. Para esas, una página no es un testigo parcial; no es testigo en absoluto. No hay consulta del lado de la página que devuelva el mismo número, ni propiedad cuya ausencia sustituya al valor faltante, ni aritmética que lo recupere.
Esa distinción separa dos tipos de informe que se parecen en la superficie. Un escaneo del lado de la página produce una lista de hallazgos sobre superficies que pudo alcanzar, y una comprobación del lado de la red produce hallazgos sobre una conexión. Cuando ambos se funden en una sola puntuación, la fusión oculta qué mitad produjo cada hallazgo, y quien lee no puede saber si un resultado limpio significa que la página era coherente o que la conexión nunca se examinó. La coherencia de capa de red y navegador nombra las capas que expone una sesión, y la huella de información de red muestra a cuáles llega una página por sí sola. Un catálogo público de suites muestra la misma brecha desde fuera: qué prueban realmente las suites de detección públicas cuenta cuántas de sus pruebas publicadas nombran la conexión.
Qué seis reglas se responden a medias
Seis de las 31 emparejan un valor de página con un valor de red. Son los casos interesantes, porque una página aporta la mitad de la comparación y no tiene nada para la otra mitad:
| Peso | Lado de la página | Lado de la red |
|---|---|---|
| 0.85 | browser.webrtc_public_ip | network.observed_ip |
| 0.7 | browser.ua_browser | network.ja4_browser_hint |
| 0.6 | browser.ua_browser | network.h2_browser_hint |
| 0.6 | browser.ua_platform | network.ch_platform_header |
| 0.6 | browser.ua_browser | network.ch_ua_browser |
| 0.55 | browser.nav_language_primary | network.accept_language_primary |
La sonda imprime la forma de la más pesada de ellas directamente:
cross_layer -> weight=0.85 net.webrtc_ip_vs_observed page=browser.webrtc_public_ip wire=network.observed_ip
page_side_view -> net.webrtc_ip_vs_observed page_reads=1 wire_reads=1
page_side_view -> predicate=not_equal needs_both_sides=true
page_side_view -> a page can supply browser.webrtc_public_ip and nothing for network.observed_ip
El predicado es not_equal, y eso es lo que hace difícil responder el par desde dentro de la página. Una página puede leer la dirección que reporta su propio proceso de recolección ICE, y una implementación de WebRTC que devuelve una dirección pública devuelve un valor que la página puede comparar con lo que sepa. Lo que la página no puede leer es la dirección que el extremo receptor observó para la misma conexión, porque ese valor existe solo en el extremo remoto. Una página que compara su dirección WebRTC con su propia idea de su dirección compara un valor local con otro valor local, y esa comparación no es la regla.
La misma estructura se mantiene en las otras cinco. Una página lee su propio agente de usuario, y no puede leer la familia de navegador que implicó un apretón TLS. Una página lee navigator.language, y no puede leer el idioma primario de la cabecera Accept-Language que envió la pila de red. Una página lee la cadena de plataforma, y no puede leer la cabecera de plataforma de client hints. En cada caso el valor de página es real y el valor de red es real, y solo uno de ellos es alcanzable desde un script.
Hay una segunda consecuencia fácil de pasar por alto. Como la regla necesita ambos lados, una página no puede siquiera saber si la regla se dispararía. Puede calcular su mitad y detenerse. Un despliegue que cambia una superficie de página para coincidir con un perfil objetivo ha cambiado una entrada de una comparación de dos entradas, y si la comparación ahora coincide depende de un hecho que el despliegue no puede consultar desde la página.
Qué pone un apretón real en el cable
La afirmación de que esos valores existen fuera de la página es fácil de enunciar y merece medirse. La sonda abre dos conexiones TLS al mismo host que solo difieren en la lista de protocolos que ofrece el cliente, y lee lo que la conexión negoció:
handshake:dual_alpn -> alpn=h2 protocol=TLSv1.3 cipher=TLS_AES_256_GCM_SHA384 group=X25519MLKEM768
handshake:http11_only -> alpn=http/1.1 protocol=TLSv1.3 cipher=TLS_AES_256_GCM_SHA384 group=X25519MLKEM768
wire_only_distinction -> alpn_differs=true
Ambas conexiones llegan a TLS 1.3, ambas coinciden en TLS_AES_256_GCM_SHA384 y ambas usan el grupo de intercambio X25519MLKEM768. La única diferencia es el protocolo negociado, h2 frente a http/1.1, y esa diferencia vino de un parámetro del cliente que el par leyó durante el apretón. Nada en el documento puede observarla. Una página cargada por cualquiera de las dos conexiones ve las mismas API, las mismas cabeceras en sus propias peticiones una vez enviadas y el mismo entorno; el protocolo que llevó la petición es una propiedad de la conexión, no del documento.
Lo mismo ocurre con la trama de ajustes de HTTP/2. La sonda construye dos tramas de ajustes y las vuelve a leer desde bytes crudos en un receptor local, así que los números vienen de la trama y no de un objeto del cliente:
settings_frame:wide -> enable_push=0 initial_window=1048576 max_frame=32768 bytes=18
settings_frame:narrow -> enable_push=1 initial_window=65535 max_frame=16384 bytes=18
settings_frame_differs -> initial_window_differs=true max_frame_differs=true
Ambas tramas ocupan 18 bytes. Llevan una ventana inicial de 1048576 frente a 65535, una trama máxima de 32768 frente a 16384, y ajustes de envío opuestos. Un par que quiera saber cómo se comporta un cliente lee estas entradas de seis bytes tal como llegan, antes de que exista documento alguno. Una página no puede leer la trama que envió, porque la trama la escribe la pila de red por debajo del documento y no se expone hacia arriba.
El lado servidor de una conexión real también es legible para la pila de red del cliente:
peer_settings:botbrowser.io -> initial_window=65536 max_frame=16777215 max_streams=256 header_table=4096
Una ventana inicial de 65536, una trama máxima de 16777215, 256 flujos concurrentes y una tabla de cabeceras de 4096 son valores que el cliente recibió del servidor. Una página puede enviar peticiones y observar respuestas, y no puede leer ninguno de estos cuatro números, porque describen el transporte por el que viajan las peticiones.
En conjunto, las mediciones establecen la forma de la brecha y no una detección concreta. La conexión lleva una lista de protocolos, un conjunto de cifrado, un grupo de intercambio de claves, una trama de ajustes y una dirección observada. El documento lleva un agente de usuario, un idioma, una plataforma y un conjunto de superficies renderizadas. Los dos conjuntos se solapan exactamente en los seis lugares de la tabla anterior, y en cada uno la comparación necesita un valor de cada lado.
Por qué las reglas más pesadas quedan al otro lado
Si las reglas de red fueran una cola fina de comprobaciones débiles, un escaneo del lado de la página cubriría el tema lo bastante bien. Los pesos dicen lo contrario:
edge_weight_bands -> ge_0.85=4 0.7_to_0.84=8 0.5_to_0.69=19 lt_0.5=0
heaviest -> weight=0.9 net.h2_rapid_reset layers=network
heaviest -> weight=0.9 net.h2_continuation_flood layers=network
heaviest -> weight=0.9 net.h2_control_flood layers=network
heaviest -> weight=0.85 net.webrtc_ip_vs_observed layers=network+browser
heaviest -> weight=0.8 net.ja4_unstable_within_session layers=network
single_wire_fact_rules -> 21
Ninguna regla de red pesa menos de 0.5. La distribución se concentra en el medio y en la parte alta: 19 reglas entre 0.5 y 0.69, 8 entre 0.7 y 0.84, y 4 en 0.85 o más. Las tres más pesadas comparten peso 0.9 y las tres describen comportamiento de tramas en una conexión HTTP/2. La primera es net.h2_rapid_reset, un reinicio de flujo que llega más rápido de lo que un cliente podría haber procesado una respuesta. La segunda cuenta tramas de continuación en un solo flujo. La tercera cuenta tramas de control a lo largo de la sesión. Cada una es una propiedad de tiempo o de volumen del transporte, y cada una se mide contando tramas en el extremo receptor.
Las dos reglas pesadas restantes describen estabilidad en lugar de un único valor. net.ja4_unstable_within_session con 0.8 pregunta si los parámetros de apretón del cliente cambiaron dentro de una sesión, y net.webrtc_ip_vs_observed con 0.85 pregunta si dos direcciones del mismo cliente no coinciden. Ambas necesitan más de una observación en el tiempo o entre capas, que es una segunda razón por la que una página no puede responderlas: aunque un script pudiera leer un parámetro de apretón, no tiene acceso al anterior.
Veintiuna de las 31 son más simples. Son comprobaciones de presencia sobre un único hecho de red, como si faltaba una cabecera que el cliente envió, si la codificación aceptada omitía un método de compresión, o si el apretón llevaba un parámetro que un cliente actual suele incluir. Un solo hecho decide la regla, y el hecho vive enteramente fuera del documento. Esa combinación, una entrada y un peso de al menos 0.5, es lo que hace del subconjunto de red una parte real del detector y no una nota al pie.
La lectura práctica es sobre cobertura, no sobre puntuaciones. Una revisión del lado de la página puede describir 95 de 126 reglas y no puede describir ninguna de las 31 que leen la conexión. Cuando un informe enumera hallazgos y no dice qué capa los produjo, las 31 ausentes son invisibles: el informe no se equivoca sobre lo que vio, y calla sobre la capa donde cuatro reglas pesan 0.85 o más.
En qué se diferencia leer un hallazgo de red
Un hallazgo del lado de la página y un hallazgo de red sostienen afirmaciones distintas, y la diferencia decide qué debe contener un registro. Un hallazgo del lado de la página es reproducible solo con el documento, porque quien cargue la misma página en el mismo entorno lee los mismos valores y llega a la misma conclusión; un desacuerdo entre dos ejecuciones apunta entonces a un cambio en el entorno. Un hallazgo de red es reproducible solo con la conexión, ya que el mismo documento cargado con otra lista de protocolos, otro cifrado u otra ruta produce una entrada distinta, y dos ejecuciones que discrepan pueden diferir en el transporte y no en el navegador.
Eso alarga la lista de campos del registro para un hallazgo de red. Tiene que nombrar la conexión de la que vino la observación, no solo la página, lo que en las ejecuciones anteriores significa el alpn=h2 o alpn=http/1.1 negociado y no una URL. Tiene que decir qué lado de cada comparación se midió, porque una regla como net.webrtc_ip_vs_observed con peso 0.85 no queda respondida leyendo solo browser.webrtc_public_ip. Y tiene que conservar la identidad de la regla en lugar de un recuento, porque 31 reglas repartidas en 23 de coherencia, 4 de reputación, 3 de automatización y 1 de artefacto no se reducen a un número que signifique algo por sí solo.
Hay un límite que conviene decir sin rodeos. Un perfil que mantiene cada superficie de página coherente con un objetivo declarado no cambia por ello el apretón, la trama de ajustes ni la dirección observada en el extremo remoto; esos son hechos separados producidos por partes separadas del cliente. Leer un informe del lado de la página como evidencia sobre la conexión exagera lo medido, y leer un informe de red como evidencia sobre el documento comete el error contrario. Los dos informes describen dos capas, y una afirmación sobre el navegador en conjunto necesita ambos.
Registrar una lectura
Una lectura de red sostiene una afirmación estrecha: esta versión del conjunto de reglas, esta conexión, produjeron estas entradas. Cuatro campos la mantienen comprobable:
- La versión y el resumen del conjunto de reglas, porque una regla que gana o pierde una entrada cambia lo que significa la separación sin cambio alguno en el cliente.
- La capa que necesita cada regla, porque 25 de las 31 no leen nada de la página y un informe que omite la capa da a entender que la página las cubrió.
- Los valores de red medidos para la conexión que realmente se usó, porque una lista de protocolos, un cifrado y una trama de ajustes pertenecen a esa conexión y no al navegador en general.
- Las seis comparaciones que necesitan ambos lados, marcadas como medidas a medias cuando solo se leyó el valor de página.
Fuentes públicas
- RFC 8446: The Transport Layer Security (TLS) Protocol Version 1.3
- RFC 9113: HTTP/2
- RFC 7301: TLS Application-Layer Protocol Negotiation Extension
- MDN: Navigator.userAgentData
- MDN: Accept-Language
- BotBrowser: referencia de coherencia de automatización
Conclusión práctica
Separa en el informe lo medido en el documento de lo medido en la conexión, porque solo la segunda parte alcanza las reglas cuyo peso llega a 0.9. Cuando la única evidencia sea un valor de página, escribe half-measured junto a la regla en lugar de un resultado. Y conserva la conexión junto al hallazgo, porque un alpn negociado y una trama de ajustes describen ese enlace concreto y no al navegador en conjunto. Para la puntuación que decide si una regla disparada puede condenar, lee por qué una señal extraña nunca condena a un navegador; para cómo una biblioteca agrupa sus propios hallazgos antes de cualquier veredicto, lee los grupos de señales de CreepJS y cómo los combina.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
Por qué una señal rara no condena a un navegador
Huella digitalQué prueban realmente las suites de detección públicas
Huella digitalFingerprinting de la Network Information API: revisión de política
RedDNS sobre TLS: privacidad del resolutor, despliegue y límites de fallo
RedCoherencia de red del navegador para proteger la privacidad
Huella digitalFingerprinting del Navigator: fugas del navegador
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.