TextDecoder 与 TextEncoder:字节与字符串
用多种标签解码固定字节:哪些标签是别名,BOM 与非法字节如何处理,为什么切块会丢掉一个字符,以及为什么字节长度与字符串长度不同。
BotBrowser Team
BotBrowser 支持在声明的 Profile 下重复运行经授权的同源页面 fixture,并保留范围受限的观察:页面编码了哪些字节,解码器返回了什么字符串;但它不能让 TextEncoder 输出 UTF-8 以外的标签,不改变一个标签解析到哪个解码器,也不会把解码结果变成身份信号。本文用多种标签解码一组固定的字节序列,记录哪些标签是别名、字节序标记如何处理、fatal 模式何时抛出而不是替换、为什么一个切块边界会丢掉多字节字符,以及为什么同一段文本的字节长度与字符串长度会不一致。
摘要
TextEncoder永远是 UTF-8,并忽略传给构造函数的任何标签;new TextEncoder({encoding:"latin1"}).encoding仍然打印utf-8。- 标签
latin1、iso-8859-1与windows-1252解析到同一个解码器,所以 UTF-8 字节形式的café会返回café,无法分辨写的是哪个标签。 - UTF-8 的字节序标记默认被去掉,只有
ignoreBOM: true才保留,所以同一批字节会因一个多数调用者从不设置的选项解码成一个或两个字符串。 - 非
fatal解码会把非法字节替换成 U+FFFD,而fatal: true会抛TypeError;被截断的多字节序列会变成一个替换字符且不报错。 - 把多字节字符跨两次解码调用切开,除非设置
stream: true否则会丢掉它,而流式结果会重新拼回原字符串。 - 孤立代理项会编码成一个 U+FFFD,所以往返可能改变值却每次调用都成功;
café是四个 UTF-16 单元和五个 UTF-8 字节。
目录
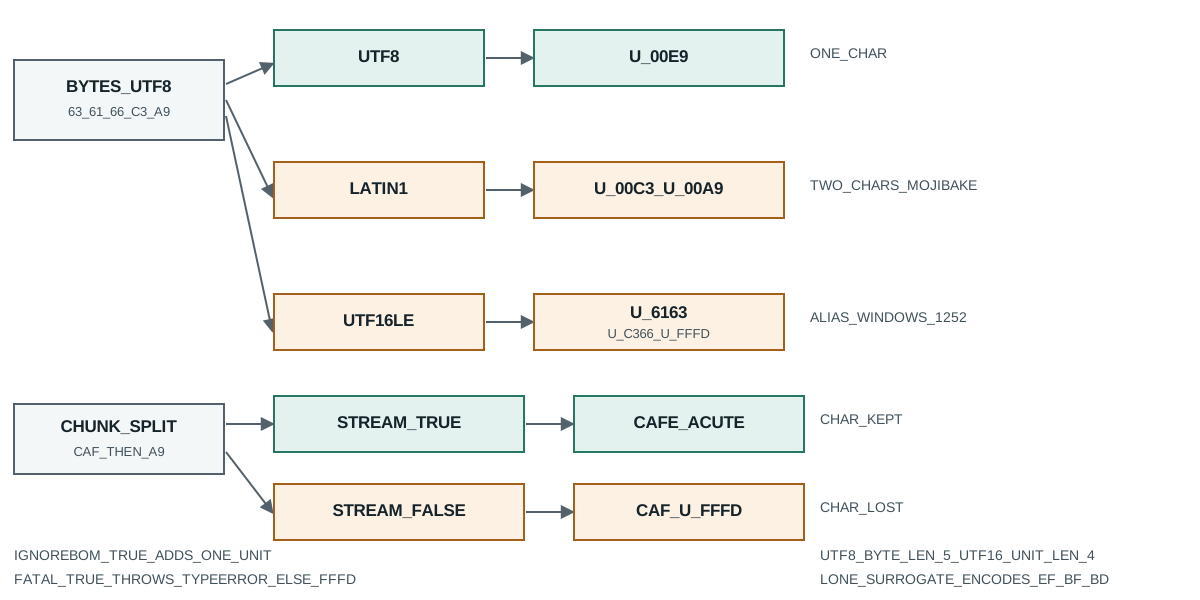
哪个标签解析到哪个解码器
构造函数接收的是标签,而不是精确的编码名,标准把许多标签映射到同一个解码器。探针用四个标签解码 café 的五个 UTF-8 字节(63 61 66 c3 a9),并打印各自返回的字符串:
TextDecoder=function TextEncoder=function node=v26.9.0
TextEncoder.encoding = "utf-8"
encode("café") -> 63 61 66 c3 a9
encode("😀") -> f0 9f 98 80
new TextEncoder({encoding:"latin1"}) -> "utf-8"
new TextDecoder("utf-8").decode(0x63 61 66 c3 a9) -> "café"
new TextDecoder("latin1").decode(0x63 61 66 c3 a9) -> "café"
new TextDecoder("iso-8859-1").decode(0x63 61 66 c3 a9) -> "café"
new TextDecoder("windows-1252").decode(0x63 61 66 c3 a9) -> "café"
new TextDecoder("utf-16le").decode(0x63 61 66 c3 a9) -> "慣썦�"
这里有两个事实。第一,无论传什么标签,TextEncoder 都报告 utf-8;这个对象根本没有别的编码,所以写 latin1 并期望单字节输出的人会得到多字节输出,且没有任何警告。第二,三个单字节标签收拢成一个解码器。latin1、iso-8859-1 与 windows-1252 是标准标签表中的别名,而 windows-1252 是三者共同解析到的解码器。用其中任何一个解码 UTF-8 字节,都会把每个字节读成一个字符,于是两字节序列 c3 a9 变成两个字符 Ã 与 ©。
这种收拢正是经典乱码的根源:生产者写了 UTF-8,消费者却声明 Latin-1,或者反过来。缺陷不是任何一方单独的 bug,而是生产者使用的标签与消费者假设的标签之间的错配。两字符结果是确定的且可逆,所以用 UTF-8 重新解码同一批字节会精确还原 café。能抓住这个问题的检查是把解码后的字符串与期望文本比较,而不是比较字节长度,因为乱码的两种写法占用的字节数相同。
第四个标签显示错误族系的代价。utf-16le 把同一批字节两两读成小端 16 位单元,于是 63 61 变成一个字符,66 c3 变成另一个,剩下的 a9 变成一个替换字符。什么都不抛。收到来自真正产出 UTF-16 的源的字节却声明 LE 的人会得到一个字符串,只是不是想要的那个;为真正的 UTF-16 声明错误字节序的人又会得到另一个字符串。标签是数据契约的一部分,所以一个解码却不记录标签的 fixture 记录的是无法复核的结果。
这一行还有同样重要的第二种读法:解码器消费了奇数个字节。UTF-16 解码器每两个字节读一个单元,所以五字节输入会留下一个没有配对的字节,解码器把这个落单字节变成 U+FFFD 而不是丢弃。因此结果的字符数即使标签看起来合法,也能透露输入的奇偶性。用错误的两字节族系解码偶数长度的 UTF-8 正文的流水线会隐藏这个信号,因为偶数个字节不留下任何落单数据,本会标记错配的替换也就从不出现。只有当标签错配同时破坏了字节奇偶性时,它才便宜可察,这是一种脆弱的检测方式。
未知标签是唯一会大声失败而不是静默失败的情况:
new TextDecoder("utf-99") -> THREW RangeError
构造函数在读任何字节之前,就以 RangeError 拒绝不在标准表中的标签。这正是 fixture 面对拼写错误时应当依赖的形状,因为它在构造时点名了问题。上面其他任何错配都会返回字符串并继续,所以对一个合法但错误的标签,唯一可靠的防护是断言解码出的值。
字节序标记与非法序列如何处理
字节序标记在 UTF-8 数据开头是三个字节(EF BB BF),在 UTF-16 数据开头是两个(小端为 FF FE)。标准对 UTF-8 标记作特殊处理:默认解码器把它从输出中去掉,而 ignoreBOM: true 时保留。探针为同一输入展示两种结果:
decode(EF BB BF 41) default -> "A"
decode(EF BB BF 41) ignoreBOM:true -> "A"
decode(FF FE 41 00) as utf-16le -> "A"
第一行解码标记后跟字节 41(A),返回单个字符 A。第二行返回两个字符:一个不可见的 U+FEFF 后跟 A,所以 result.length 是 2 而不是 1。比较两个字符串会失败,比较长度会差一,而两者都没错;是选项决定了结果。从配置里取 ignoreBOM 的消费者与不这样做的生产者,正是把一个正确字符串变成两个不等字符串的分裂点。
UTF-16 那一行显示同一规则在另一个解码器内处理标记:FF FE 是小端标记,解码器消费它,剩下的 41 00 解码成 A。期待另一字节序的 UTF-16 解码器会把 FF FE 读成一个单元并产出不同的首字符,所以标记与字节序必须先一致,文本才会一致。
非法序列是与标记不同的决定,由 fatal 设置:
decode(A FF B) non-fatal -> "A�B"
decode(A FF B) fatal -> THREW TypeError
decode(E4 B8) truncated -> "�"
FF 字节在 UTF-8 中任何位置都非法。没有 fatal 时,解码器在它的位置发出一个 U+FFFD 并继续,所以结果是 A、一个替换字符、再是 B:三个输入字节得到三个字符,其中一个被替换。而 fatal: true 时同一批字节抛 TypeError。绝不能接收损坏文本的流水线应设置 fatal,因为非 fatal 的结果是一个合法字符串,却静默地不同于输入。
被截断的情况最令人意外。E4 B8 是三字节字符的前两个字节,解码器在输入结束时无法补全,于是发出一个替换字符。即使数据被截短也不抛错。这就是为什么字节计数检查在截断输入上会通过:解码器永远返回字符串,只有值才揭示丢了一个字符。
为什么切块边界会丢掉一个字符
网络响应、文件读取和 worker 消息都按块到达,块边界可能落在多字节字符中间。TextDecoder 为此有两种模式,探针在四个字节后切开 café 的五个 UTF-8 字节,于是第一块结束在两字节 é 的第一个字节:
stream split mid-sequence: first="caf" second="é"
non-stream split mid-sequence -> "caf�"
非流式路径把每个块当作完整单元解码。第一块是 caf 加上字节 c3,它开始一个两字节字符而块里没有它的剩余部分,于是解码器把这个落单的 c3 变成一个替换字符,返回 caf 后跟 U+FFFD。é 丢了。设置 stream: true 的流式路径把末尾的 c3 留着而不是替换,所以第一次调用返回 caf,第二次收到 a9 返回 é,两个结果拼接成 café。
这就是任何读取流的解码器必须在除最后一块外的每块上传 stream: true,并不带参数再调用一次冲刷尾部的原因。一个不带该标志逐块解码的循环,会在每个落在多字节序列内部的边界丢掉一个字符,而且丢失是静默的:总长度减少一个或多个单元,每次调用都返回字符串。把拼接结果与原字符串比较的 fixture 能抓住它;只检查解码是否成功的 fixture 抓不住。
同一机制出现在页面读取 ReadableStream 并增量解码时,也出现在 worker 重组消息时。两种情况下的修法都是同一个标志加一次最终冲刷,没有它的失败是固定数量的替换字符,等于被切开的序列数。这个计数是有用的诊断:块边界处一个替换字符意味着一次切开,一串则意味着块与字符宽度没对齐。
最终冲刷很容易忘记,因为每次中间调用都已经返回了字符串。最后一块之后,仍持有尾部字节的解码器必须不带输入再调用一次,只有那次调用会发出被持有字节补全的字符。在最后一块之后停止的循环把尾部留在解码器里,所以拼接输出比那些字节本应产生的字符短。把拼接输出与原字符串比较的 fixture 能抓住遗漏;只检查没有调用抛错的 fixture 抓不住,因为一次都没抛。
字节长度与字符串长度在哪里不一致
TextEncoder 写的是 UTF-8,所以一个字符串的字节长度是它的 UTF-8 长度,而不是 UTF-16 长度。只有文本由 U+0080 以下的字符组成时二者才一致。探针用两种方式测量四个字符串:
"hello" stringLength=5 byteLength=5
"café" stringLength=4 byteLength=5
"中文" stringLength=2 byteLength=6
"😀" stringLength=2 byteLength=4
对 hello,五个 ASCII 字符占五字节,因为每个 ASCII 码点是一个单元也是一个字节。对 café,四个字母占五字节,因为 é 是一个 UTF-16 单元但两个 UTF-8 字节。对两个 CJK 字符,两个单元占六字节,因为每个在 UTF-8 中是三字节。对表情符号,两个 UTF-16 单元(一个代理对)占四字节,因为一个高于基本平面的码点在 UTF-8 中是四字节。用字节表达的存储上限与用字符表达的显示上限,因此对每种文字以不同系数不一致,而为 ASCII 写的预算会拒绝或接受错误数量的非 ASCII 文本。
这些字节的生产者往往是一个 ArrayBuffer 上的视图,ArrayBuffer 与 TypedArray 展示了为什么同样八个字节在 Uint8Array 下报告字节长度 8、在 Uint32Array 下报告元素长度 2,以及为什么保存的 subarray 别名在源缓冲被复用时失效。
代理项的情形带有第二个不一致,因为孤立代理项不是合法文本,TextEncoder 会重写它:
encode(lone high surrogate) -> ef bf bd
round trip lone surrogate length=1 equal=false
编码后的字节是 ef bf bd,一个 U+FFFD,因为孤立代理项没有 UTF-8 形式。解码这些字节返回单个替换字符,所以字符串长度与输入长度一一致,但值不同,相等检查为假。因此往返可能同时保持长度又改变值,这就是为什么长度比较不是往返测试。在任意索引处切开一个字符串恰好制造这种形状,因为在代理对内部切开会让一半落单。
记录一次编解码读数
一次编解码读数支撑一个很窄的断言:这个运行时、这个标签、这个选项、这个输入产生了这个字符串。六个字段让它可复核,而且没有一个存储解码器可能重新解释的文本:
- 传给解码器的标签以及它隐含的字节序,因为多个标签是别名,一个标签可以两种方式读字节。
- 输入作为字节序列而不是渲染后的文本,因为两个不同字节序列可以渲染成一样,一个序列可以在多个标签下读取。
- 是否设置了
ignoreBOM,因为同一批字节下它会把字符串长度改变一。 - 是否设置了
fatal,因为它在抛出的错误和被替换的替换字符之间决定。 - 是否每块设置了
stream以及是否跑了最终冲刷,因为二者都决定被切开的字符是否幸存。 - 分别记录 UTF-8 字节长度与 UTF-16 单元长度,因为两个数字回答同一文本的不同问题。
这样的读数不能显示的是字节到达之前的事。解码器拿到的是字节序列;它不会说生产者写的是 UTF-8、Latin-1 还是 UTF-16,而生产者与消费者之间的错配正是上面乱码最常见的原因。关于页面如何报告来自另一层文本的更大问题,请阅读 Unicode 归一化与文本身份信号,它覆盖为什么同一可见文本的两种写法比较不等,以及 btoa 与 atob 边界,它覆盖较早的单字节编码路径,那条路径在 UTF-8 接受的同一批非 ASCII 文本上抛错。
两个习惯让读数随时间保持诚实。第一,把标签和选项与解码后的字符串一起记录,而不是只记字符串,因为裸字符串在不知道是哪些选项产生它时无法重新推导。第二,把解码后的值与期望值比较,而对于往返,把原字符串与解码结果比较而不是比较长度,因为一个替换字符和原单元可能占用同一长度却在值上不同。
公开来源
- MDN:TextEncoder
- MDN:TextDecoder
- MDN:TextDecoderStream
- WHATWG Encoding 标准
- Unicode 标准附件 15:归一化形式
- BotBrowser:自动化一致性参考
结论
把标签当作数据契约的一部分:latin1、iso-8859-1 与 windows-1252 解析到同一个解码器,TextEncoder 永远是 UTF-8 并忽略你传入的任何标签,未知标签是唯一在构造时抛出的情况。有意识地选择 ignoreBOM,并在损坏文本不得静默通过时选择 fatal。用 stream: true 解码流并冲刷尾部,否则被切开的多字节字符会变成替换字符。分别记录标签、字节、选项和两种长度,并比较解码后的值而不是长度,这样编码成一个 U+FFFD 的孤立代理项就无法通过绿色检查。
延伸阅读
想继续深入文本层,Unicode 归一化与文本身份信号 给出同一可见文本的多种长度与排序,btoa 与 atob 边界 给出把字节塞进 string 的历史做法以及它在非 ASCII 上的失败点。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界