ArrayBuffer 与 TypedArray:一个缓冲,多种视图
用 Uint8Array、Uint32Array 与 DataView 读同一个 ArrayBuffer:字节与元素长度、slice 复制而 subarray 共享、字节序,以及 transfer 如何让源脱离。
BotBrowser Team
BotBrowser 支持在声明的 Profile 下重复运行经授权的同源页面 fixture,并保留范围受限的观察:页面通过视图读取了哪些字节,以及它产生了哪些数字;但它不能改变 DataView 读取所依据的主机字节序,不能让复制与别名行为一致,也不会把视图字节长度变成身份信号。本文取一个 ArrayBuffer,用 Uint8Array、Uint32Array 与 DataView 读取它,然后记录为什么同样八个字节有三种不同长度、为什么 slice 复制而 subarray 共享、同样字节的 big-endian 与 little-endian 读取如何不同、越界访问与整数回绕如何表现,以及 transfer 如何让源脱离。
摘要
- 一个 8 字节缓冲对任何视图的
.byteLength都是 8,但Uint8Array.length是 8、Uint32Array.length是 2、Float64Array.length是 1;长度数的是元素,不是字节。 - 三个视图共享同一批字节,所以通过一个写入会通过其他视图看到,因为它们包装同一个缓冲而不是复制它。
slice在新的缓冲上返回副本,所以对它的写入不改变源;subarray在同一缓冲上返回视图,所以对它的写入会改变源。DataView.setUint32(0, 0x01020304, false)写入01 02 03 04,按 big-endian 读回得0x01020304,按 little-endian 读同一批字节得0x04030201。Uint32Array按主机字节序读取,本机是 little-endian,所以同样字节得到0x04030201,与DataView的 little-endian 读取一致,而不与 big-endian 一致。- 越界写入被丢弃、越界读取为
undefined;Uint8Array把 256 变成 0、Int8Array把 200 变成 -56、Uint8ClampedArray把 300 限制到 255。 buffer.transfer(4)让源脱离(byteLength变为 0)并返回 4 字节副本;使用已脱离的源会抛TypeError。
目录
- 为什么一个缓冲有三种不同长度
- 为什么 slice 复制而 subarray 共享
- 同样字节如何按 big-endian 和 little-endian 读取
- 越界访问与整数回绕落在哪里
- 视图的窗口与 transfer 在哪里改变源
- 记录一次二进制读数
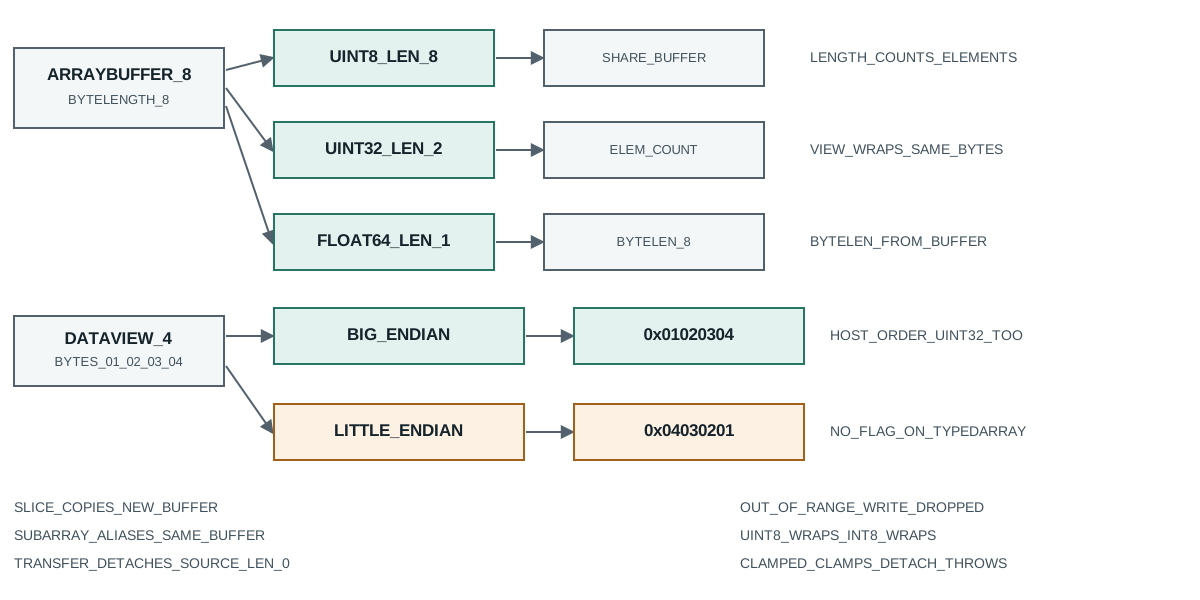
为什么一个缓冲有三种不同长度
缓冲是一块字节,对字节含义没有概念。视图提供含义,它使用的元素大小决定同样一块能容纳多少元素。探针分配一个 8 字节缓冲并在其上建立三个视图:
ArrayBuffer=function DataView=function node=v26.9.0
new ArrayBuffer(8): byteLength=8
same buffer: Uint8Array.length=8 Uint32Array.length=2 Float64Array.length=1
all share bytes: u8.buffer===u32.buffer true
无论哪个视图读取,缓冲都报告 byteLength 8。Uint8Array 每个元素读一个字节,所以它的 length 是 8。Uint32Array 每个元素读四个字节,所以它的 length 是 2。Float64Array 每个元素读八个字节,所以它的 length 是 1。三个数字都描述同样八个字节,而其中只有一个是字节数。
这个区别正是二进制代码路径的第一个缺陷:读 view.length 并乘以“每元素一字节”的人,除字节视图外对每个视图都会得到错误的字节数。byteLength 属性才是永远数字节的,它在三个视图上一致,因为它是缓冲窗口的属性,不是元素类型的属性。.buffer 身份检查确认三个视图包装同一次分配,所以通过字节视图写入会通过 32 位视图看到,这正是解码器先填字节再按整数读取时所依赖的。
实际后果是,写进记录的长度必须说明是哪个视图产生的。一条写着“长度 8”的记录是含糊的:它是字节长度或 Uint8Array 长度,但同样字节上的 Uint32Array 会说二。两者都对且回答不同问题,所以记录需要把元素大小与数字放在一起。
同样的推理决定了当缓冲不是元素大小的整数倍时视图如何报告字节数。10 字节缓冲上的 Uint32Array 只暴露两个完整的四字节元素,末尾两个字节落在它能寻址的任何元素之外。视图的 byteLength 只反映它覆盖的字节,所以剩余两个字节经它既不可读也不可写,而一个假设“缓冲每个字节都能经该视图到达”的解析器会静默丢掉尾部。为一个未与之对齐的缓冲选择元素类型,因此是在决定哪些字节可寻址,而不只是决定长度报告多少元素。
为什么 slice 复制而 subarray 共享
两个方法看似相似却行为相反。slice 返回由新缓冲支撑的新视图,subarray 返回由同一缓冲支撑的新视图。探针分别修改它们并检查源是否改变:
slice then mutate: src[1]=2 sliced[0]=99
subarray then mutate: src[1]=42 sub[0]=42
slice shares buffer: false; subarray shares buffer: true
在 slice(1, 4) 之后,向副本写入 99 让 src[1] 保持原来的 2,缓冲身份检查报告副本不共享源的缓冲。在 subarray(1, 4) 之后,向子视图写入 42 把 src[1] 改成 42,身份检查报告子视图共享源的缓冲。两个方法接受相同参数、产生同样三个元素的视图,但一个是副本,另一个是别名。
一个读取帧、用 slice 取正文并保存的解码器,可以安全地把源缓冲复用于下一帧,因为副本拥有自己的字节。一个用 subarray 做同样的事、然后把源缓冲复用于下一帧的解码器,会覆盖它保存的正文,因为子视图仍指向刚刚改变的缓冲。这是典型的别名缺陷:代码看起来正确,元素数也正确,而保存的字节静默地变成了下一帧的字节。
修法是有意识地决定记录需要哪一个。副本付出一次分配,能在源被复用时存活;别名不付成本,却在源改变的那一刻失效。保存 subarray 的记录必须让源缓冲保持存活且不被改动,或者先用 slice 把字节拷出来,并且应当说明做了哪个,因为仅凭元素数无法区分保存的别名和保存的副本。
同样字节如何按 big-endian 和 little-endian 读取
字节序决定多字节数字的哪一端在前。DataView 接受显式的 littleEndian 参数,探针写入一个 32 位值并两种方式读取:
setUint32 big-endian bytes: 01 02 03 04
DataView read BE -> 0x1020304
DataView read LE -> 0x4030201
Uint32Array (host order) -> 0x4030201
host is little-endian: true
以 littleEndian 为假(big-endian)写入 0x01020304 把字节放成 01 02 03 04。用 getUint32(0, false) 读回重建 0x01020304,用 getUint32(0, true) 读同样四个字节重建 0x04030201,即字节反转的值。字节没变,只有解释变了,两种解释在各自选项下都正确。
Uint32Array 那一行展示了陷阱。类型化数组视图没有字节序参数,它按主机原生字节序读取。本机是 little-endian,所以 Uint32Array 读到 0x04030201,与 DataView 的 little-endian 读取一致。一个用 Uint32Array 而非 DataView 解析网络头部的解码器,因此在 little-endian 主机上得到正确答案、在 big-endian 主机上得到错误答案,而代码没有任何改动。这就是为什么二进制格式总要写明自己的字节序,也是为什么必须遵循规范的解码器使用带显式选项的 DataView、而不是类型化数组视图。
host is little-endian 那一行是记录机器偏向哪一端的廉价办法:分配一个含 1 的 Uint16Array,把它的缓冲按字节读出,检查第一个字节是否为 1。一条记录了已解析整数却没有记录主机字节序的记录,无法在另一台机器上重跑到同样的数字,因为同样字节只在被假设的那个字节序下再现该值。
还有第二个更隐蔽的后果,关于视图如何报告一个数字。Uint32Array 给出无符号整数,所以最高位被置位的值读成很大的正数而不是负数,而一个使用有符号 32 位字段的格式需要 Int32Array 或 DataView.getInt32 才能正确读出。同样字节上的两个视图可能在同一个字段的量和符号上都不一致,因为元素类型除了宽度还携带符号。一条把原始字节和元素类型一起记下的记录能按任一种重读,而只记下数字的记录已经选定了一种解释。
越界访问与整数回绕落在哪里
类型化数组不会增长,也不会因索引超出长度而抛错。探针向末尾之后写入、从末尾之后读取:
write index 10 on length 3: undefined length=3
Float64Array out-of-range read index 5 -> undefined
向长度 3 的数组索引 10 写入 5 什么也不做:长度仍为 3,该索引读回 undefined,因为写入落在元素窗口之外而被丢弃。Float64Array 上的越界读取也返回 undefined 而不是 NaN,因为读到长度之外根本不是数值读取。一个信任用户提供的偏移并在计算出的索引处写入的解析器,因此可能静默丢数据,而每次调用都成功,只有写入前的长度检查才能抓住它。
写入一个装不下的值有自己的行为,三种数组类型给出三种结果:
Uint8Array 256 -> 0; Int8Array 200 -> -56
Uint8ClampedArray 300 -> 255
Uint8Array 存低 8 位,所以 256 变 0;Int8Array 存有符号 8 位值,所以 200 变 -56。两者都按元素范围取模回绕而不报错。Uint8ClampedArray 限制而不回绕,所以 300 变 255,负值会变 0。一个期望限制的像素缓冲若拿到 Uint8Array 就会回绕,于是亮值溢出成暗值,而同样值在 Uint8ClampedArray 上会饱和到白。元素类型是数据契约的一部分,一条只说“一个字节数组”却不说明它限制还是回绕的记录,并没有描述这套算术。
视图的窗口与 transfer 在哪里改变源
一个视图可以覆盖缓冲的一个子范围,而缓冲可以被 transfer。两者都改变源是什么,探针分别测量:
view window: byteOffset=4 byteLength=4 buffer.byteLength=16
after transfer(4): source.byteLength=0 moved.byteLength=4
source use after detach -> THREW TypeError
窗口那一行显示一个建在 16 字节缓冲上、偏移 4、长度 4 的 Uint8Array。视图的 byteLength 是 4、byteOffset 是 4,但底层的 buffer.byteLength 仍是 16。一条只记视图长度的记录会少报缓冲,一条只记缓冲长度的记录会多报视图;两个数字描述同一内存上的不同窗口,定位字节时两者都需要。
transfer 那一行显示它做了什么。调用前源是 8 字节;buf.transfer(4) 之后源的 byteLength 变为 0,返回的缓冲含 4 字节。源被脱离,之后任何在它上面的视图使用都会抛 TypeError,探针捕获到这一点。transfer 把字节移到新缓冲并让旧缓冲不可用,所以持有旧缓冲引用、在 transfer 后读取它的代码会得到异常而不是陈旧数据。这是响亮的失败因而容易发现,但把缓冲 transfer 走而程序另一部分仍指望读取的代码会在下一次读取时崩溃,所以被 transfer 的缓冲的归属必须记录。
相关的一条边界是编码器输出是 Uint8Array 视图而非普通数组:TextEncoder.encode("café") 返回一个 byteLength 为 5、能通过 instanceof Uint8Array 的对象。这个视图正是上面长度一节所测的输入,所以解码器随后读到的字节数与记录应保存的是同一个数。
记录一次二进制读数
一份二进制读数支撑一个很窄的断言:这个运行时、这个字节序、这个视图和这个输入产生了这些数字。六个字段让它可复核,且没有一个存储会被另一个视图重新解释的值:
- 缓冲的
byteLength,以及视图的byteOffset与byteLength,因为窗口与缓冲是不同的范围。 - 每个用于读字节的视图的元素类型,因为一个缓冲按元素大小承载 8、2 或 1 个元素。
- 主机字节序,因为类型化数组视图读原生字节序,而
DataView接受显式选项。 - 派生视图是
slice副本还是subarray别名,因为只有别名会在源缓冲被复用时改变。 - 元素类型的限制或回绕行为,因为超出元素范围的值要么按范围取模回绕,要么饱和到边界。
- 缓冲是否被 transfer 及其
byteLength发生了什么,因为已脱离的源在下一次使用时会抛错而不是读陈旧字节。
这样的读数不能显示的是字节来自何处。缓冲由某个生产者填入,而解析它的读取者并不知道生产者写的是 UTF-8、big-endian 的网络头部,还是主机字节序下的序列化数字。关于同样字节的文本一侧,TextDecoder 与 TextEncoder 展示了为什么同样四个 UTF-8 字节在一个标签下解码成一个字符串、在另一个标签下解码成乱码字符串。关于副本一侧,structuredClone 与 JSON 展示了哪些容器类型能在深拷贝后存活、JSON 往返会压塌什么,这是先于字节级读取的容器级决定。
两个习惯让读数随时间保持诚实。第一,把元素类型和字节序与数字一起记录,因为从同样字节读出的整数在每种设置下都不同。第二,保存视图是副本还是别名,并比较字节而不只比较元素数,因为指向被复用缓冲的别名与它替换掉的副本元素数相同却持有不同字节。
公开来源
- MDN:ArrayBuffer
- MDN:TypedArray
- MDN:DataView
- MDN:ArrayBuffer.prototype.transfer
- ECMAScript:DataView 对象
- BotBrowser:自动化一致性参考
结论
把视图当作数据契约的一部分:byteLength 数字节,length 数元素,一个 8 字节缓冲按视图承载 8、2 或 1 个元素。要知道 slice 复制、subarray 共享,所以保存的别名在源缓冲被复用时失效。用带显式字节序的 DataView 读二进制格式,而不是用跟随主机字节序的类型化数组视图,并记录主机是否为 little-endian。预期越界写入被丢弃、越界读取为 undefined,并预期 Uint8ClampedArray 在 Uint8Array 回绕之处做限制。分别记录窗口、元素类型、字节序、副本还是别名以及 transfer 的结果,并比较字节而不是元素数,这样陈旧别名就无法通过绿色检查。
延伸阅读
关于同样字节作为文本意味着什么,阅读 TextDecoder 与 TextEncoder;关于哪些容器类型在读取任何字节之前的深拷贝中存活,阅读 structuredClone 与 JSON。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界