ua-parser-js:Client Hints、机器人与 500 上限
在固定的 user agent 和 Client Hints 上运行固定版本的 ua-parser-js,看它报告哪种身份、丢掉哪些标记,以及 500 字符上限如何藏住一个机器人 token。
BotBrowser Team
BotBrowser 支持在声明的 Profile 下重复运行经授权的同源页面 fixture,并保留范围受限的观察:页面报告了什么;但它不能强迫第三方解析器与它测量的浏览器一致、不能改变某个库的 500 字符输入上限,也不能把一条解析出来的标签变成关于对面是谁的结论。本文固定 ua-parser-js 在 commit bd7480198cd0d237b43a24a964f424727abb78e9(包版本 2.0.10)的公开源码树,在一组固定的 user agent 字符串和 Client Hints 头集合上运行它打包后的解析器,并报告代码实际返回了什么。
TL;DR
- 固定版本的解析器把无头 user agent 标成
Chrome Headless,而它自己的机器人分类器对同一字符串仍返回isBot=false。 - Electron 应用的 user agent 被报告成普通
Chrome;解析器的浏览器名字段在那里不带任何自动化信号。 - 一旦给出 user agent 字符串,解析器就会忽略与之矛盾的
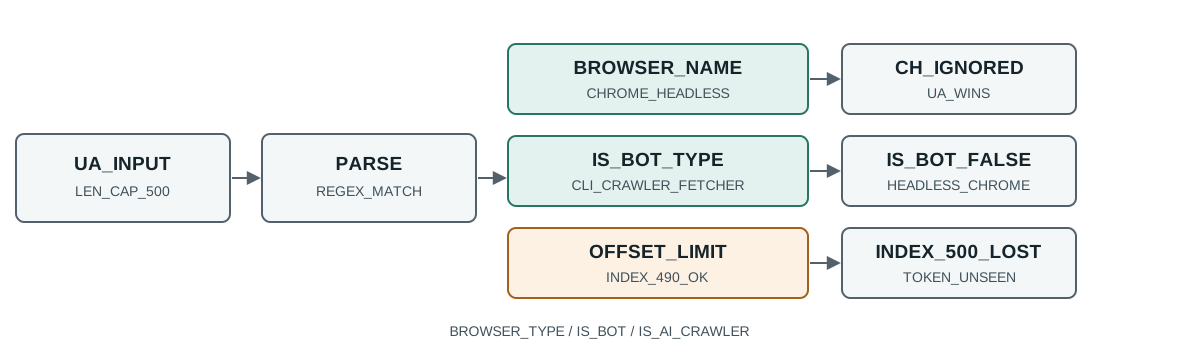
sec-ch-ua品牌列表,所以 Client Hints 不会推翻字符串已经说明的内容。 - 输入在 500 字符处截断,起点在第 500 个索引的机器人 token 对分类器不可见,而起点在 490 的同一 token 能被找到。
- 这一切只描述一个 commit 和一份打包产物;它不是关于任何网站如何给会话打分的断言。
Contents
- 固定版本到底打包了什么
- 在固定 user agent 上运行解析器
- 分类器与浏览器名字在何处不一致
- Client Hints 在何处不再起作用
- 500 字符上限在何处藏住 token
- 哪些规则列表喂给分类器
- 变异测试能说明什么、不能说明什么
- 如何在不夸大的前提下读解析结果
固定版本到底打包了什么
版本 2.0.10 把 src/ 分成七个目录。src/main 放解析器本身,src/bot-detection 放分类器,src/browser-detection 与 src/device-detection 放独立匹配器,src/extensions 放机器人、爬虫和 fetcher 列表,src/enums 放词典,src/helpers 放小工具。发布产物 dist/ua-parser.pack.js 导出 UAParser、VERSION 和五个枚举(BROWSER、CPU、DEVICE、OS、ENGINE);机器人子模块是独立入口,导出 isBot、isAIAssistant 和 isAICrawler。
两半通过不同代码路径读同一字符串,这个差异正是本文主题。UAParser 对 user agent 文本应用正则,并在收到头对象时也对 Client Hints 头应用正则。isBot 做得更窄:它通过扩展注册表解析 user agent,然后问解析出的浏览器 type 是否属于 cli、crawler、fetcher 或 library。因此一个给出可信浏览器名字的库,可以和说"这字符串不是机器人"的分类器并存,两者回答的是不同问题。
src/main/ua-parser.js 里的两个常量决定每一半能看到多少文本。解析器声明 UA_MAX_LENGTH = 500,setUA 在任何匹配前执行 trim(ua, UA_MAX_LENGTH)。因此后续一切,包括分类器重新解析的字符串,都只处理传入内容的前 500 个字符。
在固定 user agent 上运行解析器
探针加载发布产物和固定的机器人子模块,每个输入打印一行。它只读固定列表;不加载页面、不打开 Profile、不连接服务:
node /tmp/uap-full-probe.mjs
逐段观察到的输出:
section: user-agent parse
chrome-win: browser=Chrome/155.0.0.0 engine=Blink os=Windows device=desktop
safari-mac: browser=Safari/18.4 engine=WebKit os=macOS device=desktop
headless-linux: browser=Chrome Headless/155.0.0.0 engine=Blink os=Linux device=desktop
edge-win: browser=Edge/155.0.0.0 engine=Blink os=Windows device=desktop
electron-win: browser=Chrome/155.0.0.0 engine=Blink os=Windows device=desktop
googlebot: browser=undefined/undefined engine=undefined os=undefined device=desktop
iphone-safari: browser=Mobile Safari/18.4 engine=WebKit os=iOS device=mobile
这个块里三个细节比其余更重要。headless-linux 行报告了不同的浏览器名字 Chrome Headless,说明解析器确实为那字符串带了形似自动化的标签。electron-win 行报告普通 Chrome,所以基于 Electron 的应用在这个字段里与桌面浏览器无法区分。googlebot 行对浏览器、引擎和系统都报告 undefined,却仍报告 device=desktop,说明"没有匹配"是用缺失字段表达的,而不是报错。
device 字段值得单独一句,因为它很容易被读成比实际更强的断言。googlebot 和 chrome-win 都返回 desktop,headless-linux 也是;这个字段是兜底类别,不是测量值。把 device=desktop 读成"这真是台桌面机"的人,是把默认值当成了证据。
分类器与浏览器名字在何处不一致
同一次运行的第二段用全部字符串去问分类器;下面的块只是摘录,完整输出见证据文件:
section: bot classifier
chrome-win: isBot=false isAIAssistant=false isAICrawler=false
headless-linux: isBot=false isAIAssistant=false isAICrawler=false
electron-win: isBot=false isAIAssistant=false isAICrawler=false
googlebot: isBot=true isAIAssistant=false isAICrawler=false
headless-linux 行最有意思。解析器把这字符串叫 Chrome Headless,分类器叫它"不是机器人"。两句都是关于各自规则集的正确陈述:分类器对 HeadlessChrome 并不看浏览器名字,它看浏览器 type,而无头 Chromium 构建仍声明普通浏览器类型。一份只引用其中一个答案却暗示另一个的报告,是在错误描述这个库。
electron-win 行从另一个方向重复了同一模式。解析器根本不给自动化标签,分类器也同意没有机器人。因此 Electron 应用对这两个字段都不可见,除非栈里别的部分直接看 Electron/ token,而这份打包产物在探针实际走过的两条路径里都不这么做。
googlebot 行展示了分类器最强的结果 isBot=true,而解析器什么都没返回。这是反向情形:爬虫列表认出了字符串,尽管通用浏览器匹配器没有为它准备模式。只看 browser.name 会让这一行看起来像解析失败,而不是机器人命中。
作为对照,面向 AI 的列表与通用机器人列表行为不同。在更窄的探针里,分类器对 GPTBot 和 ClaudeBot 回答 isAICrawler=true,对 ChatGPT-User 和 Claude-User 回答 isAIAssistant=true,四者都是 isBot=true。普通 HeadlessChrome 字符串和 Electron 字符串在三个谓词上都保持 false,与上表一致。
Client Hints 在何处不再起作用
第三段喂入一组 Chromium 风格品牌列表和平台头,然后只改 user agent 字符串:
section: client hints
hints-only: browser=undefined/undefined os=undefined device=desktop
ua-safari-plus-chrome-hints: browser=Safari/18.4 os=macOS device=desktop
第一行是人们预期的:没有 user agent、只有 sec-ch-ua 头时,解析器在这条调用路径里什么都不返回。单靠头在这里不足以产生浏览器名字,因为品牌列表由 Client Hints 解析步骤消费而不是通用匹配器,而探针调用的是普通结果。
第二行是意外。user agent 说是 Safari,头说 Windows 上的 Chromium 和 Google Chrome,结果是 macOS 上的 Safari/18.4。在这条路径里字符串获胜,矛盾的品牌列表被忽略,所以一个 user agent 与 Client Hints 不一致的页面,会被报告成字符串声称的内容。在把解析器标签当作交叉校验之前,这是有用的性质:你本以为会被抓到的错配可以直接穿过去。
第二行保留字符串的原因在 parseCH() 里看得到。有品牌列表时,循环遍历每个品牌,跳过任何匹配 /not.a.brand/i 的名字,并且只在很窄的条件下覆盖当前名字:前一个名字必须以 Chrom 开头,或者前一个名字是 Edge 且新品牌是 WebView2。当前一个名字是 Safari 时两条都不成立,所以列表里每个品牌都被检查,却没有一个替换掉已解析的名字。Chromium 这一项只在元素类型是 ENGINE 时用于引擎版本,不用于浏览器名字。
getBrowser().withClientHints() 确实存在并且会读头,它返回的是 thenable 而不是普通对象。探针确认了这一形态,也确认了在矛盾输入上等待它仍然返回 Safari/18.4,因为同一条调和规则保留了非 Chromium 名字。对读者重要的提醒是:同步的 getResult() 和等待的 withClientHints() 是不同的调用形态、不同的答案,报告应当说明标签由哪一个产生。
解析器标签只是对同一次会话的一种读法。当问题是检测器如何处理本次运行产出的形似自动化的名字时,BotD 检测器注册表复核在显式状态上运行另一个公开检测器,而自动化检测与预防列出了页面可以检查的更广泛表面。把它们放在一起读,就不会让一个库代替整个栈。
500 字符上限在何处藏住 token
最后一段测试 src/main/ua-parser.js 里那个常量:
section: marker position vs 500-char cap
pad=430: totalLength=500 markerStart=490 isBot=true
pad=440: totalLength=510 markerStart=500 isBot=false
两个字符串只差在 GPTBot/1.2 token 前面垫了多少字符。总长 500、token 从索引 490 开始时,分类器找到它;总长 510、token 从索引 500 开始时,分类器找不到它。边界正好在 trim(ua, UA_MAX_LENGTH) 截断字符串的地方,所以 token 不是被错误解析,而是从未被看到。
这是一个形态清晰的失败模式:当 token 落在前 500 字符内,页面可被识别为机器人;当同一 token 被长注释或扩展列表推到边界之外,就无声通过。token 本身没变,只是偏移变了。一个在真实长 user agent 上追加标记、然后报告"未检测到"的测试,是在测量上限,而不是测量 token。
缓解办法不是在某份库里抬高常量,因为固定行为正是栈里其他代码写就时依据的行为。而是让观察保持诚实:把输入长度记在结论旁边,当预期出现标记时,确认其偏移落在上限之内。索引 500 处的 10 字符 token 和索引 490 处的同一 token,是同样的字符串内容和不同的证据。
哪些规则列表喂给分类器
分类器不是一个列表,而是三个注册表外层的三个封装。BotTypes 读取 Bots 扩展产出的浏览器 type,把 cli、crawler、fetcher 和 library 当作机器人类型。AIAssistants 点名 Fetchers 注册表里的具体条目,AICrawlers 点名 Crawlers 注册表里的具体条目。这些列表长得有意义:仅固定的 AICrawlers 数组就点名 53 个不同爬虫条目,来自 Anthropic、ByteDance、Cloudflare、Hugging Face、Meta、OpenAI、Semrush、Zhipu 等差异很大的供应商;AIAssistants 数组点名 8 个条目,分别来自 Amazon、Anthropic、Cohere、DuckDuckGo、Google、Mistral、OpenAI 和 Perplexity。
这个结构解释了为什么同一字符串可以既 isBot=true 又 isAICrawler=false。isBot 只问解析出的类型是不是机器人类型;isAICrawler 问解析出的浏览器名字是否匹配 53 个枚举名之一。一个按类型命中 Bots 扩展、却不在 AI 爬虫枚举列表里的爬虫,是机器人但不是 AI 爬虫。两个答案都没错;它们是对两个不同集合的两次查询。
这些列表还会过时。今天存在于固定 53 条数组里的名字,可能在后续版本被移除或改名;在此 commit 之后出现的新爬虫,按构造对所有谓词都不可见。这也是本文固定 commit 而不是分支的原因:答案是列表修订版的属性,与输入字符串一样重要。
变异测试能说明什么、不能说明什么
一个诱人的下一步是改一个 user agent 字符然后宣称解析器脆弱。探针已经提示为什么这会是弱断言。Electron/33.0.0 token 存在于字符串中却什么都没改变,因为探针走过的两条路径都不找它;移除该 token 的变异也同样什么都不会改变,于是测试看起来像在展示稳健,而不是展示一个未被使用的字段。
反过来更有信息量。在 Chrome 字符串上追加 GPTBot/1.2 token,在更窄的探针里把 isBot 从 false 翻成 true,所以针对该 token 的变异证明分类器确实读它。再把同一 token 放在两个偏移 490 和 500 上测试,就隔离出上限而不是 token。单次变异无法区分"解析器忽略这段文本"和"解析器从未看到这段文本",只有偏移对可以。
同样的逻辑适用于头。一次在 Safari user agent 上加矛盾 sec-ch-ua 品牌列表且无变化的运行,是字符串在该调用路径占优的证据。一次完全移除 user agent 并观察到 undefined 的运行,是单靠头不被普通结果调用消费的证据。两次运行、两个不同断言;单次运行会把它们混为一谈。
如何在不夸大的前提下读解析结果
解析器结果支持的是一句窄断言:这个 commit,在给定字符串和头的情况下,产出了这个标签。它不支持关于会话是浏览器、机器人还是人的断言,也不支持另一个站点会得出同样结论的断言,因为另一个站点可能固定另一个版本、传别的头、或问另一个问题。
把四个字段放在一起记录,记录才持续可用。commit,因为模式列表和上限都会在版本之间被修改。输入,逐字并带长度,因为上限使偏移成为输入的一部分。调用形态,因为 getResult() 与 withClientHints() 可能分歧。以及谓词,因为 isBot、isAIAssistant 和 isAICrawler 是三个独立答案,探针已显示它们在同一批字符串上分叉。
关于 navigator 属性的那篇文档介绍了 BotBrowser 如何让 navigator.platform、navigator.userAgentData 和相关值与加载的 Profile 对齐。本文补上读取一侧:一个被广泛使用的解析器对这些值产出的字符串做什么、它的浏览器名字和机器人分类器在哪里分歧、以及它自己的输入上限在哪里让标记不可见。报告值的一致性,与第三方解析的正确性,是两个独立问题。
对真实会话的任何决定,都应使用作出决定的系统经授权的集成结果,而不是从这次源码复核外推。fixture 里记录的解析标签和生产结论是两类不同的证据,夸大恰好发生在两者的落差里。
Practical conclusion
固定 commit,在固定输入上运行解析器,并把长度、调用形态和具体谓词记在每个标签旁边。在这个 commit 里无头 user agent 被叫作 Chrome Headless 而机器人分类器返回 false,Electron 字符串被叫作 Chrome,存在 user agent 字符串时矛盾的 Client Hints 品牌列表被忽略,起点在索引 500 的 token 不可见而索引 490 的同一 token 能被找到。
Sources
- 固定 commit 的 ua-parser-js 主解析器
- ua-parser-js 机器人检测子模块
- ua-parser-js 扩展注册表
- MDN:User-Agent Client Hints API
- MDN:navigator.userAgentData
- BotBrowser navigator 属性文档
Next reading
需要了解头集合本身如何变化时,阅读 Client Hints 指纹;需要了解浏览器从字符串里删掉了什么时,阅读 user agent 缩减与 Client Hints 迁移。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界