Unicode:页面能读到的四种文本身份
在预组合、分解、emoji 与谚文串上运行宿主 ICU,看同一段可见文本被读出四种长度,以及键匹配为何失败。
BotBrowser Team
BotBrowser 支持在声明的 Profile 下重复运行经授权的同源页面 fixture,并保留范围受限的观察:页面报告了什么;但它不能强迫页面返回一段从未调用过 normalize() 的规范字符串、改变某份 ICU 构建携带的 Unicode 版本,也不能让字形簇计数等于代码单元长度。本文在固定的字符串集合上运行 Node 运行时的 ICU,报告页面为同一段可见文本可以读到的四个不同数字:代码单元长度、码点计数、字形簇计数与规范化后的长度。
TL;DR
é写成单个码点与写成e加组合重音时,作为字符串不相等,NFC 之后相等,且给出两个不同的String.length。- 同时容纳两种拼写的
Set大小为二;同一集合经 NFC 后大小为一,所以读者看来相同的文本可能导致键匹配失败。 - emoji 把差距拉得更大:一个家庭 emoji 是八个代码单元、五个码点、一个字形簇。
- 落单的代理项会让
isWellFormed()失败,TextEncoder写一个替换字符,因此有损编码不需要任何错误就能被观察到。 - 排序、大小写与分词都取决于传给它们的 locale,而默认
sort()根本不用比较器。 - 这里的每个数字都来自某一份 ICU 与某个 Unicode 版本;另一份构建可能给出不同结果。
Contents
- 本次运行使用的运行时与 Unicode 版本
- 同一段可见文本的四种长度
- 键匹配在相同文本上失败的地方
- 落单代理项变成替换字符的地方
- 大小写改变字符串长度的地方
- 排序与分词取决于 locale 的地方
- 如何在不夸大的前提下记录一次文本读取
本次运行使用的运行时与 Unicode 版本
探针在任何测量之前先打印运行时、ICU 与 Unicode 版本,因为下面每个数字都是这一组属性的结果。本次运行报告 node=v26.9.0、icu=78.3、unicode=17.0、tz=2026a。另一份 ICU 构建可能带不同的大小写表、不同的排序表与不同的分词规则集,所以缺这些版本的读数无法复现。 ICU 时区别名复核对时区名应用同样的版本限定规则:解析出的字符串是查随附的表,而不是读时钟。
Unicode 版本比看上去更重要。新的 emoji 序列、新的组合标记与属性修正都会随版本升级到来,每一项至少会改变某段字符串下面四个长度中的一个。一份只说"页面报告长度 8"却不带 Unicode 版本的记录无法与另一台机器比较,因为同一段可见文本在一份构建上是八个单元、在另一份上可能是九个,只要某个新序列获得了会改变分词方式的属性。
同一段可见文本的四种长度
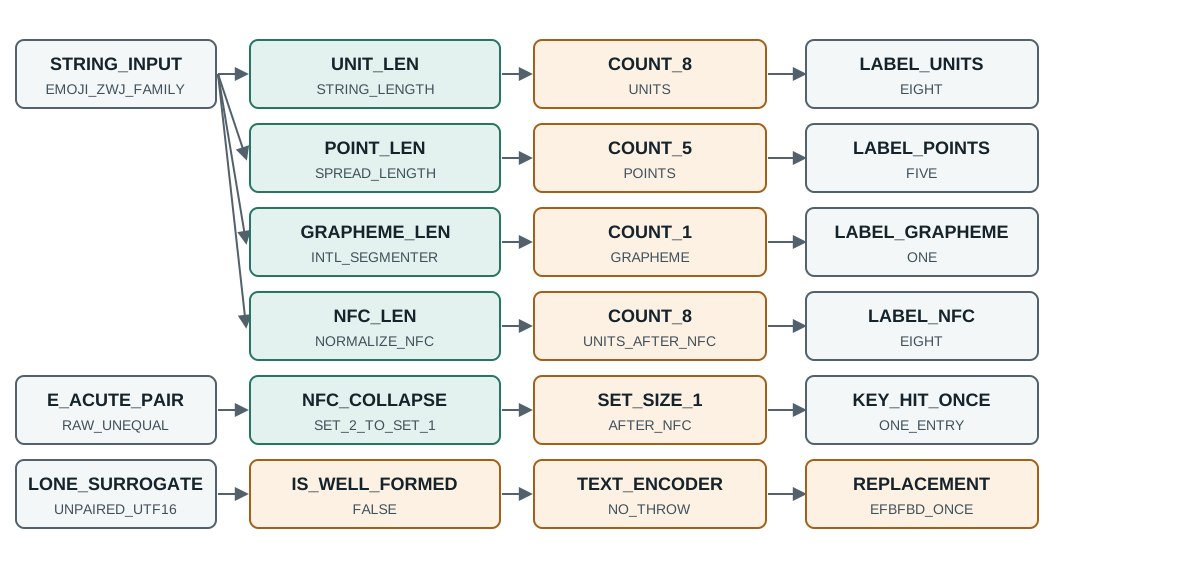
第一个探针用四种方式测量每段字符串:length 计数 UTF-16 代码单元,[...s].length 计数码点,字形簇粒度的 Intl.Segmenter 计数读者感知的一个字符,而 normalize('NFC').length 计数规范组合后的单元数。
e-acute-precomposed: units=1 points=1 nfc=1 nfd=2 cps=U+00E9
e-acute-decomposed: units=2 points=2 nfc=1 nfd=2 cps=U+0065 U+0301
emoji-zwj-family: units=8 points=5 nfc=8 nfd=8 cps=U+1F468 U+200D U+1F469 U+200D U+1F467
emoji-skin-tone: units=4 points=2 nfc=4 nfd=4 cps=U+1F44D U+1F3FD
hangul-syllable: units=1 points=1 nfc=1 nfd=2 cps=U+AC00
hangul-jamo: units=2 points=2 nfc=1 nfd=2 cps=U+1100 U+1161
六行,其中有四个不同的组合:预组合 é 那一行与预组合谚文那一行相同,两行分解形式彼此相同。两行 é 在单元数与码点上不同,但 NFC 之后一致,这是经典情形。家庭 emoji 那一行差距最大:八个单元、五个码点、一个字形簇。谚文那两行显示 NFC 把两个字母合成一个音节,所以规范化长度与预组合那一行完全一致。
实际后果是"长度"并不是一种测量。页面若记录显示名的 str.length,记录的是 UTF-16 单元数,对 emoji 密集的名字可能是读者所说字符数的两倍。页面若记录 [...str].length,记录的是码点数,仍把家庭 emoji 算作五个。只有分词器与读者一致。
字形簇计数才是与感知一致的那个,探针把这一点讲明白了:
segmenter graphemes=1 units=8 points=5
segmenter graphemes=1 units=4 points=2
segmenter graphemes=1 units=2 points=2
segmenter graphemes=1 units=4 points=2
四段不同字符串、三个不同单元计数、各一个字形簇。把名字限制为二十个代码单元的校验器会拒绝五个家庭 emoji(人类读作五个字符);把限制写成二十个字形簇的校验器会接受它们并保存四十个单元和二十五个码点。限制与读者在测量不同东西,只要记录说明用的是哪一个,两者都站得住。
键匹配在相同文本上失败的地方
两行 é 已经暗示了一种失败模式,第二个探针直接测量它:
NFC equal: true
raw equal: false
name keys equal raw: false | nfc equal: true
Set size with two spellings: 2
Set size after NFC: 1
同一名字的两种拼写作为字符串不相等,NFC 之后相等。作为 Set 的键,它们产生两条记录;先经过 normalize('NFC') 则产生一条。这就是支持工具找不到的重复账号、每次请求都因为客户端发了另一种拼写而打不中的缓存、以及因为条目是在会组合的键盘上输入而流量来自不组合的键盘所以失效的屏蔽列表背后的完整机制。
这类失败一点也不罕见。macOS 键盘对带重音的拉丁字母通常产出分解文本,Windows 键盘通常产出预组合文本,而从 PDF 复制粘贴可能按字体的字形映射产出任意一种。两种拼写在屏幕上渲染完全一致,在所有按代码单元比较字符串的语言里都判为不等。
修复办法不是到处规范化一切,因为 NFKC 会改变某些系统视为不同的字符,规范化也可能破坏逐字节签名。正确做法是在决定身份的那条边界上规范化:查找的键、缓存条目的值、查重时的比较。记录应当说明它保存的是哪一种形式,因为已保存的规范化字符串在不再次规范化的情况下无法与未规范化的比较。
落单代理项变成替换字符的地方
规范化不会修复非法文本。含落单代理项的字符串不是良构的,探针同时展示了检查与损失:
lone-surrogate isWellFormed=false units=3
lone-surrogate bytes=61 ef bf bd 62
replacement count=1
isWellFormed() 返回 false,而 TextEncoder 在坏单元处写入 ef bf bd:一个 U+FFFD 替换字符。编码不会抛错。把这样一段字符串发给服务器的页面,发出去的是与它持有的不同的字符串,而调用里没有任何东西报告这次替换。
这种静默替换正是往返会改变值的原因。编码、传输、解码,返回的文本已不再等于输入,而每一步都成功。只检查"请求完成了"的 fixture 注意不到;比较编码前字符串与解码后字符串的 fixture 会注意到,差异恰好是替换字符。
替换还有一个容易忽视的计数后果。含一个落单代理项的字符串与含一个替换字符的字符串在探针输入里都是三个代码单元,所以长度检查通过而值已不同。两个坏单元产生的两个替换字符会给出一段根本不再往返的字符串,而重复的编码-解码循环不会添加更多替换,这意味着编码两次再比较的 fixture 会在第一次就已损坏的数据上给出错误的通过。
对字符串切片是最常见的意外成因。把三个单元的字符串在索引二处切断,或取五个单元的前四个,可能拆开代理对并留下孤立的一半。结果仍是长度符合预期的合法 JavaScript 字符串,所以不会抛错;只有 isWellFormed() 或编码后的字节比较能揭示它。把用户文本截断到显示预算却不检查边界的 fixture,会在任何切口附近含有非 BMP 字符的输入上产生正是这个缺陷。
大小写改变字符串长度的地方
大小写映射不是保持长度的逐字符替换,三个常见字符展示了三种行为:
case "ß" upper="SS" upperUnits=2 lower="ß" lowerUnits=1
case "İ" upper="İ" upperUnits=1 lower="i̇" lowerUnits=2
case "Dž" upper="DŽ" upperUnits=1 lower="dž" lowerUnits=1
德语 eszett 转大写时展开成两个字母。土耳其带点大写 I 转大写仍是一个单元,但在英语 locale 中转小写展开成两个单元,因为小写形式是 i 加一个组合点。标题体二合字母把一个字符换成另一个而不改变长度。三个字符、三种结果,只有一种保持单元计数。
因此把标识符转大写来存不区分大小写的键的系统会改变某些标识符的长度,而在转换大小写之前强制最大长度的系统可能拒绝一个转换后变长的标识符。一旦知道这种展开,两者都容易修;而如果唯一的测试输入是 ASCII,两者都不可见。
locale 维度以一种容易忽视的方式让问题更糟,因为同一个字母会因传入的 locale 而映射不同:
case "I" lower(tr)="ı" upper(tr)="I" lower(en)="i"
case "i" lower(tr)="i" upper(tr)="İ" lower(en)="i"
case "İ" lower(tr)="i" upper(tr)="İ" lower(en)="i̇"
case "ı" lower(tr)="ı" upper(tr)="I" lower(en)="ı"
在土耳其语中 I 转小写为无点 ı,i 转大写为带点 İ,而在英语中两者映射到熟悉的组合。第三行最尖锐:İ 在土耳其语中转小写是一个单元,在英语中是两个单元。固定 locale 的不区分大小写比较得到一种行为;依赖默认 locale 的比较得到运行时选择的行为,而那可能与 Profile 报告的 locale 不同。
在这些计数起作用之前,文本还要经过字体栈才到达页面,而当字形来自另一种字体时,同一段字符串的测量结果可能不同:字形选择会改变每个码点占多少水平空间。CJK 字体渲染给出跨字体栈的测量对照,而 Intl API 的 locale 数据与可移植格式处理同一 locale 依赖下的日期与数字输出。
排序与分词取决于 locale 的地方
排序是 locale 改变答案的第三个地方,探针为同样四个单词给出三种不同顺序:
sort en: apple < äpple < zebra < Zebra
sort sv: apple < zebra < Zebra < äpple
sort default: Zebra < apple < zebra < äpple
en compare zebra/Zebra: -1
英语把 äpple 排在 apple 之后,瑞典语把它排在最后,因为 ä 是排在 z 之后的独立字母,而默认排序把 Zebra 排在最前,因为它比较代码单元,大写 Z 排在小写 a 之前。因此页面渲染的排序列表会在只差 locale 的两个会话之间不同,而对该列表的截图比较会报出一处完全属于排序的差异。
同一个比较器也决定相等性,当映射表以排序文本为键时,因为 Intl.Collator 对默认比较视为不同的字符串返回零。探针在四个敏感度级别上测量了这一点:
sensitivity base: e-acute vs e=0 a vs A=0
sensitivity accent: e-acute vs e=1 a vs A=0
sensitivity case: e-acute vs e=0 a vs A=-1
sensitivity variant: e-acute vs e=1 a vs A=-1
在 base 敏感度下两对都相等,所以用这种比较器构造的键会把 é 与 e 合并、把 a 与 A 合并。在 accent 敏感度下两对朝相反方向分裂。建立在错误敏感度比较器上的"查重"功能,恰好会合并或拆分它本该处理的那两种情形,而这个设置不会出现在输出里。
词分词再添一个与显而易见的分词器不一致的数字:
word segments=5 ["Version","155.0.0","ships","café","file"]
whitespace tokens=6 vs segmenter words=5
按空白切分给出六个 token,而分词器给出五个词类片段,整个差距来自带圈数字 ①,分词器对它的 isWordLike 为 false。去掉它两者都变成五,而把连字 fi 换成 f 也不会改变两者为五,所以连字不是原因。记录在 fixture 里的"词数"完全取决于产生它的方法。
数值排序是最后一个改变顺序的开关,而且改变很大:
numeric on: 1.2.0 < 1.9.0 < 1.10.0
numeric off: 1.10.0 < 1.2.0 < 1.9.0
启用数值比较时,版本按发布页期望的顺序排列。不启用时按文本排列,1.10.0 会排在 1.2.0 之前。用没有数值选项的比较器排序的版本列表,在每个读者看来都是错的,却内部自洽,因此在 diff 里很难被发现。
如何在不夸大的前提下记录一次文本读取
文本读取支持的窄断言是:这个运行时、这份 ICU、这个 Unicode 版本与这个 locale,在这个输入下产出了这四个数字。它不说明读者看到的是同一回事、另一份构建会一致,或服务器以相同方式规范化了这段字符串。
保留六个字段,记录就仍然可核对。运行时、ICU 与 Unicode 版本,因为大小写表、排序表与分词规则都随它们而来。按原样记录的输入,最好以码点形式给出,因为两种输入可能渲染一致。四个长度,每个都写明方法,因为 length、展开长度、分词计数与 NFC 长度是四种不同断言。locale 与比较器敏感度,因为两者都改变答案。在边界上应用的规范化形式,因为保存的 NFC 字符串无法与保存的 NFD 字符串比较。以及编码路径是否产生了替换字符,因为这次替换改变值而不报错。
对应文档页介绍 BotBrowser 如何让字体与 navigator 表面与加载的 Profile 保持一致。本文补上读取一侧:运行时会如何处理这些表面携带的文本、某个 API 返回四种长度中的哪一种,以及 locale 在哪里决定了一个读者以为固定的比较。配置一致与对结果字符串的正确读取是两个独立问题。
对真实会话的任何决定,都应使用作出决定的系统经授权的集成结果,而不是从这次探针外推。fixture 里记录的长度和生产结论是两类不同证据。
Practical conclusion
记录运行时、ICU 与 Unicode 版本,以码点形式记录的输入,四个长度及各自方法,locale 与比较器敏感度,边界上的规范化形式,以及编码器是否写入了替换字符。在这份构建里 é 有两种不同的单元计数、两条记录的集合在 NFC 后塌为一条、家庭 emoji 是八个单元和一个字形簇、落单代理项被编码成一个替换字符而不报错、大小写可以把长度翻倍、排序顺序随 locale 改变。
Sources
- MDN:String.prototype.normalize
- MDN:Intl.Segmenter
- MDN:Intl.Collator
- Unicode 标准附件 15:规范化形式
- Unicode 标准附件 29:文本分词
- MDN:TextEncoder
- BotBrowser 字体文档
Next reading
需要了解同一段文本在不同字体栈下如何测得不同时,阅读 CJK 字体渲染;需要同一 locale 依赖的格式一侧时,阅读 Intl API 的 locale 数据与可移植格式。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界