btoa 与 atob:Latin-1 边界与填充的真相
在带重音、CJK 与 emoji 的字符串上运行 btoa 和 atob,看各自在哪里抛错、atob 返回什么、填充是否可选、哪种字母表会被拒绝。
BotBrowser Team
BotBrowser 支持在声明的 Profile 下重复运行经授权的同源页面 fixture,并保留范围受限的观察:页面调用了哪个编码 API、抛出了什么错误;但它不改变运行时如何实现 btoa 或 atob,不能让只接受 Latin-1 的编码器接受星平面字符,也不会把编码错误变成指纹。本文在带重音、CJK 与 emoji 的字符串上运行这两个函数,然后记录各自在哪里抛错、atob 返回什么、哪些输入无需填充即可解码。
摘要
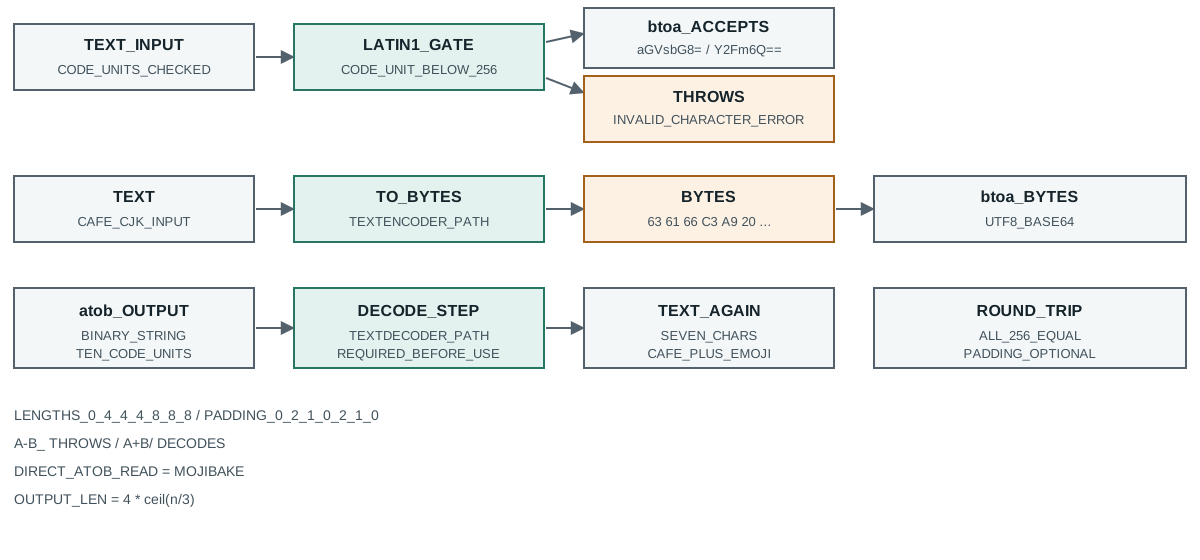
btoa只接受小于 256 的码元。"café"可编码,"ÿ"可编码,但"Ā"(U+0100)与"😀"会抛InvalidCharacterError。- 标准做法是先用
unescape(encodeURIComponent(text))把文本转成字节,再把字节交给btoa。此时结果等于原文本的 UTF-8 字节。 atob返回二进制字符串,不是文本。直接读取得到乱码;再做一次解码才把同样的字节还原成原文。atob接受缺少填充的输入,但拒绝 URL 安全字母表:"a-b_"抛错,"a+b/"可解码。- 输出长度是
4 * ceil(n / 3),所以 0 到 6 字节对应长度 0、4、4、4、8、8、8,并带相应填充。
目录
btoa 在哪里拒绝输入
HTML 标准把 btoa 定义在码元上,限制比多数调用方预期的更窄。输入字符串的每个码元都必须小于 256,也就是只有 Latin-1 文本能通过。六个字符串的测量把边界标得精确:
btoa("hello") -> ok aGVsbG8=
btoa("café") -> ok Y2Fm6Q==
btoa("ÿ") -> ok /w==
btoa("Ā") -> THREW InvalidCharacterError
btoa("😀") -> THREW InvalidCharacterError
btoa("中文") -> THREW InvalidCharacterError
两个结果出人意料。"café" 毫无怨言地编码,因为那个字面量里的带重音字母是单个码点 U+00E9,小于 256,所以不触发异常。"ÿ" 是 U+00FF,仍是能容纳的最后一个码元,也能编码。第一次拒绝是 "Ā" 的 U+0100,刚好越过边界,异常名是 InvalidCharacterError。
emoji 那一行说明失败并不是「非 ASCII」这种粗略分类。emoji 位于基本多文种平面之外,所以存为代理对,两半都是大于 255 的码元。btoa 看到 0xD83D 这个码元就拒绝,根本不会看第二半。只用西欧文本测试的人("café" 是最爱)可能上线一条在每次手工测试里都通过、第一次遇到 emoji 或 CJK 名字就断的路径。
错误对象值得记录,因为它是页面唯一能拿到的信号。没有部分输出也没有返回状态,所以把 btoa 包在 try 里的代码只能靠名字区分 Latin-1 违规与函数缺失。消息文本很短且未规定,因此 fixture 应当断言 error.name 而不是消息。
这条边界不依赖运行时版本。限制写在算法里,所以浏览器与 Node 一致,在 Node 里复现抛错的测试,在运行同一页面的浏览器里也会复现。
还有第二个让人读错边界的原因:带重音那一行与拒绝那一行在屏幕上看起来很像。"café" 与 "Ā" 读起来都是「一个带记号的字母」,但一个编码、一个抛错,因为决定性的属性是数值码点而不是视觉形状。组合的 é 是一个小于 256 的码点;组合的 Ā 是一个更大的码点;而分解的 é 写成 e 加一个组合重音是两个码点,第二个是 U+0301,仍小于 256,所以它也能编码。凭外观而不凭码点推理的人,在这三种情况里至少会预测错一个。
这也解释了面向字节的 API 为何与来自表单、剪贴板或 URL 的文本配合很差。这些来源经常给出分解形式、零宽连接符与 emoji 序列,每一种都会改变哪些码元到达 btoa。记录失败输入的码点而不只是它渲染出的文本,才能让后来的读者复现异常。
把文本转成字节的包装
被广泛复制的修法是两步惯用法。encodeURIComponent 把文本变成 UTF-8 字节的百分号编码字符串,unescape 把每个 %XX 还原成它代表的字节,留下一个码元正好是 UTF-8 字节的字符串。把这个字符串交给 btoa,得到 UTF-8 字节的 Base64。
wrap("café") -> Y2Fmw6k= byteCount=5 btoaMatchesUtf8=true
wrap("😀") -> 8J+YgA== byteCount=4 btoaMatchesUtf8=true
wrap("中文") -> 5Lit5paH byteCount=6 btoaMatchesUtf8=true
这些行给出三个事实。字节数与 UTF-8 长度一致,而不是与 JavaScript 字符串长度一致:"café" 是四个码元但五个字节,"😀" 是两个码元但四个字节,"中文" 是两个码元但六个字节。产出的 Base64 等于同一文本由运行时自身 UTF-8 编码器编码后的 Base64,探针用 btoaMatchesUtf8 标志直接核对。而且包装对这些输入从不抛错,因为执行 btoa 时每个码元已经是一个字节。
这个惯用法有效,但它也带来两个值得点明的负担。unescape 已被弃用,为现代 JavaScript 配置的 linter 会标记它,所以强制该规则的代码库无法使用这种精确形式。而且经由百分号编码会分配三个中间字符串,如果该调用位于编码上千个小热值的循环里就有影响。现代替代方案用 TextEncoder 构造字节字符串:
function btoaUtf8(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = '';
  for (const byte of bytes) binary += String.fromCharCode(byte);
  return btoa(binary);
}
该版本避开 unescape 并产出同样的 Base64,因为 TextEncoder 直接输出 UTF-8 字节。这才是应当教的写法,因为过时的惯用法只是因为它早于旧环境中的 TextEncoder 才存活。
atob 返回什么以及为何需要第二步
atob 是 btoa 的逆,而不是 btoaUtf8 的逆。它返回一个二进制字符串,其码元是解码后的字节,它既不知道也不关心原件是 UTF-8 文本。把这个二进制字符串当作文本来读,就是产生乱码的缺陷,测量给出了确切的字节:
atob(b64) is a binary string of 10 code units: 63 61 66 c3 a9 20 f0 9f 98 80
  read as text directly -> "café ð.." equalToOriginal=false
  after escape/decode  -> "café 😀" equalToOriginal=true
十个字节,每一个都对应 "café 😀" 的 UTF-8 编码:63 61 66 是 caf,c3 a9 是 é 的两字节序列,20 是空格,f0 9f 98 80 是 emoji 的四字节序列。解码后的字节是对的。失败发生在调用方把十字节的二进制字符串当作十字符的原文,而它不是:原文有七个字符,字节数是十。
这段差距正是朴素实现看起来能工作、直到不能工作的原因。对纯 ASCII,一个字节等于一个字符,所以 atob 之后直接使用给出正确答案,每次用英文文本的测试都通过。一旦值里出现多字节字符,字节字符串与文本字符串就分开,跳过第二步的调用方存下损坏的数据。探针在一段 CJK 上把损坏具体化:
wrong-path round trip of "中文测试" -> "ä¸æ..." equal=false
正确路径镜像编码器:取 atob 的二进制字符串,重建字节,按 UTF-8 解码。过时的配对是 decodeURIComponent(escape(binary));现代配对从二进制字符串构造 Uint8Array 并运行 TextDecoder:
function atobUtf8(encoded) {
  const binary = atob(encoded);
  const bytes = Uint8Array.from(binary, char => char.charCodeAt(0));
  return new TextDecoder().decode(bytes);
}
两种写法都把同样的十个字节还原成七个字符。fixture 应当记录的教训是:两种情况里 atob 都成功了,所以只断言「没有抛错」的检查无法发现乱码。记录必须把解码文本与原文比较,这与检查调用是否返回是两回事。
数值比较让差距无处遁形。原字符串有七个字符;atob 的二进制字符串有十个码元。多出的三个全来自两个多字节字符,é 多一个字节,emoji 多两个,合计三个。因此拿长度与原文比较来验证解码值的调用方,对每个含非 ASCII 字符的字符串都会看到不匹配;而跳过比较的调用方会存下更长的字节字符串,直到下游解析器拒绝它才发现。
同一套算术解释了缺陷为何能在随意测试下存活。只编码解码 "hello" 的 fixture 看到五个字节进、八个字符的 Base64、五个字符出,原文与解码文本一致,往返看起来精确。一旦一个带重音字符进入值,字节数与字符数就分开,缺陷出现在之后而不是在从没喂过非 ASCII 字符串的测试里。
填充、省略填充与 URL 安全字母表
Base64 用 = 把输出填充到四的倍数,调用方常假定解码器需要这个填充。测量显示 atob 两种形式都接受:
atob("aGVsbG8") -> ok "hello"
atob("aGVsbG8=") -> ok "hello"
第一个字符串缺了末尾的 =,atob 仍返回 "hello"。这种宽容在服务器为更短的 URL 去掉填充时有用,但也意味着解码器不能用来验证输入是否被正确填充。若 fixture 必须拒绝未填充输入,该检查放在 atob 之前,而不是之内。
字母表则是另一回事。标准 Base64 用 + 与 /;URL 安全变体用 - 与 _。atob 只实现标准字母表,所以 URL 安全字符会抛:
atob("a-b_") -> THREW InvalidCharacterError
atob("a+b/") -> ok "kæÿ"
第二行把四个字符解码成三个字节,恰好构成一个有效的三字符串。第一行在遇到的第一个 URL 安全字符上抛错。因此从 URL、JWT 片段或文件名 slug 拿到的 token 是 URL 安全 Base64,直接交给 atob 就会恰好在使用那两个替换字符的输入上失败。修法是解码前做两行翻译:把 - 换成 +、_ 换成 /,若长度不是四的倍数再补回填充。这次翻译很便宜,而缺少它是「对某些 token 有效、对另一些失败」的常见原因,因为短 token 可能恰好两个替换字符都不含。
长度算术与全字节往返
输出长度遵循一条固定规则,调用方据此可在不先解码的情况下估算缓冲区或发现被截断的字符串。每三个输入字节变成四个输出字符,最后一组一或两字节被填充到该宽度:
bytes=0 base64Len=0 padding=0
bytes=1 base64Len=4 padding=2
bytes=2 base64Len=4 padding=1
bytes=3 base64Len=4 padding=0
bytes=4 base64Len=8 padding=2
bytes=5 base64Len=8 padding=1
bytes=6 base64Len=8 padding=0
模式每三个字节重复:三的倍数无填充,剩一个字节有两个 =,剩两个字节有一个。所以输出长度是 4 * ceil(n / 3),填充数是 (3 - n mod 3) mod 3。调用方在编码前就能预测编码后大小,这在值必须落在列限制或 URL 预算内时很重要:每三个字节花四个字符,所以已知字节数的编码有已知上限。
这种可预测性不止用于估缓冲区。由于编码长度是字节数的纯函数,解码器可以在不解析的情况下拒绝被截断的字符串:若一个值声称编码了一定字节数,但其长度不是 4 * ceil(n / 3),就有东西被切掉了。仅凭填充不是可靠信号,因为 atob 接受未填充字符串,但总长度仍限定了字符串能表示的范围。
全字节范围闭合了回路。把全部 256 个可能字节值经 btoa 编码再经 atob 解码回来,得到逐字节相同的字符串:
all 256 bytes via btoa/atob: byteIdentical=true length=256
这个结果才是调用方真正需要从这对函数得到的保证:进去什么字节,就原样回来,覆盖整个 Latin-1 范围,无丢失也无替换。它也把前文的边界从反面展示出来。btoa 处理 0 到 255 的每个字节值,所以 Latin-1 文本能编码;它只拒绝大于 255 的码元,所以任何 Latin-1 之外的文本都需要先做字节转换。文章的两半从相反方向描述同一条边界。
记录一次编码读数
能通过复审的编码读数会写明边界并证明它。六个字段覆盖可观察部分,且都不保存秘密值:
- 运行时与函数名,让读者知道结果来自标准
btoa与atob而非 polyfill。 - 确切编码成功的字符串与确切抛错的字符串及其错误名,让 Latin-1 边界可复现。
- 是否应用了文本转字节的包装以及它产出的字节数,并与运行时自身 UTF-8 编码器比较。
- 是否执行了解码步骤,以及结果作为文本是否等于原文,而不只是
atob是否返回。 - 使用的字母表是标准还是 URL 安全,填充是否存在。
- 字节数与产出长度,以便核对
4 * ceil(n / 3)规则。
这样一份记录不能显示任何关于数据保密性的东西。Base64 是编码而非加密,读者一步即可还原,所以记录应当保存往返相等与字节数,而不是解码后的内容本身。关于页面的文本与编码处理如何与它报告的字符串相互作用这一更大问题,请阅读 Unicode 规范化与文本身份信号;关于运行时的字节级选择如何在另一个 API 上显露,请阅读 crypto-js 随机来源对比。
两个习惯让读数长期保持诚实。第一,断言错误名与字节数,而不是消息文本,因为边界是标准化的而消息不是。第二,在每个涉及这些函数的 fixture 里至少放一个非 Latin-1 字符串与一个 URL 安全 token,让两种最常见的静默失败无法通过全绿的测试。
公开来源
- MDN:btoa() 全局函数
- MDN:atob() 全局函数
- HTML 标准:宽容的 base64 解码
- RFC 4648:Base16、Base32 与 Base64 数据编码
- MDN:TextEncoder
结论
调用 btoa 前先确认每个码元都小于 256,并用 TextEncoder 把文本转成字节,而不是相信输入。把 atob 当作字节字符串的逆,使用前总要把结果解码回文本。把 URL 安全 Base64 翻译成标准字母表并补回填充,记录字节数与错误名,并在 fixture 里保留一个非 Latin-1 字符串与一个 URL 安全 token,让静默失败一直可见。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界