structuredClone 与 JSON:深拷贝到底保留了什么
对日期、映射、集合、NaN、BigInt、循环与共享引用分别跑 structuredClone 和 JSON 往返,看每种拷贝保留、改变、拒绝还是静默丢弃。
BotBrowser Team
BotBrowser 支持在声明的 Profile 下重复运行经授权的同源页面 fixture,并保留范围受限的观察:页面如何复制一个对象;但它不改变运行时如何实现结构化克隆算法,不能让函数或符号可克隆,也不会把拷贝结果变成身份信号。本文对同一批值分别运行 structuredClone 与 JSON 往返,然后记录各自保留哪些类型、改变哪些数字、拒绝或静默丢弃哪些值,以及共享引用、循环与原型如何表现。
摘要
structuredClone把Date、Map、Set与RegExp保留为这些类型;JSON 往返把Date变成字符串,把Map、Set或RegExp变成{}。- JSON 往返把
NaN与Infinity变成null,把-0变成0;structuredClone三者都保留,包括-0的符号。 structuredClone对函数或符号抛DataCloneError;JSON 静默丢弃函数属性。structuredClone保留BigInt,并在transfer选项下移动一个ArrayBuffer;JSON.stringify对BigInt抛错。structuredClone保留共享引用与循环;JSON 往返复制共享引用并在循环上抛错。- 两者都不保留类原型,所以克隆实例会丢掉方法,除非手动恢复原型。
目录
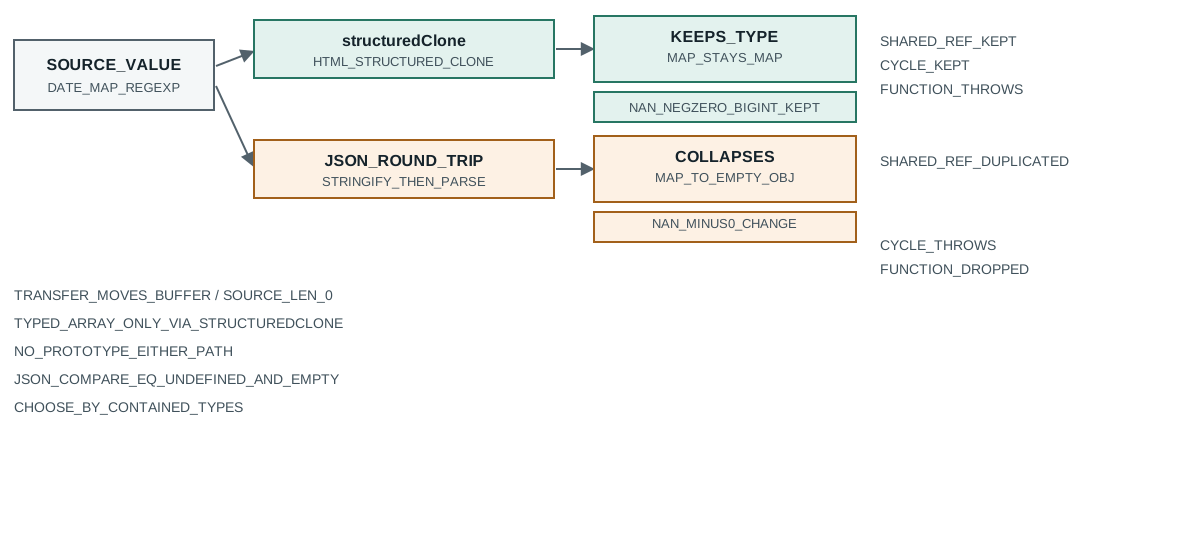
两种拷贝各自保留的类型
两条路径复制值的不一样部分。structuredClone 实现 HTML 结构化克隆算法,对下面这些平台类型有显式分支;JSON 往返只懂序列化 JSON.stringify 支持的东西、再重建 JSON.parse 返回的东西:
structuredClone({d:new Date(0)}) -> {d: Date(1970-01-01T00:00:00.000Z)}
JSON round trip of Date -> {d: "1970-01-01T00:00:00.000Z"}
structuredClone({m:new Map([[1,"a"]])}) -> {m: Map(1=>"a")}
JSON round trip of Map -> {m: {}}
structuredClone({s:new Set([1,2])}) -> {s: Set(1, 2)}
JSON round trip of Set -> {s: {}}
structuredClone(/ab+/gi) -> RegExp(/ab+/gi)
JSON round trip of RegExp -> {}
四行四个差异。Date 经 JSON 变成字符串,所以往返前是 Date 的值往返后是 string,任何 .getTime() 调用都会失败。Map 变成空对象,所以每个条目都无错消失。Set 变成空对象,所以每个成员都无错消失。RegExp 变成空对象,丢掉模式与标志。
静默是危险之处。那四个 JSON 结果都是合法值,typeof 都是对象,所以只检查 typeof 的代码看不出问题。损失在之后出现,当代码在 {} 上调用 Map 方法或用日期字符串做算术时。所以深拷贝必须按值包含什么来选择,而不是按方便:JSON 往返只对由 JSON 自身类型构成的值正确。
类型化数组展示同样的模式,但结果更令人困惑,因为 JSON 产出一个看起来像数组却并非数组的对象:
structuredClone typed array kept: true values=1,2,3
JSON typed array kept: false shape={"0":1,"1":2,"2":3}
structuredClone 返回真正的 Uint8Array,三个值不变,所以 instanceof 通过、每个类型化数组方法都能用。JSON 版本是带数字键的普通对象,所以 instanceof Uint8Array 为 false,byteLength 为 undefined,按下标写入的循环只是赋普通属性。用 JSON 序列化二进制数据再读回的人,得到一个在 JSON.stringify 下记录相同、在任何算术下行为完全不同的结构,所以比较序列化输出无法发现这一变化。只有对结果做类型或长度检查才能显示它。
对象形状只对 JSON 已理解的值保留。普通对象、数组、字符串、有限数字、布尔与 null 往返后结构完好,这正是 JSON 设计覆盖的子集。其他一切要么转换、要么丢弃、要么抛错。因此写出允许类型的 schema 是选择拷贝方法最便宜的方式:若 schema 只含 JSON 类型,往返安全可预测;若它点名了 Date、Map 或类型化数组,structuredClone 是唯一保留它的路径。
独立性是两条路径唯一共有的性质,值得确认而非假定。新克隆与新的 JSON 拷贝各自得到自己的嵌套对象与数组,所以修改一个不会写穿到源:
clone independent: list=true nested=true date=true
向克隆数组追加、修改嵌套属性、给克隆日期设新时间之后,源仍报告三元素数组、原嵌套值与时间戳。所以深拷贝对它保留的值确实很深;上面的差异讲的是它保留什么,而不是它是否让拷贝与源隔离。
数字与 BigInt
JSON 的数字规则比 JavaScript 更窄,往返会静默改变三个看起来可表示的值:
structuredClone({n:NaN,i:Infinity,z:-0}) -> {n: NaN, i: Infinity, z: -0}
JSON round trip of NaN/Infinity/-0 -> {n: null, i: null, z: 0}
Object.is(JSON -0, -0) -> false
Object.is(structuredClone -0, -0) -> true
NaN 与 Infinity 经 JSON 变成 null,因为 JSON 没有它们的字面量,往返含任一个的值会无警告地拿回 null。-0 情形更细:JSON 结果在 === 下数值等于 -0,所以朴素相等检查通过,但 Object.is 区分符号并报告 false,而 structuredClone 保留符号并报告 true。用负零表达某种含义(例如计算中的带符号零)的代码,经 JSON 无错地丢掉这个信号。
BigInt 把两条路径分得更开。structuredClone 能处理,JSON.stringify 对它抛错:
structuredClone(10n) -> BigInt(10)
JSON.stringify(10n) -> THREW TypeError
JSON.stringify 的 TypeError 是整个对比里唯一响亮的失败,值得注意因为它是例外。含 BigInt 的值根本过不了 JSON 边界,而通过 structuredClone 原样通过。改用 BigInt 标识符又保留 JSON 深拷贝的团队,第一次复制这种标识符就会撞上它。
上面的数字变化与 JavaScript Number 精度与跨运行时可移植性 所覆盖的是同一类问题:一个值可以在 === 下数值相等却在 Object.is 下不同,而序列化的拷贝路径正是这种差异变成永久的地方。
被拒绝或被静默丢弃的值
对没有拷贝表示的值,两条路径以最差的方式分歧:一个拒绝,一个丢弃:
structuredClone(()=>1) -> THREW DataCloneError
structuredClone(Symbol("x")) -> THREW DataCloneError
JSON round trip of function property -> {v: 1}
structuredClone({u:undefined}) -> {u: undefined}
JSON round trip of {u:undefined} -> {}
JSON round trip of [1,,3] -> [1, null, 3]
structuredClone 对函数或符号抛 DataCloneError,所以失败立即且发生在拷贝点。JSON 往返静默丢弃函数属性:结果有 v: 1 而没有 f,期望方法存活的人得到没有该方法的普通对象。undefined 属性由 structuredClone 保留、由 JSON 丢弃,数组空洞经 JSON 被替换成 null。
一般形状应记为规则:structuredClone 对它无法表示的值响亮失败,而 JSON 靠丢弃或替换静默失败。对校验路径,响亮的失败更容易捕获和修正。对值必须始终幸存的路径,静默丢弃才是危险,因为拷贝看起来成功而数据已丢。
共享引用与循环
深拷贝不只是类型问题,也是图的问题。同一个对象在源中出现两次时,两种拷贝表现不同:
structuredClone shared reference identical: true
JSON shared reference identical: false
structuredClone 保留引用:若拷贝前 a 与 b 指向同一对象,拷贝后仍指向同一个(新的)对象,所以图形状保留。JSON 往返复制共享对象,因为序列化写两次、解析建两个独立对象,所以 a === b 变成 false。这一区别对任何语义依赖别名的值都很重要,例如两个父节点共享的节点,JSON 拷贝会静默打破别名。
循环是更尖锐的情形。structuredClone 处理自引用对象并让环保持完整,而 JSON 往返抛错:
structuredClone(cycle) -> ok, self===clone: true
JSON round trip of cycle -> THREW TypeError
克隆的 self 指向克隆,所以环存活。JSON.stringify 对循环结构抛错,因为它无法表示无限嵌套,错误是 TypeError。所以带循环的值能由 structuredClone 拷贝、根本不能由 JSON 拷贝,与共享引用情形相反,那里 JSON 拷贝却改变形状。
循环结果还给检查克隆的工具一个教训。逐属性遍历循环对象而不记录已访问的递归 describe 函数会一直递归到栈溢出,所以打印克隆循环图的 fixture 必须在已访问集合处停下,而不是盲目跟随每个引用。克隆本身没问题;失败的是报告代码。当测试对循环值报告 RangeError 时这一区别很重要:错误可能来自断言助手而不是拷贝,修法在助手里而不在拷贝调用。
原型、可转移对象与仍需注意之处
两条路径都不保留类原型。克隆丢掉方法,之后是普通对象:
structuredClone prototype is Point: false
structuredClone has double method: undefined
克隆值有实例字段但没有原型,所以 instanceof Point 为 false,调用 double() 失败。通过 structuredClone 克隆领域对象的团队仍要恢复原型,通常由克隆字段构造新实例或显式设置原型。拷贝是结构化拷贝,不是语义拷贝。
transfer 选项让 structuredClone 不只是深拷贝。把缓冲放进 transfer 列表会移动它而不是复制,源缓冲被分离:
transfer: source byteLength=0 clone byteLength=8
源报告长度为零,因为所有权移到了克隆,所以源不能再使用。这是对正从一个地方交给另一个地方的大缓冲的有意优化,也是陷阱:转移缓冲后再读源会得到空视图,无错误。拷贝读数应记录是否发生过转移,因为转移既改变源又产出克隆。
转移规则还决定拷贝是否真是拷贝。没有 transfer 列表时,缓冲像任何值一样被复制,源保留字节、克隆得到自己的,代价是拷贝期间内存翻倍。有 transfer 列表时所有权移动、总内存不变,这对大到成为拷贝变慢原因之一的缓冲很重要。所以同一个调用因一个选项有两种截然不同的侧写,只测量克隆的 fixture 看不出发生了哪种;它必须记录之后的源长度。
worker 消息用同一套结构化克隆算法,所以本文每个结果都适用于发往并在 worker 中读取的数据。区别是 worker 边界还会对列为可转移的缓冲自动应用转移规则,而同一缓冲不经转移发送两次会被复制两次。在页面与 worker 之间移动大缓冲、再从页面侧读取的团队会发现空缓冲,正如上面的内存内转移,而失败看起来像数据损坏而不是一次把源清空的转移。
还有一处不对称值得记录,因为它会破坏比较代码。structuredClone 保留 undefined 属性、JSON 丢弃它们,所以两个在 JSON 比较下看起来相等的对象,在结构化克隆下可能不同:
structuredClone({u:undefined}) -> {u: undefined}
JSON round trip of {u:undefined} -> {}
先让两个值都过 JSON 再比较的测试,会把带 u: undefined 的对象与不带 u 的对象当成相等,因为两者都序列化为 {}。同一个测试在结构化克隆上会看到一个有键、一个没有。所以建立在 JSON 上的比较助手对某些类型比值的模型允许的更严、对另一些更松,fixture 应当直接比较克隆值,而不是把它们过一遍 JSON 再比较。
记录一次拷贝读数
能通过复审的拷贝读数会说明拷贝保留什么、丢弃什么。六个字段覆盖可观察部分:
- 拷贝方法与运行时,让读者知道算法是结构化克隆还是 JSON。
- 源里的值类型列表,以及拷贝后哪些仍是同一类型。
- 拷贝前后的特殊数字值,含
NaN、Infinity与-0的符号。 - 是否存在函数、符号或
BigInt,以及拷贝是拒绝还是丢弃了它。 - 源是否有共享引用或循环,以及它们是否存活。
- 对缓冲,是否被转移,以及转移后的源长度。
这样的读数不能显示任何关于跨 worker 边界或写入持久存储的拷贝。值可以在内存里干净克隆却仍无法序列化进数据库,而发给 worker 的消息用同一套结构化克隆算法但有自己的转移规则。关于页面的数据模型如何与它报告的内容相互作用这一更大问题,请阅读 浏览器存储模型 与 URL 解析与 search params,后者覆盖值无法通过朴素往返的另一个地方。
两个习惯让读数长期保持诚实。第一,记录类型列表与共享引用结果,而不只是拷贝是否无错返回,因为一个成功却丢掉 Map 的拷贝是抛错检查漏掉的失败。第二,在依赖深拷贝的 fixture 里至少放一个 -0、一个共享引用和一个循环,让静默替换与别名断裂无法通过全绿的测试。
公开来源
结论
按值包含什么来选择拷贝:对 Date、Map、Set、RegExp、BigInt、共享引用与循环用 structuredClone,对由 JSON 自身类型构成的值才用 JSON 往返。预期 structuredClone 对函数或符号响亮失败、JSON 静默丢弃它,并预期 JSON 把 NaN 与 Infinity 变成 null、把 -0 变成 0。任何结构化拷贝后都要手动恢复类原型,并记录缓冲是否被转移,让变空的源不再是意外。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界