URL 解析与 search params:往返会改变什么
解析奇怪的 URL 与查询串,看 new URL 在哪里抛错、归一化改写什么、重复键、加号与排序如何表现,以及为何 set 不等于直接赋值。
BotBrowser Team
BotBrowser 支持在声明的 Profile 下重复运行经授权的同源页面 fixture,并保留范围受限的观察:页面解析了哪个 URL、解析器改写了什么;但它不改变运行时如何实现 WHATWG URL 算法,不能让相对字符串在没有 base 时解析,也不会把归一化的 URL 变成身份信号。本文解析一组棘手的 URL 与查询串,然后精确记录 new URL 在哪里抛错、归一化改写哪些字符、重复键与加号如何存活,以及为何设置查询参数与直接赋值原始 search 字符串不同。
摘要
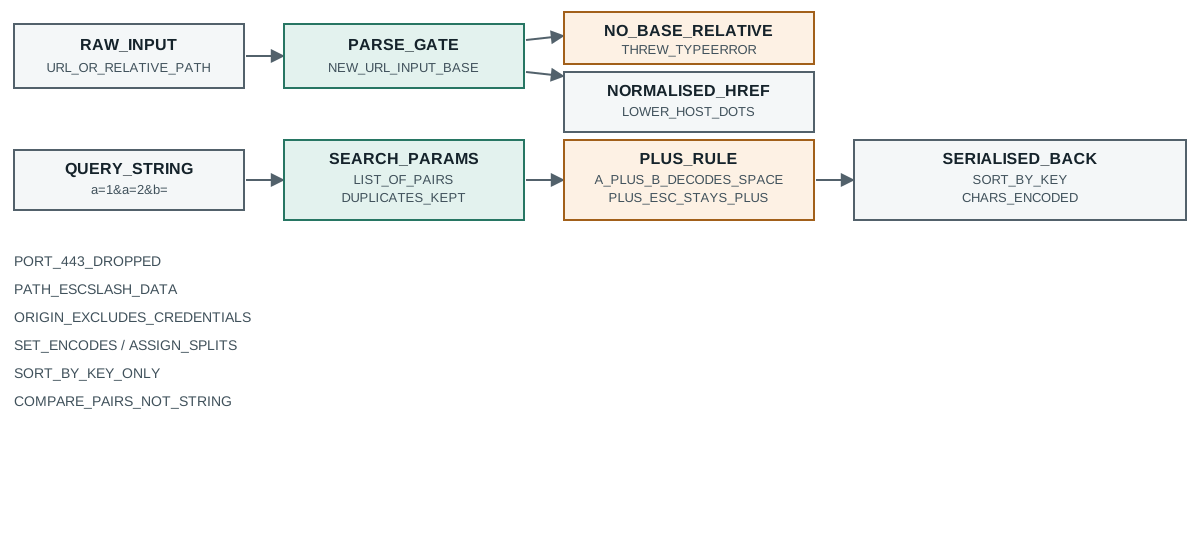
new URL对相对字符串且无 base 时抛TypeError。同一字符串提供 base 后解析成功,路径里的空格变成%20。- 解析是归一化而非身份:
HTTPS://Example.TEST:443/a/../b/./c变成https://example.test/b/c丢掉默认端口并解析点段。 URLSearchParams保留重复键,把+当空格,并在序列化时对值里的&与=做百分号编码。sort()按键重排;插入顺序在调用前保持不变,所以往返可改变字符串而不改变数据。searchParams.set与直接赋值url.search的编码方式不同:前者对空格做百分号编码,后者交给 URL 解析器处理。
目录
new URL 在哪里抛错,base 在哪里救场
构造函数有两种形式,只有一种能解析相对引用。没有 base 时,输入必须已是绝对 URL;只有路径的字符串没有可依附之处,解析器会抛错: 解析后的 URL 也是保存前必须拷贝的值,structuredClone 与 JSON 展示了深拷贝保留哪些类型与引用、JSON 往返又静默丢弃哪些。
new URL("/a/b?x=1", undefined) -> "THREW TypeError"
new URL("/a/b?x=1", "https://example.test") -> "https://example.test/a/b?x=1"
new URL("a b", "https://example.test/dir/") -> "https://example.test/dir/a%20b"
new URL("../../x", "https://example.test/a/b/c") -> "https://example.test/x"
第一行是常见缺陷:代码从配置、表单字段或链接拿到值后调用 new URL(value) 却不给 base,对每个相对路径都会抛错,而吞掉错误的 try 块会把错误 URL 变成静默的 undefined。第二行给出修法,用 base 解析同一字符串。
第三、四行显示解析不是字符串拼接。相对路径里的空格被百分号编码成 %20,../../x 从 /a/b/c 上溯三层得到 /x,而不是字面追加。期望原始输入经过构造函数后原样不变的人,在这两种情况下都会惊讶,因为输出是归一化的 URL,不是传入的字符串。
这一区别对相等比较很重要。两个指向同一资源的字符串可能解析成同一个 href,而一个字符串在归一化后可能解析成不同的 href。用比较输入串与输出串来证明「什么都没变」的 fixture,在任何需要归一化的输入上都会失败;而用比较两个解析后的 URL 来证明等价,即使输入看起来不同也可能通过。
归一化改写了什么
解析器把 scheme 与主机转小写、去掉默认端口、解析点段,并对每个组件中不允许的字符做百分号编码。四个输入并排展示改写:
raw="HTTPS://Example.TEST:443/a/../b/./c"
  href="https://example.test/b/c"
  origin="https://example.test" protocol="https:" port=""
raw="https://example.test/a%2Fb?q=a b#frag ment"
  href="https://example.test/a%2Fb?q=a%20b#frag%20ment"
  pathname="/a%2Fb" search="?q=a%20b" fragment="#frag%20ment"
raw="https://user:[email protected]/x"
  username="user" password="pass"
第一个输入一次丢掉三样东西:大写的 scheme 与主机转成小写,显式 :443 消失因为它是 https 的默认端口,/a/../b/./c 折叠成 /b/c。存了原始字符串再与 href 比较的人,会看到一个完全属于归一化的差异。
第二个输入展示更细微的一点。路径里编码的斜杠 %2F 原样保留,因为它是对一个否则会改变路径结构字符的刻意转义;查询与片段里的原始空格变成 %20;片段里的空格也被编码。所以路径保留编码斜杠,而查询与片段编码了字面空格。对整个 URL 做一次粗暴的「全部编码」或「全部解码」会破坏 %2F,这正是解析器要对每个组件按各自规则处理的原因。
第三个输入显示凭据被解析进 username 与 password 并重新序列化进 href,而 origin 排除它们。这对日志很重要:origin 可安全记录与比较,而 href 可能携带不应写进日志或 fixture 记录的用户名与密码。为带凭据的 URL 保存 href 的读数保存了秘密;保存 origin 与 pathname 的没有。
每个组件有自己的规则集,这就是对整条 URL 做单次编码或解码不安全的原因。scheme 与主机比较并小写存储;端口等于 scheme 默认值时被丢弃;路径解析点段并把编码斜杠当数据保留;查询应用加号到空格的规则并对保留字符做百分号编码;片段编码原始空格但保留片段自身结构。把整个 href 拿去做 decodeURIComponent 再传给 new URL 的人通常会得到不同的 URL,因为解码步骤把编码斜杠与编码 amp 号变成解析器会读作结构的字符。安全单位是组件,不是整条字符串。
这套组件模型也解释了为什么两个看起来不同的 URL 解析后可能相同。HTTPS://Example.TEST:443/b/c 与 https://example.test/b/c 产出同一个 href,因为解析器首先小写并去掉默认端口。比较原始字符串的去重步骤会把它们当成不同并都存下,而比较解析后 href 的步骤会把它们合并。哪个正确取决于目标:缓存键想要合并形式,让两种拼写命中同一条目;审计日志可能想要原始形式以保留原始输入。读数应当说明它保存哪种形式。
重复键、加号与值编码
URLSearchParams 是键值对列表而非映射,几项行为由此而来。重复键保留,空值存在但为空,而含有 & 或 = 的值在列表序列化时被百分号编码:
params.getAll(a) -> ["1","2"]
params.get(b) -> ""
params.get(c) -> "&="
params.toString() -> "a=1&a=2&b=&c=<encoded ampersand><encoded equals>"
getAll 返回两个 a 值,所以用 get('a') 的人只看到第一个并静默丢掉其余。get('b') 返回空字符串,这与缺失键的 null 不同:单独的 b= 存在但值为空,而检查 if (value) 的代码把两者都当假。解码成 &= 的值会重新序列化并把 amp 号与等号再次编码,所以原始字符串往返了,但解码后的值显示调用方真正想要的字符。
加号是另一个陷阱。在查询串里 + 表示空格,所以合法包含加号的值必须百分号编码成 %2B:
searchParams from a+b -> "a b"
Map-like set round trip -> "q=a%2Bb"
第一行显示 new URLSearchParams('q=a+b').get('q') 返回 "a b",因为解析器把加号读成空格。第二行显示从值为 a+b 的对象构造同一列表会序列化成 q=a%2Bb,所以加号作为数据保留。不对称就是缺陷:用字符串拼接构造查询的人写 q=a+b 之后读回 a b,而走 URLSearchParams 与值对象的人保留加号。两条路径对同一个意图值产生分歧,只有一条能往返。
三种不同转义解码成两种不同字符,只有逐项列出的读数才能捕捉差异。原始 + 解码成空格,%20 解码成空格,%2B 解码成加号。所以 q=a+b、q=a%20b、q=a%2Bb 是三种不同编码:前两者携带值 a b,第三携带 a+b。把查询解码再用通用编码器重编码的人会把前两者合并成一种形式,并可能按所用编码器丢失或凭空造出第三个里的加号。解析转储里记录的 ?a=%2B+%20 正是同一个参数里的这个三元组:加号、空格、空格,分别由 %2B、+、%20 解码而来;把三者都当数据的重编码会改变字符串,即使解码后的值不变。
重复键与同样的解码相互作用。查询 a=1&a=2&b= 解析成三个键值对,两个键为 a,一个键为 b 值为空,再序列化回完全相同的字符串 a=1&a=2&b=。这条恒等值得记录,因为它是例外而非规则:这条字符串已处于规范序列化,所以解析再序列化保持不变,而含原始空格或非规范转义的字符串会改变。只用已规范输入的 fixture 永远看不到归一化,所以至少一条非规范输入应当放进集合。
排序与往返的代价
列表有插入顺序,sort() 按键重排。在调用 sort() 之前,顺序就是追加的顺序:
insertion order -> "k9=9&k8=8&k7=7&k6=6&k5=5&k4=4&k3=3&k2=2&k1=1&k0=0"
sorted order -> "k0=0&k1=1&k2=2&k3=3&k4=4&k5=5&k6=6&k7=7&k8=8&k9=9"
以递减顺序追加的十个键按该顺序序列化,sort() 把它们变成递增。数据前后相同,只有序列化字符串变了。这就是往返的代价:若 fixture 构造查询、序列化、再解析并比较字符串,比较可能仅因顺序而失败。比较键值对集合而非字符串的 fixture 是稳定的。
对重复键还有第二个后果。sort() 对比较相等的键是稳定的,所以两个同键条目在排序后保持相对插入顺序。期望 sort() 也把同键内的值排序的人得不到;值保持追加顺序,只有键分组改变。
这条稳定性可测且值得直说:sort() 之后 a=1&a=2 仍是 a=1&a=2,不是 a=2&a=1,因为两个键比较相等且排序稳定。想要同键内值有序的人必须在追加前单独排序,而假设 sort() 已做到的人会发布随插入顺序变化而波动的输出。要记录的规则是:sort() 只按键排序,相等键保持输入顺序。
长度是往返不是转换的又一个原因。把查询解析成列表再序列化回去,即使键值对相同也可能改变字符串长度,因为一个 %20 变成 +、一个原始空格变成 %20,取决于路径。断言往返后字节长度固定的 fixture 会在某些输入上通过、在另一些上失败,原因与缺陷无关。改为测量键值对数量与键集合,就能让断言在所有都正确的编码选择之间保持稳定。
设置参数与直接赋值 search
修改 URL 对象的查询有两种方式,编码方式不同:
set("q","a b+c&d=e") href -> "https://example.test/?q=a+b%2Bc%26d%3De"
search = "?q=a b+c&d=e" href -> "https://example.test/?q=a%20b+c&d=e"
第一行走 searchParams.set,按查询串规则对值做百分号编码:空格变成 +,加号变成 %2B,& 与 = 变成 %26 与 %3D,所以整个值留在一个参数内。第二行直接以原始字符串赋值 url.search,解析器把 & 与 = 当分隔符:值变成 a b(空格编码为 %20),c 与 d 变成独立参数。
两个结果不是同一个 URL,差异并非表面。set 保持意图值完整;原始赋值把它切成三个参数,因为分隔参数的字符正是调用方想要的数据。手工构造查询再赋值的人必须在赋值前对每个保留字符做百分号编码,而用 set 的人交出原始值让 API 去编码。
还有一处空格差异值得注意。set 为空格产出 +,而原始赋值产出 %20。两者都解码成空格,但两种序列化不同,所以逐字节比较两个 href 会失败,即使它们携带同一个逻辑参数。这也是比较解析值而非序列化字符串的又一个理由。
记录一次 URL 读数
能通过复审的 URL 读数会说明它解析了什么、改变了什么。六个字段覆盖可观察部分,且都不保存凭据:
- 输入字符串与所用 base,或未提供 base 且解析抛错的事实。
- 得到的
origin、pathname、search、fragment,分别记录而不是一个href,让凭据与归一化可见。 - 查询键值对列表以
[key, value]条目记录,含重复与空值,而不是一条重建字符串。 - 序列化查询里的空格是
+还是%20,因为两者解码相同但序列化不同。 - 键值对顺序以及是否调用了
sort(),因为顺序改变字符串而不改变数据。 - 查询如何被修改,经由
searchParams.set还是原始search赋值,因为两者对保留字符编码不同。
这样的记录不能显示任何关于服务器或代理会如何解释同一 URL 的东西。客户端用一种方式解析,服务器框架可能用自己的规则解码并重新解析查询,而重定向可能在传输中重写字符串。关于页面解析后的 URL 如何与它报告的字符串相互作用这一更大问题,请阅读 URL 协议检测与隐私 与 btoa 与 atob 的边界,后者覆盖查询值经过的编码层。
两个习惯让读数长期保持诚实。第一,记录 origin 与键值对列表而不是一个 href,让归一化与凭据可见,而不是融进一条不透明字符串。第二,比较解析后的键值对而非序列化字符串,让顺序与 + 还是 %20 的选择无法把正确的往返变成假失败。
公开来源
结论
当 URL 可能相对时总提供 base,并预期解析器归一化而不是保留输入字符串。把 URLSearchParams 当键值对列表,让重复键与空值存活,并记住 + 解码成空格。改变值时用 searchParams.set 并让它编码保留字符,或在赋值 search 前自行对每个保留字符做百分号编码。记录 origin 与键值对列表而不是一个 href,并比较解析后的键值对而非序列化字符串。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界