crypto-js 的随机来源:你的构建用了哪一条分支
阅读 crypto-js 4.2.0 与 3.1.2 的源码,再测量每个版本调用哪一个随机来源、一次请求要付多少次调用,以及模拟对象能改变什么。
BotBrowser Team
BotBrowser 支持在声明的 Profile 下重复运行经授权的同源 fixture,并保留范围受限的观察:页面调用了哪个 API、调用了多少次;但它不能查看浏览器的熵池、认证随机性质量,也不能把库的调用次数变成身份信号。本文阅读两个已发布的 crypto-js 构建,然后测量可观察的部分:每个版本绑定哪个随机来源、一次请求付多少代价、测试桩能替换什么。
摘要
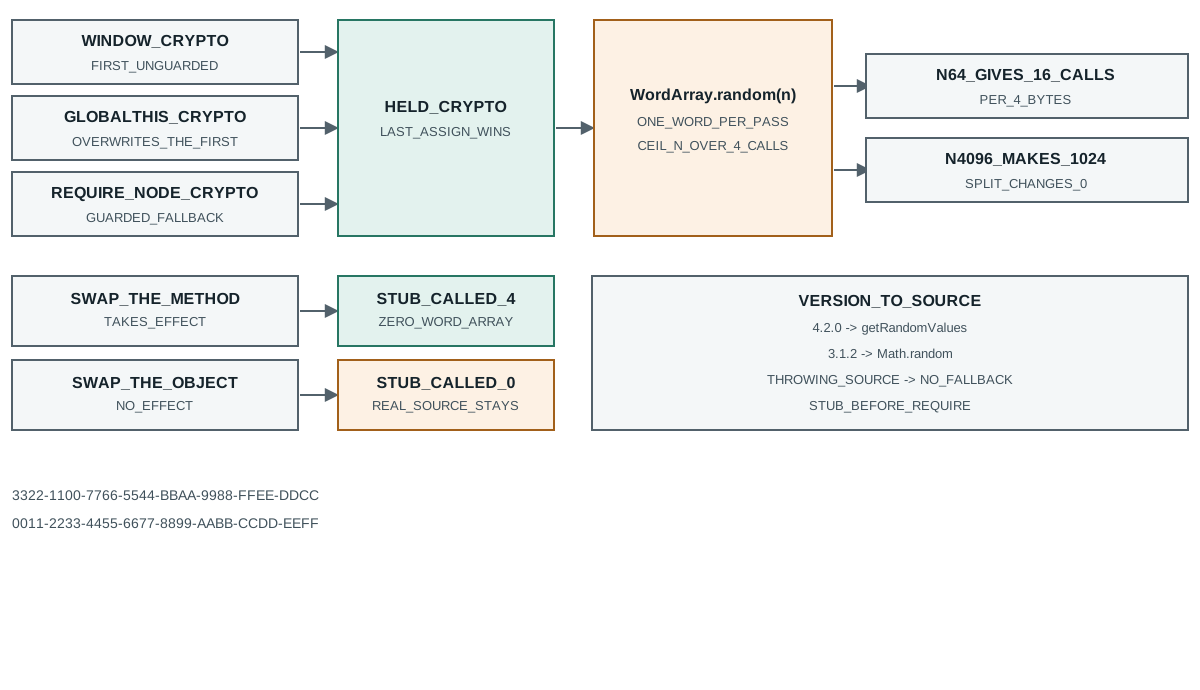
[email protected]每填一个词都调用crypto.getRandomValues;[email protected]调用Math.random。两者 API 表面一致,只有解析到的来源能区分。- 一次
WordArray.random(n)请求约产生n / 4次随机调用,所以 64 字节要付十六次往返,而不是一次。 core.js的绑定循环有三处赋值不检查是否已找到来源。globalThis.crypto会覆盖window.crypto上的桩,所以只替换window.crypto的 jsdom 测试看到零次桩调用。- 模块加载后,替换已持有对象上的方法有效,替换整个
globalThis.crypto对象无效。 - 桩抛出异常时,
4.2.0只抛出自己的通用错误,不会回落到Math.random。
目录
每个构建绑定哪个随机来源
已发布的 [email protected] 的 core.js 先声明 var crypto;,再按固定顺序执行六处赋值。顺序比旁边的注释更重要,因为只有后三处会检查是否已经找到来源。
// [email protected] core.js
if (typeof window !== 'undefined' && window.crypto) crypto = window.crypto;
if (typeof self !== 'undefined' && self.crypto) crypto = self.crypto;
if (typeof globalThis !== 'undefined' && globalThis.crypto) crypto = globalThis.crypto;
if (!crypto && typeof window !== 'undefined' && window.msCrypto) crypto = window.msCrypto;
if (!crypto && typeof global !== 'undefined' && global.crypto) crypto = global.crypto;
if (!crypto && typeof require === 'function') crypto = require('crypto');
前三行没有防护,每一行都可能覆盖上一行的结果。在浏览器里 self 与 window 是同一个对象,所以第二行只是把第一行重写一遍。在同时定义了 window 对象的 Node 进程里,第三行用 globalThis.crypto 覆盖了前两行的结果。带防护的后三行只在什么都没找到时才有意义。
这一处细节解释了一个看似不可能的测试结果。jsdom 测试常会写 globalThis.window = { crypto: 桩 } 来控制随机性,然后 require 库并等待桩被调用。在现代 Node 进程里一次也等不到,因为 globalThis.crypto 存在,第三行在模块加载完成前就把桩换掉了。
测量证实了这一点。两个子进程只有一行不同,各自统计一次 WordArray.random(16) 请求中的桩调用与原生调用:
window stub with globalThis.crypto present -> {"stubCalls":0,"allZero":false}
window stub with globalThis.crypto absent  -> {"stubCalls":4,"allZero":true}
第一种情况下桩一次没收到,真实 crypto 对象收到四次调用。第二种情况下,在 require 之前把 globalThis.crypto 设为 undefined,桩拿到了全部四次,并产出一个全零的词数组,这正是填充零字节的桩应有的结果。
两个库版本站在同一个 API 的两侧。二者都提供 CryptoJS.lib.WordArray.random(nBytes),返回对象形状相同,所以只检查 sigBytes 的测试在两边都通过。在同一个进程里对两个来源做插桩就能分开它们:
one call each in one process: getRandomValues=4 (v4.2.0) Math.random=4 (v3.1.2)
v3.1.2 random(16): Math.random=4
同样一次 16 字节请求,现代构建调用 getRandomValues 四次,3.1.2 调用 Math.random 四次。旧辅助函数读 Math.random() 并放大成 32 位整数;新辅助函数向 crypto 对象要 new Uint32Array(1) 并取第零个元素。两条路径对页面来说都不明显更慢,返回类型也一致,所以 package.json 里的版本号是判断打包产物内含哪一条的唯一低成本办法。
一次随机请求的代价
词辅助函数每趟填一个 32 位词,所以循环次数直接跟随请求的字节数。对 crypto 对象计数而不是对时钟计数,规则就显现出来:
v4.2.0 random(4) -> getRandomValues calls=1
v4.2.0 random(16) -> getRandomValues calls=4
v4.2.0 random(64) -> getRandomValues calls=16
64 字节要付十六次调用,不是一次。对正整数而言代价是 Math.ceil(n / 4),而浏览器配额按每次调用计算而不是按请求,所以实际上限是 16,384 次四字节调用,而不是一次 65,536 字节。循环里大量生成随机材料的任务,付出的是很多次小配额检查而不是一次大的。
这条规则对想留在配额内的 fixture 有直接影响。4,096 字节要付 1,024 次往返,把它拆成八次 512 字节调用总代价相同,因为每一次调用本身又被拆成一百二十八个四字节词。在 API 边界上分组不能减少随机调用次数,只有总字节数能。测试里大量生成密钥材料的循环,无论请求一个数组还是多个,都会在同一个总大小处触到配额。
同一规则的另一面是时间。在被测机器上一千次 32 字节请求在几毫秒内完成,小到循环开销在被测材料用途的成本旁边不可见。所以值得记录的是调用次数而不是耗时:耗时随机器与负载变化,次数不变。
小数与非法尺寸展示了循环的边界,且都不抛错:
random(0) -> words=0 sigBytes=0 hexLen=0
random(4) -> words=1 sigBytes=4 hexLen=8
random(4.5) -> words=2 sigBytes=4.5 hexLen=10
random(16) -> words=4 sigBytes=16 hexLen=32
random(-1) -> words=0 sigBytes=-1 hexLen=0
负数请求返回空词数组,其 sigBytes 为 -1,十六进制编码器输出空串而不是抛错。把 sigBytes 当长度检查的代码会拿到一个假值但不是零的值,这正是能通过 if (words.sigBytes) 而在后面的序列化里失败的那种值。
对合法请求,输出长度是稳定的。同一进程内五千次 16 字节请求每次都产生三十二个十六进制字符:
5000 calls of random(16): hex length min=32 max=32
这点稳定值得说明,因为它区分了两件测试容易混淆的事。固定长度证明编码器一致;它对字符背后的随机性一无所说。两个断言需要不同证据,只有第一个便宜可查。
测试桩在哪里输给后来的全局对象
替换随机来源是确定性测试的常规做法,失败方式很隐蔽:桩装上了,断言通过了,桩却一次没被调用。模块加载完成之后,两种放置方式表现不同。
post-load swaps -> {"methodSwapAllZero":true,"objectSwapAllZero":false}
替换库已持有对象上的 getRandomValues,下一次结果就变了,词数组返回全零。此后把 globalThis.crypto 换成新对象则什么都不变,因为库在加载时保留了那个对象的引用,再也不会去查全局。第一种形式是测试能用的;第二种会静默地把真实来源留在原地。
顺序出于同样原因也重要。先设 globalThis.window.crypto 再 require 库的测试,是在和第三处无防护赋值对抗。在 require 之前设置或清空 globalThis.crypto,才是能命中绑定循环执行时那一刻的放置方式。
第三种不同行为是 crypto 对象存在但拒绝。一个 getRandomValues 永远抛错的桩给出这个结果:
getRandomValues always throws -> threw: Native crypto module could not be used to get secure random number.
库吞掉了原始错误并抛出自己的简单消息。调用方看到的已经不是原来的拒绝名称,所以想区分配额问题与来源缺失的页面必须检查 crypto 对象本身,而不是库抛出的错误。同样重要的是,4.2.0 在这种情况下不会回落到 Math.random。静默降级的风险属于 3.1.2,那里 Math.random 是来源而不是后备。
调用方仍可以在不读库代码的情况下区分两种失败。在发起请求前检查 crypto 对象是否暴露 getRandomValues;如果暴露了,抛出的错误来自来源而不是绑定缺失。这次检查只花一次属性读取,却把含糊的错误变成一个判断,这正是 fixture 需要把 source-missing 与 source-refused 分开记录的原因。
十六进制文本从哪里来
词数组保存 32 位词,十六进制编码器从最高字节读到最低字节。这一步与库版本无关;变化的是四个字节如何变成词。把同样十六个随机字节按两种解释输入,效果就看得出来: 同一分组边界在文本为传输而编码时出现:btoa 与 atob 的边界 展示了字节字符串与字符串如何分开,以及为什么解码步骤在文本重新一致之前是必须的。
entropy bytes: 00112233445566778899aabbccddeeff
WordArray(little-endian words, as the randomBytes branch) -> 3322110077665544bbaa9988ffeeddcc
WordArray(big-endian words)                               -> 00112233445566778899aabbccddeeff
endianness changes the hex: true
两次运行消耗了完全相同的字节,却产出了不同文本。差别在分组规则而不在熵:一种读法把每组四字节当作小端,另一种当作大端,编码器如实打印它拿到的 32 位值。因此两台分组方式不同的机器做比较,会报告一个与随机性无关的差异。
有符号形式不会增加第二重差异。-1146447480 与 -1122868 以及它们的无符号等价 3148519816 与 4293844428 编码成同样的十六个十六进制字符,因为编码器对每个字节取掩码:
signed words [-1146447480,-1122868] -> bbaa9988ffeeddcc
unsigned words [3148519816,4293844428] -> bbaa9988ffeeddcc
sign is lost in the hex: true
这就是为什么用 readInt32LE() 读四字节、可能产生负词的 Node 分支,在小端机器上仍与浏览器分支一致。被测机器报告小端,在这台机器上两个分支用同样的字节构成同样的词。大端机器则不会,因为浏览器分支取 Uint32Array 元素的机器解释,而 Node 分支显式固定小端。最后这句是对两条代码路径的阅读,不是测量:这里只运行了小端情形,大端情形留给拥有该硬件的人作为开放检查。
跨机器比较的实用结论比看上去更窄。两台机器跑同一构建且都是小端,分支无关,文本一致。版本不同则来源变了,文本一致只是巧合。两个产物之间的差异能说明两个变量里哪一个动了,前提是字节序记录在旁边,这又是记录需要的一个字段。
口令加密从来源取走什么
AES.encrypt 有两种相似但用途不同的入口。把字符串当口令传入时,库要派生密钥与 IV,这条路径先生成盐。传入已解析的密钥并显式给出 IV 时,派生整段被跳过。
AES.encrypt(passphrase) -> getRandomValues calls=2
AES.encrypt(key+iv) -> getRandomValues calls=0
passphrase output header="Salted__" saltBytes=8
explicit key+iv deterministic across runs: true
八个盐字节付两次调用,符合每趟一个词的规则。输出字符串在固定头部之后、密文之前带着八个盐字节,所以同样口令与同样明文两次运行只在这八个字节以及由它们派生的一切上不同。显式密钥形式零调用,两次运行输出相同,这正是确定性测试需要而保存的产物不能有的性质。
两种密钥派生的默认代价也相距很远。口令路径使用与 OpenSSL 兼容的派生,默认一次迭代,而独立的 PBKDF2 辅助函数默认 250,000 次:
EvpKDF keySize=12 iterations=1: 0.06 milliseconds
PBKDF2 default iterations=250000: 851 milliseconds
两个数字都来自同一台机器并随负载变化,请当作数量级而不是基准。它们支持的结论稳定:为保存的产物选择口令辅助函数买到的是盐和一次快速派生,而不是慢速派生;提高迭代次数是调用方必须显式做出的另一个决定。
记录一次库随机来源读数
能通过复审的读数会写明输入与边界。六个字段覆盖可观察部分,且不保存任何生成的随机材料:
- 包名与精确版本,加上提供词辅助函数的文件,因为绑定顺序是那个文件的属性。
- 两个来源各自的调用次数,
getRandomValues与Math.random,针对一次声明尺寸的请求。 - 请求尺寸与得到的
sigBytes,用于核对调用次数是否符合每趟一个词。 - 机器的字节序,因为它决定两个分支的文本是否一致。
- 桩是在模块加载之前还是之后安装的,以及它替换了哪个对象。
- crypto 对象拒绝时产生的错误文本,包括原始错误名是否保留。
这份记录是测试可以断言的依据,并且小到能放进复审笔记。它不能支撑任何关于随机性质量、唯一性,或页面会报告什么机器属性的说法。调用次数是形状,不是熵的测量;稳定的十六进制长度是编码器的属性,不是来源的证据。关于这些调用落到的浏览器侧约定,请阅读 加密随机性可观察面与浏览器指纹;关于把逐组件结果与自身摘要分开的固定版本收集器,请阅读 FingerprintJS OSS 采集与来源。
两个习惯让库读数长期保持诚实。第一,依赖升级后重跑调用计数,因为改版本可以在不改 API 的情况下换掉来源,3.1.2 与 4.2.0 的差别正是如此。第二,记录一旦绑定顺序改变就会失败的那项检查,这里是带原生全局与不带原生全局时的桩调用次数。只保存产出长度的记录这两种变化都发现不了。
公开来源
- crypto-js 源码:core.js
- crypto-js 版本发布
- MDN:Crypto.getRandomValues
- Web Cryptography API 规范
- MDN:Math.random
结论
先读你实际发布的那个构建的 core.js 标签版本,再对一次已知尺寸的请求统计两个来源各自收到的调用次数。把版本、调用计数、字节序与桩的放置位置写进记录。把产出的文本当作编码器结果,让随机材料留在记录之外,并在此依赖变动时重跑计数。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界