ICU 时区别名与你实际报告的 TZ
问 ICU 页面真正读到的时区身份:别名如何折叠、TZ 何时生效,以及为什么固定偏移在 1 月与夏令时区一致而在 7 月分歧。
BotBrowser Team
BotBrowser 支持在声明的 Profile 下重复运行经授权的同源页面 fixture,并保留范围受限的观察:页面报告了什么;但它不能强迫 ICU 返回它编译时没有的名字、改变某个 ICU 版本视为规范的拼写,也不能因为两个时区在 1 月读同一个时钟,就让固定偏移表现得像夏令时区。本文在固定的时区名列表上运行 Node 自带的 ICU,报告 Intl.DateTimeFormat().resolvedOptions().timeZone 对每个名字的回答,然后区分三件常被混为一谈的事:页面读到的名字、它渲染出的偏移,以及提供默认值的那个环境变量。
TL;DR
- 大多数历史拼写仍然可用,但 ICU 会用自己的规范名回答:
Asia/Kolkata报告Asia/Calcutta,Europe/Kyiv报告Europe/Kiev。 UTC、Etc/UTC、Etc/GMT、GMT与Zulu全部折叠为UTC,所以报告的字符串无法区分它们。- 设置
process.env.TZ会改变下一次Intl调用报告的默认值;显式timeZone选项在该次调用中胜出,且不改变默认值。 Etc/GMT+5与America/New_York在 1 月渲染同一个时钟,在 7 月相差一小时,所以一次冬季采样无法区分固定偏移与夏令时区。- 偏移并不限于整点:
Asia/Katmandu报告GMT+5:45,Pacific/Chatham报告GMT+13:45。 - 这里的一切都是某一对 ICU 与 tzdata 的属性;它不说明任何网站如何给会话打分。
Contents
本次运行使用的 ICU
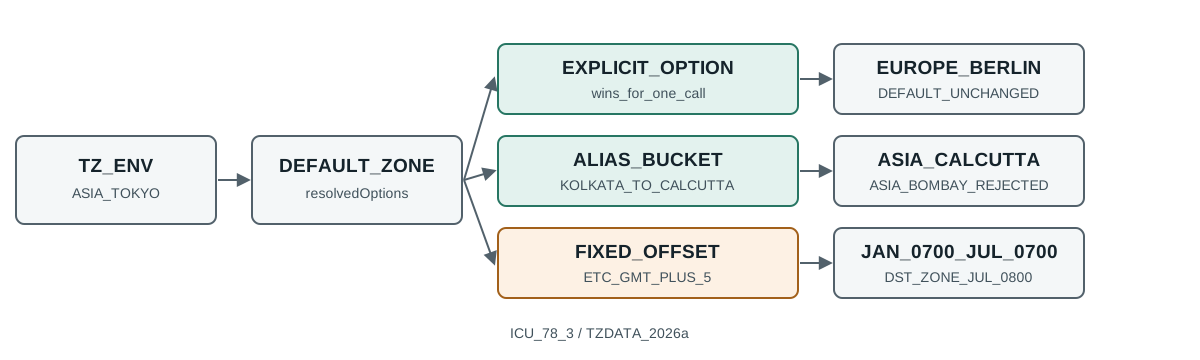
探针在其他一切之前打印 ICU 与 tzdata 版本,因为下面每条结论都限定在这一对上。运行报告 icu=78.3、tz=2026a,node=v26.9.0。另一份 ICU 构建可能带另一张规范表:今天被当作别名的拼写,之后可能变成规范名,随着弃用名退役,这种情况确实发生过。
这一行版本号是让时区复核保持诚实的最省办法。一份只说页面"报告 Europe/Kiev"却不说是哪个 ICU 与 tzdata 产生的报告无法再核对,因为答案是查随运行时发布的表,而不是按时钟计算。同时记下两个版本,把轶事变成可复现的观察,也解释了为什么两台浏览器版本相同的机器会给出不同答案。
向 ICU 要规范名,而不是输入
探针把 21 个名字送入 new Intl.DateTimeFormat('en-US', { timeZone: zone }).resolvedOptions().timeZone。有意思的性质是答案往往不是输入本身:
Asia/Calcutta -> Asia/Calcutta
Asia/Kolkata -> Asia/Calcutta
Europe/Kiev -> Europe/Kiev
Europe/Kyiv -> Europe/Kiev
Asia/Rangoon -> Asia/Rangoon
Asia/Yangon -> Asia/Rangoon
Asia/Saigon -> Asia/Saigon
Asia/Ho_Chi_Minh -> Asia/Saigon
Pacific/Ponape -> Pacific/Ponape
Pacific/Pohnpei -> Pacific/Ponape
每一对都是同一个时区的旧拼写与新拼写,ICU 把两者都解析到同一个规范名。折叠方向很重要:在这份构建里旧拼写胜出,所以报告 Asia/Calcutta 的页面很可能被配置成 Asia/Kolkata,而报告 Europe/Kiev 的页面可能被设成 Europe/Kyiv。报告出的字符串证明的是这个 ICU 规范到哪,而不是调用方传了什么。
折叠也不限于弃用名。UTC、Etc/UTC、Etc/GMT、GMT 与 Zulu 全部返回 UTC,US/Eastern 返回 America/New_York。五个不同输入变成一个输出,所以只读规范名的比较无法区分它们,只保存该字段的记录已经丢失了再也找不回来的信息。
21 个被探测的名字里有十个原样返回,比上面的成对结果暗示的更多:UTC、Etc/GMT+5、Etc/GMT-5、Asia/Calcutta、Europe/Kiev、America/Buenos_Aires、America/New_York、Asia/Rangoon、Pacific/Ponape 与 Asia/Saigon。原样组并不意味着"已经规范",而意味着"已经是这张表偏好的拼写"。两个 GMT 变体在其中,却仍携带相反的偏移。它们是偏移相反的独立时区,POSIX 的符号约定与通常习惯相反。在下面对比测试里,UTC 为 12:00 时 Etc/GMT+5 渲染 07:00,而 Etc/GMT-5 渲染 17:00。
未知名字会响亮地失败而不是被规范化:Mars/Olympus 抛出 RangeError,更接近的拼写错误 Asia/Calcuttta、America/New_Yrok、Europe/Kievv 与 Europe/Berlin1 同样如此。只有大小写变体能解析,所以 asia/kolkata 与 ASIA/KOLKATA 都回答 Asia/Calcutta;带多余空格的名字会像任何未知字符串一样被拒绝。结论比看上去更窄:拼错的时区会被拒绝而不是被悄悄映射,但拼写正确的别名会被悄悄重映射,页面仅凭报告的字符串无法区分这两种结局。因此一个报告出合理时区的页面通过了一项检查,即名字存在,且没有失败任何一项,因为它报告的名字仍可能与配置的不同。
数一数多少输入落进同一个桶
别名的结构数起来比逐名阅读更容易理解。第二遍把九个候选输入按解析结果分组:
bucket Asia/Calcutta <- Asia/Kolkata, Asia/Calcutta
bucket REJECTED <- Asia/Bombay
bucket Asia/Dhaka <- Asia/Dacca, Asia/Dhaka
bucket Europe/Kiev <- Europe/Kyiv, Europe/Kiev, Europe/Uzhgorod, Europe/Zaporozhye
这四行给出四个发现。印度时区吸收两种拼写;Asia/Calcutta 的长名字是 India Standard Time,偏移是 GMT+5:30,所以旧名字并不描述另一个国家。孟买更早的 Asia/Bombay 在这张表里根本不存在,被直接拒绝,说明这张表不是所有曾用名的完整历史。达卡吸收旧拼写 Asia/Dacca。而基辅时区吸收四个输入,其中包含乌克兰西部两个地理上不同的城市,它们解析到同一条规范记录。
最后那个桶会击穿朴素推理。把规范名当作地点描述的人,会把 Europe/Kiev 读成"会话声称在基辅"。在这份构建里它同样覆盖配置成 Europe/Uzhgorod 的会话,那座城市在约 600 公里之外。规范字符串是一条表记录,不是关于机器站在哪里的断言。
被拒绝的用例从另一个角度成为有用的反例。如果这张表接受所有历史别名,那么拒绝就是配置错误的强证据。既然并非如此,拒绝只能证明这个具体拼写在本次 ICU 构建里不存在。安全的说法很窄:这个输入在这里未被接受,所以页面报告的时区来自另一条路径。
TZ 环境变量到底在哪里生效
第二个探针把默认值与显式选项分开,而"这个浏览器在哪个时区"的大部分困惑正来自这里。
TZ as inherited: resolved=America/Toronto toTimeString=07:00:00 GMT-0500 offset=GMT-5
TZ set at runtime: resolved=Asia/Tokyo toTimeString=21:00:00 GMT+0900 offset=GMT+9
explicit option wins over env: Europe/Berlin
default after explicit call still: Asia/Tokyo
invalid zone rejected: RangeError
long name part: Eastern Standard Time
这六行里能看到三个行为。运行时修改 process.env.TZ 会改变下一次无选项 Intl 调用报告的内容,resolvedOptions() 与 toTimeString() 都变,所以在这个运行时里环境默认值并不是在进程启动时冻结的。显式 timeZone 选项在该次调用里压过环境变量,并且不改变后续调用的默认值,它们仍报告 Asia/Tokyo。而 America/New_York 在 1 月的长名字是 Eastern Standard Time,这个名字本身会随日期变化。
对 fixture 的后果是:除非记录说明 X 是怎样提供的,"页面报告时区 X" 就是含糊的。带 TZ 启动且没有逐次调用选项的进程报告的是环境默认值;传显式选项的页面报告的是代码里的决定。两者一致时会产生同一个 resolvedOptions().timeZone 字符串,只有记录下来的输入能区分它们。这也是为什么只引用时区的支持报告无法复现:同一个字符串可能来自任一路径,所以第一个问题应是这个值从哪里进入进程。
同一区域还有二阶陷阱。因为 TZ 由运行时读取而不是页面读取,从 shell 配置继承的值可能存活到一个自以为在测试 Profile 派生值的测试里。探针把继承来的时区显示为 America/Toronto,它来自宿主环境而不是任何页面选项。只记录规范时区的 fixture 会把它归因于被测 Profile。运行前检查环境,并记下变量是启动时设置还是之后修改的,这是测量 Profile 与测量 shell 之间的差别。
显式选项也不会永久改写默认值。探针先用 TZ 设定默认值,再用显式时区格式化,然后向新的格式化器询问默认值,仍然得到环境值。同一次脚本里的连续两次读取可能因此不一致,如果其中一次传了选项,而不加标注地交错两种调用形态的比较,会看起来像时区在两次读取之间变了。
读偏移,而不只是读名字
时区身份通常被记为一条字符串,但同一个时区按提问方式可以渲染出六种名字形态:
name shortOffset: GMT-5
name longOffset: GMT-05:00
name short: EST
name long: Eastern Standard Time
name shortGeneric: ET
name longGeneric: Eastern Time
它们不是可互换的证据。GMT-5 与 GMT-05:00 携带偏移而不含季节,因此全年稳定。EST 内嵌冬季称谓,7 月会读作 EDT。ET 与 Eastern Time 与季节无关,两者都成立。一份记录"页面说 EST"又去和夏季采样比较的报告,比较了两条不同标签,可能报出虚假变化。
偏移也不限于整点,这是个在真实时区上会失效的常见假设:
zone Asia/Kathmandu -> Asia/Katmandu GMT+5:45
zone Australia/Eucla -> Australia/Eucla GMT+8:45
zone Pacific/Chatham -> Pacific/Chatham GMT+13:45
zone Asia/Kolkata -> Asia/Calcutta GMT+5:30
加德满都还规范成另一种拼写 Asia/Katmandu,并渲染 45 分钟偏移。查塔姆在 1 月渲染 GMT+13:45,因为它的夏令时规则属于南半球。一个期望偏移落在整点、或期望正值只在某个大小以内的校验器,会把探针里这四行全部读错而不报任何错误。
语言维度再加第三个变量。同一时刻同一时区会因 locale 不同而渲染不同,顺序与时钟约定都变:
locale en-US: hourCycle=h12 hour12=true -> Jan 15, 2026, 7:00 AM
locale en-GB: hourCycle=h23 hour12=false -> 15 Jan 2026, 07:00
locale de-DE: hourCycle=h23 hour12=false -> 15.01.2026, 07:00
locale fr-FR: hourCycle=h23 hour12=false -> 15 janv. 2026, 07:00
locale ja-JP: hourCycle=h23 hour12=false -> 2026/01/15 7:00
en-US 是唯一使用 12 小时制的一行,ja-JP 打印 7:00 没有前导零,而其他 h23 行打印 07:00。因此把日期按字符串跨语言归一化的比较会标出四处差异,而它们全是格式,不是会话状态。
固定偏移在哪里模仿夏令时区
最后一段采样相隔一年的两个日期,这是区分固定偏移与观察夏令时所区的最省办法:
dst America/New_York: 07:00 / 08:00
dst Etc/GMT+5: 07:00 / 07:00
dst Europe/Berlin: 13:00 / 14:00
America/New_York 与 Etc/GMT+5 对 1 月时刻都渲染 07:00,所以一次冬季采样无法区分它们。到 7 月它们相差一小时,而 Europe/Berlin 显示同样的 13:00 到 14:00 的位移。只取一个时间戳就宣布时区一致的报告,测量的是某一天的吻合,而不是时区的同一性。
偏移对比测试从另一侧说同一件事:
pair Etc/GMT+5 vs America/New_York: 07:00 / 07:00
pair Etc/GMT-5 vs Asia/Karachi: 17:00 / 17:00
pair UTC vs Etc/UTC: 12:00 / 12:00
每一对在采样时刻都吻合,却描述不同时区。三对里有两对在 7 月也会吻合;只有第一对会分歧,因为只有一方观察夏令时。这就是"只比冬季"的陷阱:它对表里每一对都给出吻合结果,包括六个月后会分歧的那一对。
如果 fixture 只能负担一次采样,诚实的说法是"这两者在这一天吻合"。在相反季节再取一次几乎不花成本,却能把那句话变成"这两者描述相同的偏移规则",而那才是多数时区复核真正想下的结论。
南半球让采样规则比"取夏天和冬天"更严。Pacific/Chatham 在 1 月渲染 GMT+13:45,那是它的夏天,所以把它当冬季读数的人把季节弄反了。Australia/Eucla 保持恒定的 GMT+8:45,因为它根本不切换。相隔半年的两次采样仍然能把它们分开,但前提是记录把时刻与渲染值放在一起,而不是凭假设给某次采样贴上"冬季"标签。
选取时刻也很重要。取 12:00 UTC 的采样让两个日期保持干净可比,而接近本地午夜的采样可能同时移动渲染出的日期和小时,只保存小时的比较会把日期位移读成缺了一天。记录精确的 ISO 时刻可以零额外成本地消除两种含糊。
时区只是三个相邻字段中的一个,而三者遵循不同规则,只记录它的 fixture 是不完整的。时区、locale 与语言介绍三者如何相互作用,而 navigator language 与应用本地化说明语言列表有它自己的规范化问题:一个有序数组要与单一协商头比较。
如何在不夸大的前提下读时区身份
一次时区读取支持的是一句窄断言:这份 ICU 构建,在这个输入下,对这个时刻报告了这个规范名与这个渲染偏移。它不陈述配置了哪个别名、该时区是否观察夏令时、哪个 locale 产生了渲染字符串,也不陈述网站如何对待报告它的会话。
记录里保留五个字段,读取就仍然可核对。ICU 与 tzdata 版本,因为规范表与夏令时规则都随它们而来。按传入记录的输入名,因为规范化把它丢掉了。采样的时刻,因为固定偏移与夏令时区在冬季一致。调用形态,因为环境默认值与显式选项填的是同一个输出字段。以及带 hourCycle 的 locale,因为渲染字符串取决于两者。
对应文档页介绍 BotBrowser 如何让时区、locale 与语言与加载的 Profile 保持一致。本文补上读取一侧:ICU 对这些设置产出的名字做了什么、哪些拼写折叠成一个答案、多少输入共享同一个桶,以及在哪里一次采样无法区分两个不同时区。配置一致与对报告字符串的正确解释是两个独立问题,只记录规范名的 fixture 两个都没完整回答。
对真实会话的任何决定,都应使用作出决定的系统经授权的集成结果,而不是从这次探针外推。fixture 里记录的规范名和生产结论是两类不同证据,夸大恰好发生在两者的落差里。
Practical conclusion
记录 ICU 与 tzdata 版本、输入名、采样时刻、调用形态,以及带小时循环的 locale。在这份构建里旧拼写在四个桶中赢得规范化,Asia/Bombay 被直接拒绝,五个 UTC 类输入折叠成 UTC,TZ 设定的默认值会被显式选项覆盖而不再改变,偏移包含 45 分钟的取值,而固定偏移在 1 月与夏令时区一致、在 7 月分歧。
Sources
- MDN:Intl.DateTimeFormat
- MDN:Intl.DateTimeFormat resolvedOptions
- IANA 时区数据库
- CLDR 时区别名数据
- BotBrowser 时区、locale 与语言文档
Next reading
需要了解三个字段如何相互作用时,阅读时区、locale 与语言;需要同一 Profile 的语言一侧时,阅读 navigator language 与应用本地化。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界