IA de scraping web : ce que le modèle ne voit pas
Comprenez comment un outil de scraping IA réduit les données du navigateur avant le modèle, et comment vérifier une valeur sans confondre contexte et page.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
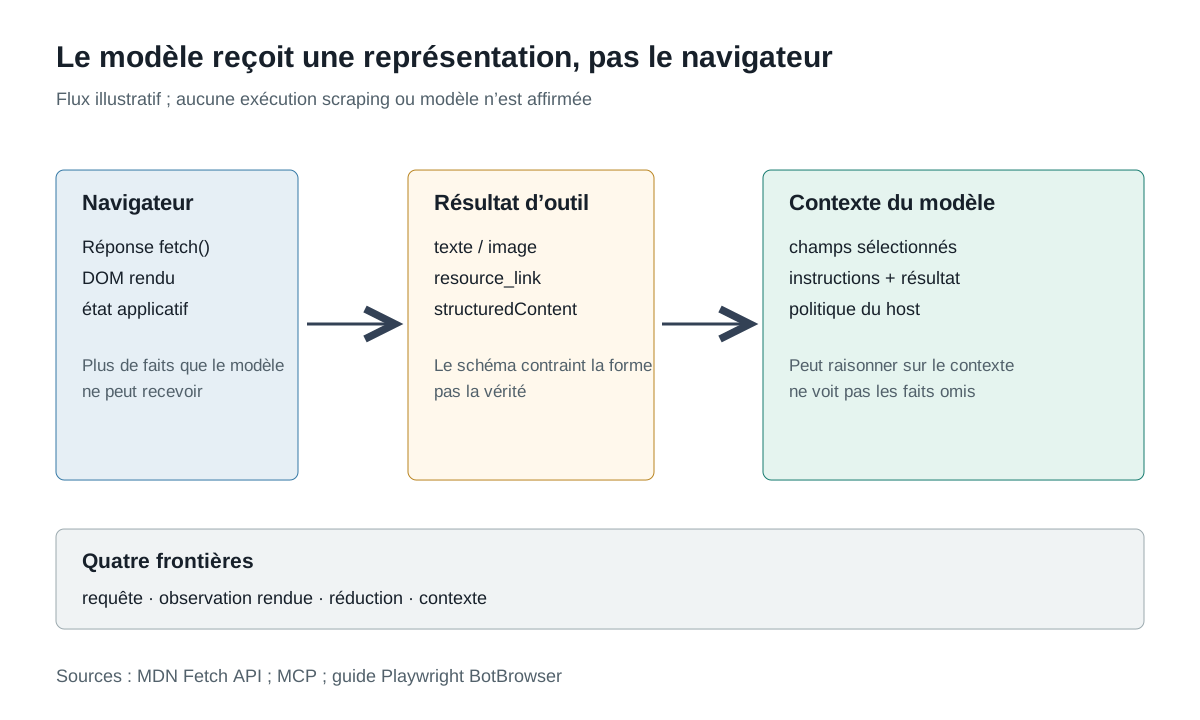
Un pipeline de scraping assisté par IA peut renvoyer une liste ordonnée de produits sans que le modèle voie jamais l’état complet du navigateur qui les a produits. Il peut recevoir un instantané d’accessibilité, une extraction texte, une capture, un objet JSON sélectionné ou un message d’outil. BotBrowser configure un processus Chromium contrôlé avec des entrées Playwright et profil documentées ; il ne garantit pas les données transmises au modèle, ce que celui-ci conserve, ni l’exactitude d’une valeur. Le contexte du modèle est une représentation du travail, pas le travail entier.
La guide d’évidence des API de scraping demande ce qu’un service décide à la place de l’appelant. L’analyse de fraîcheur des décisions demande si une observation reste valable au moment de l’action. La frontière décisive est ce qui subsiste après l’entrée du résultat navigateur ou outil dans le contexte du modèle.
TL;DR
- Un navigateur peut exécuter une requête, rendre une page et exposer beaucoup d’informations ; un résultat d’outil ne contient que ce que son implémentation choisit.
- Un
Responserenvoyé parfetch()signifie que les en-têtes sont arrivés, pas que le statut HTTP est réussi ni que le corps a été analysé. - Les outils MCP peuvent renvoyer texte, image, audio, liens de ressources ou ressources intégrées, avec du contenu structuré et des schémas optionnels. Un schéma valide décrit la forme, pas la vérité.
- Le contexte peut omettre un champ, une requête échouée, un élément caché, une redirection ou une ligne supprimée sans que le modèle sache que l’omission existe.
- Conservez la provenance de chaque champ décisif : URL, méthode, versions navigateur/outil, règle, validation et preuve non renvoyée.
- Vérifier une affirmation peut exiger la réponse brute, une nouvelle observation contrôlée, un endpoint applicatif ou une décision humaine. Le modèle ne peut pas inventer cette couche.
Sommaire
Le modèle reçoit une représentation sélectionnée
Imaginons une page produit construite comme exemple. Le navigateur reçoit du HTML, exécute des scripts, demande des données API et peut rendre une liste virtualisée. L’outil peut ensuite retourner un texte de cinq noms, une capture de la première vue ou un tableau structuré titre/prix. Ces sorties ne sont pas interchangeables : contenu, méthode et conclusions possibles diffèrent.
La spécification des outils MCP décrit des capacités contrôlées par le modèle et invoquées par tools/call. Elle permet texte, images, audio, liens de ressources et ressources intégrées, ainsi que structuredContent et des schémas de sortie. L’architecture MCP confie au host l’agrégation du contexte et l’intégration du modèle. Ce sont des règles de protocole et de responsabilité, pas une garantie que l’outil renvoie le navigateur entier ni que le modèle reçoit chaque octet.
| Frontière | Exemple construit | Ce que le modèle peut savoir | Ce qui reste hors contexte |
|---|---|---|---|
| Requête navigateur | Une page et une API ont été demandées | Seulement ce que l’outil rapporte | Trace réseau, requêtes sans rapport et temps d’origine |
| Page rendue | Cinq cartes visibles et un modèle caché | La représentation choisie par l’outil | DOM hors écran, contenu inaccessible et état applicatif |
| Réduction de l’outil | [{title, price}] | Les champs et métadonnées retournés | Lignes supprimées, nœuds source et règle de sélection |
| Contexte du modèle | Le prompt contient le tableau | Le tableau et ses instructions | Processus navigateur, identifiants, cache et état distant interne |
La première ligne ne devient pas complète parce que le navigateur démarre. Le guide Playwright de BotBrowser montre comment l’exécutable, le profil et le proxy sont transmis ; ces entrées rendent l’environnement explicite. Elles ne définissent ni le schéma du résultat ni le transfert de chaque observation vers le modèle.
Un objet Response n’est pas une extraction réussie
HTTP révèle parfois une différence cachée par un résultat compact. La référence MDN Fetch API indique que fetch() résout le Response dès l’arrivée des en-têtes, même pour un statut HTTP d’erreur. Le code doit examiner statut, en-têtes et corps avant de décider ce que signifie le résultat.
La récupération et l’extraction ont des critères d’acceptation distincts. La frontière crawler-scraper empêche de confondre une URL récupérée avec un enregistrement validé avant son entrée dans le modèle.
L’outil pourrait renvoyer cet objet construit :
{
  "ok": true,
  "items": [{ "title": "Example item", "price": 19.99 }]
}
ok: true montre que l’outil a choisi ce booléen, pas pourquoi. La requête a pu se terminer, un analyseur a pu trouver un tableau, la page n’a pas levé d’exception, ou une règle métier a accepté une ligne. Ce sont des frontières de succès différentes. Un schéma peut valider le booléen et le tableau, sans décider si le résumé du modèle est vrai ou si la page affichait plus de produits.
La spécification MCP distingue donc erreurs de protocole et d’exécution, et demande aux clients de valider avant de transmettre au modèle. La validation limite les données mal formées, pas la perte de représentation. Le modèle raisonne sur ce qu’il reçoit ; il ne voit ni Response, ni page complète, ni candidats rejetés, sauf si l’application les conserve et les transmet.
La réduction supprime plus que des espaces
L’extraction texte normalise les espaces, supprime le balisage et choisit une zone visible. Ces opérations peuvent améliorer l’efficacité et modifier ce qui reste vérifiable. Dans une grille avec panneau de détails, un instantané peut garder les noms visibles et omettre un prix présent dans une infobulle. Une capture montre le prix sans clé de registre. Un JSON contient le prix sans devise, stock ou révision.
Réduire n’est pas automatiquement faux. Il faut demander si les faits omis soutenaient l’affirmation prévue. Le suivi de prix exige montant et devise ; la détection de changement exige clé et révision ; l’index de recherche exige URL canonique et titre. Un modèle qui résume un tableau ne peut pas inventer de manière fiable des champs que l’extracteur n’a jamais inclus.
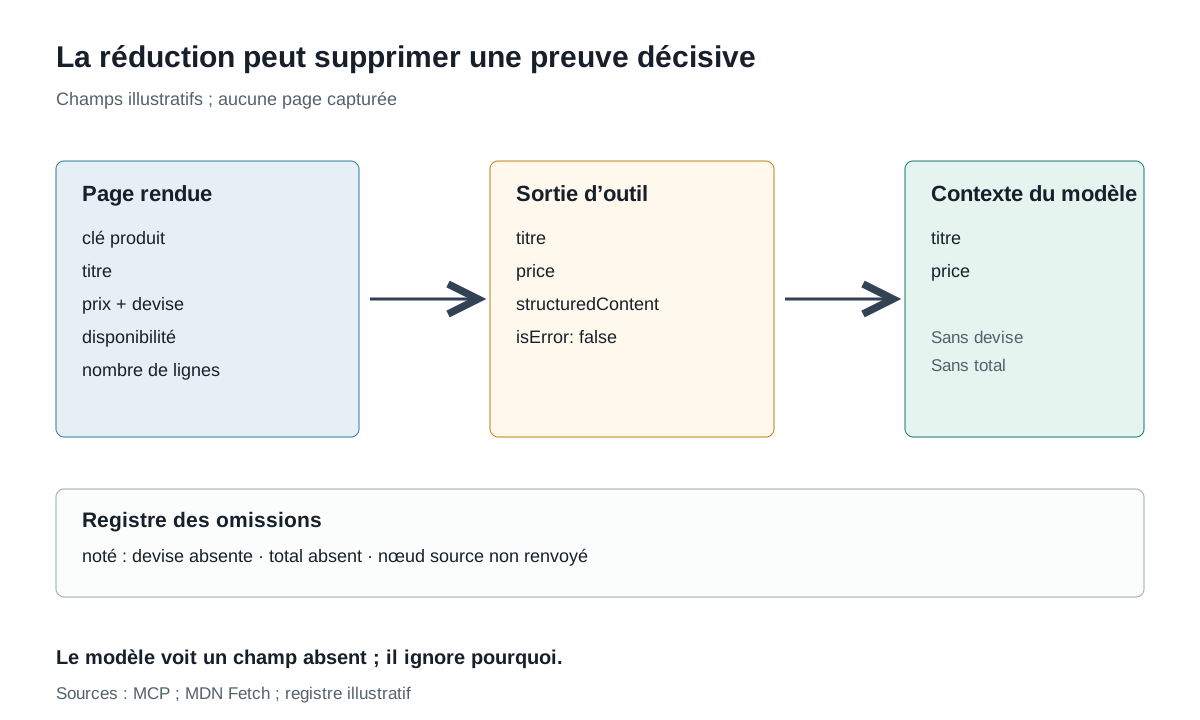
Le contexte n’est pas un navigateur miniature. Il peut contenir un texte sans en-têtes, une image sans nœuds DOM ou un registre sans texte source. Un résultat valide peut rester une description avec perte. La réponse n’est pas d’ajouter tous les champs, mais de nommer ceux qui soutiennent la décision et de conserver les preuves nécessaires à leur vérification.
Un champ structuré exige une histoire d’extraction
Un résultat typé paraît autoritaire, mais son histoire compte davantage. Pour price: 19.99, notez s’il vient d’un sélecteur, d’un rôle, d’un champ JSON, d’une zone OCR, d’une règle texte ou d’une saisie humaine. Les échecs et coûts de vérification diffèrent.
| Méthode | Origine construite | Affirmation soutenue | Ce qui n’est pas établi |
|---|---|---|---|
| Données structurées | Champ JSON applicatif | L’analyseur a lu ce champ dans cette réponse | Le produit est disponible ou le prix concerne la région |
| Instantané DOM | Nœud texte visible près d’une devise | Le texte figurait dans cette représentation | Une clé stable ou le catalogue complet caché |
| Image ou OCR | Zone de capture | Les pixels ressemblaient à un nombre | La valeur d’origine, le balisage non rendu ou toutes les lignes |
| Extraction par modèle | Le modèle a lu un texte antérieur | Le modèle a proposé cette valeur depuis son contexte | La proposition correspond à la source |
La quatrième ligne vient volontairement en dernier. Un modèle peut extraire ou classer une représentation, mais sa sortie ne prouve pas cette représentation. Un schéma, un score de confiance ou un second appel sont des tests utiles ; aucun n’observe le navigateur sauf si l’outil produit une nouvelle observation. La source, la version de l’outil et la règle doivent accompagner le résultat.
Le modèle ne vérifie pas ce qu’il n’a jamais reçu
Le modèle compare les champs présents. Il peut remarquer l’absence de currency ou un total incompatible avec les entrées visibles. Il ne remarque pas une ligne supprimée si l’outil n’indique ni total, ni curseur, ni erreur. Il ne déduit pas un diagnostic utile d’une réponse HTTP si seul ok: false est renvoyé. Il ne peut pas prouver qu’un champ manquait dans le navigateur ; seulement qu’il manquait dans la représentation.
C’est une limite pratique de toute boucle d’extraction pilotée par modèle. Le modèle peut proposer une requête de preuve, mais le host décide si l’outil peut l’exécuter et si le résultat est authentique. Le host MCP coordonne contexte et connexions ; le navigateur navigue et rend ; aucun ne transforme automatiquement chaque réponse distante en autorité universelle. La frontière des API de scraping sépare déjà l’artefact retourné de la décision interne du fournisseur, et la même séparation s’applique au contexte du modèle.
Chaque champ décisif exige donc une source nommée. Sur une page contrôlée, un JSON déterministe plus une assertion texte rendue. Dans un flux externe autorisé, un endpoint documenté ou un registre confirmé par un opérateur. Pour une image seule, la limite reste visible : OCR est une valeur dérivée, pas la page originale.
Relier un résumé du modèle à sa source
Un résumé utile doit pouvoir être parcouru à rebours. Partez de l’affirmation, identifiez les champs cités, retrouvez-les dans le résultat d’outil, puis remontez à l’observation navigateur ou réseau. Si un maillon manque, le résumé reste une hypothèse et non un scraping vérifié.
Pour l’affirmation construite « la première page contient cinq produits et le moins cher coûte 19.99 », quatre questions doivent être répondues : quel appel a renvoyé les produits ? a-t-il couvert toutes les lignes ou la première vue ? quel champ a fourni le prix et une currency ? quelle vérification indépendante confirme page et outil ? Répéter le nombre ne répond à aucune.
Une erreur de catégorie apparaît aussi : le modèle peut citer sa phrase antérieure comme si elle était une source. La répétition donne une stabilité apparente sans observation nouvelle. La chaîne doit finir à une réponse, un instantané avec méthode définie, une fixture déterministe ou un endpoint applicatif. Un autre modèle peut relire, mais n’est pas la preuve originale.
Gardez les références compactes. Digest du résultat, URL, heure, chemin de champ et version de fixture suffisent souvent. N’enregistrez pas identifiants, cookies ou texte entier uniquement pour donner une apparence complète. Le but est de prouver le champ revendiqué, pas de conserver chaque octet passé par le navigateur.
La vérification inverse compte également. Si l’outil contient un champ absent du résumé, ne concluez pas immédiatement à une erreur du modèle. La tâche peut être plus étroite ou la politique du host peut l’avoir exclu. Notez quelle représentation est arrivée et quelle instruction a sélectionné le champ.
Enfin, indiquez le point d’arrêt. Une extraction vérifiée sur une page ne prouve pas la même règle pour une autre région, langue ou session. Un prix peut apparaître sur une carte et manquer dans le détail ; un identifiant peut rester stable tandis que sa position change. Chaque nouvel état de source crée une frontière et exige la vérification appropriée.
Concevoir la vérification avant de généraliser
Un registre compact peut accompagner le résultat sans copier la page. Il nomme l’artefact, la réduction et la première question ouverte :
| Champ | Valeur construite | But |
|---|---|---|
| Exécution et source | run-04, https://example.test/products | Sépare session et affirmation |
| Méthode | browser-json, screenshot-ocr, dom-snapshot | Nomme la production de la représentation |
| Outil et schéma | catalog_extract@2, outputSchema-v3 | Garde code et contrat visibles |
| Champs choisis | title, price, currency | Montre ce que le modèle a reçu |
| Preuve omise | full row count, pagination cursor | Rend l’absence explicite |
| Vérification | owned fixture v7 ou endpoint | Nomme un contrôle indépendant |
| Première divergence | price source field absent | Oriente l’investigation |
Ce registre n’est ni une empreinte universelle ni une copie de contenu sensible. Il rend la frontière visible. Un résumé du modèle doit remonter vers l’outil puis vers une observation définie. Sans chaîne, la conclusion correcte est « non vérifié indépendamment », pas « la page ne contient pas cette valeur ».
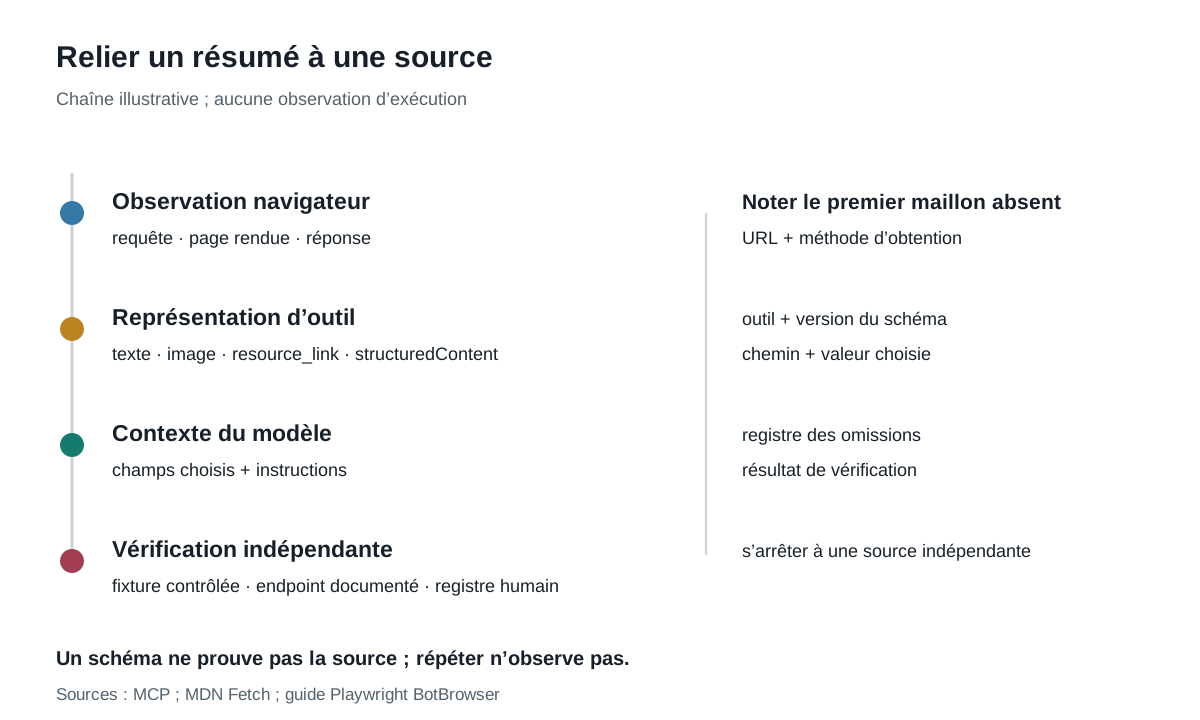
La vérification borne aussi coût et vie privée. Envoyer une capture complète après chaque extraction préserve plus de détails, mais peut exposer du contenu personnel et multiplier le stockage. Renvoyer seulement les champs utiles peut être plus sûr si l’outil documente la réduction et l’application vérifie le résultat. Il faut assez de preuves pour l’affirmation, pas le contexte maximal.
Questions fréquentes
Un scraper IA voit-il toute la page web ?
Le nom ne le détermine pas. Le modèle voit la représentation transmise par le host ou l’outil : texte, image, objet structuré ou sous-ensemble d’une observation navigateur.
Un résultat d’outil réussi équivaut-il à un HTTP réussi ?
Non. Fetch peut résoudre un Response avant le contrôle du statut et l’outil peut définir un autre succès. Séparez protocole, HTTP, analyse et application.
Un schéma de sortie prouve-t-il le prix extrait ?
Non. Il valide types et forme. L’exactitude exige source, histoire d’extraction et méthode de vérification.
Le modèle peut-il demander l’information absente ?
Il peut proposer un appel si le host l’autorise. Le host contrôle les permissions et l’outil décide de sa réponse ; le modèle n’observe pas arbitrairement les internes du navigateur ou du serveur.
Sources
- MDN Fetch API
- Spécification des outils serveur MCP
- Architecture MCP
- Configuration Playwright BotBrowser
Conclusion pratique
Traitez le contexte du modèle comme une représentation réduite produite par le navigateur ou l’outil, pas comme l’observation complète. Conservez source, méthode, versions, champs choisis, omissions connues et voie de vérification. Le modèle aide à interpréter ce qu’il reçoit ; l’application doit prouver les faits importants. BotBrowser rend explicites le processus et les entrées navigateur, mais ne remplit pas les preuves absentes, ne rend pas un schéma vrai et ne garantit aucun résultat de site.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
API de scraping web : ce que cache la réponse
DéploiementAutomatisation MCP : ce que transporte le protocole
DémarrageNavigateur headless pour agents IA : lancement et limites des outils
DéploiementAgent navigateur : quand la décision devient périmée
DémarrageWeb crawler vs web scraper : résultats et erreurs
DémarrageNavigateur de web scraping : quel type choisir ?
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.