Scraping LinkedIn : accès, consentement et limites
Le scraping LinkedIn exige de distinguer profils visibles, exports, autorisations API et droit de réutilisation. Les réglages du navigateur n’accordent aucune permission.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Le scraping LinkedIn n’est pas autorisé au seul motif qu’un profil s’affiche dans un navigateur. La première décision consiste à déterminer si l’usage envisagé repose sur une API approuvée, un export des données d’un compte ou une autre base explicite couvrant la collecte et la réutilisation. BotBrowser peut configurer des surfaces de navigateur observables et adossées à un profil dans un contexte contrôlé par l’opérateur, ce qui aide à distinguer la configuration du navigateur de la vue observée. Il ne peut pas accorder l’accès à LinkedIn, ajouter des autorisations API, fournir une permission de collecte ou garantir que LinkedIn acceptera une session de navigateur.
Résumé
- Une vue visiteur et une vue membre décrivent ce qui a été affiché à un observateur ; aucune ne crée un droit sur un jeu de données réutilisable.
- Un siège payé par l’employeur bénéficie de droits propres au service. Il ne fait pas de l’employeur le propriétaire du compte personnel du membre.
- Un export de compte concerne les droits du titulaire sur ses données ; une autorisation API concerne une application, les produits approuvés, les autorisations demandées et le consentement du membre.
- Choisissez un parcours selon la couverture documentée des données et de l’objectif visés. Une autorisation ou une exigence de champ non résolue justifie de réduire la portée du projet, pas de modifier un réglage du navigateur.
Sommaire
- Cinq limites qui répondent à des questions différentes
- Ce qu’établit réellement une vue de profil
- Propriété du compte, exports et autorisations des applications
- Un dossier de décision pour choisir un parcours pris en charge
- Contextes de navigateur et incertitude de l’observateur
Cinq limites qui répondent à des questions différentes
L’expression « données LinkedIn » recouvre plusieurs objets distincts : un champ affiché à un visiteur, un champ affiché à un membre donné, une copie remise au titulaire d’un compte et une réponse fournie à une application autorisée. Les traiter comme interchangeables crée une erreur de planification avant tout travail technique. Le Contrat d’utilisation de LinkedIn, en particulier sa section §8.2, limite le scraping, la copie du service et l’accès automatisé non autorisé. L’affichage d’une valeur n’annule pas ces restrictions.
La distinction utile sépare les preuves de présentation des preuves d’autorité. Une capture d’écran peut établir qu’une vue précise comprenait un intitulé de poste à un moment donné. Elle ne peut pas établir que la copie en masse, la redistribution, l’enrichissement ou la conservation continue sont couverts. Une autorisation API peut établir une capacité plus limitée de l’application, mais son endpoint et son objectif restent déterminants. Ce sont des affirmations distinctes, appuyées par des dossiers distincts, même lorsqu’elles concernent le même profil.
| Limite | Question à laquelle elle répond | Preuve qu’elle peut fournir | Déduction qu’elle ne permet pas |
|---|---|---|---|
| Vue affichée au visiteur | Qu’est-ce qui apparaissait sans session membre ? | Une vue associée à son canal d’accès et à son moment | Autorisation de compiler des profils |
| Vue affichée au membre | Qu’est-ce que ce membre a vu ? | Une vue conditionnée par les réglages et les relations | Un accès identique pour chaque membre |
| Export des données du compte | Quelle copie le titulaire du compte peut-il demander ? | Les catégories de données remises | La propriété des informations d’autres membres |
| Consentement et autorisation API | Que peut demander cette application ? | Un accès au produit approuvé et le scope accordé | Un accès général aux données du site web |
| Autorité de collecte et de réutilisation | Cet objectif envisagé est-il couvert ? | Les conditions applicables, le consentement, l’accord et l’analyse juridique | Une conclusion fondée uniquement sur la visibilité |
La dernière ligne ne constitue pas une interface technique supplémentaire. C’est la décision qui doit être compatible avec l’interface choisie et l’usage prévu. Par exemple, l’autorisation d’afficher dans une application un résultat approuvé par un membre ne répond pas à elle seule à la question de savoir si ce résultat peut devenir une base de prospection. Cette question exige d’examiner les conditions du produit applicables et l’usage ultérieur envisagé, plutôt que de comparer des captures de navigateur. Le dossier de décision juridique et contractuelle traite plus généralement de ces questions de responsabilité dans des contextes de collecte.
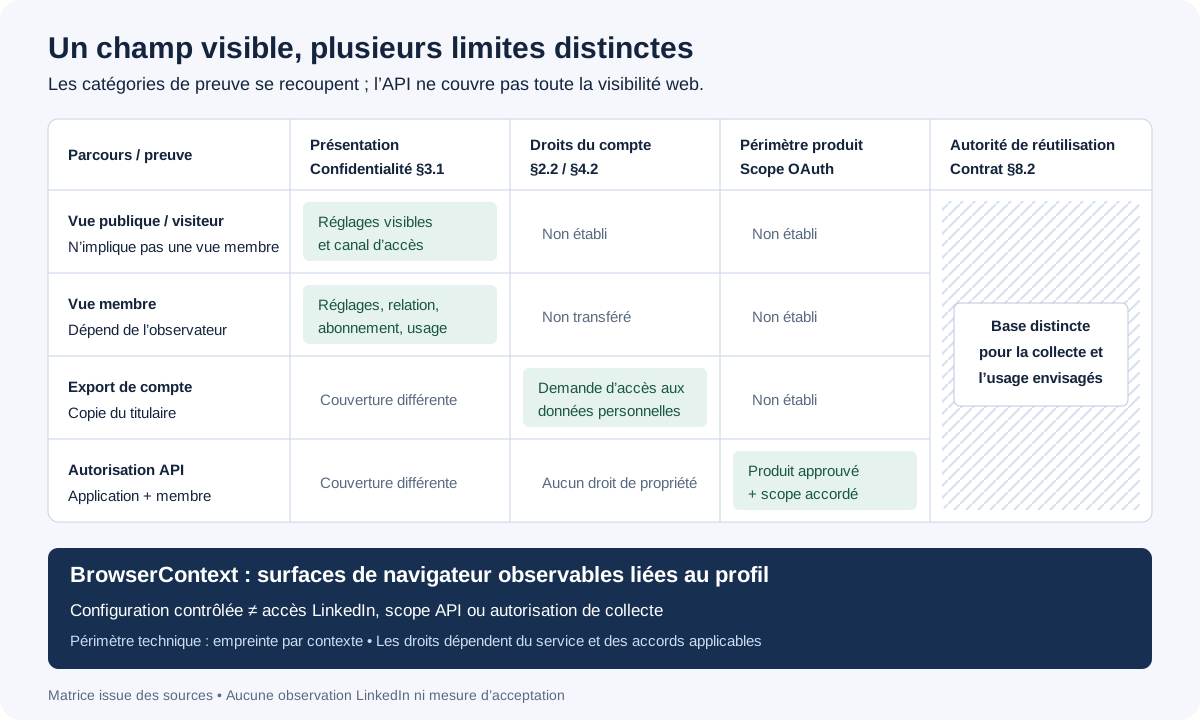
La matrice indique le type de preuve fourni par chaque parcours, pas une progression vers un accès sans restriction. En particulier, l’accès API n’est pas un surensemble de tout ce qui est visible sur le site web. Un produit peut exposer une réponse limitée alors qu’un navigateur affiche une page plus riche ; un export peut contenir des informations de compte sans vue publique correspondante. La limite du scope et celle de la présentation se croisent donc sans que l’une englobe l’autre.
Ce qu’établit réellement une vue de profil
La Politique de confidentialité §3.1 décrit comment la visibilité d’un profil dépend des réglages et du degré de relation avec le membre qui le consulte, de ses abonnements, de son utilisation du service, des canaux d’accès et des types de recherche. Ces conditions comptent davantage qu’une simple étiquette public ou privé. Même avec un accès membre, une recherche par nom et une recherche par mot-clé ne garantissent pas la même disponibilité du profil ni les mêmes champs. La politique ne justifie pas de supposer que tous les membres connectés reçoivent une fiche identique.
Considérez une comparaison envisagée entre deux observations existantes et fournies légitimement. L’une présente un intitulé, l’autre affiche aussi une section supplémentaire du profil. La différence permet d’affirmer que les vues diffèrent. Elle ne permet pas d’en isoler la cause. Les observateurs peuvent différer par leur abonnement, leur relation, leurs réglages, leur canal ou le moment de l’observation. Une différence de configuration du navigateur peut aussi exister, mais le résultat visible ne suffit pas à l’identifier comme explication. Consignez les conditions connues avant d’attribuer une cause.
Un champ absent exige une formulation particulièrement prudente. « Non affiché dans cette vue membre » est une observation ; « le membre ne possède pas cette information » est une affirmation sur le compte sous-jacent. De même, un résultat public contenant moins d’informations ne montre pas que le profil complet est vide. La Politique de confidentialité §3.1 décrit une disponibilité conditionnelle ; l’absence de preuve de présentation doit donc rester une absence de preuve, plutôt que devenir un fait négatif concernant une personne.
La même rigueur s’applique à l’apparente exhaustivité. Une page peut sembler détaillée sans constituer une représentation complète des données du compte ou une réponse API. Une étiquette d’abonnement ne peut pas servir de contrat de schéma, et un rendu réussi ne prouve pas que tous les champs demandés resteront disponibles par la suite. Un document de besoins doit distinguer « champ nécessaire à l’objectif métier » de « champ vu dans une vue », car seul le premier décrit le projet évalué.
Les offres d’emploi publiques sont un sujet voisin, mais différent. La limite de navigateur des sites d’offres d’emploi concerne les catégories d’accès aux annonces et les limites d’extraction, tandis que l’interprétation des champs d’emploi d’Indeed et LinkedIn traite des champs d’annonce, de la pagination et de l’identité des offres. La présence d’une annonce ne prouve rien sur l’accès aux relations d’un membre ou à l’historique de son compte. Regrouper ces enregistrements sous un pourcentage unique de « couverture LinkedIn » masquerait le changement d’objet et d’autorisation.
Pour analyser une source, le résultat utile est une affirmation qualifiée telle que vue-membre / intitulé présent / relation inconnue, et non une promesse de couverture universelle. Cette description conserve ce que les preuves étayent et rend visible la variable manquante. Elle permet aussi à une personne décisionnaire d’écarter une source inadaptée sans commander une expérience de collecte simplement pour découvrir que ses hypothèses d’accès étaient incomplètes.
Propriété du compte, exports et autorisations des applications
L’accès au compte commence par la personne, pas par le poste de travail. Le Contrat §2.1 et §2.2 exige un compte unique sous nom réel et interdit le partage ou le transfert d’un compte. La section 2.2 distingue aussi les droits de l’employeur sur un service acheté des droits sur le compte personnel du membre. Un employeur peut contrôler l’accès à un siège payant et recevoir des rapports sur son utilisation, mais le paiement ne transfère pas la propriété de ce compte personnel.
Cette distinction change la manière dont une organisation évalue une demande de données. Une facture d’abonnement peut établir qu’un service a été acheté. Elle ne peut pas établir que l’organisation est propriétaire du profil, des relations ou de l’historique de compte de l’employé. La demande d’accès d’un responsable et la demande de données du membre lui-même ne constituent donc pas des preuves équivalentes. Le dossier approprié identifie les droits de la personne qui les exerce et les droits propres au service qui s’appliquent, sans assimiler un poste de travail partagé à un droit de compte partagé.
Les exports de compte concernent le titulaire
La Politique de confidentialité §4.2 décrit les droits d’accès aux données personnelles et de demande d’une copie, y compris une copie lisible par machine des données personnelles fournies à LinkedIn. C’est une option pertinente lorsque le besoin réel porte sur les informations propres au titulaire du compte. Ce parcours diffère de la compilation des profils d’autres personnes, et son adéquation dépend des catégories effectivement fournies et de l’usage prévu.
Un export doit donc être évalué comme un paquet remis, avec un sujet et une couverture définis. Si la question métier concerne les propres enregistrements du titulaire, le paquet peut y répondre sans reproduire la présentation du site web. Si elle concerne un marché entier de personnes, le droit de demander ses propres données n’établit pas une couverture à l’échelle du marché. La Politique de confidentialité §4.2 constitue une preuve du droit d’accès qu’elle décrit, pas une garantie de chaque catégorie ou version historique qu’un projet pourrait souhaiter.
Le consentement de l’application dépend du produit
La documentation du flux de code d’autorisation de LinkedIn décrit une application qui demande à un membre l’accès au moyen du paramètre scope. Les autorisations disponibles dépendent des produits ou programmes partenaires approuvés pour cette application. L’approbation du produit et le consentement du membre répondent à des questions différentes : la première porte sur ce que l’application peut demander, le second sur ce que le membre a accordé dans le cadre de cette demande.
La documentation indique également que la modification des autorisations scope nécessite une nouvelle authentification des utilisateurs, afin que les permissions demandées soient explicitement accordées. Un ancien dossier de consentement ne peut pas être interprété automatiquement comme l’approbation d’une extension ultérieure. Pour évaluer une intégration, les preuves pertinentes sont la couverture actuelle du produit approuvé et l’ensemble actuel des scopes accordés, ainsi que les exigences de l’endpoint. Un simple badge « connecté à LinkedIn » omet précisément les distinctions nécessaires pour évaluer un nouveau besoin en données.
La connexion au navigateur constitue un troisième état, distinct à la fois de l’éligibilité et du consentement de l’application. Le guide des cookies de MDN explique comment les cookies peuvent contribuer à la gestion des sessions entre un navigateur et un serveur. Cette session de navigateur n’est ni un jeton d’accès API ni la preuve que l’application dispose d’une autorisation particulière. Inversement, une autorisation d’application n’est pas une permission générale de copier le site web. La documentation d’autorisation porte sur les appels API autorisés par le membre et soumis aux scopes demandés, pas sur des pages rendues quelconques.
Ces parcours doivent être comparés selon leur couverture, et non leur commodité. L’export du titulaire du compte, une API approuvée pour un produit et un accord distinct documenté peuvent chacun répondre à un besoin légitime différent. Si aucun ne couvre les données et la réutilisation envisagées, c’est le projet lui-même qui reste sans réponse. L’absence d’un champ souhaité dans l’une de ces options ne permet pas de conclure quoi que ce soit sur les autres parcours.
Un dossier de décision pour choisir un parcours pris en charge
Un dossier d’approbation utile commence par une question précise : de qui les données sont-elles nécessaires, quels champs sont indispensables, qui recevra le résultat et qu’en fera-t-on ensuite ? Ces éléments déterminent les preuves pertinentes. « Recherche », « recrutement » ou « usage interne » sont trop généraux pour distinguer une demande du titulaire d’un compte d’une nouvelle base concernant d’autres membres. Le Contrat §8.2 fait de la copie et de l’usage des questions importantes, tandis que la Politique de confidentialité §4.2 et le scope OAuth décrivent des mécanismes d’accès pris en charge différents.
Le tableau est un outil de décision original dérivé de ces distinctions documentaires. Il n’affirme pas qu’un projet répertorié est automatiquement approuvé. Sa règle de choix consiste à retenir un parcours uniquement lorsque les preuves requises couvrent à la fois les données demandées et l’objectif envisagé ; sinon, il faut expliciter l’élément manquant et réduire ou suspendre cette partie du besoin.
| Besoin envisagé | Preuve requise | Ce qui reste inconnu | Action |
|---|---|---|---|
| Un titulaire de compte a besoin de sa propre copie d’enregistrements | Fondement de la demande selon Politique de confidentialité §4.2 et catégories réellement présentes dans l’export | Le paquet contient-il l’historique nécessaire ? | Évaluer le contenu documenté de l’export |
| Une application a besoin de données autorisées par un membre | Produit ou programme partenaire approuvé, exigences de l’endpoint et scope actuellement accordé | Les champs et l’usage souhaités sont-ils inclus ? | Comparer le besoin à la couverture API actuelle |
| Une équipe veut conserver des champs de profil vus par un visiteur | Analyse du Contrat §8.2 et autorité explicite pour cet usage | Couverture de la collecte, de la conservation et de la redistribution | Résoudre ces conditions avant de choisir un mécanisme de collecte |
| Un employeur veut des informations associées à un siège payé | Conditions du siège et limite du compte personnel prévue à la section §2.2 | Quels rapports organisationnels sont couverts ? | Préférer les options de rapport prises en charge par le service |
| Deux vues de profil fournies sont contradictoires | Conditions de la Politique de confidentialité §3.1 et provenance des observations | Quelle condition a causé la différence ? | Conserver l’écart sans inventer une fiche complète |
Une exigence portant sur un champ peut être rejetée sans rejeter tout le projet. Supposons que le résultat nécessaire soit un résumé d’activité du titulaire du compte, tandis qu’une colonne supplémentaire proposée concerne des membres sans rapport. Le parcours d’export peut convenir à la première partie, sans fournir de réponse automatique pour la colonne supplémentaire. Les séparer révèle un objectif viable plus limité, au lieu de laisser une idée d’enrichissement facultative redéfinir tout le fondement de l’autorisation.
Les preuves dépendent aussi du temps. Une ancienne approbation de produit, une attribution de siège passée ou une déclaration de consentement historique peuvent décrire des conditions révolues. L’exigence de nouvelle autorisation pour une modification des scopes, documentée par OAuth, montre concrètement pourquoi la couverture actuelle importe. Un dossier de décision doit préciser la version ou la date des conditions pertinentes et le périmètre de consentement évalué, sans stocker de secrets ni reproduire des éléments de session du compte. Une référence au dossier d’approbation du système responsable est plus utile qu’un indicateur « autorisé » sans explication.
Enfin, distinguez la description d’un fournisseur de la couverture qu’il démontre. Un tiers proposant des « données LinkedIn » peut fournir un jeu de données issu d’exports, un produit sous licence ou tout autre chose. Cette étiquette ne prouve à elle seule aucun de ces parcours. Demandez quelle source, quelle base contractuelle, quel objectif autorisé et quelles limites de mise à jour s’appliquent au jeu de données exact. Le Contrat §8.2 traite expressément des informations obtenues par des tiers ; leur transmission par un intermédiaire ne dispense donc pas d’examiner les droits sous-jacents.
Contextes de navigateur et incertitude de l’observateur
La documentation sur l’empreinte par contexte décrit les contrôles de profil et les réglages du navigateur rattachés à un BrowserContext. C’est la capacité BotBrowser pertinente ici : un opérateur peut rattacher les surfaces observables configurées du navigateur à un contexte contrôlé particulier. La documentation fournit des commandes au niveau du navigateur ; elle n’établit ni un droit d’accès à LinkedIn, ni une autorisation API, ni l’explication d’une réponse particulière de LinkedIn.
L’isolation générale des contextes est traitée dans l’isolation du navigateur multi-comptes. Cette séparation technique ne doit pas être interprétée comme une permission de LinkedIn de créer plusieurs comptes : la règle de compte du Contrat §2.1 reste distincte. De même, l’article sur l’effacement des données de site et les limites de compte dans le navigateur décrit le nettoyage. Effacer l’état local ne prouve pas la révocation d’une autorisation API côté serveur, et un contexte de navigation privée ne garantit pas l’anonymat auprès d’un service.
Comparaison synthétique d’observations A/B/C
Ce qui suit est un exemple de raisonnement synthétique et inoffensif, pas une exécution réelle de LinkedIn, un résultat d’acceptation mesuré ou une procédure de collecte recommandée. Les lignes représentent des observations fictives fournies pour analyse. Aucun compte, identifiant ou donnée de profil réelle n’est concerné.
| Observation fictive | Conditions fournies | Résultat visible | Interprétation défendable |
|---|---|---|---|
| A | Vue visiteur ; canal consigné | Intitulé affiché ; section détaillée absente | Cette présentation visiteur ne contient pas cette section |
| B | Vue membre ; relation et abonnement inconnus | Intitulé et section détaillée affichés | La présentation membre diffère ; cause non résolue |
| C | Réponse de l’application ; produit approuvé et scope documenté | Seuls les champs pris en charge par le produit sont renvoyés | La couverture API est plus limitée que la comparaison du site web demandée |
Comparer A et B n’isole pas un effet du navigateur, car l’appartenance au service et d’autres conditions de visibilité diffèrent. Comparer B et C ne montre pas un échec de l’API, car le contrat produit de l’API diffère de la présentation de la page. La Politique de confidentialité §3.1 justifie de conserver la première incertitude ; la documentation OAuth justifie de conserver la seconde. Aucune comparaison n’établit qu’une valeur absente puisse être récupérée en modifiant un profil de navigateur.
Une règle analytique utile consiste à associer chaque conclusion à sa catégorie de preuve. Étiquetez A comme preuve de présentation, B comme preuve d’une vue membre conditionnelle et C comme preuve de périmètre applicatif. Consignez comme inconnue l’information absente sur la relation, au lieu de lui substituer une explication plausible. Les contrôles du navigateur conservent ainsi leur rôle légitime et une capture d’écran plus riche ne devient pas discrètement une promesse d’un jeu de données autorisé plus complet.
FAQ
Un siège LinkedIn payé fait-il du compte d’un employé la propriété de l’entreprise ?
Non. Le Contrat §2.2 accorde à l’acheteur des droits sur le service payé, notamment le contrôle des accès et les rapports d’utilisation, tout en maintenant la distinction avec le compte personnel du membre. Un dossier d’achat doit donc s’appuyer sur les conditions de rapport du siège, et non supposer que le paiement transfère le compte.
Le consentement à une requête API peut-il couvrir de nouveaux scopes ?
La documentation d’autorisation exige une nouvelle authentification lorsque les autorisations de scope changent, afin que la requête élargie soit explicitement accordée. L’éligibilité du produit doit également couvrir les scopes demandés. Un ancien événement de consentement ne prouve pas qu’un besoin ultérieur plus large a été approuvé.
Un champ de profil absent d’un export est-il nécessairement indisponible ailleurs ?
Non. Un export, une page rendue et une réponse API ont des couvertures différentes. Le contenu de l’export remis répond à une question propre à ce paquet. L’absence d’une donnée dans un export ne prouve pas son absence d’une page, et la visibilité sur une page ne crée pas un droit d’export ou d’accès API.
Une observation peut-elle établir que LinkedIn a accepté une configuration du navigateur ?
Une vue fournie précise peut établir ce qui s’est affiché dans les conditions consignées. Elle ne peut établir ni une acceptation future, ni un taux général de réussite, ni la cause d’une différence entre observateurs. Aucune mesure d’acceptation à l’exécution n’est rapportée ici.
Sources
- Contrat d’utilisation de LinkedIn : §2.1 éligibilité du compte ; §2.2 droits sur le compte et siège payé ; §8.2 restrictions relatives à la copie et à l’accès automatisé.
- Politique de confidentialité de LinkedIn : §3.1 conditions de visibilité ; §4.2 droits d’accès et de copie des données.
- Flux de code d’autorisation LinkedIn : consentement du membre, scopes dépendant du produit et autorisation après modification des scopes.
- Documentation BotBrowser sur l’empreinte par contexte : commandes de navigateur adossées à un profil et rattachées à un contexte.
- Guide des cookies HTTP de MDN : modèle d’état de session entre navigateur et serveur.
Conclusion pratique
La décision concernant le scraping LinkedIn commence par la personne concernée, l’usage prévu et une base d’accès prise en charge. La visibilité visiteur, la visibilité membre, un export de compte et une autorisation d’application apportent des preuves différentes ; aucune ne doit se substituer discrètement aux autres. La configuration du navigateur intervient après cette distinction et ne peut pas combler l’absence de droits ou de couverture produit.
Rédigez une phrase qui précise les données nécessaires, leur sujet, leur destinataire et leur objectif. Associez-la à une ligne du tableau de décision, puis identifiez la catégorie exacte d’export, le scope API approuvé, le rapport de service pris en charge ou l’accord explicite qui la couvre. Si la correspondance est incomplète, réduisez le résultat demandé avant de choisir les outils du navigateur.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
Empreinte Canvas : exports vides et erreurs
EmpreinteKasada : signaux des défis et confidentialité
EmpreinteAPI de scraping web : ce que cache la réponse
DéploiementGoogle Maps : Places API ou listes affichées ?
DémarrageScraping légal et conditions : ce qu’une équipe doit décider
EmpreinteEmpreinte multi-navigateur : portée de la corrélation
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.