Rebrowser Proxy : trajets, profils et confidentialité
Le proxy Rebrowser définit le trajet d’une exécution distante. Paramètres hérités, profils persistants, authentification et limites de l’automatisation.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Un paramètre de proxy Rebrowser modifie le trajet réseau attribué à une exécution du navigateur distant. À lui seul, il ne choisit pas un autre profil, ne supprime pas les cookies existants et n’installe pas les correctifs de bibliothèques Rebrowser, qui constituent un produit distinct. Ces différences deviennent concrètes lorsque le navigateur se connecte correctement mais conserve une session applicative, qu’un choix de proxy semble ignoré ou que deux onglets sont supposés disposer de configurations réseau séparées.
BotBrowser documente la configuration du proxy au niveau du navigateur et, pour les contextes d’entreprise compatibles, des changements propres à chaque contexte. Ses contrôles du moteur et du profil portent sur la configuration du navigateur ; un proxy fournit un trajet réseau. BotBrowser ne détermine pas la réponse du destinataire ni ne supprime les informations déjà conservées par une application ou un prestataire.
TL;DR
- La documentation cloud de Rebrowser attribue un proxy à chaque exécution. L’API Runs distingue un choix explicite des paramètres du profil et des groupes utilisés lorsque ce choix est omis.
- La connexion de contrôle distant et le trafic applicatif du navigateur ont des fonctions différentes. Connecter le client ne prouve pas quel trajet une requête vers l’application a emprunté.
- Réutiliser un profil persistant peut conserver l’état applicatif entre les exécutions. Un autre proxy ne crée pas une nouvelle frontière de stockage.
- La documentation cloud de Rebrowser indique que les appels habituels de création de contexte Puppeteer et Playwright restent sans effet. Les hypothèses d’isolation d’une bibliothèque locale ne doivent pas être transférées au service.
Sommaire
- Une exécution possède une connexion de contrôle et un trajet
- Quel choix de proxy devient effectif
- Un nouveau trajet peut conserver le même profil
- L’authentification concerne plusieurs frontières
- Les onglets cloud ne garantissent pas des contextes séparés
- DNS et transport demandent leurs propres preuves
- Ce que modifie le correctif de bibliothèque
- Responsabilité des échecs et éléments de preuve
- Conclusion pratique
Une exécution possède une connexion de contrôle et un trajet
Rebrowser nomme run, ou exécution, l’instance créée au démarrage d’un navigateur distant. Sa page Key Concepts indique que chaque exécution doit disposer d’un proxy et annonce la prise en charge de HTTP et SOCKS5. Le navigateur est distant : le processus qui visite une page n’est pas nécessairement celui, ni la machine, qui exécute le client d’automatisation. Cette séparation change la portée d’une connexion réussie.
L’API Runs renvoie un identifiant d’exécution et des endpoints WebSocket au démarrage. Le client communique avec le navigateur par une connexion de contrôle. Séparément, le navigateur demande documents et ressources via le trajet attribué à l’exécution. Une connexion de contrôle fonctionnelle établit que le client peut communiquer avec le navigateur distant. Elle ne montre pas qu’une requête applicative donnée a atteint son destinataire via le proxy prévu.
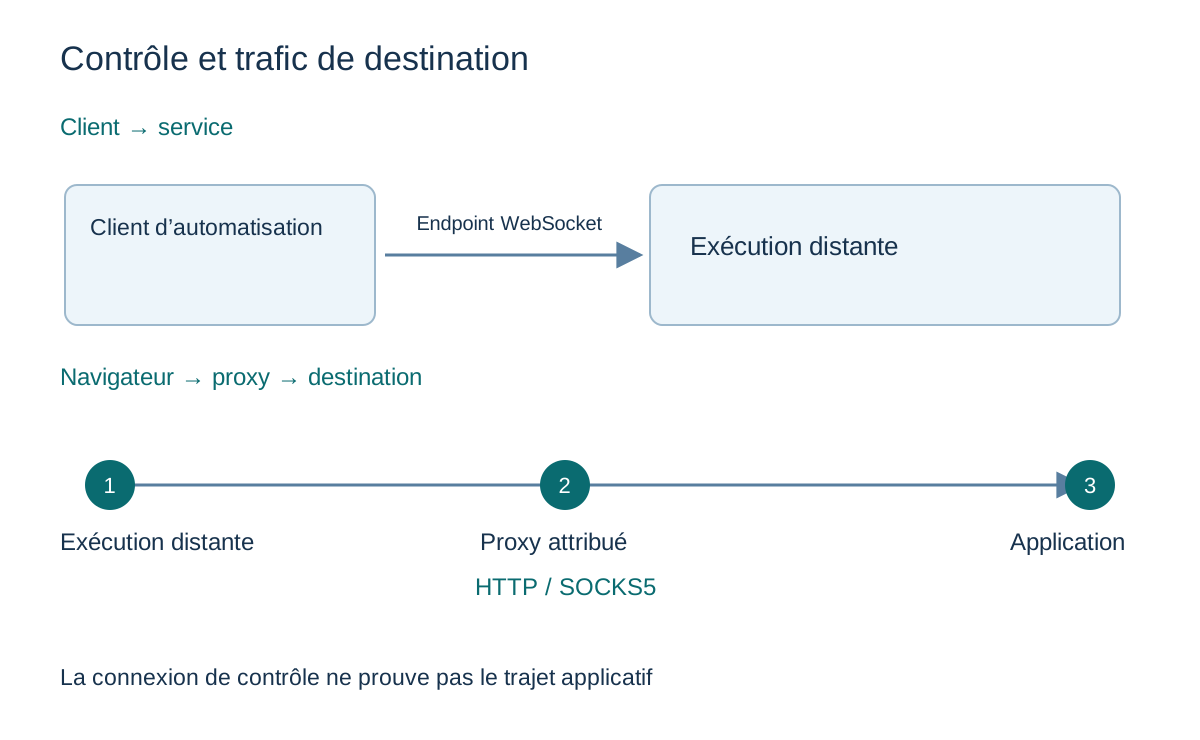
La distinction concerne aussi l’emplacement du client. Déplacer le script sur un autre poste modifie le point de départ de la connexion de contrôle. Cela ne démontre pas que le proxy du navigateur distant a changé. Inversement, modifier le proxy de l’exécution ne prouve pas que les propres requêtes du client, ses appels de supervision ou d’autres logiciels empruntent désormais ce trajet. Ces connexions ont des responsables de configuration différents.
Il s’agit d’une distinction de périmètre du trafic, et non d’une affirmation selon laquelle un déploiement précis expose des informations supplémentaires. Une analyse de confidentialité commence par les endpoints qui échangent effectivement des données. Le client peut gérer un identifiant d’accès au service et recevoir des données de pages. Le navigateur distant gère le contenu applicatif et l’état du profil. Le proxy participe au trajet du navigateur. Le destinataire reçoit l’échange applicatif. La visibilité de chaque partie dépend de la connexion et de la configuration, pas du mot proxy affiché dans un panneau.
Une application maîtrisée peut, par exemple, recevoir une requête depuis la sortie prévue pendant que le client perd sa connexion distante. Les deux observations sont compatibles. Le trajet du navigateur et la session de contrôle ont des durées et des conditions d’erreur distinctes. Remplacer un paquet de bibliothèque à cause de cette déconnexion modifie un autre composant que le choix du proxy ayant produit la requête.
La vue d’ensemble des proxies organise les décisions de routage, DNS et familles d’adresses. Rebrowser y ajoute un cycle de vie cloud : l’exécution est l’unité à laquelle sa documentation attribue un proxy. Cette unité déclarée constitue le point de départ avant toute hypothèse sur une page, un onglet, une connexion ou un processus local.
Une enveloppe locale ajoute une autre frontière de routage : l’analyse du code de Botright distingue les clients Python de consultation préalable du trafic du navigateur vers la destination. Le proxy du navigateur ne décrit pas à lui seul ces requêtes antérieures.
Quel choix de proxy devient effectif
Un choix de proxy peut provenir de plusieurs endroits. La description des paramètres de Rebrowser donne un ordre : paramètres par défaut, paramètres du premier groupe du profil, puis paramètres du profil. Elle précise que les valeurs effectives sont consultables sur la page de l’exécution. Modifier une couche ne prouve pas ce qu’une exécution ultérieure utilisera après prise en compte des autres couches.
Les groupes ont une conséquence pratique. La documentation décrit l’attribution d’un proxy à un groupe pour plusieurs profils, puis sa modification à un seul endroit. Il s’agit d’une relation de configuration entre les profils et un responsable commun des paramètres. Cette description ne signifie pas que tous les membres partagent des cookies, un processus ou une identité applicative. Elle établit des paramètres partagés ; les autres relations exigent des éléments distincts.
Les paramètres de démarrage ajoutent un choix explicite. proxyId identifie un proxy configuré ; proxyUrl fournit une URL de proxy. Rebrowser recommande l’un ou l’autre, et non les deux. Lorsque le paramètre pertinent est omis, la documentation renvoie aux paramètres du profil et des groupes. L’omission a donc un sens : elle laisse la sélection à une configuration existante plutôt que de choisir nécessairement une connexion directe.
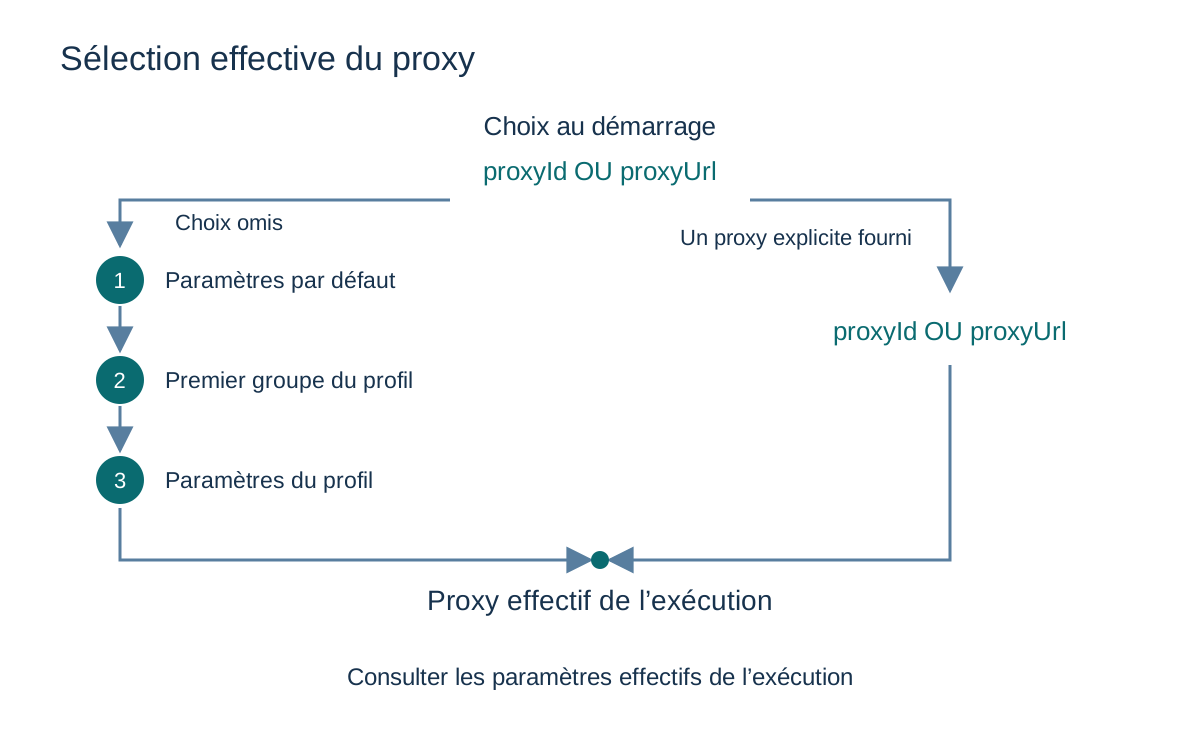
La même API documente un autre choix automatique : sans profileId, le premier profil aléatoire disponible est sélectionné. Cela compte pour la continuité. Une exécution démarrée sans choix explicite peut ne pas posséder l’état ou les paramètres du profil récemment modifié. Un résultat inattendu ne suffit pas à conclure à une défaillance du proxy : un autre profil a pu être sélectionné.
Prenons un groupe dont la configuration est modifiée pour des tâches futures, alors qu’un profil particulier conserve ses propres paramètres. Les éléments pertinents sont les valeurs effectives de l’exécution examinée et la présence éventuelle d’un choix de proxy au démarrage. Une capture du groupe modifié montre une intention à cette couche. Elle n’enregistre pas le choix final de chaque exécution.
La source ne décrit pas d’algorithme universel de fusion de plusieurs appartenances à des groupes, au-delà de sa mention du premier groupe. Les paramètres de démarrage ne démontrent pas non plus que tous les réglages d’un profil peuvent être modifiés pendant une exécution active. Configurer lors de la création et reconfigurer un navigateur déjà lancé sont deux opérations différentes. Les séparer évite d’inférer une capacité de changement à chaud non documentée à partir d’un paramètre de départ.
La décision reste concrète : identifier l’exécution, le profil choisi et la présence d’un choix de proxy au démarrage, puis consulter les paramètres effectifs du service. Une réponse différente du destinataire ne suffit pas à identifier la couche qui a sélectionné le proxy.
Un nouveau trajet peut conserver le même profil
Routage réseau et continuité du stockage sont indépendants. La documentation des profils persistants décrit la conservation des données entre exécutions en créant un profil puis en réutilisant son identifiant. Elle cite cookies, cache et autres stockages du navigateur. Une exécution ultérieure peut donc emprunter un nouveau trajet tout en conservant des données déposées précédemment par une application.
Une session encore authentifiée après un changement de proxy est compatible avec ce fonctionnement. Le trajet a changé, mais un cookie ou un autre état applicatif peut subsister. Sa présence ne démontre pas l’utilisation de l’ancien proxy. De même, un écran de connexion ne prouve pas un nouveau profil : l’application peut expirer une session, demander une nouvelle authentification ou prendre une décision côté serveur indépendamment du stockage du navigateur.
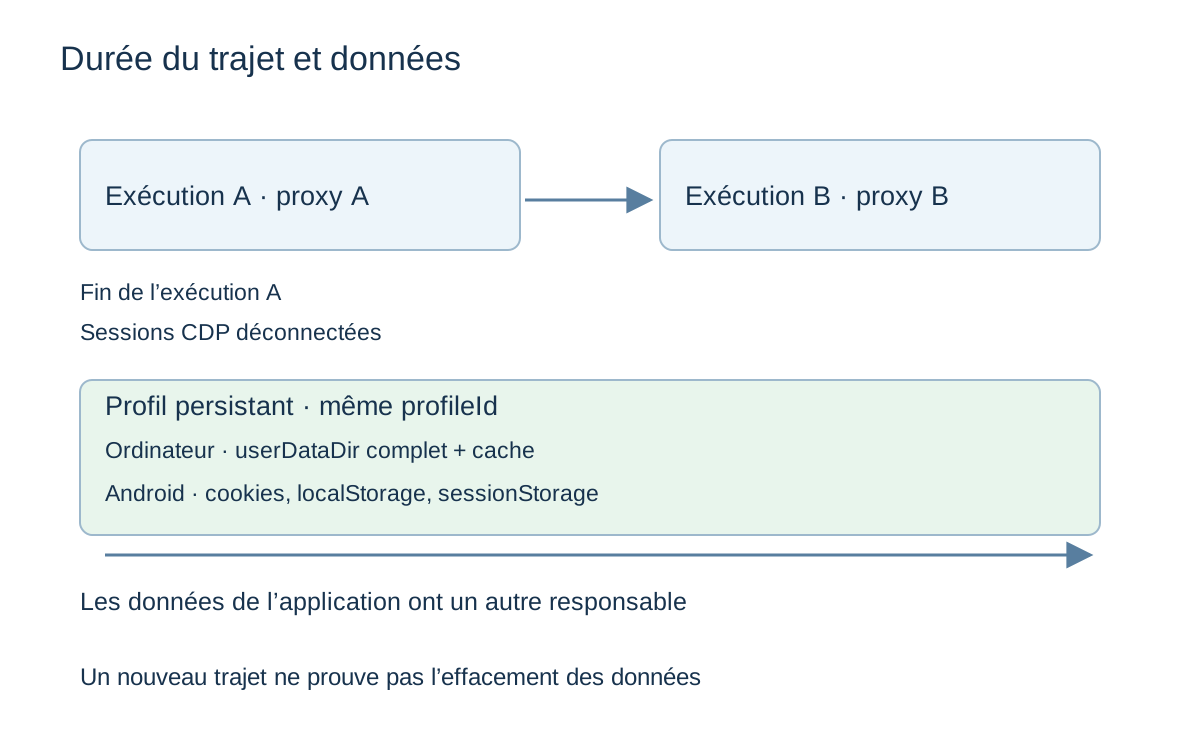
L’opération de fin d’exécution déconnecte immédiatement toutes les sessions CDP. Elle décrit la fin des connexions de contrôle distant. Il ne faut pas l’étendre à une promesse d’effacement du profil persistant ou des données du destinataire. Une frontière de session de contrôle est plus étroite qu’une frontière de suppression de données.
Rebrowser décrit aussi une option désactivant la persistance pour obtenir des démarrages propres. Ce paramètre de profil ou de groupe est distinct du choix du proxy. La documentation déclare une persistance complète de userDataDir sur ordinateur, y compris cache, cookies et autres fichiers. Pour les navigateurs mobiles, elle énumère seulement les cookies, localStorage et sessionStorage, en attribuant cette limite à Android. Ces déclarations concernent ce service : la conservation du cache sur ordinateur ne peut pas être supposée pour son offre Android.
Sur ordinateur avec persistance activée, le cache produit une conséquence de confidentialité et de diagnostic. La même documentation explique qu’un cache persistant peut réduire la bande passante du proxy en évitant des téléchargements répétés. Voir une ressource dans le navigateur n’implique donc pas toujours un nouveau transfert par le proxy à cet instant. Il faut distinguer une requête réellement envoyée, l’exécution qui l’a envoyée et l’état déjà disponible dans le navigateur distant.
Pour un usage autorisé, séparer état et trajet clarifie les choix de conservation. Un profil peut être gardé pour assurer une continuité, tandis que les journaux de sélection du proxy ont une durée plus courte pour leur finalité opérationnelle. Une politique de démarrage propre peut aussi empêcher le passage d’un état applicatif entre tâches. Ces décisions sont différentes et relèvent des contrôles du profil, pas d’effets supposés d’un changement d’adresse de sortie.
La vue d’ensemble de l’empreinte du navigateur replace stockage, surfaces du navigateur et observations réseau dans une analyse plus large de l’identité. Ici, la conséquence précise est qu’une dimension modifiée ne réinitialise pas les autres. Ni un nouveau trajet ni un état local vierge n’effacent les données déjà détenues par l’application distante.
L’authentification concerne plusieurs frontières
L’authentification peut viser le service d’automatisation, le proxy ou l’application destinataire. Une validation à une frontière n’autorise pas la suivante. Distinguer ces rôles évite aussi de transmettre des secrets au mauvais destinataire pendant l’analyse d’un échec.
L’API Runs décrit une connexion au service et, séparément, un choix de proxy. Son format d’URL de proxy comporte un nom d’utilisateur et un mot de passe. Ces identifiants autorisent un intermédiaire réseau ; ils ne correspondent ni au compte de l’application ni aux identifiants d’accès au service de navigateur distant.
L’exposition découle du rôle de chaque secret. Le service distant a besoin des informations nécessaires à la connexion au proxy configuré. Le fournisseur du proxy en gère l’autorisation. L’application gère sa propre session de compte. Déplacer un mot de passe d’un champ à l’autre parce que les deux concernent un navigateur ne rend pas leurs destinataires équivalents. Un journal opérationnel doit conserver la frontière en échec sans enregistrer le secret.
Le périmètre d’une erreur importe davantage que son libellé. Une connexion distante qui ne devient jamais utilisable relève de l’enquête client-service. Une erreur d’autorisation du proxy relève de sa configuration et de son fournisseur. Un refus de connexion au compte relève de l’application. Ces événements peuvent dépendre les uns des autres, mais l’un ne prouve pas la cause de l’autre. Une erreur générique peut demander plus d’éléments avant toute attribution.
Un rapport reste utile sans conserver une URL de proxy complète. Il peut indiquer l’exécution, une référence interne approuvée de configuration, la phase et l’heure. Une URL avec identifiants ou un endpoint contenant un jeton de service peut transformer un document de support en copie supplémentaire de données sensibles. Le guide des proxies BotBrowser traite aussi les identifiants comme un sujet opérationnel ; un format documenté n’est pas une raison de coller des secrets réels dans les rapports.
Les données de session demandent la même prudence. Un profil peut conserver un cookie de connexion et une capture montrer des requêtes associées. Aucun de ces éléments n’est nécessaire en totalité pour établir une configuration de run inattendue. Le bon élément est le plus petit enregistrement répondant à la question. Conserver du contenu de pages ou de comptes sans rapport augmente l’exposition sans expliquer le proxy attribué.
Les descriptions publiques de Rebrowser établissent des interfaces, pas une cartographie complète des accès internes aux secrets ou de leur conservation. Une évaluation de sécurité doit encore examiner conditions du service, contrôles d’accès et politiques opérationnelles. Un paramètre de proxy ne prouve pas qui peut consulter chaque secret manipulé par le navigateur cloud ni la durée de chaque enregistrement du prestataire.
Les onglets cloud ne garantissent pas des contextes séparés
Les bibliothèques locales proposent souvent des APIs de création de contextes. Leur présence dans le client ne prouve pas que tous les services distants implémentent le même comportement. La page Unsupported Features de Rebrowser autorise plusieurs onglets mais indique que browser.createBrowserContext() de Puppeteer et browser.newContext() de Playwright restent sans effet dans ses navigateurs cloud.
Cette déclaration doit rester liée au service cloud et à la documentation consultée. Elle ne signifie pas que ces APIs ne fonctionnent jamais, ni que les correctifs ouverts suppriment les contextes d’un navigateur local. Une bibliothèque, un exécutable et un service cloud ont des périmètres distincts. Le même nom de méthode peut figurer dans un client dont l’endpoint prend en charge des opérations différentes.
Pour le routage, deux onglets ne prouvent donc pas deux périmètres de proxy configurables indépendamment. La documentation attribue un proxy au run et ne fournit pas la création ordinaire de contextes pour le diviser. Une architecture dépendant d’un stockage ou de trajets distincts doit disposer d’une prise en charge explicite. Un deuxième objet de page ne fournit pas cette garantie.
BotBrowser documente une autre interface. Son guide du changement dynamique décrit la modification du proxy d’un BrowserContext précis par une session CDP au niveau navigateur, avec les prérequis ENT Tier3. Il faut attendre la fin du changement avant une navigation dépendant du nouvel état géographique. Ces contrôles appartiennent à BotBrowser et ne démontrent pas qu’un endpoint cloud tiers les implémente.
Même dans une implémentation compatible, le moment compte. Le guide BotBrowser précise que les requêtes suivantes utilisent le nouveau proxy, alors que celles déjà en cours peuvent se terminer via l’ancien. Ce cycle documenté n’est pas une promesse universelle de migration instantanée de toutes les connexions. Modifier le trajet d’un contexte ne crée pas non plus un nouveau stockage et n’efface pas les données applicatives côté serveur.
L’article sur le changement dynamique de proxy développe le choix entre configuration par contexte et instances séparées pour ce produit. La documentation cloud de Rebrowser impose une autre décision : attribuer les responsabilités selon son propre modèle de runs et profils. Une architecture disant seulement « un contexte par tâche » reste incomplète jusqu’à confirmation du comportement requis par le service distant.
DNS et transport demandent leurs propres preuves
HTTP et SOCKS5 désignent des interfaces de proxy. À eux seuls, ils n’établissent pas toutes les propriétés du DNS, des connexions chiffrées ou de la couverture du trafic cloud. La page Key Concepts déclare que les requêtes du navigateur distant passent par le proxy attribué et nomme ces protocoles. Elle ne précise pas où chaque nom est résolu et ne fournit pas de trace DNS d’une exécution réelle.
La question DNS diffère de celle de l’adresse de sortie. Le service recevant une requête observe sa source réseau apparente, tandis que le résolveur ayant obtenu l’adresse est un autre participant. Une sortie attendue ne prouve pas quel résolveur a été utilisé. De même, un endpoint de contrôle en WebSocket sécurisé n’établit pas les propriétés de chaque connexion entre navigateur et proxy.
La documentation BotBrowser distingue explicitement socks5://, avec résolution locale, de socks5h://, avec résolution distante. Il s’agit d’un contrat produit précis. On ne doit pas le transférer à Rebrowser parce que les deux mentionnent SOCKS5. Compatibilité, formats acceptés et comportement de résolution doivent être établis pour le service concerné.
La confidentialité du transport porte aussi sur des liens précis. Le navigateur peut utiliser une connexion applicative chiffrée alors que le fournisseur du proxy traite encore des métadonnées de connexion. Le prestataire cloud exploite le navigateur qui traite la page. La visibilité exacte du contenu dépend du protocole et d’une éventuelle terminaison de connexion chez l’intermédiaire. Qualifier un proxy de privé sans identifier ces liens omet la question centrale de l’analyse.
Rebrowser avertit dans sa description des proxies que les fournisseurs peuvent restreindre certaines catégories de destinations. Cela fournit une autre explication documentée possible : un trajet choisi peut être soumis à la politique de l’intermédiaire. Ce n’est pas la preuve de la cause d’un échec particulier, mais une application inaccessible ne doit pas être automatiquement décrite comme un problème de signaux du navigateur.
Les éléments restent spécifiques : une attribution de route est un fait de configuration ; une réponse d’un endpoint maîtrisé observe un échange applicatif ; une observation DNS concerne la résolution ; une déclaration du fournisseur concerne sa politique. Aucun ne remplace tous les autres. Aucun essai réel de proxy ou navigateur cloud Rebrowser n’est fourni ; interfaces documentées et couverture mesurée restent distinctes.
Ce que modifie le correctif de bibliothèque
Les correctifs ouverts Rebrowser ont encore un autre périmètre. Leur README décrit des modifications du code de Puppeteer et Playwright et indique explicitement que les paquets de remplacement modifient la bibliothèque, pas le navigateur. Cela établit une distinction de couches logicielles. Le paquet ne devient pas un fournisseur de proxy et son installation ne prouve pas le trajet d’un run cloud.
La comparaison des correctifs Rebrowser et de la couche navigateur examine une implémentation figée et une comparaison locale contrôlée. Ses observations dépendent de ces paquets, versions et conditions. Elles ne peuvent pas être transférées au cloud comme si celui-ci avait été mesuré dans le même essai. La documentation cloud fournit d’autres faits : création du run, choix du proxy, persistance et fonctions non prises en charge.
Événements documentés de fin d’exécution
La description des événements Runs API donne une preuve plus précise de fin de session cloud qu’une capture applicative. Une exécution retournée peut contenir results.events, avec les champs type, date et data. Les valeurs documentées distinguent fermeture explicite et terminaison automatique. L’identifiant rattache l’événement à une instance ; la date le sépare d’une exécution ultérieure utilisant le même profil. Ces enregistrements décrivent le cycle du service, sans constituer une trace des requêtes réseau du navigateur.
Un événement apiFinish signifie que l’exécution a été terminée par /finishRun. Il indique le mode de terminaison, pas un refus du destinataire ni une panne du proxy. Face à une fin inattendue, il peut être rapproché du journal autorisé de contrôle du travail. La description publique n’identifie pas chaque personne ou processus appelant. Une attribution à un opérateur précis exige un enregistrement d’accès protégé ; le seul nom de l’événement ne constitue pas un historique des actions du compte.
Un warning dont data contient clientActionTimeout indique une fin automatique faute de commandes CDP pendant le délai d’inactivité. L’activité du client ne se confond pas avec une page encore affichée ou l’intention de poursuivre le travail. Une image conservée ne prouve pas l’envoi de commandes. Cette description ne donne pas de durée numérique : elle ne permet ni d’inventer un délai ni de prescrire du trafic périodique. La distinction utile oppose inactivité automatique et demande explicite de fermeture.
Un warning contenant maxRunDurationReached signale une autre fin automatique : la durée maximale documentée est de 6 heures. Un travail atteignant cette limite doit distinguer fin d’une exécution et démarrage de la suivante, même avec le même profil. Cet événement n’établit ni effacement du cache, ni erreur d’authentification du proxy, ni changement de politique du destinataire. Chaque question exige ses propres éléments. Conserver ensemble durée et code évite de classer toutes les déconnexions distantes comme une panne unique.
L’API décrit séparément les problèmes système dans errors[].code. L’exemple connectBrowser-connect signifie que la connexion au navigateur n’a pas pu être rétablie. Il ne situe pas une panne chez le fournisseur du proxy, ne révèle pas une décision du destinataire et n’établit pas quelles requêtes ont abouti avant la perte de connexion. Tableau d’événements et champ d’erreur répondent donc à des questions proches mais distinctes : comment l’exécution s’est terminée et quel problème système a été enregistré. Aucun ne remplace les paramètres effectifs du proxy.
Un compte rendu minimal peut retenir identifiant, heure, type et motif non secret, avec des références internes au profil et au proxy sélectionnés. Les comparer aux paramètres effectifs sépare erreur de sélection et fin documentée du cycle de vie. Les données absentes doivent rester absentes, sans être déduites de l’apparence d’une page. Cette interprétation utilise les champs publics ; aucun compte cloud, aucune session proxy réelle et aucun historique du service n’ont été inspectés. Un endpoint WebSocket authentifié complet n’est pas nécessaire pour expliquer ces catégories.
Responsabilité des échecs et éléments de preuve
Un échec peut être décrit précisément avant que sa cause finale soit connue. L’API Runs expose des enregistrements et événements, dont les raisons de fin du run. Ils concernent le cycle de vie du service. Une réponse applicative concerne le destinataire. Un paramètre de profil concerne l’état prévu. Leur ordre temporel aide à distinguer les faits des explications possibles.
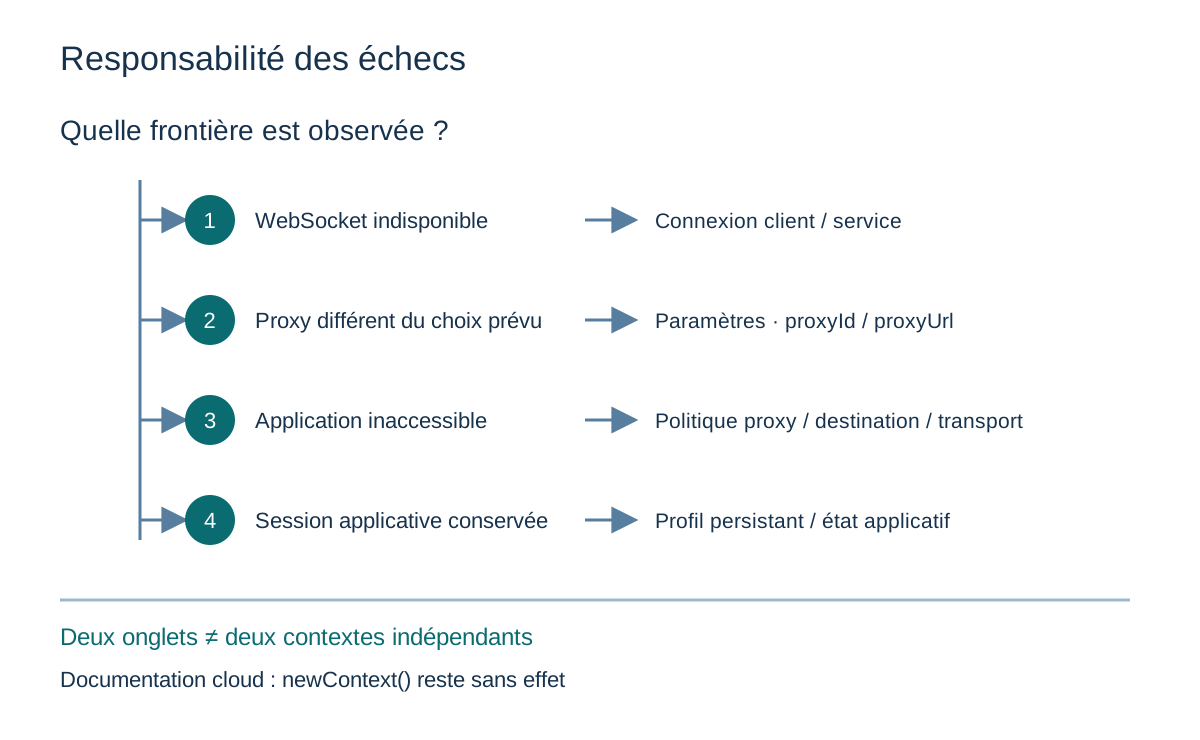
| Observation | Frontière pertinente | Ce qu’elle n’établit pas |
|---|---|---|
| Endpoint distant inutilisable par le client | Connexion client-service | Proxy qu’une requête applicative aurait emprunté |
| Proxy inattendu dans les paramètres effectifs | Choix du run et héritage | Responsabilité d’un correctif de bibliothèque |
| Requête incapable d’atteindre l’application | Trajet, politique et disponibilité | Participant responsable sans autres éléments |
| Session conservée dans un nouveau run | Profil persistant et session applicative | Maintien du trajet de l’ancien proxy |
| Deux onglets dans un run cloud | Organisation des pages | Contextes, stockages ou proxies indépendants |
Le tableau classe les observations ; il ne fournit pas une procédure d’accès à un service protégé. Un endpoint distant peut être indisponible pour une raison étrangère à la page. Un proxy peut refuser une connexion selon sa politique. Une application peut renvoyer une réponse d’autorisation alors que le transport fonctionne. Ces conditions ont des responsables distincts et doivent être examinées dans un environnement autorisé.
Un dossier utile conserve phase, heure, référence du run et référence de sa configuration effective. Il précise si l’observation vient du client, du tableau de bord cloud ou d’une application maîtrisée. Sans cette origine, le libellé d’erreur peut être ambigu ; une capture complète peut exposer davantage que nécessaire. Il faut préserver la distinction entre absence de preuve et preuve de défaillance d’un composant.
Questions fréquentes
Rebrowser fournit-il les proxies ou impose-t-il un fournisseur externe ?
Key Concepts décrit des proxies de centre de données inclus dans certains plans, d’autres types proposés et la possibilité d’ajouter un proxy externe. Ce sont des options déclarées, pas une adéquation mesurée ni une promesse d’acceptation par un destinataire.
Omettre un paramètre signifie-t-il une connexion directe ?
L’API Runs renvoie au profil et aux groupes. Key Concepts attribue un proxy à chaque run. Un paramètre absent ne doit donc pas être présenté comme une preuve de connexion directe.
Modifier un groupe actualise-t-il immédiatement tous les navigateurs actifs ?
La documentation décrit les paramètres effectifs au démarrage. Elle ne démontre pas la mise à jour immédiate de tous les runs existants. Sélection initiale et changement en cours d’exécution demandent des déclarations séparées.
Finir le run supprime-t-il les données applicatives ?
L’opération coupe les sessions CDP. La persistance est décrite séparément et aucune déclaration n’établit l’effacement des données du destinataire. Il faut identifier le propriétaire du stockage et l’opération de suppression.
Sources
- Rebrowser Key Concepts : runs, proxies, protocoles et ordre des paramètres.
- Rebrowser Runs API : profils, proxies, endpoints, journaux et fin des runs.
- Rebrowser Profiles & Persistent Context : continuité, cache et plateformes.
- Rebrowser Unsupported Features : onglets et limitation des contextes cloud.
- README des correctifs Rebrowser : périmètre des paquets d’automatisation.
- Configuration du proxy et changement dynamique BotBrowser : contrôles et prérequis distincts.
Conclusion pratique
La configuration de proxy Rebrowser concerne le trajet d’un run cloud. Le choix effectif dépend éventuellement du profil, des groupes ou d’un paramètre explicite au démarrage. Données persistantes, connexions de contrôle et bibliothèques ont des responsables et des durées différents. La limitation cloud documentée sur les contextes rend ces différences essentielles lors du passage d’une architecture locale au service distant.
Pour un déploiement autorisé, choisir les frontières de stockage et de routage selon le modèle documenté, puis examiner les observations à ce périmètre. Les contrôles de navigateur et contexte BotBrowser proposent un autre modèle ; ils ne prouvent pas l’implémentation d’un tiers. Un trajet et un environnement définis laissent encore autorisation applicative, traitement du fournisseur et historique serveur à leurs responsables respectifs.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
Correctifs Rebrowser : une fois le proxy connecté
RéseauChangement dynamique de proxy pour des contextes de navigateur séparés
EmpreinteBotright : portée de l’automatisation et confidentialité
RéseauVue d’ensemble de la configuration proxy : carte des décisions réseau
DémarrageBotBrowser Launcher : profils, proxy et démarrage
DémarrageProxy Playwright : routes, authentification et signaux
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.