Web Unblocker et API de scraping: usages et limites
Un débloqueur hébergé renvoie des données, pas une session. Cette forme de requête décide des travaux qu'il sert. Un cadre de coût est inclus.
BotBrowser Team
Vous voulez la documentation structurée pour Documentation ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Un débloqueur hébergé répond à une requête HTTP avec des données puis l'oublie, et cette forme de requête décide presque tout de son bon usage. BotBrowser fournit un profil déclaré qui maintient la cohérence des surfaces lisibles par une page d'un lancement à l'autre, et ne peut pas remplacer un pool de proxys, une flotte gérée ou un service de nouvelles tentatives. La documentation des fournisseurs montre ce que la catégorie vend réellement: un pipeline de requêtes qui prend en charge le routage, les nouvelles tentatives, le rendu et la génération de sa propre empreinte, plus un identifiant de session qui conserve une sortie réseau pendant une fenêtre bornée, et non un navigateur qui reste identique.
Résumé
- Un débloqueur est un pipeline de requêtes: vous envoyez une URL, vous recevez un résultat, et aucun processus de navigateur ne reste à inspecter ensuite.
- Les éléments documentés sont le routage, les nouvelles tentatives, le rendu JavaScript et la génération d'empreintes assurée par le fournisseur.
- La continuité est bornée et limitée à un périmètre: un fournisseur documente un identifiant de session qui conserve une sortie pendant dix minutes au maximum.
- Il s'agit d'une continuité de sortie réseau, pas d'une continuité d'identité du navigateur, et les deux répondent à des exigences différentes.
- Les services gérés conviennent aux extractions ponctuelles, aux petits volumes et aux travaux sans authentification.
- Ils conviennent mal lorsqu'il faut le même navigateur reconnaissable pendant plusieurs jours, ou lorsque le contenu de la requête ne peut pas quitter votre périmètre.
- La comparaison des coûts est une question d'utilisation, et le cadre ci-dessous calcule les deux côtés sans citer aucun prix.
Sommaire
- Ce que vend réellement la catégorie
- Les limites imposées par la forme de la requête
- Quand un service hébergé est le bon outil
- Quand c'est le mauvais outil
- Le coût, sans détour
- Conclusion pratique
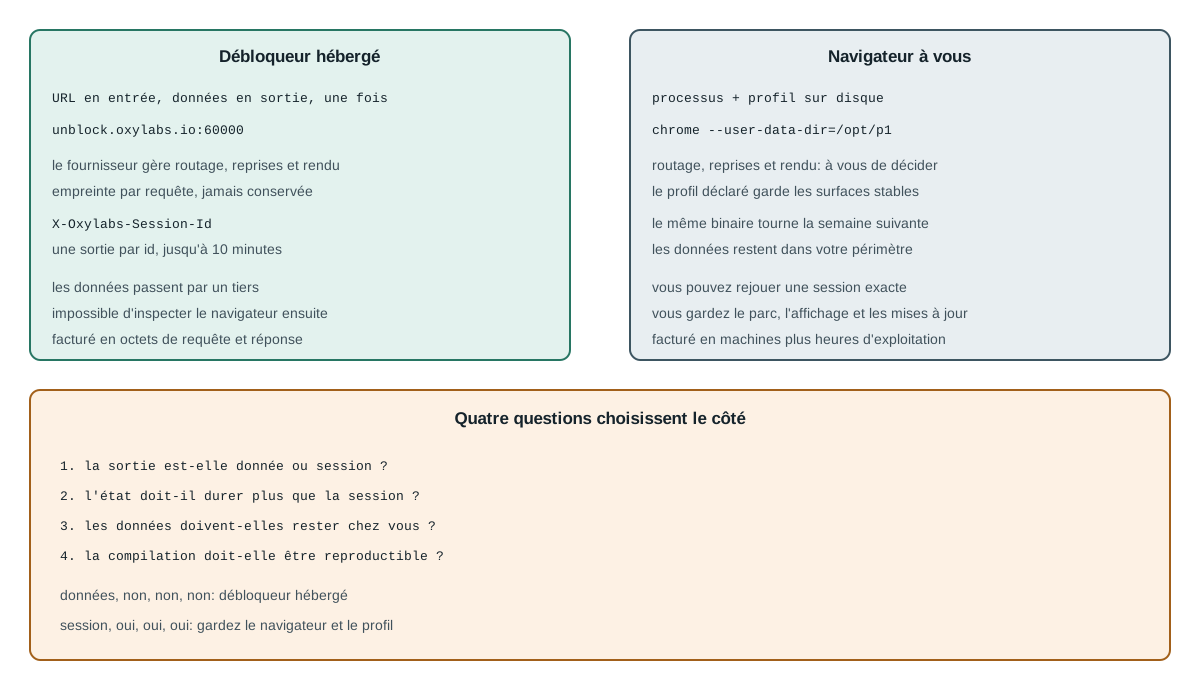
Ce que vend réellement la catégorie
La documentation est inhabituellement explicite sur la composition, ce qui permet de traiter cette section brièvement. Oxylabs décrit Web Unblocker comme une solution de proxy assistée par IA qui gère le type de proxy, la génération d'empreintes du navigateur, les nouvelles tentatives automatiques, le maintien de session et le rendu JavaScript. Browserless expose la même idée par des points de terminaison REST, où une requête HTTP exécute une tâche de navigateur et renvoie un résultat plutôt qu'une session.
you send      -> https://unblock.oxylabs.io:60000  (proxy endpoint) or /content, /scrape (REST)
you receive   -> HTML, JSON or an image, once
you do not get-> a browser process, a profile directory or a build you chose
Deux détails de cette liste comptent plus que l'argument principal. Le premier est la génération d'empreintes: c'est le fournisseur qui la produit, ce qui signifie qu'elle n'est pas entre vos mains pour rester constante pendant des jours. Le second concerne les nouvelles tentatives: le fournisseur décide du moment où il réessaie, ce qui est pratique jusqu'au jour où vous devez savoir si une réponse est arrivée après trois tentatives ou dès la première, et la règle de facturation documentée ne facture que la tentative visible sur la facture.
Ce n'est pas une critique. Un pipeline de requêtes est la bonne forme pour une vaste classe de travaux, et c'est la raison d'être de la catégorie. Le point est que la forme reste une forme: elle détermine ce que vous pouvez affirmer ensuite.
La forme décide aussi de ce qui peut être comparé. Une équipe qui choisit entre un pipeline hébergé et son propre navigateur choisit en réalité entre deux modèles de protection, et ce qu'un noyau de navigateur change par rapport aux surcharges de script injectées explique pourquoi une protection partielle peut être plus distinctive qu'aucune. Un pipeline hébergé est cohérent par construction parce qu'un seul système produit toutes les valeurs; un navigateur auto-hébergé n'est cohérent que si le profil les déclare toutes.
assertable after a request    -> status code, body, latency, credit cost
not assertable               -> which browser build ran, which profile, which fingerprint
Les limites imposées par la forme de la requête
Trois limites découlent de l'envoi d'une URL et de la réception d'un résultat, et chacune est documentée plutôt que supposée.
La première est une continuité bornée. Oxylabs documente un en-tête X-Oxylabs-Session-Id qui affecte une sortie à un identifiant de session pendant 10 minutes au maximum, après quoi une autre sortie est attribuée. C'est une fonction réelle, utile aux flux en plusieurs étapes. C'est aussi une fenêtre d'affinité de sortie, pas une identité durable du navigateur: après 10 minutes, la sortie réseau change, et rien dans la réponse ne dit à quoi ressemblait le navigateur avant ou après.
session id -> one proxy for up to 10 minutes -> new proxy afterwards
             (egress continuity, not browser continuity)
La deuxième limite tient au fait que l'empreinte est générée à l'intérieur du fournisseur. La liste des fonctions le dit directement, et l'architecture l'explique: un service qui exécute des milliers de requêtes par minute ne peut pas lire votre profil sur le disque. Ce qu'il peut faire, c'est en générer une cohérente pour chaque requête, ce que la documentation annonce. La conséquence pour le lecteur est étroite: si l'exigence est "le même navigateur lundi et vendredi", ce n'est pas la bonne couche qu'il faut solliciter.
La troisième est le chemin des données. Une requête qui traverse un pipeline hébergé transporte l'URL, les en-têtes que vous configurez, les cookies que vous transmettez et le corps de la réponse chez un tiers. Pour des pages publiques, c'est souvent acceptable; pour tout ce qui comporte une authentification, un identifiant client ou une clause contractuelle de résidence des données, cela ne l'est généralement pas. C'est un fait de conformité plutôt qu'un défaut du produit, et il appartient à la décision avant le prix.
Cette troisième limite s'accompagne d'un test pratique, assez court pour être exécuté avant de signer quoi que ce soit. Listez les champs que transporte la requête: l'URL, chaque en-tête, chaque cookie, le corps et la réponse. Demandez ensuite, pour chaque champ, s'il peut légalement quitter l'environnement dans lequel le travail s'exécute. Si un seul champ ne le peut pas, un pipeline hébergé est écarté pour cette cible quelle que soit sa performance, et le remplacement n'est pas un meilleur fournisseur mais un navigateur à l'intérieur du périmètre.
allowed to leave -> public URL, no cookies, no account identifiers
not allowed      -> session cookies, bearer tokens, customer records, regulated data
leaves your perimeter -> target URL, request headers, cookies, response body
stays with provider   -> retry history, generated fingerprint, routing decision
Deux autres propriétés comptent pour la reproductibilité. Un pipeline hébergé se met à jour selon son propre calendrier, si bien que deux requêtes identiques à un mois d'intervalle peuvent être servies par des composants internes différents; et le modèle de crédits mesure du trafic, si bien que la taille du corps reçu compte autant que le nombre de requêtes. La règle de nouvelles tentatives documentée est la moitié rassurante: une nouvelle tentative interne qui aboutit n'est facturée qu'une fois. Ni l'une ni l'autre n'est cachée: les deux sont visibles dans la documentation et le tableau de bord, pas dans la réponse.
Une quatrième limite est facile à manquer jusqu'au moment où elle gêne: le point de terminaison parle HTTP, donc le seul levier sur le navigateur est l'ensemble d'en-têtes documenté par le fournisseur. Oxylabs propose des instructions de navigateur personnalisées et un en-tête de rendu JavaScript pour Web Unblocker, et les deux sont réellement utiles. Aucun ne permet d'affirmer quelle compilation a tourné, quelles polices étaient installées ou quel chemin GPU a été emprunté, car le navigateur est derrière le point de terminaison plutôt que devant vous. Un test écrit contre un point de terminaison hébergé peut affirmer les données; il ne peut pas affirmer le navigateur, et toute affirmation contraire porte sur la génération interne du fournisseur, pas sur votre reproduction.
assertable through the endpoint -> status, body, latency, credits spent
assertable only on a browser    -> build, profile, fonts, GPU, extensions, timing
C'est aussi pourquoi un service hébergé est un mauvais choix pour une suite de régression. Une suite qui compare la capture d'hier à celle d'aujourd'hui a besoin que les deux images viennent de la même compilation, avec les mêmes polices et le même rapport de pixels de l'appareil, alors qu'un point de terminaison hébergé fait délibérément varier ces trois éléments dans sa flotte pour franchir les contrôles d'empreinte. La variation qui le rend efficace face à une cible est exactement celle qui le rend inutilisable comme référence fixe.
La réponse pratique est une séparation, pas un vainqueur. Utilisez le point de terminaison hébergé lorsque la question est "cette URL renvoie-t-elle les données", et un navigateur que vous exécutez lorsque la question est "cette page se rend-elle encore comme avant". Les deux questions sont légitimes et demandent des instruments différents.
Quand un service hébergé est le bon outil
Le bon usage se décrit plus facilement par une liste de conditions qui doivent toutes être réunies, car un travail qui en satisfait quatre sur cinq appartient généralement ailleurs.
- La sortie attendue est constituée de données et non d'une session, donc rien en aval n'a besoin de piloter une page.
- Le travail est ponctuel ou de volume faible et régulier, là où exploiter une flotte coûterait plus qu'elle n'économise.
- Aucun état d'authentification ne doit survivre entre les requêtes, donc la fenêtre d'affinité de dix minutes suffit.
- Le contenu de la requête est public ou non sensible, donc la présence d'un tiers dans le chemin des données est acceptable.
- Vous n'avez pas besoin de reproduire le navigateur lui-même, seulement le résultat de l'extraction.
Lorsque ces conditions sont réunies, le pipeline hébergé coûte moins cher dans tous les sens qui comptent: une requête HTTP remplace un processus, et un 200 avec un corps constitue tout le contrat. Aucune machine à entretenir, aucun navigateur à mettre à jour, aucun pool à surveiller. C'est la raison d'être de la catégorie, et une équipe qui a exactement ce besoin ne devrait pas le construire.
Un deuxième usage légitime est une première passe sur une nouvelle cible. Envoyer quelques requêtes par un service hébergé indique si la page renvoie des données avant que quiconque écrive un harnais de navigateur, et la réponse coûte quelques crédits. Diagnostiquer un scraping bloqué par couche est la méthode qui transforme cette première passe en décision plutôt qu'en habitude.
Un troisième usage est une charge dont les cibles tournent. Un travail de surveillance qui observe deux cents pages publiques sans rapport une fois par jour tire peu d'un navigateur persistant, car chaque page est une origine différente et l'identité qui compte est la cohérence par requête, non la continuité. Le routage hébergé résout ce cas directement: le fournisseur choisit une sortie adaptée à la cible et le travail n'a jamais besoin de savoir laquelle. Le même travail avec un navigateur auto-hébergé exigerait un pool dimensionné selon les cibles simultanées et une règle sur la sortie vue par chaque origine, soit plus de mécanique que le travail ne le justifie.
one origin, many runs      -> continuity matters; a browser you own
many origins, one run each -> coherence per request; a hosted pipeline
Quand c'est le mauvais outil
Les conditions symétriques sont tout aussi concrètes, et chacune nomme l'exigence que la forme de la requête ne peut pas satisfaire.
- Le même navigateur doit rester reconnaissable la semaine suivante, donc l'identité doit survivre à la requête.
- Les données ne peuvent pas quitter votre infrastructure, que ce soit pour une raison de résidence, de contrat ou d'obligation client.
- Vous devez figer la compilation du navigateur, car une différence de mise en page ou de codec change le résultat.
- Vous devez rejouer une session exacte pour comparer deux exécutions, ce qui exige de conserver la session au lieu de la redemander.
- Vous avez besoin d'un état par identité qui persiste pendant des jours, et cela correspond à un répertoire de profil, pas à un en-tête de session.
Dans ces cas, le navigateur doit s'exécuter dans un lieu que vous contrôlez, et le travail absorbé par un service hébergé devient explicite: installer une compilation figée, conserver un répertoire de profil, maintenir l'affichage ou le conteneur en bon état et consigner ce qui a tourné. Figer une version de Chrome for Testing est la moitié matérielle de ce travail, et Browserless face aux navigateurs auto-hébergés est la décision voisine sur le lieu d'exécution du processus lorsque l'identité reste la vôtre.
La dernière de ces conditions est celle qui surprend les équipes, et mérite donc d'être explicitée. Rejouer une session exacte signifie conserver le navigateur entre deux observations, pas envoyer deux fois la même requête. Un point de terminaison hébergé ne peut pas le faire, car la seconde requête est une nouvelle session par construction; un navigateur que vous exploitez le peut, car le répertoire de profil, par exemple celui lancé avec chrome --user-data-dir=/opt/p1, et le processus sont toujours là. Quand un rapport affirme que "cela fonctionnait mardi", la seule façon de tester cette affirmation est de revenir au même navigateur, et c'est une capacité plutôt qu'un confort.
replay definition -> same process, same profile, same build, second observation
not a replay      -> same URL sent again through a stateless endpoint
hosted unblocker  -> you own: the query, the parsing, the decision to retry
self-hosted       -> you own: the binary, the profile, the pool, the display, the record
Le coût, sans détour
Aucun des deux côtés n'est un nombre sans votre charge de travail, mais les deux sont calculables, et écrire la formule est plus utile que lire le prix de quelqu'un d'autre.
hosted monthly    ~= consumed_traffic x unit_price    (request bytes + response bytes)
self-hosted cost  ~= machines x hours + ops_hours x loaded_rate + egress
crossover         -> where hosted_traffic x unit_price equals the fixed side
Deux corrections rendent cette arithmétique honnête, et toutes deux viennent de la page de facturation du fournisseur plutôt que d'une supposition sur le fonctionnement d'un pool de proxys. La première est que le compteur mesure du trafic, pas des requêtes: Oxylabs facture les octets de la requête et les octets de la réponse des données extraites avec succès, si bien qu'un grand corps JSON coûte plus qu'un petit et qu'une différence de compression change la facture sans changer le nombre de requêtes. La seconde est la règle des nouvelles tentatives, et elle va à l'opposé de l'intuition la plus courante. Lorsqu'une requête demande trois tentatives internes et que la dernière réussit, la documentation précise que seul le trafic consommé pendant la dernière tentative réussie est facturé; et lorsque le côté du fournisseur échoue avec un 5xx, cette tentative n'est pas facturée. L'exception documentée va dans l'autre sens: un échec causé par le client reste facturé, si bien qu'une requête mal formée ou des identifiants erronés peuvent coûter du trafic sans renvoyer de données.
Un exemple chiffré rend la forme concrète sans citer le tarif d'aucun fournisseur. Supposons qu'un travail émette cinquante mille requêtes par mois et qu'une sur dix demande une tentative interne supplémentaire avant de réussir, soit cinquante-cinq mille tentatives au total. Selon la règle documentée, les unités facturées restent cinquante mille requêtes réussies, car la tentative supplémentaire à l'intérieur d'une requête réussie n'est pas facturée séparément. Le terme qui bouge est le trafic: si chaque réussite consomme deux cents kilo-octets entre requête et réponse, le mois totalise dix gigaoctets de trafic facturé, et une cible dont la taille de page double déplace la facture deux fois plus loin qu'une cible dont le taux de nouvelles tentatives double. Côté auto-hébergé, le même travail tient dans quelques navigateurs simultanés sur deux machines pendant huit heures par jour, et l'arithmétique est faite d'heures machine plus les heures passées par quelqu'un à les mettre à jour.
requests issued          50000
internal attempts        55000  (1 in 10 needs one extra)
billed successful units  50000  (only the last, successful attempt)
billed traffic           ~10 GB at 200 kB per success
low, spiky volume   -> per-request billing follows the spikes; hosted usually cheaper
high, steady volume -> fixed machines amortise; self-hosted usually cheaper
either way          -> the identity requirement is not in this arithmetic at all
Le niveau gratuit mérite une phrase simple plutôt qu'un dédain, car une part importante des recherches autour de cette catégorie le cherche précisément. Les fournisseurs publient une allocation gratuite, et Oxylabs documente un crédit de bienvenue. Une allocation gratuite est un moyen légitime d'évaluer un pipeline; elle ne permet pas d'exploiter une charge qui exige de la concurrence, car les niveaux gratuits publiés plafonnent les sessions simultanées et leur durée. Lire ce plafond avant de construire sur le niveau gratuit sépare un pilote d'une panne.
Une alternative open source est l'autre objet de ces recherches, et mérite le même traitement simple. Un débloqueur auto-hébergé existe, et il correspond essentiellement au travail de pool de navigateurs décrit plus haut, plus une couche de routage et une boucle de signalement des détecteurs, soit une grande quantité de code à maintenir. Cela vaut la peine lorsque le volume est régulier et que les exigences d'identité sont réelles; cela n'en vaut pas la peine pour éviter un abonnement sur un travail qui tourne deux fois par semaine, car le coût d'exploitation d'un pool est dominé par les heures passées à le surveiller, non par les machines qu'il utilise. Un pool que personne ne surveille est un pool qui échoue silencieusement un samedi, et l'abonnement qu'il remplaçait payait exactement cette attention.
free tier        -> good for a pilot, capped on concurrency and session length
open-source      -> good at steady volume, costs engineering hours to operate
paid per request -> good for spiky or low volume, follows the spikes
Conclusion pratique
Posez quatre questions dans l'ordre. La sortie doit-elle être des données ou une session? Un état doit-il survivre plus longtemps que la fenêtre du fournisseur? Le contenu de la requête doit-il rester dans votre périmètre? Le navigateur lui-même doit-il être reproductible? Un travail qui répond "données, non, non, non" relève d'un débloqueur hébergé, et l'en-tête de session de dix minutes lui suffit. Un travail qui répond "session, oui, oui, oui" relève d'un navigateur que vous exécutez, et aucun réglage de la requête hébergée ne le remplacera.
Le mode de défaillance à éviter est le cas mixte, où une équipe commence par un pipeline hébergé, ajoute une authentification, puis ajoute une exigence de persistance et continue d'étendre la requête jusqu'à construire un harnais de navigateur à partir de nouvelles tentatives. À ce stade, le geste honnête consiste à exécuter le navigateur, conserver le profil et réserver le service hébergé aux cibles qui correspondent encore à la forme de la requête.
Les deux changements coûtent moins que l'alternative, un pipeline dont personne ne peut reproduire le comportement. Consignez le côté utilisé par chaque cible et la raison; scraping avec navigateur headless: ce qui change est la liste des différences une fois le navigateur de votre côté de la ligne.
Sources
Articles Connexes
Browserless face aux navigateurs auto-hébergés
ComparaisonQue change un navigateur antidétection ?
DémarrageNavigateur pour le web scraping : six critères
ComparaisonCœur du navigateur et scripts JavaScript pour les empreintes
DéploiementProtection des empreintes du navigateur pour la collecte web
DéploiementScraping Shopify : Storefront API, Ajax ou navigateur ?
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.