Scraping SERP a escala: requisitos del navegador
Planifica el scraping SERP a escala midiendo páginas por hora, retraso de inicio, capacidad del navegador y espera de red por separado antes de elegir un entorno.
BotBrowser Team
Quieres la documentación estructurada de Despliegue?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
El scraping SERP a escala es un problema de planificación de carga: el navegador debe sostener un objetivo requerido de páginas por hora sin convertir el inicio, la renderización o la memoria en un cuello de botella oculto. Un plan de medición usa un accesorio propio o un objetivo/API explícitamente autorizado; no contiene instrucciones para recopilar SERP en vivo. BotBrowser proporciona un entorno de ejecución de navegador configurable para una comparación controlada, pero no programa trabajos, no decide si la recopilación está permitida y no garantiza la respuesta de un tercero. Una comparación de compra mide el trabajo del navegador por separado de la espera de red.
TL;DR
- Establece un objetivo en páginas completadas por hora y una latencia máxima aceptable; mide ambos valores en lugar de inferir la capacidad a partir del tiempo de lanzamiento.
- Compara el mismo conjunto representativo de páginas en dos niveles de concurrencia previstos; registra el inicio del navegador, el tiempo hasta la página lista, la memoria y los fallos.
- Mantén fija la configuración del navegador mientras mides la espera de red, y después cambia una sola variable del lado del navegador cada vez.
- Trata la hoja de trabajo y la fórmula siguientes como un plan de medición, no como resultados de referencia de BotBrowser.
- Mide solo un accesorio propio o un objetivo/API explícitamente autorizado; no se incluye ningún procedimiento de recopilación en vivo.
Contenido
- Traducir la carga de trabajo en requisitos del navegador
- Separar el tiempo del navegador del tiempo de red
- Un plan de medición reutilizable
- Conclusión práctica
Traducir la carga de trabajo en requisitos del navegador
“A escala” no oculta una única cifra de navegadores. Un objetivo de planificación necesita al menos un volumen de páginas, una ventana de observación, una definición de página lista y un rango aceptable de tiempo de finalización. Si un trabajo necesita 12,000 páginas completadas en 4 horas, el objetivo aritmético es 3,000 páginas por hora. Este es un cálculo de ejemplo, no una capacidad medida del navegador ni una recomendación sobre el volumen de recopilación.
Las páginas por hora resultan más útiles que los lanzamientos de navegador por hora porque un lanzamiento solo representa la preparación. La carga de trabajo también paga por crear un contexto, navegar, ejecutar scripts de página, esperar la condición de preparación elegida y almacenar el resultado. Un navegador que arranca rápido pero pasa la mayor parte de cada trabajo esperando tareas de página puede incumplir el objetivo. Por el contrario, un lanzamiento inicial lento puede amortizarse cuando un diseño compatible reutiliza un proceso o contexto de navegador. La documentación de optimización del rendimiento cubre el ajuste del entorno de ejecución; los requisitos de carga pertenecen a la comparación previa a la compra.
La latencia también necesita una definición. Registra el tiempo desde el inicio de la navegación hasta la señal exacta de preparación que necesita la carga de trabajo, no un evento “página cargada” sin especificar. Una SERP puede tener contenido útil antes de que terminen todas las imágenes o recursos diferidos, pero elegir otra condición de preparación cambia el resultado. Mantén esa condición idéntica entre comparaciones y documéntala junto con el resultado.
| Campo del requisito | Valor de ejemplo | Nota |
|---|---|---|
| Páginas completadas | 12000 | Trabajo total, no recuento de lanzamientos |
| Ventana de observación | 4 h = 14400 s | Tiempo transcurrido disponible |
| Señal de preparación | page-ready cuando exista el contenido requerido | Debe permanecer fija |
| Objetivo medio | 12000 / 14400 * 3600 = 3000 pages/h | Requisito aritmético únicamente |
| Objetivo de latencia | p95 <= 20 s para el mismo evento de preparación | Límite de cola, no una media |
La fórmula hace explícita la media solicitada; no predice la capacidad del navegador, del host, de la ruta ni de la respuesta. El inicio, las pausas programadas, los reintentos y la persistencia consumen parte de la ventana, por lo que deben registrarse en lugar de quedar ocultos en el agregado. Una flota puede cumplir 3,000 páginas/h mientras un subconjunto tarda más de 20 s, razón por la cual la tasa y el objetivo de p95 pertenecen al mismo requisito.
Define una página completada antes de comparar productos. El navegador puede informar cuándo ocurrió el evento de preparación seleccionado, mientras que la validación o el almacenamiento fuera del navegador pueden terminar después. Mantén separadas esas marcas temporales: un cuello de botella posterior no debe etiquetarse como latencia del navegador, y un manejo de resultados más rápido no debe acreditarse como navegación más rápida.
Antes de observar un candidato, fija la muestra y la regla de detención. Selecciona un conjunto representativo de páginas del accesorio, registra el recuento y la mezcla de complejidad, y decide cuántas repeticiones necesita cada nivel de concurrencia. Por ejemplo, usa 500 pages por repetición, 3 repetitions y dos niveles previstos como 4 contexts y 8 contexts; son entradas de la hoja de trabajo, no límites medidos. Inicia cada repetición desde un estado documentado del navegador y conserva las páginas fallidas o con tiempo agotado en el recuento.
También decide cómo se recopilan las muestras de recursos. Registra la asignación de CPU y memoria del host, el intervalo de muestreo, la compilación del navegador, el identificador del perfil, el modo de lanzamiento y la versión de la biblioteca de automatización. Si un candidato necesita otra ruta de proxy, compárala solo con una ruta que el operador esté autorizado a usar. Mantén sin cambios el contenido del accesorio, el evento de preparación, el host y la ruta mientras pruebas una variable del lado del navegador. Incluye el identificador exacto del accesorio, los campos de configuración y el tamaño de muestra junto a cada resultado para que una repetición use las mismas entradas.
La misma regla de autorización se aplica cuando la carga cambia de resultados de búsqueda a listados organizados por empresa; los límites del scraping de bolsas de empleo definen la lista permitida de páginas públicas y las condiciones de parada para datos autenticados.
Separar el tiempo del navegador del tiempo de red
Una duración observada combina varios costos: inicio del navegador y trabajo del contexto, inicialización del proxy, navegación, renderización local y ejecución de scripts, conexión de red y espera de respuesta, además de cualquier espera deliberada de página en la carga de trabajo. Una observación lenta por sí sola no identifica la capa responsable. El navegador no puede hacer que una respuesta ascendente llegue antes, y un cambio de ruta no demuestra que el inicio del navegador haya sido eficiente. Usa solo un accesorio propio o un objetivo/API explícitamente autorizado para estas comparaciones.
Usa una línea de base controlada. Mantén constantes la compilación del navegador, el perfil, el accesorio propio o el conjunto de páginas autorizado, la condición de preparación, los recursos de la máquina y la ruta de red. Registra el inicio del navegador, la inicialización del proxy, la navegación y la espera de página como etapas separadas. Luego varía un factor: por ejemplo, compara la reutilización de procesos con lanzamientos nuevos mientras dejas la ruta sin cambios. Para examinar los efectos de la ruta, conserva la configuración del navegador y usa solo rutas y objetivos que el operador esté autorizado a probar. La documentación de configuración de proxy describe la ruta de red como una superficie de configuración separada.
La reutilización de contextos y la condición elegida de página lista pueden cambiar el trabajo del lado del navegador sin modificar la ruta. La documentación de rendimiento describe el ajuste del entorno de ejecución para un despliegue que ya está en funcionamiento; este plan, en cambio, captura etapas de tiempo previas a la compra sobre un accesorio controlado. Mantén idénticos el comportamiento del accesorio y la preparación entre comparaciones, y registra cualquier opción del lado del navegador que cambie durante una ejecución. No forma parte de la medición ningún selector, lógica de rastreo, procedimiento para SERP en vivo ni solución alternativa de control de acceso.
El artículo de optimización del rendimiento cubre el ajuste del entorno de ejecución después de que exista un despliegue, mientras que la planificación de capacidad de contextos muestra cómo las curvas de memoria medidas fijan un límite de admisión. Este plan de medición mantiene esas capas separadas: el inicio del navegador y el trabajo de página se registran por separado de la ruta y la espera de respuesta, de modo que una comparación de compra no atribuye cada resultado lento al navegador.
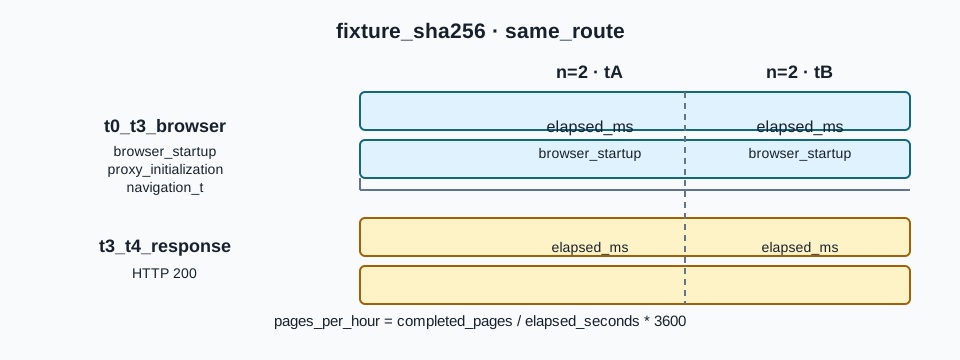
| Etapa | Evento inicial | Evento final | Qué puede respaldar |
|---|---|---|---|
browser_startup | lanzamiento solicitado | el navegador puede aceptar una acción de carga | comparación entre inicio en frío y reutilización |
proxy_initialization | ruta configurada | la primera solicitud puede usar la ruta | costo de preparación |
navigation | inicio de navegación | evento de preparación seleccionado | intervalo completo de página |
response_wait | inicio de solicitud | cabeceras o cuerpo de respuesta disponibles | comportamiento de red observado |
completion | evento de preparación | aceptación posterior | costo ajeno al navegador |
Las etapas pueden superponerse: varias solicitudes pueden estar en curso mientras continúa el trabajo del navegador. Por tanto, sumar la duración de cada solicitud a la latencia hasta página lista puede contar dos veces el tiempo. Trata la tabla como límites de atribución, no como prueba de que un entorno de ejecución tenga un costo del navegador y un costo de red perfectamente separables.
El muestreo de recursos necesita un intervalo fijo, por ejemplo, sample every 5 s, y un registro de los contextos activos en el pico de memoria. El uso del procesador debe provenir de la misma ventana. Si el host alcanza CPU 100% o agota la memoria, el navegador puede volverse más lento aunque su configuración no haya cambiado; la capacidad del host pertenece al registro de la prueba.
El trabajo en frío y en caliente no debe mezclarse en una media inexplicada. La primera página puede incluir el inicio del proceso, la carga del perfil y la configuración inicial que las páginas posteriores no repiten. Si la carga prevista inicia un proceso nuevo por unidad, ese costo en frío es representativo. Si el diseño previsto reutiliza un proceso, la ruta en caliente también importa. Informa ambos casos cuando se consideren los dos patrones de despliegue e indica cuál debe respaldar la decisión de compra. Una ruta en caliente más rápida no demuestra que la ruta en frío vaya a cumplir el mismo calendario.
Un plan de medición reutilizable
La siguiente hoja de trabajo es un plan para completar con observaciones de un accesorio propio o un objetivo/API explícitamente autorizado; los valores están vacíos porque aquí no se representa ninguna ejecución.
| Campo previsto | Registrar para cada comparación | Por qué importa |
|---|---|---|
| Carga de trabajo | Identificador del accesorio/API propio y condición de página lista | Hace equivalentes las ejecuciones comparadas |
| Navegador | Compilación, perfil, modo de lanzamiento, elección de reutilización | Identifica cambios del lado del navegador |
| Etapa 1 | Duración del inicio del navegador | Aísla la inicialización del proceso |
| Etapa 2 | Duración de la inicialización del proxy | Separa la preparación de ruta del trabajo de página |
| Etapa 3 | Duración de la navegación | Registra el intervalo completo de navegación |
| Etapa 4 | Espera de página hasta la condición de preparación fija | Mantiene explícita la regla de finalización |
| Carga | Concurrencia prevista: nivel A y nivel B | Muestra si cambia la tasa medida |
| Resultado | Páginas completadas, tiempo transcurrido, fallos | Permite calcular páginas por hora |
| Costo | Pico de memoria y espera de respuesta observada | Expone la capacidad y la presión de red |
La hoja de trabajo debe tratarse como un registro mínimo, no como una especificación completa de prueba. Añade la asignación de CPU y memoria del host, el sistema operativo, el identificador de compilación del navegador y la versión de la biblioteca de automatización cuando difieran entre candidatos. Registra si el navegador se ejecutó headless o con una pantalla visible, ya que una comparación solo es significativa cuando los modos coinciden con el despliegue previsto. Si un candidato requiere una forma de host diferente, documenta ese hecho explícitamente en lugar de atribuir su resultado únicamente al navegador. Las cuatro etapas temporales son grupos de observación, no una garantía de que cada biblioteca de automatización exponga cuatro mediciones sin superposición; indica el límite de evento usado para cada grupo.
Para la planificación, una tabla de decisión compacta puede mantener las conclusiones vinculadas a la evidencia:
| Observación en la comparación prevista | Interpretación que conviene investigar | Siguiente medición |
|---|---|---|
| El inicio o la inicialización del proxy crece en el nivel B | Es posible que el trabajo de preparación compita con trabajos concurrentes | Repite en A y B manteniendo fijos el accesorio y la ruta |
| La navegación crece mientras las demás etapas permanecen similares | El intervalo completo de navegación necesita una atribución más detallada | Mantén fijo el navegador y revisa las observaciones de espera de respuesta |
| La espera de página crece pero la navegación es estable | El tiempo de preparación o el trabajo de página pueden explicar la diferencia | Vuelve a comprobar el mismo evento de preparación en el mismo accesorio |
| Las páginas por hora cambian poco y el pico de memoria aumenta | Es posible que el host o la carga del navegador estén limitados por recursos | Repite ambos niveles e inspecciona las muestras de recursos del host |
| Las etapas del navegador siguen similares mientras cambia la espera de respuesta | Las condiciones de red pueden explicar la diferencia | Mantén fija la configuración del navegador y revisa una comparación de rutas autorizada |
Estas son indicaciones de interpretación, no hallazgos de referencia. Una fila describe lo que podría significar una observación futura y qué variable inspeccionar después; no afirma que una ejecución de BotBrowser haya producido ese patrón. La misma disciplina se aplica a los resúmenes de compra: incluye la configuración y la ventana de medición junto a cada resultado, y distingue una diferencia observada de una explicación causal.
Para cada ejecución, calcula pages_per_hour = completed_pages / elapsed_seconds * 3600. Esta fórmula normaliza una ejecución completada; no predice la siguiente ejecución. Compara los mismos campos en dos niveles de concurrencia, como una línea de base de baja carga y un nivel planificado superior, en lugar de tratar un único resultado como límite. Si el rendimiento deja de aumentar mientras crecen la memoria del navegador o la latencia hasta página lista, es posible que el navegador o el host estén saturados. Si las medidas del lado del navegador permanecen estables mientras cambia la espera de respuesta, investiga la ruta de red por separado.
Repite el plan las veces necesarias para observar variación e informa el tamaño y la dispersión de la muestra, no solo la ejecución más rápida. Mantén en el registro las páginas del accesorio que fallaron o agotaron el tiempo: eliminarlas haría que la tasa aparente pareciera mejor mientras oculta un costo operativo. Este es un diseño de medición, no una promesa de que dos puntos de concurrencia establezcan un techo universal de capacidad.
Un accesorio propio debe representar la complejidad relevante de las páginas sin incluir datos sensibles de consultas en un informe compartido. Un accesorio estable puede conservar diferentes cargas de renderización y scripts usando etiquetas neutrales. Registra su identificador y las características que importan al trabajo del navegador, como la actividad de scripts, el diseño y el contenido esperado al alcanzar la preparación. No uses el resultado de unas pocas páginas ligeras del accesorio como afirmación sobre toda carga de trabajo. Mantén el accesorio exacto sin cambios entre candidatos para que las diferencias del navegador no se mezclen con diferencias de contenido. Si el objetivo es una API autorizada, identifica la operación de la API, su condición de respuesta documentada y una muestra segura para publicación que omita entradas sensibles.
Los fallos pertenecen al denominador y a un resumen de fallos separado. Un tiempo de espera de navegación agotado, una condición de preparación que nunca ocurre y un error de persistencia posterior son eventos distintos. Etiquétalos según la etapa que los emitió, conserva sus recuentos e indica si las páginas están incluidas en la salida completada. Un valor de páginas por hora sin un recuento de fallos acompañante puede ocultar una tasa de finalización baja. El registro de medición debe conservar suficientes detalles para que otra persona revisora entienda si el candidato completó la tarea definida, no solo si generó actividad del navegador.
La ventana de prueba también necesita una regla de detención. Una ejecución corta puede medir principalmente el inicio, mientras que una ejecución muy larga puede incorporar cambios no relacionados del host o de la ruta. Elige una duración o un recuento de páginas antes de observar los resultados, repite en las mismas condiciones y anota cualquier interrupción. No amplíes solo el candidato que al principio parece más lento, salvo que el plan revisado se aplique después de forma consistente. Esto evita cambiar la comparación después de ver qué resultado resulta más conveniente.
Al final, resume tres cantidades distintas: el rendimiento medio solicitado, el rendimiento completado observado y la distribución de latencia observada. La primera es un requisito; la segunda es un resultado de una configuración registrada; la tercera describe la variación temporal alrededor de esas finalizaciones. Ninguna por sí sola establece una capacidad universal de navegador. Una decisión de compra también debe conservar el registro de configuración, la asignación de recursos, los recuentos de fallos y los límites del accesorio de páginas para que los cambios posteriores puedan compararse con la misma línea de base.
FAQ
¿Basta el tiempo de lanzamiento para estimar la capacidad?
No. El tiempo de lanzamiento omite la navegación, la preparación, la ejecución de página y el manejo de resultados. Es un componente útil, especialmente cuando los lanzamientos son frecuentes, pero las páginas completadas por hora son la medida a nivel de carga de trabajo.
¿Todas las páginas deben usar la misma condición de preparación?
Usa la misma condición dentro de una comparación para que las ejecuciones sean comparables. La condición debe coincidir con el resultado que realmente necesita la carga de trabajo; esperar recursos no relacionados puede exagerar el trabajo del navegador, mientras que detenerse demasiado pronto puede omitir contenido requerido.
¿Una mayor concurrencia siempre aumenta el rendimiento?
No. Las páginas concurrentes adicionales pueden aumentar la contención por CPU, memoria, procesos del navegador o recursos de red. Mide en los niveles previstos y trata una meseta o una latencia creciente como evidencia que debe inspeccionarse, no como un límite universal de capacidad.
¿BotBrowser determina si una carga de trabajo SERP tiene éxito?
No. BotBrowser proporciona el entorno de ejecución del navegador y resultados visibles de página para una comparación controlada. La programación del trabajo, la calidad de la red, las respuestas de terceros y las decisiones sobre autorización quedan fuera de ese límite de capacidad.
Conclusión práctica
Antes de elegir un entorno de navegador para scraping SERP a escala, traduce la carga de trabajo en páginas por hora y una latencia de preparación definida. Ejecuta un plan repetible con un accesorio propio o un objetivo/API explícitamente autorizado en dos niveles de concurrencia; registra por separado el inicio, la inicialización del proxy, la navegación y la espera de página. Mantén distintas las variables del navegador y de la red, y usa la comparación para identificar qué recurso necesita atención. La siguiente acción es definir el accesorio permitido y la condición de preparación; ninguna cifra genérica de navegadores puede reemplazar esa línea de base. No es una guía para recopilar SERP en vivo, seleccionar elementos de página, implementar lógica de rastreo ni eludir CAPTCHA, límites de velocidad o controles de acceso.
Fuentes
Este artículo forma parte de la guía: Despliegue y versión del navegador: mapa operativo
Artículos Relacionados
Rendimiento del navegador: optimización a escala
DesplieguePerfiles de navegador para monitoreo SEO y seguimiento SERP
DesplieguePlanificación de capacidad de BrowserContext
DespliegueLímites de recursos para contenedores: método práctico
DespliegueEscalar contextos con perfiles Per-Context
DespliegueScraping de bolsas de empleo: límites del navegador
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.