Rendimiento del navegador: optimización a escala
Consejos prácticos para optimizar memoria, CPU, rendimiento de red y densidad de instancias al ejecutar automatización del navegador a escala.
BotBrowser Team
Prefieres la documentación del producto mantenida?
Este artículo tiene una página equivalente en el centro de documentación. Usa los docs para el flujo canónico, las flags actuales y la referencia duradera.
Cuando los trabajos del navegador se ralentizan al aumentar la concurrencia, la pregunta útil es qué recurso o cola limita esa carga. BotBrowser ofrece aislamiento de perfiles y controles de carga, pero no garantiza un número universal de instancias por host; mide juntas las páginas, la ruta y la máquina objetivo antes de cambiar la capacidad.
Resumen
- Mide trabajos representativos en frío y en caliente antes de fijar el límite de workers.
- Identifica el recurso limitado y define reglas explícitas de admisión y recuperación para una cola acotada.
- Cambia un coste cada vez y decide si aceptas o reviertes con la misma carga y el mismo objetivo de servicio.
Contenido de esta guía
- Mide primero la carga de trabajo
- Protege el presupuesto con contrapresión
- Ajusta un coste cada vez
- Acepta versiones con evidencia de recuperación
- Dónde encaja BotBrowser
- Conclusión práctica
Mide primero la carga de trabajo
Una carga de automatización de navegador consume memoria, tiempo de CPU, almacenamiento y capacidad de red en proporciones que dependen de las páginas y del trabajo que se realiza en ellas. Una navegación corta de solo texto se comporta de forma muy distinta a una sesión larga con medios, capturas de pantalla, descargas o varios pasos de aplicación. Por eso la planificación de capacidad parte de la mezcla real de trabajos y no de un número fijo de instancias. BotBrowser puede ejecutar perfiles aislados en paralelo en un entorno de prueba controlado para medir tu propia mezcla de trabajos; no puede garantizar el mismo rendimiento en otras compilaciones, plataformas o hardware.
La capacidad en producción depende de las páginas, el modo del navegador, la duración de la sesión, la ruta de red, la versión, el backend gráfico, el paquete de perfil, el host y la concurrencia que use la aplicación. Mide esos factores juntos antes de cambiar la configuración de memoria, CPU, red o ciclo de vida. El objetivo es completar las tareas de forma estable con una protección de privacidad coherente, no alcanzar el mayor número posible de workers.
El rendimiento también es una cuestión de fiabilidad. Quedarse sin memoria puede detener un navegador a mitad de una operación y dejar resultados incompletos y un estado de sesión dañado. Una CPU saturada ralentiza todas las instancias, lo que alarga la carga de páginas y aumenta los fallos por tiempo de espera. Los procesos de navegador huérfanos agotan poco a poco el host. Un host sin margen de memoria puede convertir la salida de un solo navegador en una interrupción más amplia del servicio, así que reserva capacidad para la variación normal de la carga y para los arranques simultáneos.
Construye una referencia de capacidad
Elige un conjunto pequeño de trabajos que refleje la producción. Incluye una página rápida, una más pesada, la sesión normal más larga y cualquier flujo que capture medios o descargue archivos. Ejecuta el mismo conjunto en la clase de host de destino, con la versión de BotBrowser, la familia de perfiles, la política de rutas y el modo de navegador previstos.
Registra los trabajos completados, los fallidos, la espera en cola, la duración total, la duración del arranque, la presión de memoria, la saturación de CPU, la actividad de almacenamiento y el rendimiento de red. Usa percentiles para la latencia en lugar de un único promedio. Los promedios pueden ocultar los trabajos lentos que determinan el comportamiento de los tiempos de espera y de la cola.
Mide por separado un arranque en frío y una ejecución en caliente. El resultado en frío representa la sustitución de un host y la recuperación de un despliegue. El resultado en caliente representa el servicio estable. Ambos importan, pero mezclarlos en una sola cifra dificulta interpretar la comparación entre versiones.
Conserva una referencia escrita para cada clase de carga. El registro debe identificar la clase de host, el par de versiones, la familia de perfiles, el conjunto de páginas, la región de la ruta, el modo de navegador, la ventana de prueba y el resultado. No debe contener contenido de páginas, credenciales ni datos de navegación personales.
Define un presupuesto de recursos
Reserva capacidad para el sistema operativo, la monitorización, la actividad de despliegue y el arranque simultáneo. Lo que queda es el presupuesto para la carga del navegador. Trata la memoria, la CPU, el almacenamiento y la red como límites independientes, porque un trabajo puede agotar uno mientras los demás siguen pareciendo sanos.
La planificación de memoria debe basarse en el pico observado y en la tendencia sostenida de RSS. La de CPU debe considerar tanto la saturación como la latencia de las tareas. La de almacenamiento debe incluir el acceso a perfiles, las descargas, los artefactos temporales y los registros. La de red debe incluir la ruta aprobada además de las páginas de destino.
El presupuesto también necesita un margen para fallos. Un worker que reintenta de inmediato tras un tiempo de espera agotado puede generar más presión que la tarea original. Incluye los reintentos normales y la actividad de recuperación en las mediciones de staging antes de aprobar un techo de producción.
Asocia cada síntoma con el contador que lo explica
Un síntoma indica dónde mirar, no qué cambiar. La tabla empareja una observación habitual con el contador que la resuelve, para que la revisión de capacidad parta de datos medidos y no de una suposición sobre el host.
| Síntoma | Contador que se lee | Decisión |
|---|---|---|
| La espera en cola crece y la CPU sigue plana | p95_queue_wait frente a completion_latency | El límite es la política de admisión; añade cupos por clase solo cuando baje la espera |
| La memoria residente sube y la CPU está baja | rss_per_context en los contextos abiertos | Cierra contextos ociosos o reduce el peso de página; el host está limitado por memoria |
| La CPU se acerca al techo del host | cpu_saturation con error_rate_after_retry | Baja la concurrencia o pasa las sesiones cortas a una compilación recortada |
| El p95 de página sube con el rendimiento plano | p95_page_time por ruta con error_rate_after_retry | Una dependencia o ruta lenta; aísla la URL antes de añadir hosts |
error_rate_after_retry sube con queue_depth | Reintentos por tarea completada | La contrapresión devuelve capacidad antes de cerrar la limpieza; aplaza el reintento |
Lee la fila que coincide con el incidente antes de abrir una revisión de capacidad. Comprar un host por la fila equivocada oculta el límite real y añade coste sin restaurar el objetivo de servicio.
Ordénate la investigación de un incidente
Escribe el orden como política para que dos operadores lleguen a la misma respuesta:
- Congela las nuevas admisiones para que la muestra deje de moverse mientras se lee.
- Compara
rss_per_contexten la concurrencia que falla con el mismo valor en la última concurrencia aceptada. Un valor plano con la memoria libre del host por debajo de un cuarto de la nominal apunta al host. - Compara
p95_queue_waitconcompletion_latency. Una espera en cola mayor que la latencia de finalización con la CPU bajo la mitad de la nominal apunta a la política de admisión. - Compara
launch_durationen los dos niveles de concurrencia. Un arranque que crece con las lecturas paralelas de perfiles apunta al almacenamiento de perfiles.
Este orden descarta un problema del host solo cuando los pasos 2 y 4 salen planos y el paso 3 muestra la espera dentro de la cola. Cambia primero la fila que cruza la línea de la política; cambiar dos a la vez deja el incidente sin responsable. Trata un cuarto y la mitad como la política operativa de este despliegue, no como un hecho universal sobre navegadores.
Protege el presupuesto con contrapresión
Coloca una cola acotada delante del trabajo del navegador. Admite un trabajo nuevo solo cuando el despliegue tenga capacidad para su clase de carga. Cuando la cola alcance su límite, rechaza, aplaza o redirige el trabajo según la política del servicio. No permitas que los llamadores creen trabajo de navegador sin límite directamente.
Usa colas separadas cuando las cargas tengan costes u objetivos de servicio muy distintos. Un trabajo largo con medios no debe consumir todos los huecos que necesitan las comprobaciones cortas de la aplicación. La planificación equitativa y los límites por clase hacen que el servicio sea más fácil de operar que un único número global de concurrencia.
Define explícitamente quién es dueño de la cola. El planificador debe distinguir el trabajo en espera, activo, completado, cancelado e incierto para que la recuperación no duplique una tarea en silencio. Aplica límites de reintentos y reintentos diferidos en la propia cola, y devuelve capacidad solo cuando la sesión anterior se haya cerrado correctamente.
La contrapresión debe responder a evidencia sostenida, no a una sola muestra ruidosa. La espera en cola, la latencia de las tareas, las salidas del navegador, el margen del host y la finalización de la limpieza ofrecen una vista combinada útil. Usa queue depth junto con esos indicadores; reduce las admisiones cuando varios salgan del rango aprobado y restablécelas poco a poco tras la recuperación.
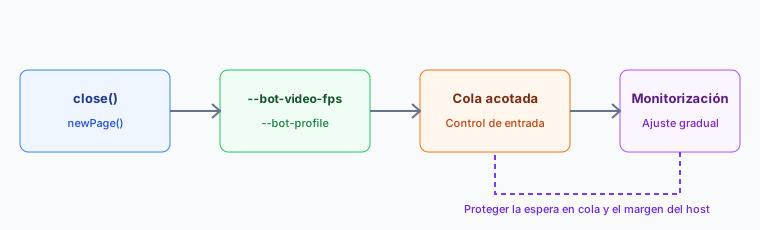
Revisa el presupuesto cuando cambie la versión del navegador, la imagen del host, la familia de perfiles, la ruta o la carga de trabajo. Un techo anterior es una observación histórica, no un derecho a obtener el mismo rendimiento. Repetir la referencia mantiene las decisiones operativas ligadas a evidencia actual.
Una carga que pasa con 20 contextos y falla con 40
El mismo host, las mismas páginas y la misma familia de perfiles pueden pasar una revisión de capacidad con 20 contextos y fallarla con 40. El fallo tiene tres causas habituales y cada una deja un contador distinto.
- Memoria del host.
rss_per_contextse mantiene plano, pero la memoria residente total cruza la memoria libre del host, el núcleo reclama páginas y los contextos más lentos se atascan. La decisión es menos contextos por host o un host mayor. - Tiempo de carga del perfil.
launch_durationcrece con la concurrencia porque cada contexto lee su perfil al arrancar. El almacenamiento local y un conjunto de perfiles más pequeño acortan el arranque; el host no es el límite. - Política de admisión.
p95_queue_waitcrece con la CPU muy por debajo del techo y la memoria estable. La cola admite trabajo más rápido de lo que la limpieza devuelve capacidad, así que separa las clases o aplaza el reintento.
Ejecuta el caso de 40 contextos una vez con las admisiones congeladas tras el primer atasco. Si rss_per_context y launch_duration coinciden con la ejecución de 20 contextos, el host no es la causa y la cola tiene la solución. Si divergen, corrige el recurso antes de ajustar la admisión, porque un cambio de política no recupera memoria que ya se perdió.
Registra la causa elegida, los dos niveles de concurrencia y rss_per_context, launch_duration y p95_queue_wait en el registro de decisión de capacidad de la carga, para que la siguiente revisión parta de esta comparación y no de una página en blanco.
Ajusta un coste cada vez
Valida una optimización cada vez en una carga de staging controlada. Compara la finalización de tareas, el estado de salida del navegador, la tendencia de memoria, la latencia de creación de páginas, la finalización de capturas y el cierre de contextos con la configuración de versión sin cambios. Mantén constantes la familia de perfiles, la ruta de red, el backend gráfico y el conjunto de páginas durante la comparación.
Memoria y ciclo de vida de las páginas
Trata los límites del heap como controles específicos de cada carga. Un límite bajo puede terminar trabajo legítimo de JavaScript, mientras que uno excesivo puede eliminar el margen del host. Mide el heap retenido durante el flujo representativo y cambia los límites solo con el responsable de la aplicación y un plan de reversión.
Cierra las páginas sin demora para que el navegador libere los recursos de los trabajos terminados. Llamar a page.close() da al navegador un límite claro de ciclo de vida, mientras que navegar a otra URL no pone fin a la propiedad de la página. Cierra también el propio navegador en todas las rutas de salida y usa el supervisor del despliegue para identificar un worker que no responde.
const page = await context.newPage();
try {
  await page.goto('https://example.com', { waitUntil: 'domcontentloaded' });
  // Lee aquí los datos que necesita el flujo.
} finally {
  await page.close();
}
Prefiere domcontentloaded frente a esperar a que la red quede inactiva cuando el flujo solo necesita el documento. La detección de inactividad puede añadir segundos en páginas pesadas, y el DOM está listo mucho antes. Deriva los tiempos de espera de navegación y de operación del objetivo de servicio aprobado y de la distribución de latencia observada, y trata un tiempo agotado como un fallo explícito con diagnósticos suficientes para distinguir el retraso de la página de la presión de recursos.
Recicla las instancias del navegador a partir de evidencia del ciclo de vida. Introduce un límite por tareas o por tiempo solo cuando las tendencias de staging y producción muestren que mejora la estabilidad, mantenlo configurable y revísalo después de cada cambio de versión. Reutiliza una página solo mientras represente la misma sesión y el mismo plan de identidad, y crea un contexto nuevo cuando deba separarse el almacenamiento o el estado del perfil.
Registra en los registros de la aplicación la finalización del arranque, el estado de salida, stderr, la duración de las tareas, la espera en cola y el cierre de contextos, y vigila la memoria del host con las herramientas estándar del sistema operativo. Define alertas a partir de la capacidad medida del host y del objetivo de servicio, y observa las tendencias en lugar de esperar al agotamiento.
CPU y cadencia de vídeo
Conserva las funciones del navegador que necesita la aplicación. Desactivar comportamiento en segundo plano, extensiones, medios o servicios de actualización puede cambiar el comportamiento de las páginas y la seguridad operativa. Empieza con la configuración documentada de la versión y elimina una función solo cuando un QA representativo confirme que el flujo no depende de ella.
Limita la concurrencia a partir de la saturación de CPU medida. Aumenta los workers poco a poco mientras sigues el trabajo completado, los errores del navegador, el tiempo en cola y el margen del host. Las cargas de capturas, medios, JavaScript complejo y Canvas necesitan techos distintos, por lo que una proporción universal de instancias por núcleo no es fiable.
Reduce la cadencia de vídeo cuando no necesites la reproducción visual completa. Las páginas con mucho vídeo pueden mantener activo el trabajo de decodificación y renderizado aunque la automatización solo necesite actualizaciones visuales ocasionales. En perfiles con Video FPS Control activado, --bot-video-fps fija la cadencia real del vídeo por separado de los FPS de medios que las páginas ven informados.
chromium-browser \
  --bot-profile="profiles/profile.enc" \
  --bot-video-fps=1:30 \
  --headless
Úsalo en monitorización con mucho vídeo, QA o páginas de larga duración donde los píxeles del vídeo fotograma a fotograma no formen parte del resultado. Consulta Video FPS Control para la sintaxis y el benchmark para la carga probada. Las reducciones de CPU del benchmark son rangos de referencia para una carga de vídeo concreta, no compromisos de capacidad ni límites de aprobado o suspenso.
Separa las clases de carga en lugar de usar un único valor global para todas las páginas. Las páginas que reproducen vídeo como contenido principal suelen necesitar la cadencia normal, mientras que las que mantienen elementos de vídeo en segundo plano a menudo no. Mide la CPU antes y después del cambio en el mismo host, con el mismo conjunto de páginas y la misma concurrencia, y usa una ventana de muestra lo bastante larga para incluir la reproducción estable y no solo el arranque de la página.
Comprueba también el tipo de salida que importa para el flujo. La extracción del DOM, la captura de API, las capturas de pantalla y las comprobaciones de píxeles de medios toleran de forma distinta una cadencia visual menor, y la salida de píxeles sigue la cadencia real. Mantén el ajuste junto al perfil de lanzamiento o la definición del trabajo para que el siguiente operador sepa qué trabajos usan una cadencia de medios menor, y mantenlo separado de los controles de FPS de pantalla.
Red y almacenamiento
Bloquear medios innecesarios puede reducir el trabajo de red y de renderizado. Conserva los recursos que la aplicación necesita para el diseño, la interacción, la autenticación y la validación de privacidad, y prueba cada regla de bloqueo con páginas representativas. Mantén las hojas de estilo y las fuentes cuando importe el renderizado del texto.
Cuando el ancho de banda de la ruta es limitado, el enrutamiento selectivo puede mantener ciertas rutas de petición fuera del proxy. Consulta Proxy Selective Routing para la sintaxis de las reglas y la licencia que exige. Las peticiones que coinciden se conectan directamente, así que decide qué recursos pueden salir de la ruta del proxy según la política de red aprobada, y repite la validación de la ruta cada vez que cambien las credenciales, la región o la salida.
Un proxy añade latencia de red a cada petición que transporta. Mantén la ruta estable durante un benchmark y compara p95 request latency antes de cambiar la región de salida.
Guarda los paquetes de perfil en almacenamiento local rápido en lugar de volúmenes montados en red. La carga del perfil ocurre una vez al arrancar, y su coste relativo depende de todo el flujo de lanzamiento. En despliegues que reinician instancias con frecuencia, el almacenamiento local puede reducir el retraso de red en la ruta de arranque.
Gráficos y hosts headless
Más capacidad aporta margen útil, pero no corrige colas sin límite, un cierre incompleto ni un backend gráfico inadecuado. Mide la carga antes de añadir hosts y añade capacidad cuando una carga sostenida deje de cumplir el objetivo de servicio después de verificar la cola y el cierre.
El modo headless puede reducir parte del trabajo del sistema de ventanas, pero la página sigue usando recursos visuales, de red, de JavaScript y de almacenamiento, así que trata la diferencia como específica de cada carga. Mantén activo el soporte gráfico, porque eliminarlo puede cambiar las capacidades de renderizado de las cargas que dependen de WebGL o WebGPU.
Usa la guía Linux GPU Backend cuando el despliegue se ejecute sin pantalla física. En Linux, mantén el mismo backend gráfico seleccionado en los workers comparables. Un cambio que elimina una capacidad necesaria del navegador no es una mejora válida de rendimiento.
Acepta versiones con evidencia de recuperación
Compara fases operativas representativas
Una versión candidata debe medirse frente a la referencia aprobada con las mismas clases de carga y la misma imagen de host. Mantén separados el arranque en frío, el trabajo estable en caliente y el apagado controlado. El arranque en frío muestra si los workers nuevos pueden entrar en servicio de forma predecible. La fase estable muestra si la espera en cola y el uso de recursos se mantienen estables una vez asentadas las cachés y las conexiones. El apagado muestra si la capacidad vuelve tras el trabajo completado, cancelado y fallido. Compara p95 queue delay con la latencia de finalización para detectar esperas de admisión crecientes.
Ejecuta cada fase el tiempo suficiente para exponer la variación normal de la respuesta de las páginas y de la latencia de la ruta. Compara las distribuciones del tiempo de finalización y de la espera en cola junto con la presión sostenida de memoria, la contención de CPU, la actividad de almacenamiento y el uso de red. Una ejecución corta y correcta sirve para comprobar la compatibilidad básica, pero no basta para aprobar un presupuesto de recursos de producción.
Documenta la mezcla de cargas usada para la decisión. Incluye trabajos ordinarios, la sesión más larga admitida y un caso de fallo autorizado. Así el registro de aceptación sigue siendo útil cuando cambien más adelante la aplicación, la ruta, la imagen del host o la versión del navegador.
Aplica criterios de aceptación explícitos
La aceptación de una versión debe responder si el servicio completa el trabajo requerido y conserva el margen operativo. Revisa juntos la finalización correcta, el tratamiento esperado de errores, el crecimiento de la cola, la finalización de la limpieza y el tiempo de recuperación. Una versión no debe aprobarse solo porque mejoren sus trabajos más rápidos mientras los más pesados se vuelven menos fiables.
Usa el objetivo de servicio existente como límite de decisión. Si no hay un objetivo formal, establece uno a partir de la versión aprobada actual antes de comparar una candidata. Registra cualquier compromiso deliberado, como un pequeño aumento de latencia a cambio de menor presión sostenida de memoria, y obtén la aprobación del responsable de la aplicación. Incluye el SLO y la ventana de medición en el registro de aceptación.
Mantén las comprobaciones de privacidad y funcionales en el mismo plan de aceptación. Un cambio que ahorra recursos pero elimina el renderizado, el almacenamiento, los medios o el comportamiento de red necesarios es una regresión aunque baje el uso del host. La evidencia de rendimiento respalda una versión solo cuando el flujo representativo sigue produciendo el resultado autorizado.
Ejercita la contrapresión y la recuperación
Las pruebas de aceptación deben incluir un periodo en el que las llegadas superen la capacidad de servicio disponible. Confirma que la cola acotada aplica la política de admisión prevista, protege el trabajo ya en curso y vuelve a su rango normal cuando baja la demanda. Observa si los reintentos se retrasan según la política en lugar de añadir presión de inmediato.
Prueba también una interrupción controlada de un worker. El supervisor debe identificar el worker no disponible, conservar un resultado claro de la tarea y admitir trabajo de reemplazo solo cuando haya capacidad. El trabajo completado no debe repetirse en silencio, y el trabajo incierto debe seguir la política de conciliación de la aplicación.
Tras la interrupción, verifica que la memoria, la actividad de almacenamiento, la espera en cola y la latencia de finalización vuelven al rango operativo aprobado. Un servicio que vuelve a aceptar trabajos mientras la limpieza sigue incompleta no se ha recuperado del todo. Mantén reducida la admisión hasta que la evidencia muestre que tanto el flujo de tareas como el margen del host son estables; incluye queue depth en la observación de recuperación.
Conserva evidencias para la reversión
Todo cambio de rendimiento necesita una condición de reversión y un responsable. La condición puede ser un crecimiento sostenido de la cola, una menor fiabilidad de finalización, una limpieza incompleta o la pérdida de margen de recuperación. Defínela antes del despliegue para que la decisión no dependa de una interpretación improvisada durante un incidente.
Conserva el identificador de versión, la imagen del host, el manifiesto de carga, la clase de ruta, el registro de configuración, la ventana de observación y los resultados resumidos tanto de la candidata como de la referencia aprobada. Mantén emparejados los valores release_id de la candidata y de la referencia con sus ventanas de observación. Guarda los registros según la política de retención y acceso de la organización, y elimina credenciales, contenido de páginas y datos personales del registro.
Durante un despliegue por etapas, amplía solo cuando la etapa anterior cumpla los criterios de aceptación durante una ventana de observación adecuada. Si aparece una condición de reversión, detén nuevas ampliaciones, reduce las admisiones, completa o concilia el trabajo aceptado y restaura la última configuración aprobada. Repite la referencia representativa tras la reversión para confirmar que la recuperación es completa, en lugar de suponer que cambiar de versión bastó.
Dónde encaja BotBrowser
Para sesiones con mucho vídeo, BotBrowser soporta --bot-video-fps (ENT Tier2, en perfiles con Video FPS Control activado), que reduce la cadencia real de decodificación y renderizado del vídeo mientras el valor de FPS de medios informado se configura por separado. Cuando no hace falta la cadencia visual completa, esto puede reducir la CPU, así que conviene probarlo como un cambio controlado dentro del plan anterior. BotBrowser no puede garantizar un ahorro de CPU ni una cifra de capacidad para todas las cargas, no sustituye las referencias de capacidad, las colas, la contrapresión ni el cierre ordenado que corresponden al operador, y no puede conservar la salida de píxeles fotograma a fotograma cuando se reduce la cadencia real. Sube el valor real cuando un flujo muestree píxeles de vídeo.
En despliegues que evalúen flujos por contexto, Per-Context Fingerprint (ENT Tier3) es una opción que depende de la licencia y que conviene medir con la misma carga autorizada y los mismos requisitos de privacidad que la topología actual. Trata el resultado como evidencia específica de la carga, no como un compromiso general de capacidad. BotBrowser no fija la capacidad del host, la política de colas, el rendimiento del proxy ni el comportamiento de las páginas, así que esas decisiones siguen siendo del responsable de la aplicación.
Descarga BotBrowser para preparar un despliegue o contacta con nuestro equipo enterprise para planificar la infraestructura. Consulta Configuración de servidor headless, Guía de despliegue con Docker, CLI Recipes y Buenas prácticas para capturas de pantalla para los detalles de implementación.
Cuando una página debe elegir sugerencias de cola además de capacidad del host, las prioridades de scheduler.postTask aportan el registro de cancelación y alternativa que mantiene explícito ese límite.
Fuentes públicas
- BotBrowser FPS Control
- Benchmark de BotBrowser
- BotBrowser Proxy Selective Routing
- BotBrowser Linux GPU Backend
- API Page de Playwright
Conclusión práctica
Empieza con una referencia que incluya espera en cola, latencia de finalización, presión de recursos y limpieza. Define la admisión limitada a partir de esos datos, cambia un solo coste cada vez y conserva la configuración anterior hasta que los mismos trabajos representativos cumplan el objetivo de servicio después del despliegue.
Este artículo forma parte de la guía: Despliegue y versión del navegador: mapa operativo
Artículos Relacionados
Planificación de capacidad de BrowserContext
DespliegueEscalar contextos con perfiles Per-Context
DespliegueLímites de recursos para contenedores: método práctico
DespliegueMemoria de BrowserContext en Chromium 151: caso de versión
DespliegueBotBrowser Trimmed en Linux x64: rendimiento medido
DespliegueDespliegue y versión del navegador: mapa operativo
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.