Conmutación de proxy y continuidad visible para el usuario
Separa los fallos del tramo del proxy de los del destino, planifica rutas aprobadas en orden con reintentos acotados y registra un cambio de ruta como una asignación nueva.
Quieres la documentación estructurada de Red?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Por qué una ruta caída no es una sesión continua
Una sesión del navegador que pasa por un proxy depende de dos elementos que pueden fallar de forma independiente: la ruta hasta el proxy y el destino que hay detrás. Cuando falla la ruta, quien opera la web necesita tres respuestas. ¿Qué puede seguir viendo el usuario? ¿Qué se puede repetir sin riesgo? ¿Un cambio a otra ruta aprobada sigue contando como la misma sesión? La respuesta breve es que una conmutación puede restablecer el servicio, pero no hace que la página, sus solicitudes en curso o su estado de aplicación continúen sin cambios, y un cambio de ruta de salida es una asignación de red nueva que debe quedar en el registro.
Los navegadores ya incluyen un comportamiento estándar de respaldo. Un archivo de configuración automática de proxy puede devolver una lista ordenada de rutas, y el navegador prueba la siguiente entrada tras un fallo de conexión. La guía de MDN sobre archivos PAC describe el formato de la lista, y la documentación de proxy de Chromium describe cómo se evalúa. Ese comportamiento decide adónde va la siguiente conexión. No dice nada sobre si sobrevive la página que se estaba cargando, el formulario enviado a medias o el contenido multimedia que se estaba reproduciendo. Mantener separadas esas dos preguntas es el núcleo de un buen plan de conmutación.
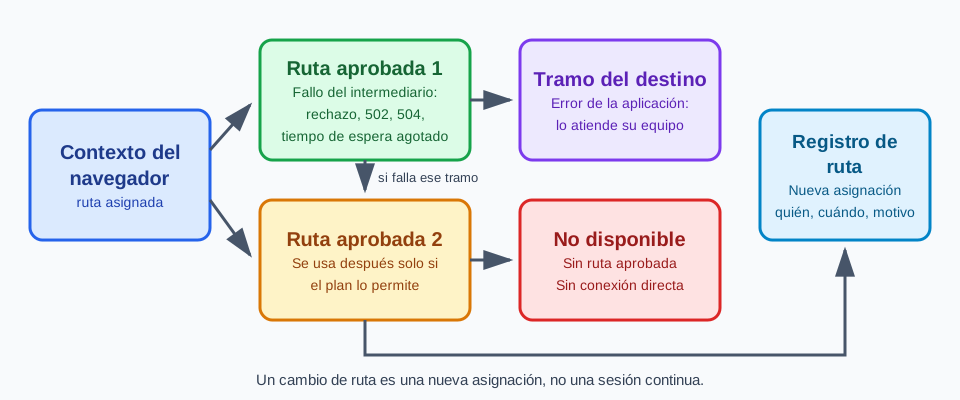
Tres términos mantienen la precisión del resto de la explicación. Una ruta es el camino aprobado que usa un contexto del navegador para llegar a los destinos, incluidos el punto de acceso del proxy y la cuenta que hay detrás. Una categoría de fallo indica qué parte del camino falló y quién se encarga de la siguiente acción. Una declaración de continuidad describe lo que vive el usuario después: la página se completa, un reintento acotado tiene éxito, aparece un estado no disponible claramente señalado o una asignación de ruta nueva inicia un recorrido nuevo. Proxy por contexto explica la propiedad de la ruta a nivel de contexto. La conmutación empieza cuando esa asignación ya existe y plantea qué ocurre cuando la ruta asignada deja de funcionar.
El alcance aquí es el trabajo autorizado sobre rutas aprobadas. Un fallo nunca autoriza una conexión directa silenciosa ni una ruta no aprobada, y nada de lo que aquí se explica consiste en rotar proveedores para ocultar actividad ni en evitar las decisiones de acceso de un destino. El objetivo es un comportamiento predecible para el usuario y un registro exacto para quien opera.
Separar los fallos del tramo del proxy de los fallos del destino
Una solicitud que pasa por un proxy HTTP cruza al menos dos tramos: del cliente al proxy y del proxy al destino. RFC 9110 define los códigos de estado que informan de problemas en el segundo tramo cuando interviene un proxy o una pasarela. Un 502 Bad Gateway significa que el proxy recibió una respuesta no válida del servidor al que se conectó, y un 504 Gateway Timeout significa que no recibió a tiempo una respuesta de ese servidor. La referencia de MDN sobre 502 explica ese mismo papel de pasarela. Estos códigos los emite el proxy y describen su lado ascendente. No son errores de aplicación del propio destino.
Los fallos anteriores a que se complete el tramo del proxy son distintos. Una conexión rechazada al punto de acceso del proxy, una consulta DNS fallida para el nombre del proxy o una espera agotada al conectar ocurren antes de que ninguna solicitud llegue a un destino. En HTTPS, el navegador pide primero al proxy que abra un túnel con el método CONNECT, y solo inicia la conversación TLS con el destino después de que el proxy responda con un estado de éxito. Un proxy que rechaza el túnel, responde 407 Proxy Authentication Required o responde con un estado de pasarela en esa fase ha fallado en su tramo aunque nunca se haya contactado con el destino. La guía de MDN sobre servidores proxy y túneles describe ese túnel.
Los fallos del destino son una categoría aparte. Una vez abierto el túnel, un error de aplicación, un error de certificado o un rechazo a nivel de aplicación pertenecen al destino y a su responsable. Un 503 puede venir de cualquiera de los dos lados, así que averigua quién lo envió antes de asignarlo. Reintentar un error del destino por otra ruta rara vez ayuda y puede repetir una acción que el destino ya procesó. Una buena categoría de incidente nombra el tramo, el estado o error observado y el responsable: el soporte del proveedor para los fallos del tramo del proxy y el responsable de la aplicación para los fallos del destino.
Para cada categoría, escribe de antemano el resultado que ve el usuario. Cuando se rechaza la apertura del túnel, la página no carga y el usuario ve un error de conexión o el estado no disponible de la aplicación. Cuando una navegación recibe un 502 o un 504 del proxy, el usuario ve un documento de error y un intento posterior puede tener éxito. Cuando un subrecurso agota la espera, la página se muestra a medias, con imágenes ausentes o una función que no arranca. Cuando el destino devuelve un error de aplicación, el usuario ve el mensaje propio de la aplicación. Nombrar estos resultados permite que el soporte explique lo ocurrido sin inspeccionar tráfico.
El respaldo a nivel de navegador reacciona a un conjunto estrecho de eventos. La documentación de Chromium indica que, en general, solo los fallos a nivel de conexión pueden activar el respaldo de proxy, como no resolver el nombre DNS del proxy o no conseguir conectar un socket con él, y que los fallos al establecer un túnel CONNECT dejaron de tratarse como desencadenantes a partir de la versión 67. Por tanto, un proxy que responde 502 no hace que el navegador pruebe por sí solo la siguiente entrada de la lista. Quien espera que se use la siguiente ruta tras un error de pasarela confía en un comportamiento que el navegador no ofrece.
La misma documentación señala que el respaldo no tiene opciones de configuración y que un proxy marcado como defectuoso pasa al final de la lista durante un periodo en lugar de eliminarse. Por eso el orden de los intentos puede diferir del orden escrito. Anota el orden que observes en un ensayo en lugar de dar por bueno el escrito.
Qué puede seguir viendo el usuario y qué puede repetirse sin riesgo
Cuando una ruta falla a mitad de un recorrido, tres cosas son ciertas sobre la página que tiene delante el usuario. El contenido que ya se mostró sigue en pantalla, porque vive en la página y no en la ruta. Las solicitudes en curso terminan en un error o en una espera agotada, y la página decide cómo presentarlo. Las solicitudes aún no enviadas usan la ruta que esté vigente cuando empiecen. Por eso una conmutación produce una página en parte antigua y en parte nueva, y la aplicación debe dejar claro en qué partes confía.
El contenido mostrado no prueba que algo se completó. Un formulario que sigue visible tras una espera agotada puede haberse recibido o no, y un indicador de carga que nunca termina no dice nada al usuario. Da a cada paso del recorrido una señal de finalización que vean tanto el usuario como quien opera, como un mensaje de confirmación, un identificador de solicitud devuelto por el servidor o un cambio de estado en una página de estado. Sin esa señal, lo más seguro tras una espera agotada en una solicitud que cambia estado es suponer que su resultado se desconoce.
La idempotencia decide qué se puede repetir. La entrada del glosario de MDN define un método idempotente como aquel en el que hacer la misma solicitud una vez o varias veces tiene el mismo efecto previsto en el servidor. RFC 9110 clasifica como idempotentes PUT, DELETE y los métodos seguros como GET y HEAD, mientras que POST no lo es. Permite que un cliente reintente automáticamente una solicitud idempotente tras un fallo de conexión, antes de leer la respuesta. También dice que un cliente no debería reintentar automáticamente una solicitud no idempotente salvo que tenga alguna forma de saber que su semántica es en realidad idempotente, o alguna forma de detectar que la solicitud original nunca se aplicó.
Esas definiciones describen un contrato del método y no lo que hace una aplicación concreta. Un punto de acceso GET que cambia estado rompe el contrato, y un POST que lleva una clave verificada por el servidor puede ser seguro de repetir. Marca cada operación del recorrido como repetible, repetible solo con una clave verificada por el servidor, o no repetible sin confirmación del usuario. Un navegador no puede saber por una espera agotada si una acción no idempotente ya surtió efecto, así que el reintento de un pago, un mensaje o un cambio de cuenta debe preguntar al usuario o consultar antes el estado.
Idempotente no significa gratis. Repetir una lectura por otra ruta puede devolver otra versión regional de la página, otra copia en caché u otro estado de límite de frecuencia, y el destino puede contar la repetición como carga adicional. Mantén las repeticiones pocas y acotadas, como se describe en la sección siguiente, y no hagas silenciosa una repetición cuando la diferencia importaría al usuario.
La autenticación requiere la misma atención. Una cookie de sesión que fija el destino pertenece al contexto del navegador y no a la ruta, así que normalmente permanece tras un cambio de ruta. Aun así, un destino puede pedir al usuario que confirme un inicio de sesión después de que cambie la ubicación de red. Trata esa confirmación como un resultado normal y no diseñes el recorrido suponiendo que no ocurrirá. Mantén las credenciales del proxy fuera de los registros de fallos; autenticación de proxy en el navegador e higiene de credenciales explica cómo tratarlas.
Planificar rutas en orden y un presupuesto de reintentos acotado
Un plan de conmutación es un documento breve con cuatro partes: la lista ordenada de rutas aprobadas, las categorías de fallo que permiten pasar a la siguiente ruta, el presupuesto de reintentos de cada ruta y el estado final cuando se agota la lista. Escríbelo antes de un incidente y consérvalo con el responsable de la ruta, porque el contacto del proveedor, el responsable de red y el responsable de la aplicación guardan cada uno una parte.
Incluye solo rutas aprobadas para la carga de trabajo, la región y la categoría de destino, en el orden en que deben probarse. Una segunda ruta necesita la misma aprobación que la primera, incluidas la autorización del destino y el tratamiento de datos. Una ruta que resulta estar al alcance no es una alternativa aprobada. Si un archivo PAC o una lista de proxies del navegador expresa el plan, lee la lista como su forma técnica: cada entrada es una ruta que el plan acepta. Una entrada directa en esa lista es la decisión de salir del límite del proxy. La documentación de Chromium indica además que, cuando no se puede descargar un archivo PAC, la resolución puede recurrir a la siguiente opción, a menudo una conexión directa silenciosa, salvo que el script esté marcado como obligatorio, así que comprueba qué hace tu configuración en ese caso.
Da a cada ruta un número pequeño y fijo de intentos y un límite de tiempo para todo el recorrido, y escribe ambos como valores de política que elige el equipo. Los valores corresponden al responsable de la aplicación, porque un documento que se lee, un paso de pago y una sincronización en segundo plano toleran esperas distintas. Espacia los intentos para que un proveedor que se recupera no reciba una ráfaga de solicitudes repetidas, y repite automáticamente solo las operaciones marcadas como repetibles. Las operaciones no repetibles pasan a la vía de confirmación del usuario descrita antes.
Decide de antemano qué fallos permiten un cambio. Pasar a la siguiente ruta es razonable cuando el fallo pertenece al tramo del proxy: el punto de acceso es inalcanzable, se rechaza el túnel o el proxy devuelve repetidamente estados de pasarela para destinos distintos. No es razonable cuando el fallo pertenece al destino. Tampoco lo es cuando el proxy rechaza las credenciales, ya que un 407 apunta a un problema de cuenta que otra ruta no arreglará y que debe resolver el proveedor. La decisión de acceso de un destino es una decisión y no un fallo que haya que sortear por otra ruta, y cambiar de ruta como respuesta queda fuera del uso aprobado.
Muestra al usuario un avance honesto mientras se ejecuta el plan. Un mensaje como reconectando es exacto mientras queden intentos, y un mensaje de no disponible es exacto cuando se agota el presupuesto. Un bucle sin final no da al usuario ni lo uno ni lo otro. Si varios contextos del navegador comparten una ruta, un fallo llega a cada uno de ellos, así que aplica el plan por contexto y lleva también el registro por contexto.
Cambios de ruta y estados no disponibles
Un cambio de ruta modifica la salida que ve el destino. Es una asignación de ruta nueva y no la continuación de la anterior. Regístralo con el identificador del contexto, el nombre de la ruta anterior, el nombre de la ruta nueva, la hora, la categoría del desencadenante y quién lo aprobó. El destino observa un origen de red nuevo y puede tratar con razón las solicitudes posteriores como procedentes de otro lugar, así que todo lo que dependiera del origen anterior, como una página regional, un estado de límite de frecuencia o la confirmación de un inicio de sesión, debe considerarse posiblemente cambiado. Este registro permite que el soporte explique por qué el usuario vio un aviso nuevo y que una revisión de versión compare los recorridos antes y después de un cambio.
No presentes el resultado como una sola sesión continua. En informes y notas de soporte, etiqueta el segmento anterior al cambio y el posterior como asignaciones de ruta distintas dentro de un mismo contexto del navegador. Las cookies y el almacenamiento viven con el contexto, así que el estado de la aplicación puede permanecer mientras el origen de red cambió. Ambos hechos pertenecen al registro, porque la continuidad de los datos y la continuidad de la ruta son independientes. Una explicación para el usuario debe decir lo ocurrido en términos corrientes: la conexión se restableció por otra ruta aprobada y es posible que te pidan confirmar.
Las solicitudes que empezaron antes del cambio terminan por la ruta antigua o fallan, y las que empiezan después usan la ruta nueva, así que una página puede combinar respuestas de ambas. No envíes de nuevo una solicitud no idempotente solo porque cambió la ruta. Aplica las mismas reglas de antes: repite solo lo marcado como repetible y consulta el estado antes que nada.
Cuando no existe una ruta alternativa aprobada, el plan termina en un estado no disponible, y ese estado final es explícito. Indica que no se puede llegar al servicio, nombra lo que el usuario puede hacer a continuación, como volver a intentarlo más tarde o contactar con soporte, y deja una entrada de registro con la categoría del fallo y el responsable de la ruta. No termina en una conexión directa implícita, en un proveedor no aprobado ni en un bucle silencioso. Una página que carga por una conexión directa tras fallar el proxy puede parecer un éxito, pero cambió el límite de red sin una decisión, puede exponer al destino la dirección propia de la organización y rompe la premisa bajo la que se aprobó el recorrido.
Diseña con cuidado el estado no disponible. Conserva en local lo que el usuario escribió cuando la aplicación lo permita, desactiva los controles que repetirían una acción no repetible hasta confirmar el estado y enlaza a una página de estado cuando exista. Un texto que diga que no se pudo llegar al servicio por la ruta aprobada es más útil que un error genérico, porque indica al soporte con qué responsable contactar.
Volver a la ruta principal cuando se recupera es otro cambio de ruta, y se aplica el mismo registro. Evita cambiar de un lado a otro ante interrupciones breves. Mantén una ruta durante un recorrido y vuelve a evaluarla en un límite natural, como una tarea nueva o un contexto del navegador nuevo, para que cada segmento del registro tenga un inicio claro y un motivo claro.
Revisión operativa y encaje del producto
Ensaya cada categoría de fallo antes de confiar en el plan. Usa un destino que controles y una ruta de prueba que rechace conexiones, un proxy de prueba que devuelva un estado de pasarela y un punto de acceso de destino que devuelva un error de aplicación. Anota el resultado visible para el usuario de cada ensayo y el responsable que nombra el registro. No ensayes contra destinos de terceros de maneras que los sobrecarguen o que no esperarían.
Repite el ensayo tras un cambio de plan del proveedor, una migración de punto de acceso, un cambio de región, una actualización mayor del navegador o un cambio relevante en el destino. Mantén disponible el último plan aceptado mientras evalúas un candidato y compara el mismo recorrido en ambos. Los criterios de aceptación son el resultado para el usuario, el fallo acotado y el responsable de la recuperación, no una etiqueta de protocolo.
Varios equipos suelen compartir este plan. El proveedor responde de la disponibilidad de las rutas, el responsable de red califica las rutas y su orden, el responsable de la aplicación decide qué operaciones son repetibles y qué dice el estado no disponible, y el responsable del contexto aplica la ruta asignada y lleva el registro. Un traspaso breve entre esos responsables es una prueba más sólida que una sola línea de registro, y mantiene las credenciales y el tráfico detallado en los sistemas controlados que ya los protegen.
BotBrowser documenta la asignación de proxy por contexto y el cambio de proxy en tiempo de ejecución mediante un comando CDP para un contexto del navegador existente (ENT Tier3), donde las solicitudes en curso terminan por el proxy anterior y las nuevas usan el actualizado, de modo que quien opera puede aplicar un cambio de ruta controlado y registrado. BotBrowser no documenta una comprobación de estado ni una conmutación automáticas del proxy, no puede migrar las solicitudes en curso ni garantizar la continuidad de la página tras un cambio de ruta, y no puede reparar la ruta averiada de un proveedor.
En la práctica, trata el comando de cambio como el paso que autoriza el plan y no como un bucle de recuperación. La documentación de BotBrowser indica esperar a que cada comando termine antes de enviar otro cambio para el mismo contexto o de iniciar una navegación que dependa de la ruta nueva, y que el comando vuelve a detectar la dirección de salida, salvo que esta se proporcione con el comando, y actualiza la zona horaria, la configuración regional y el idioma de ese contexto. Anota esos cambios en el registro de ruta junto con la ruta nueva, porque forman parte de lo que ve el destino tras el cambio. Cambio dinámico de proxy describe el comando con más detalle, y semántica de proxy HTTP y solicitudes del navegador explica cómo usan los navegadores los túneles CONNECT y las respuestas del proxy.
Ejecuta las comprobaciones de conmutación
Aplica estas comprobaciones a un ensayo en un entorno de pruebas y anota si pasa o falla en cada una.
- Ensaya un túnel rechazado, un estado de pasarela del proxy, una espera agotada al conectar y un error de aplicación del destino. Pasa si el registro clasifica cada caso como fallo del tramo del proxy o del destino, nombra un responsable y indica el resultado visible para el usuario. Falla si alguno se informa solo como un error genérico de página.
- Ejecuta un caso en que el proxy devuelve un estado de pasarela y otro en que el destino devuelve un error de aplicación para la misma página. Pasa si aparecen como resultados separados con responsables distintos. Falla si se fusionan en un único recuento de fallos.
- Compara el plan escrito con la lista de rutas configurada. Pasa si las rutas en orden coinciden con las aprobadas, si el presupuesto de reintentos y el límite de tiempo del recorrido están escritos y si no aparece ninguna entrada directa ni ruta no aprobada. Falla si la configuración contiene una entrada que el plan no enumera.
- Durante una espera agotada ensayada, clasifica cada operación del recorrido como repetible, repetible solo con una clave verificada por el servidor o no repetible sin confirmación. Pasa si solo se volvieron a enviar automáticamente las operaciones repetibles. Falla si se volvió a enviar una solicitud no idempotente sin clave ni confirmación del usuario.
- Provoca un cambio controlado a la siguiente ruta aprobada. Pasa si el registro muestra el contexto, la ruta anterior, la ruta nueva, la hora, la categoría del desencadenante y quién lo aprobó como una asignación de ruta nueva. Falla si un informe presenta ambos segmentos como una sola sesión continua.
- Desactiva la ruta alternativa y repite el fallo. Pasa si el recorrido termina en el estado no disponible con la categoría del fallo y el responsable de la ruta anotados, y el registro de red no muestra ninguna conexión fuera de la ruta aprobada. Falla si la página carga por una conexión directa o si los intentos continúan sin fin.
Fuentes
Artículos Relacionados
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.