FingerprintJS Pro: tratamiento de datos y privacidad
Distingue la correlación por workspace, la seudonimización de IP, el historial y la entrega cifrada en FingerprintJS Pro de los controles del navegador.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
FingerprintJS Pro no es simplemente el hash de FingerprintJS de código abierto con más propiedades del navegador. El servicio comercial, documentado actualmente como Fingerprint Identification, procesa solicitudes de identificación mediante un sistema cliente-servidor. Sus consecuencias para la privacidad dependen del workspace, la región de tratamiento, la información devuelta y las copias que conserva la empresa que lo integra. BotBrowser proporciona controles de superficies del navegador respaldados por perfiles en la capa del motor; no puede cambiar los identificadores de otro servicio, borrar exportaciones del cliente ni establecer una finalidad lícita para el tratamiento.
La distinción importante es entre reducir un campo expuesto y terminar la correlación. Fingerprint documenta un modo de IP seudonimizada en el que la IP de la respuesta pasa a ser 0.0.0.0, mientras los identificadores de visitante existentes pueden continuar. También documenta identificadores diferentes para clientes no relacionados, pero identificación compartida entre varios dominios controlados por una empresa. Ninguna de estas afirmaciones significa que todas las observaciones dejen de ser vinculables. El límite relevante es la configuración del servicio y su finalidad declarada, no solo el nombre de host de la barra de direcciones.
Resumen
- Identification comercial utiliza un servicio que actúa como encargado del tratamiento. El resumen local de la biblioteca OSS no describe toda su ruta de datos.
- Los identificadores de visitante se delimitan por workspace. Varios dominios de una empresa pueden participar en ese ámbito; clientes distintos reciben identificadores distintos.
- La seudonimización cambia la información de IP almacenada y devuelta y limita varios productos. No necesariamente reinicia los identificadores existentes.
- Las cifras publicadas de 7, 30 y 90 días describen ventanas de consulta del historial. Las copias recibidas por webhook tienen otro ciclo de vida.
- Sealed Client Results cifra la entrega a través del cliente hasta el backend. El cifrado no significa que el encargado o el backend de integración nunca procesen el evento.
Contenido
- Tratamiento comercial frente a un resumen OSS
- Ámbito del workspace entre dominios controlados
- Seudonimización de IP y correlación conservada
- Elección de región y custodia del encargado
- Consulta del historial frente a copias posteriores
- Entrega cifrada y visibilidad en el cliente
- Controles del navegador y límites del servicio
- Conclusión práctica
Tratamiento comercial frente a un resumen OSS
La documentación de privacidad de Fingerprint distingue la biblioteca abierta de la API comercial cliente-servidor. Esa distinción cambia la primera pregunta de una evaluación de privacidad. Para una biblioteca local, un ingeniero puede examinar qué recopila una revisión concreta y cómo deriva un resumen. Para un servicio, también hacen falta el destinatario, el ámbito del identificador, la configuración de la cuenta, la entrega de respuestas y el almacenamiento del cliente. El nombre de un paquete no responde a esas preguntas.
El análisis del código OSS de FingerprintJS existente trata los estados de componentes, su orden y la procedencia del cálculo diferido del resumen en un commit fijado. Esos hechos no establecen la implementación ni el tratamiento de datos del producto comercial. En particular, un valor derivado localmente y un resultado remoto pueden tener historias distintas aunque ambos se denominen informalmente huella. Tratarlos como equivalentes elimina el límite del servicio antes de comenzar la evaluación.
Fingerprint describe al sitio integrador como responsable del tratamiento y a sí mismo como encargado. Son los papeles declarados por el proveedor en su modelo documentado, no una conclusión sobre todos los despliegues. El sitio decide por qué solicita identificación y cómo utiliza la respuesta. El encargado recibe y procesa información para prestar el servicio. La empresa sigue teniendo que evaluar su finalidad real, configuración, contratos y obligaciones; una declaración de cumplimiento del producto no decide esos asuntos por ella. El análisis de privacidad de hCaptcha separa también proveedor, integrador y usuario final según su política; sus términos no son el contrato de Identification.
La misma página de privacidad y cumplimiento distingue atribución y personalización de prevención del fraude y seguridad. Ofrece orientación sobre consentimiento e interés legítimo, pero no debe convertirse en un permiso universal para recopilar. La consecuencia de ingeniería es más concreta: deben ser explícitos el momento de identificación y su finalidad empresarial. Una integración de seguridad y otra de atribución de compras no deberían heredar silenciosamente sus supuestos de recopilación solo por usar el mismo software.
Según esa documentación, el agente JavaScript guarda cookies y otros metadatos del navegador durante la solicitud de identificación. Cargar el agente y solicitar identificación merecen, por tanto, entradas separadas en la descripción del flujo. La documentación permite activar explícitamente la identificación en circunstancias apropiadas, en lugar de suponer que cada carga de página debe producir un evento. Es una decisión de recopilación de la aplicación integradora, no una configuración de privacidad deducible de tener instalado un paquete.
Una evaluación útil distingue al menos tres registros: la decisión de solicitar identificación, el evento del servicio y el uso posterior del resultado por la aplicación. Están relacionados, pero no son idénticos. Un registro de aplicación puede sobrevivir a la solicitud original. Una respuesta puede influir en una decisión sin conservarse como copia completa del evento. Separarlos permite preguntar qué datos necesita una finalidad declarada, en lugar de tratar toda la integración como una operación indivisible.
La documentación de regiones y conservación aporta hechos de configuración del servicio; la documentación de resultados sellados explica una opción de entrega. Ninguna demuestra que un navegador concreto ejecutara una API concreta. No se presenta una captura de eventos V8 atribuible a su fuente. Una respuesta de red o un mapa de campos archivado no establece qué interfaces leyó el agente comercial actual, en qué frame ni en qué etapa de una solicitud.
Ese límite probatorio no elimina la decisión central de privacidad. Una empresa puede comparar ámbito del workspace, copias conservadas y opciones documentadas sin reconstruir un recopilador propietario. A la inversa, una traza de API en ejecución no probaría por sí sola cómo almacena o borra datos el encargado. La observación del navegador y la gobernanza del servicio responden a preguntas diferentes. Deben encontrarse en la evaluación, pero no sustituirse cuando falte la evidencia necesaria.
Ámbito del workspace entre dominios controlados
Fingerprint afirma que los identificadores de visitante se delimitan por workspace, no por un identificador universal compartido entre todos sus clientes. Dice que dos clientes que identifican el mismo navegador o dispositivo reciben identificadores diferentes. Es un límite documentado significativo para una clase de correlación. No promete que una empresa no pueda vincular actividad entre sus propiedades ni describe cómo puede asociar los resultados con los datos de sus propias cuentas.
La misma fuente permite expresamente identificar visitantes entre varios dominios controlados por una empresa. La condición indicada es que los sitios usen una clave pública de API del mismo workspace. El límite de origen y el límite de workspace responden, por tanto, a preguntas distintas. Dos sitios pueden tener orígenes separados y participar en un mismo ámbito de identificación documentado. Un aviso de privacidad centrado solo en el dominio actual puede omitir esa relación organizativa aunque la integración funcione conforme a su configuración.
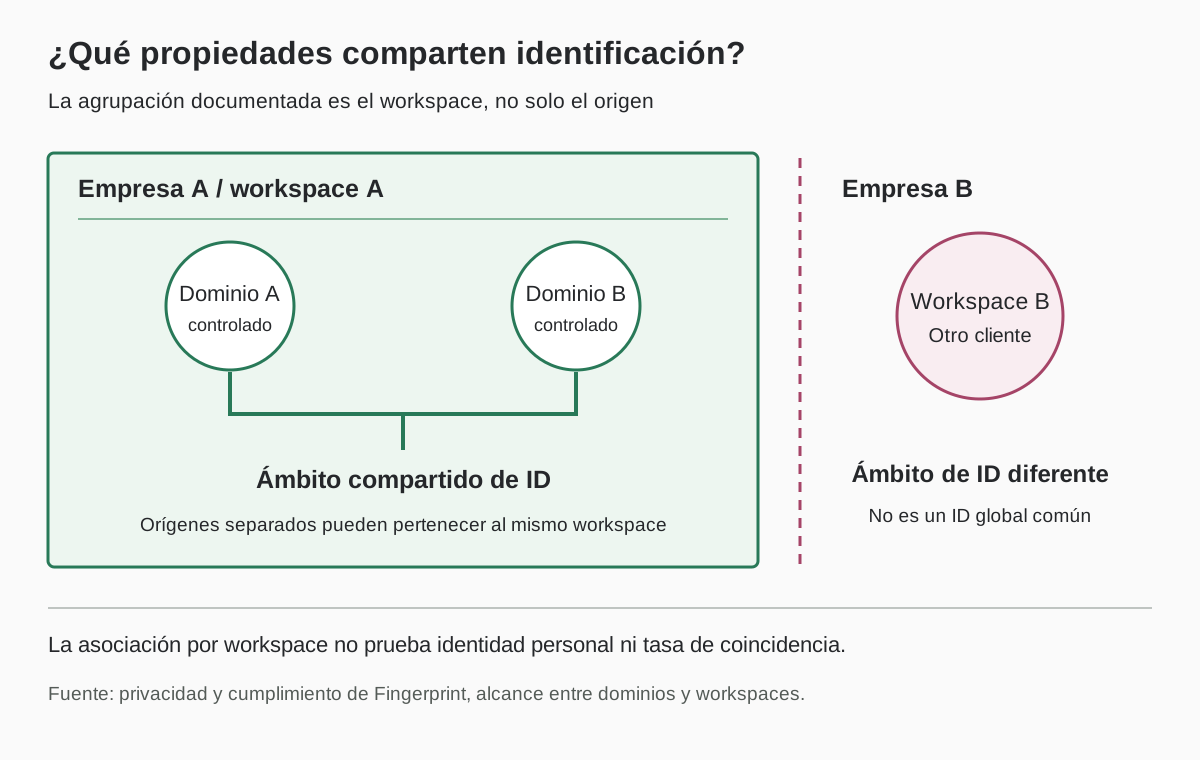
El diagrama representa el modelo de titularidad declarado por el proveedor, no una tasa de coincidencia medida. Los dominios de un workspace indican una asociación permitida entre propiedades controladas. El workspace separado indica el límite documentado entre clientes diferentes.
Para una empresa con un sitio público y una aplicación, compartir ámbito puede servir a una finalidad de atribución elegida explícitamente. Otra empresa puede preferir separar contextos de producto no relacionados para cumplir sus objetivos de minimización. Son decisiones de finalidad y arquitectura, no instrucciones para cambiar resultados de detección. La explicación entre dominios del proveedor acredita que la asociación está soportada, no que cualquier agrupación sea apropiada o esté jurídicamente justificada.
También hay que distinguir el ámbito de workspace de una persona. La documentación describe identificación de navegadores y dispositivos. La aplicación puede guardar por separado información de cuenta, compras o soporte. Si asocia un evento con esos registros, la exposición incluye la asociación realizada por la aplicación, no solo el campo de identificador de visitante. Denominar seudónimo al resultado original no describe todo lo que la base del cliente puede conocer después de esa asociación.
La diferencia general entre firma del navegador y persona se desarrolla en huellas del navegador y Canvas Fingerprinting. Aquí se añade el alcance organizativo. ¿Quién opera cada dominio? ¿Qué workspace utiliza cada integración? ¿Qué finalidad permite considerar conjuntamente los eventos? Esas respuestas dibujan un límite de privacidad más útil que afirmar que el identificador es simplemente de primera parte o que se genera sin una cookie de terceros.
La documentación de privacidad afirma que el sistema no es adecuado para un grafo global entre sitios no relacionados porque los clientes reciben identificadores distintos. Hay que mantener ese matiz. Un identificador global entre clientes y un identificador de la empresa entre sus dominios no son el mismo acuerdo. Negar el primero no niega el segundo. Asimismo, la existencia del segundo no demuestra que clientes no relacionados reciban un ID común o compartan historial.
El inventario de integración debe identificar tanto los orígenes como las relaciones de workspace que los conectan. Resulta especialmente útil cuando un equipo mantiene el sitio público y otro la aplicación autenticada. Cada equipo puede describir correctamente su frontend y pasar por alto una configuración compartida del servicio. La documentación justifica comprobar esa relación; únicamente la configuración real de la empresa puede demostrar si existe en su despliegue.
Seudonimización de IP y correlación conservada
La documentación de IP seudonimizada describe una elección entre tratamiento ordinario de IP y otra representación. En el modo ordinario, Fingerprint dice que almacena la IP de origen en texto claro y la utiliza para identificar. En el alternativo, combina la IP original con otros metadatos y la convierte criptográficamente antes de utilizarla en sus algoritmos. Son descripciones del modelo del proveedor, no observaciones independientes de su infraestructura.
La diferencia documentada en la respuesta es concreta. Las respuestas ordinarias exponen la IP original; las del modo seudonimizado usan 0.0.0.0. Ese valor representa un campo de respuesta, no la nueva dirección de red del navegador. No significa que la solicitud saliera desde una dirección de ceros ni que ninguna infraestructura manejara una conexión real. Confundir el campo mostrado con la conexión convertiría una opción de tratamiento en una afirmación de transporte sin respaldo.
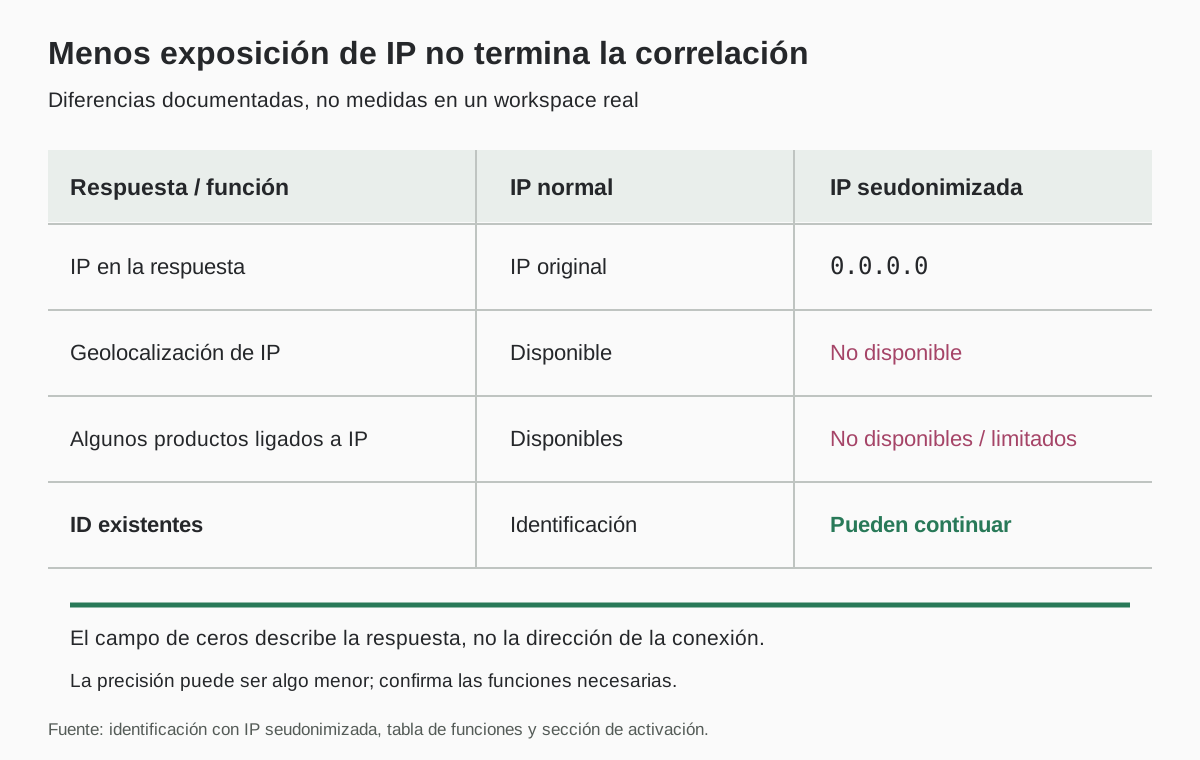
La tabla comparativa enumera contrapartidas funcionales. La geolocalización de IP no está disponible en modo seudonimizado. Tampoco lo están varios Smart Signals dependientes de IP, y la detección de bots del navegador tiene disponibilidad limitada. La pregunta no es si desaparece un campo sin consecuencias. Es si la aplicación necesita esas salidas para su finalidad y si reducir la exposición de IP compensa la pérdida de funcionalidad documentada.
La sección de activación aporta el matiz decisivo sobre correlación: puede mantenerse el workspace existente y los usuarios pueden seguir recibiendo el mismo identificador de visitante. Una aplicación que deja de guardar la IP visible no necesariamente deja de vincular visitas mediante otro identificador. Eso no vuelve inútil la seudonimización. Significa que la mejora debe describirse en el campo y el tratamiento que cambian, sin ampliarla hasta prometer una ausencia completa de vínculos.
La misma fuente también matiza la precisión. La introducción presenta favorablemente la alternativa, pero la sección de activación dice que la precisión puede ser ligeramente inferior a la identificación estándar. Una decisión de compra o implementación debe conservar esa condición específica. Sin porcentaje ni comparación controlada, no puede afirmarse cuánto cambiaría ni prometer precisión inalterada para el tráfico de una empresa concreta.
| Requisito de la aplicación | Consecuencia documentada | Límite de la decisión |
|---|---|---|
| Evitar la IP original en respuestas de identificación | El modo seudonimizado devuelve 0.0.0.0 | Evaluar otros campos y copias del cliente |
| Utilizar geolocalización de IP del servicio | No está disponible en ese modo | Decidir si la finalidad necesita esa función |
| Mantener continuidad de identificación | Los identificadores existentes pueden continuar | No describir el cambio como reinicio de correlación |
| Conservar todos los productos dependientes de IP | Varios quedan indisponibles o limitados | Confirmar con el proveedor el producto necesario |
La tabla es una ayuda basada en diferencias documentadas, no una medición de un workspace configurado. La primera fila trata la exposición en la respuesta; la tercera, la continuidad de otro identificador. Separarlas evita un error frecuente: considerar que retirar un campo reconocible demuestra que todos los registros restantes carecen de valor asociativo. La continuidad de identificadores que declara el propio servicio contradice directamente esa deducción.
El cliente también debe separar la representación transformada del encargado de los datos de su aplicación. Si registra direcciones de red o eventos de cuenta por otra vía, cambiar una opción del encargado no reescribe esos registros independientes. La fuente describe Identification, no todos los servidores de la arquitectura del cliente. La pregunta útil es qué copias y asociaciones cambian con la opción y cuáles permanecen porque las produce otra parte del sistema.
Elección de región y custodia del encargado
La documentación de regiones enumera tres regiones de workspace: Global en Northern Virginia, EU en Frankfurt y Asia en Mumbai. La predeterminada es US. También indica que la región elegida no puede cambiarse después. Es, por tanto, una decisión inicial con consecuencias persistentes, no una preferencia estética que pueda suponerse vinculada a la ubicación física del visitante o a la dirección postal de la empresa.
El nombre de región identifica la configuración del servicio descrita por el proveedor. No debe confundirse con el sistema operativo objetivo de un perfil, una salida de proxy o el idioma de la interfaz. Esas propiedades pueden afectar a la sesión sin cambiar dónde declara el encargado que guarda los datos del workspace. Una página en un idioma europeo no demuestra un workspace EU. Una conexión por un proxy regional no demuestra que un workspace existente haya cambiado de región.
Fingerprint afirma que los datos no salen de la región elegida. Es el compromiso de residencia declarado por el proveedor para su servicio. No localiza el almacén analítico, los registros del backend ni las copias de webhook de la empresa integradora. Si esta recibe un evento y lo guarda en otro lugar, aparece un destino adicional bajo control del cliente. El mapa completo necesita tanto la región del encargado como los lugares donde el cliente recibe o conserva sus salidas.
Para una región no predeterminada, la documentación exige especificarla en el agente JavaScript y usar la URL base correspondiente en el Server API. Son dos superficies de configuración asociadas a la misma elección. Un frontend y un backend mantenidos por equipos distintos pueden necesitar coordinación. El requisito documentado sirve al inventario de integración; no demuestra que haya ocurrido una configuración inconsistente ni predice el error que devolvería un despliegue concreto.
La página de privacidad y cumplimiento sitúa las decisiones de la empresa junto a las obligaciones del encargado. Por eso, elegir región es necesario pero insuficiente para la evaluación completa. El equipo todavía debe conocer la finalidad, las propiedades conectadas, las respuestas conservadas y quién puede acceder. Elegir una región con nombre no responde automáticamente a ninguna de esas preguntas.
Por ejemplo, una empresa puede elegir un workspace EU y enviar eventos recibidos a otro sistema de informes operado por ella. La declaración regional del proveedor describe su lado del servicio. El sistema de informes introduce una decisión del cliente que requiere evaluación independiente. El ejemplo no afirma una transferencia concreta ni un resultado jurídico; muestra por qué región del encargado y destino posterior deben ocupar filas distintas del inventario, no comprimirse en una etiqueta regional.
Las secciones de conservación y borrado añaden otro límite independiente. Un destino responde dónde se trata o guarda un registro. Una ventana de consulta responde hasta cuándo permite acceder una interfaz. Un proceso de borrado trata su eliminación. Ninguna descripción sustituye a las otras. Conocer la región no demuestra cuánto vive cada registro; conocer el período de consulta no demuestra dónde residen las exportaciones del cliente.
La decisión regional debe preceder a las suposiciones de traslado. La fuente llama expresamente inmutable a la elección del workspace; esa afirmación no proporciona una promesa general de migración. Quien necesite otra disposición debe confirmar con el proveedor el proceso soportado y sus consecuencias. No debe suponer que cambiar una preferencia del navegador, un argumento regional o un hostname modifica el compromiso de almacenamiento del workspace existente. La evaluación necesita el acuerdo real, no uno deducido.
Consulta del historial frente a copias posteriores
El título de la sección de conservación es amplio, pero el texto y la tabla definen una capacidad específica: hasta qué antigüedad se puede consultar el historial mediante Dashboard y Server API. Las ventanas publicadas son 7 días para Free, 30 para planes de autoservicio de pago y 90 o más para Enterprise según contrato. Al citarlas deben conservarse la interfaz y el plan correspondientes.
Acceso y eliminación son eventos diferentes. Que un registro deje de aparecer en una interfaz no demuestra por sí solo que todas las copias subyacentes o posteriores se hayan borrado. Tampoco demuestra la tabla que se conserven indefinidamente. Establece la disponibilidad que describe el proveedor. El borrado real necesita el acuerdo aplicable, el proceso soportado y evidencia adecuada, no una extrapolación del límite de historial de una interfaz.
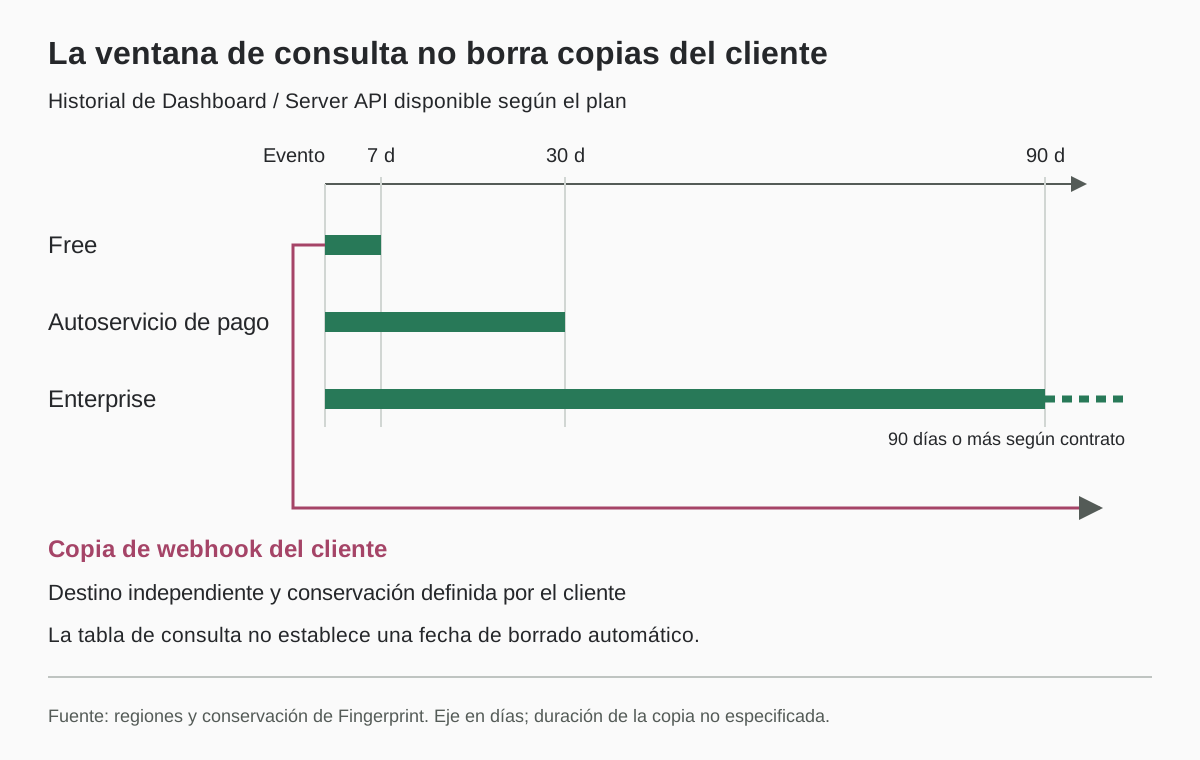
La misma documentación ofrece webhooks para almacenamiento más largo o personalizado. Cada respuesta puede entregarse a un endpoint del cliente y guardarse en su base. Es evidencia directa de que la consulta del servicio y una copia del cliente pueden tener ciclos diferentes. Por eso el diagrama coloca la copia en una rama aparte en lugar de prolongar la barra de consulta hasta inventar un calendario universal de conservación.
El cliente que utiliza esa opción necesita decidir durante cuánto tiempo son útiles los datos recibidos y quién puede acceder. Esa decisión no viene determinada por que el plan indique 7 o 30 días. La tabla no establece cómo limpia el cliente su base de datos. Describir toda la conservación mediante la ventana del plan puede retratar correctamente la interfaz y, al mismo tiempo, omitir una copia que los sistemas propios siguen manteniendo.
La sección de borrado dice que Fingerprint, como encargado, eliminará información de un navegador o dispositivo a petición del responsable y remite a soporte. Es un proceso documentado con asignación de papeles. No es una prueba de borrado en producción, un plazo garantizado ni evidencia de eliminación simultánea de exportaciones independientes. Esas afirmaciones adicionales requieren compromisos aplicables y verificación propios.
El inventario del responsable puede distinguir tres casos. La aplicación puede consultar solo cuando lo necesita y evitar una copia completa; puede conservar determinados campos para una finalidad definida; o puede guardar la respuesta completa en otro sistema. Son opciones ilustrativas del cliente, no afirmaciones sobre valores predeterminados. Generan responsabilidades de acceso y limpieza diferentes aunque las tres empresas utilicen el mismo plan y región.
La explicación de las ventanas indica que pasar de Free a un plan de pago amplía la consulta a 30 días. Es un cambio de acceso, no una base para afirmar que se revirtió un borrado histórico o que siempre será recuperable todo lo que no estaba disponible. La declaración respalda el cambio de ventana. La disponibilidad histórica de una cuenta concreta debe confirmarse mediante el comportamiento soportado de esa cuenta y sus términos contractuales.
Para decidir sobre privacidad hay que separar una función del servicio de un compromiso integral de conservación. La función tiene interfaz, plan y período; el compromiso integral debe abarcar los destinos reales del encargado y del cliente. Una ventana corta puede coexistir con una copia más larga. Una respuesta cifrada también puede conservarse tras descifrarla. Ni una cifra pequeña en una tabla de precios ni la representación cifrada durante el transporte establecen el ciclo de todos los registros resultantes.
Entrega cifrada y visibilidad en el cliente
Sealed Client Results es una alternativa de entrega para información normalmente obtenida por Server API. El diseño documentado devuelve un resultado cifrado a través del agente, destinado a ser descifrado y usado en el backend integrador. La propiedad de privacidad trata de quién puede leer el resultado durante el recorrido. No elimina el tratamiento inicial del servicio ni la capacidad del backend para recibir el evento en forma utilizable.
En el esquema ordinario, el backend recupera el evento del servicio mediante Server API. En el sellado, el navegador transporta el resultado cifrado y el backend lo descifra. Cambian entrega y visibilidad en el cliente, pero ambos recorridos implican servicio y backend integrador. La comparación relevante no es «datos frente a ningún dato»: es si un participante recibe información legible o cifrada y qué ocurre después de que un destinatario autorizado la obtiene.
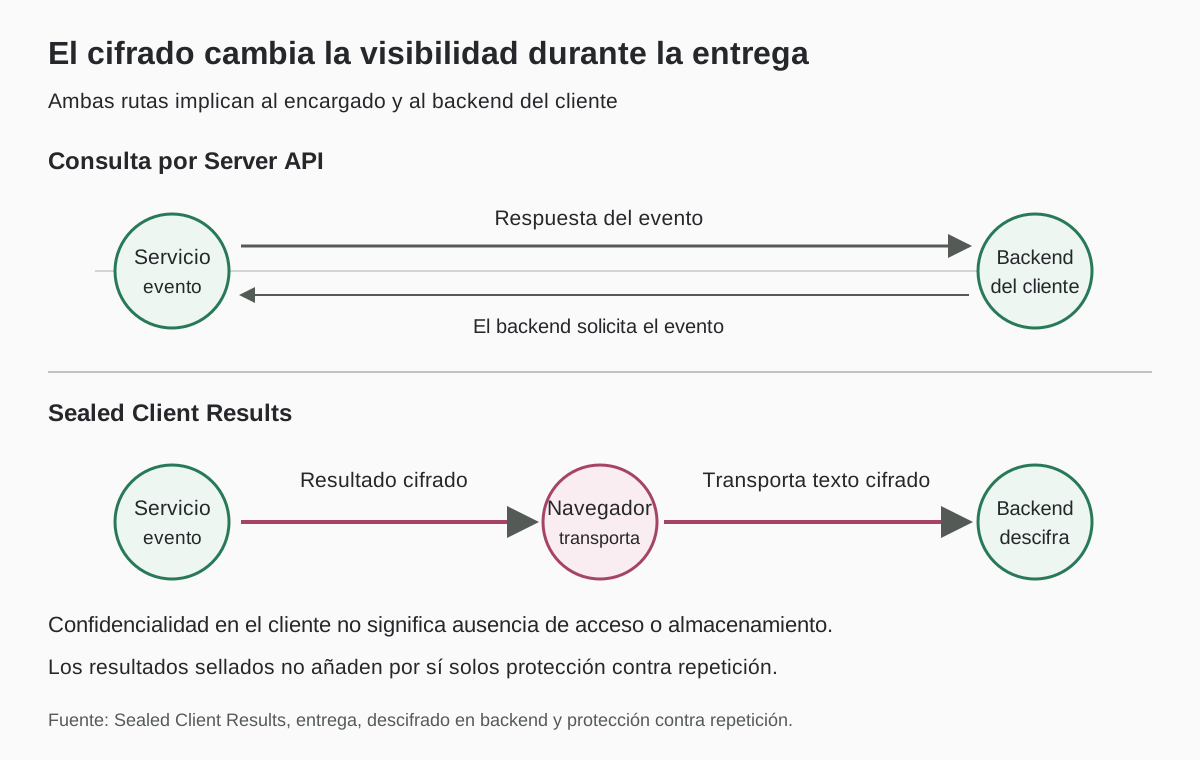
Fingerprint describe el resultado sellado como contenedor de la información disponible en su endpoint de eventos. Cifrar ese paquete no establece por sí mismo minimización. Puede reducir la exposición a lectores del cliente sin cambiar la cantidad de información disponible para el backend. El equipo debe decidir qué campos necesita la aplicación por separado de su elección de cifrar o no la entrega.
La documentación de configuración sitúa el descifrado en el backend. Ese límite importa: la clave y el evento descifrado no están destinados a convertirse en estado normalmente legible por la página. Es una arquitectura documentada, no una afirmación de implementación correcta en todas las integraciones. Evaluar un despliegue requiere examinar dónde expone realmente el resultado la aplicación y dónde registra su información descifrada.
El cifrado tampoco debe ampliarse hasta prometer frescura. La sección de protección contra repetición dice expresamente que los resultados sellados no añaden esa protección por sí mismos. Entrega auténtica y aceptación de la aplicación son propiedades diferentes. Un evento cifrado puede seguir necesitando decisiones sobre relevancia y antigüedad. No se proporciona una interacción con un servicio protegido ni un procedimiento de aceptación; un mecanismo no debe recibir garantías que su proveedor no declara.
El papel transportador del navegador puede producir descripciones engañosas. Que el resultado pase por él no significa que la página pueda leer todo su contenido. Que la página no pueda leer el contenido cifrado no significa que el encargado nunca lo haya manejado. Son partes y etapas diferentes. Un diagrama debe identificar participante, representación y destino conjuntamente, en lugar de etiquetar toda la transacción como privada o del lado del cliente.
La documentación de historial sigue siendo relevante después de elegir la entrega. Cuando un backend recibe un evento utilizable, cualquier almacenamiento del cliente pertenece al inventario de copias, llegue por Server API, webhook o resultado sellado. La entrega sellada no fija el borrado del cliente. Una ventana de consulta tampoco impide conservar un evento ya recibido mediante una integración autorizada.
Controles del navegador y límites del servicio
La documentación de huellas de BotBrowser describe controles respaldados por perfiles en rutas nativas del navegador, no mediante inyección de JavaScript en la página. Esa afirmación trata la superficie expuesta al contenido. Un parche de página modifica otra capa. Ninguna de las dos determina por sí misma la organización de workspaces de un encargado, el uso que hace el cliente del identificador o el ciclo de información ya recibida por un sistema externo.
Separar esas cuestiones evita una comparación de productos poco útil. La consistencia de superficies nativas es una cuestión de ingeniería diferente de si dos propiedades comparten ámbito de identificación. Una preferencia del navegador no es una solicitud de borrado al encargado. Una superficie coherente no demuestra que el proveedor devuelva cierta puntuación ni que un sitio autorice una acción. Esos resultados requieren autoridad y evidencia propias, no deducciones de la capa donde opera una herramienta de privacidad.
La explicación general de huellas del navegador trata cómo contribuyen las propiedades expuestas a la correlación. La decisión sobre el servicio añade las partes y configuraciones que rodean la recopilación. Los controles del navegador pueden tratar sus superficies documentadas; la empresa todavía elige si solicita identificación, dónde reside el workspace, qué propiedades lo comparten y qué campos incorpora a sus registros. Las responsabilidades siguen separadas aunque una organización evalúe ambas a la vez.
La siguiente tabla asigna cada pregunta a la evidencia capaz de responderla. Ninguna exige reconstruir un recopilador propietario. Un inventario de API necesitaría otra evidencia, incluidos eventos atribuibles para las afirmaciones de ejecución. Una afirmación de conservación necesitaría registros del servicio y del cliente. Distinguirlos evita recoger salidas sensibles del navegador solo para contestar una pregunta sobre almacenamiento contractual o ámbito de correlación.
| Pregunta | Evidencia pertinente | Lo que no establece |
|---|---|---|
| ¿Pueden compartir identificación los dominios controlados? | Configuración del workspace y ámbito documentado | Identidad de una persona o grafo universal entre clientes |
| ¿Qué cambia al seudonimizar IP? | Tabla actual y opción real del workspace | Imposibilidad total de correlación o precisión inalterada |
| ¿Hasta cuándo se consulta el historial? | Términos de Dashboard y Server API por plan | Borrado de todas las copias del encargado y del cliente |
| ¿Quién lee un resultado sellado? | Diseño de entrega e implementación de la aplicación | Ausencia de tratamiento, conservación o protección automática de frescura |
| ¿Qué API del navegador se ejecutaron? | Eventos atribuibles a fuentes en la captura pertinente | Almacenamiento, borrado o aceptación por terceros |
Preguntas frecuentes
¿Un identificador limitado al workspace implica uno distinto en cada dominio?
No. El modelo declarado permite identificar entre dominios controlados por una empresa si usan el mismo workspace. El ámbito del dominio y el del workspace deben documentarse por separado.
¿0.0.0.0 en una respuesta significa que no existió una IP de origen?
No. Es la representación documentada del modo seudonimizado. No afirma que la conexión original careciera de dirección; la continuidad del identificador puede permanecer.
¿La ventana de consulta determina cuánto vive una copia de webhook?
No. La documentación de conservación ofrece almacenamiento por webhook como opción separada. El cliente necesita una política propia de acceso y limpieza para ese destino, no convertir el período de consulta en una promesa de borrado sin respaldo.
Fuentes
- Privacidad y cumplimiento de Fingerprint
- Regiones y conservación de datos
- Identificación mediante direcciones IP seudonimizadas
- Sealed Client Results
- Descripción de huellas del navegador de BotBrowser
Conclusión práctica
Evalúa FingerprintJS Pro por sus límites documentados: correlación de workspace, región del encargado, representación de IP, entrega y copias conservadas. Elige cada uno según la finalidad real. Una IP de ceros, un resultado cifrado y una ventana corta describen propiedades diferentes; ninguna demuestra que toda correlación o almacenamiento hayan terminado. Antes de integrar o cambiar el servicio, identifica los dominios controlados y destinos del cliente que participan y confirma con el proveedor los términos y la configuración vigentes.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
FingerprintJS OSS: recopilación y origen del resumen
Huella digitalAkamai Bot Manager: datos del sensor y privacidad
Huella digitalPrivacidad de hCaptcha: señales y límites de la evidencia
Huella digitalPrivacidad de reCAPTCHA: señales y límites de evidencia
Huella digitalAWS WAF CAPTCHA: tokens, señales y privacidad
Huella digitalKasada: señales de desafíos y privacidad
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.