DataView: порядок байтов, выравнивание и границы
Один зонд на фиксированных буферах: порядок байтов по умолчанию, невыровненные чтения, ошибки границ, точность float, общие буферы, view со смещением и геттеры BigInt.
BotBrowser Team
Нужна структурированная документация по теме Отпечатки?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
BotBrowser умеет воспроизводить авторизованный same-origin fixture под объявленным профилем и вести ограниченную запись о том, какую бинарную раскладку прочитала страница и в каком порядке байтов, но он не может изменить порядок байтов, который использует протокол, не может заставить типизированный массив терпеть невыровненное смещение и не может восстановить поле после того, как чтение за границами выбросило исключение. Этот обзор прогоняет один зонд по девяти фиксированным буферам и фиксирует порядок байтов по умолчанию против явного, что невыровненные чтения работают, тогда как view типизированного массива отказывается, что чтение за границами выбрасывает исключение, тогда как типизированный массив молча отбрасывает запись, какую точность float даёт каждая ширина, как view и типизированный массив делят один буфер, что сообщает view со смещением, как байты становятся текстом и что добавляют геттеры BigInt.
Кратко
setUint32по умолчанию пишет старший байт первым, поэтому0x01020304ложится как01020304и читается обратно как16909060в big-endian против67305985в little-endian.DataViewчитает по любому смещению, поэтомуsetUint32(1, ...)работает, тогда какUint32Arrayпо смещению один выбрасываетRangeError.- Чтение
getUint32за границами выбрасываетRangeError, тогда какtyped[10] = 7на четырёхбайтовом массиве молча отбрасывается и длина остаётся четыре. Float32не может точно хранить0.1и читается обратно как0.10000000149011612, тогда какFloat64читается обратно как0.1, поэтому ширина поля является частью его смысла.DataViewиUint8Arrayнад одним буфером видят записи друг друга, поэтому запись байта меняет то, что читает view.- View со смещением сообщает собственные
byteLengthиbyteOffset, тогда какbuffer.byteLengthостаётся всей аллокацией, а чтение на один за концом view выбрасывает исключение. - Байты не текст: одни и те же четыре байта декодируются как
hiéв UTF-8 иhiéв latin1. getBigUint64возвращаетBigInt, и добавлениеNumberк нему выбрасываетTypeError.
Содержание
- В каком порядке DataView пишет по умолчанию
- Где view допускает больше, чем типизированный массив
- Чем каждая ширина платит в точности
- Что сообщает view со смещением и как делится буфер
- Как байты становятся текстом и откуда берётся BigInt
- Записать бинарное чтение
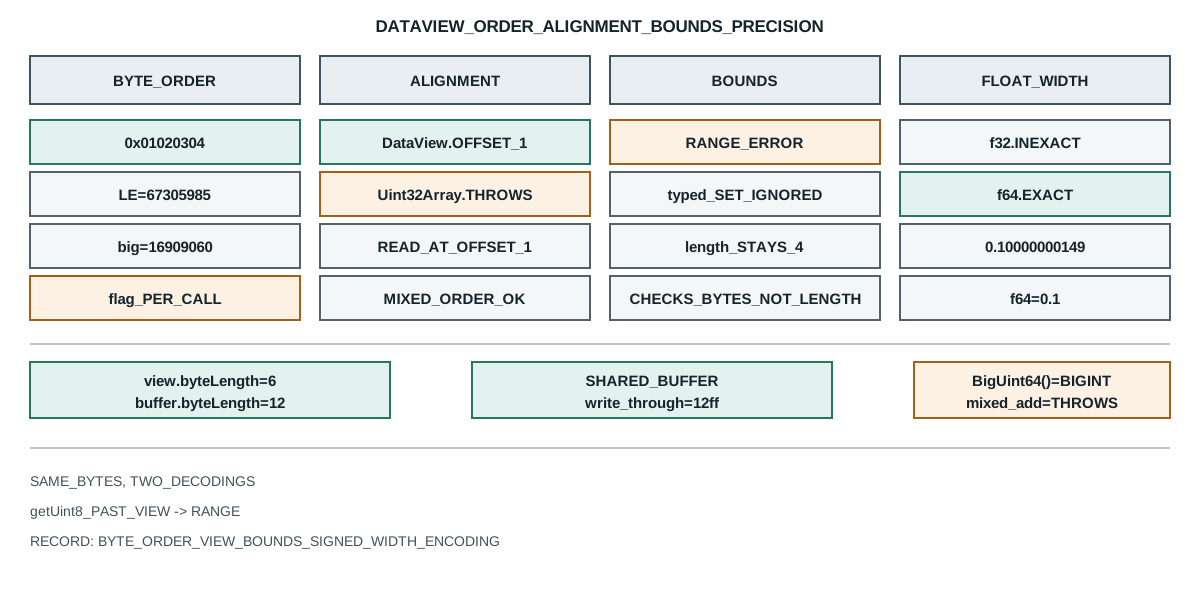
В каком порядке DataView пишет по умолчанию
DataView выбирает порядок байтов на каждый вызов, и по умолчанию это big-endian. Зонд записывает одно целое и затем читает его обратно двумя способами:
node=v26.9.0
default-bytes -> 01020304 readLE=67305985 readBE=16909060
unaligned-read -> deadbeef
typed-aligned-required -> RangeError
bounds -> dataview=RangeError typed-set-ignored=true length=4
float-precision -> f32=0.10000000149011612 f64=0.1 f32-exact=false
method-set -> Int8,Uint8,Int16,Uint16,Int32,Uint32,Float32,Float64,BigInt64,BigUint64
shared-buffer -> bytes=12340000 view=1234
write-through -> view-after-byte-write=12ff
offset-view -> byteLength=6 byteOffset=4 bufferByteLength=12
getUint8-at-view-end -> 0 end-throws=RangeError
decode -> utf8=hié latin1=hié bytes=4
bigint -> value=18446744073709551615 mixed-add=TypeError
Четыре байта на проводе это 01 02 03 04 в порядке памяти, и та же память читается как два разных числа в зависимости от флага. 16909060 это 0x01020304, и это чтение совпадает с записью, а 67305985 это 0x04030201, те же байты, прочитанные наоборот. Значит запись положила старший байт 0x01020304 по смещению ноль. Читатель, который передает true там, где писатель использовал значение по умолчанию, видит целое с обратными байтами, и ошибка невидима в hex-дампе, потому что байты выглядят правильно.
Эта асимметрия объясняет, почему сетевое поле всегда имеет порядок байтов, записанный в спецификации, тогда как формат файла, записанный локальным процессом, обычно наследует порядок узла. По умолчанию используется big-endian, который совпадает с большинством сетевых заголовков и противоположен порядку узла на каждой текущей мейнстримной цели, поэтому страница, которая опускает флаг, читает локально записанный двоичный файл наоборот. Явная передача флага это единственный способ, которым запись может заявить, что она прочитала, в любом направлении.
Есть последствие второго порядка, которое ловит читателя, который флаг всё же помнит. Флаг задаётся на вызов, а не на view, поэтому один DataView может читать своё первое поле как big-endian, а второе как little-endian, и оба варианта законны. Бинарный формат с унаследованным big-endian заголовком, за которым следует little-endian тело, имеет ровно такую форму, и парсер, который задаёт порядок один раз, при конструировании, не имеет способа это выразить. Флаг должен путешествовать вместе с полем, а значит таблица полей в парсере должна называть порядок рядом с шириной и знаковостью.
Методы float принимают тот же флаг, и сбой там ещё тише. Float32, записанный как big-endian и прочитанный как little-endian, не выбрасывает исключение и не даёт распознаваемо неверное целое; он даёт малый денормал или огромное значение, и оба выглядят как правдоподобные измерения, пока страница не сравнит их с диапазоном. Читатель, который проверяет float против ожидаемых границ, ловит это столкновение только когда байтово-обратные биты случайно выпадают за диапазон, а страница, которая доверяет значению слепо, не имеет обнаружения вовсе.
Где view допускает больше, чем типизированный массив
DataView не требует, чтобы его смещение было выровнено по ширине, которую он читает, тогда как view типизированного массива требует. Зонд пишет и читает целое по смещению один:
unaligned-read -> deadbeef
typed-aligned-required -> RangeError
DataView прочитал четыре байта начиная со смещения один и вернул значение, которое записал. Uint32Array над тем же буфером по тому же смещению выбросил RangeError, потому что view типизированного массива требует, чтобы его byteOffset был кратен размеру его элемента. Это структурное различие: DataView это курсор по байтам, а типизированный массив это окно, которое должно совпадать со своей сеткой элементов.
Семантику элементов типизированного массива разбирает ArrayBuffer и представления типизированных массивов. Выбор между ними следует из этого. Парсер, который проходит заголовок поле за полем со смешанными ширинами и без заполнения, использует DataView. Страница, которая читает большой блок одного типа, например пиксельный буфер или массив сэмплов, использует типизированный массив и платит требование выравнивания один раз. Страница, которой нужно и то и другое, может создать DataView и несколько view типизированного массива над одним буфером, по одному на каждую цель, потому что все они делят память.
Правило выравнивания имеет последствие для производительности, которое легко перевернуть. Выровненное чтение типизированного массива может отобразиться в одну машинную загрузку, тогда как чтение DataView должно собирать байты и может быть медленнее на том же поле. Вот почему страница, которая в горячем цикле разбирает один тип элемента, использует типизированный массив, даже когда буфер не выровнен в начале, переходя к первому выровненному смещению и пропуская ведущие байты, и почему страница, которая разбирает холодный заголовок со смешанными ширинами, использует DataView и принимает стоимость на каждое поле. Двое не взаимозаменяемы на одной скорости, и выбор одного по причине другого это частый источник медленного парсера, который ещё и трудно исправить позже.
Границы ведут себя в этих двух по-разному, и это разница опасная. Зонд читает одно целое за концом и пишет один байт за концом:
bounds -> dataview=RangeError typed-set-ignored=true length=4
Чтение DataView выбросило RangeError, что останавливает парсер на точном поле, которое не удалось прочитать. Запись типизированного массива по индексу десять на четырёхбайтовом массиве не сделала вообще ничего, и длина осталась четыре, поэтому страница, которая заполняет буфер по индексу и проверяет только длину после, не может отличить отброшенную запись от успешной. В ветке кода, которая декодирует недоверенный ввод, поведение с исключением это то, что падает громко, а молчаливое это то, что даёт правдоподобный но неверный результат.
Чем каждая ширина платит в точности
View предоставляет десять типов элементов, и две ширины float различаются в том, что они могут представить:
method-set -> Int8,Uint8,Int16,Uint16,Int32,Uint32,Float32,Float64,BigInt64,BigUint64
float-precision -> f32=0.10000000149011612 f64=0.1 f32-exact=false
Обеим ширинам был дан один и тот же литерал 0.1, и только шестидесятичетырёхбитное чтение вернулось как 0.1. Тридцатидвухбитное чтение вернуло 0.10000000149011612, что является ближайшим значением, которое может хранить тридцатидвухбитный float. Страница, которая читает поле как Float32, округляет его для отображения и сравнивает с сохранённым 0.1, получает несовпадение, не имеющее отношения к данным.
Целочисленные ширины имеют ту же проблему в другой форме. Int8 и Uint8 различаются только выше 127, где знаковая форма переходит в отрицательное, поэтому байт, который отправитель записал как 200, читается как -56 через getInt8. Страница, которая выбирает знаковый геттер для поля, которое спецификация называет беззнаковым, получает отрицательное число в диапазоне, задокументированном как положительный, и ошибка появляется только когда значение пересекает середину.
Случай Float64 также показывает, почему сравнение двух float между двумя рантаймами требует осторожности. Значение 0.1 не представимо точно в двоичном виде ни при какой ширине, и шестидесятичетырёхбитное чтение напечатало 0.1 только потому, что отображение его округлило. Запись, которая хранит отображаемое значение, а не сырые биты, сохранила округлённое число, и два рантайма, которые согласны по отображению, всё ещё могут хранить разные биты.
Тот же момент точности решает, как сравнивается хеш или контрольная сумма. Страница, которая читает тридцатидвухбитное слово дайджеста как Float32 и сравнивает с сохранённым литералом, сравнивает округлённые значения, и два дайджеста, которые различаются только в младших битах, могут сравняться равными после кругового пути. Исправление в том, чтобы держать бинарный дайджест в его целочисленной ширине, использовать getUint32 вместо float геттера и сравнивать целые напрямую. Контрольная сумма никогда не float, и чтение её как float это ошибка, которая заставляет проверку пройти, когда она должна провалиться.
Как view и типизированный массив делят один буфер
DataView держит ссылку на ArrayBuffer, а не копию, поэтому каждый другой view над этим буфером видит ту же память. Зонд пишет через DataView, а затем через Uint8Array:
shared-buffer -> bytes=12340000 view=1234
write-through -> view-after-byte-write=12ff
Запись 0x1234 как big-endian легла как 12 34 00 00, что и увидел байтовый view. Запись 0xff во второй байт изменила целое, которое читает view, на 0x12ff, вообще не трогая DataView. Страница, которая делает снимок одного view и ожидает, что он останется на месте при записях другого view, имеет устаревшее значение; страница, которая намеренно полагается на разделение, имеет дешёвый способ переинтерпретировать ту же память.
Вот почему DataView хорошо подходит для парсера протокола, которому также нужна контрольная сумма на уровне байтов. Парсер читает поля через view, а Uint8Array над тем же буфером суммирует байты, и ни один не копирует буфер. Стоимость в том, что любая мутация видна везде, поэтому парсер, который пишет обратно в буфер, из которого читает, может испортить контрольную сумму, вычисленную раньше, если порядок не зафиксирован.
Что сообщает view со смещением и как делится буфер
View можно создать над срезом буфера, и он сообщает о срезе, а не об аллокации:
offset-view -> byteLength=6 byteOffset=4 bufferByteLength=12
getUint8-at-view-end -> 0 end-throws=RangeError
View покрывает шесть байтов начиная со смещения четыре, и его buffer.byteLength всё ещё сообщает всю двенадцатибайтовую аллокацию. Страница, которая вычисляет смещение поля из buffer.byteLength, а не из собственного byteLength view, читает за срезом, и вот почему последняя строка важна: чтение индекса шесть, на один за собственными шестью байтами view, выбрасывает исключение, хотя у нижележащего буфера есть место. Границы view, а не буфера, решают, что может затронуть чтение.
Это различие то, что сбивает подпарсер. Функция, которой передали view над срезом полезной нагрузки, не может прочитать следующее поле внешнего кадра, потому что view заканчивается там, где заканчивается срез, и исключение это единственный сигнал, что вызывающий передал более узкий view, чем предполагала функция. Запись, которая хранит длину буфера, но не смещение и длину view, не может восстановить, какие чтения были законны.
Как байты становятся текстом и откуда берётся BigInt
Текстовая сторона того же буфера имеет свою границу, которую границы atob и btoa разбирает для случая base64. Байты не текст, пока не названа кодировка, и одни и те же четыре байта декодируются двумя способами:
decode -> utf8=hié latin1=hié bytes=4
Четыре байта это 68 69 c3 a9. Прочитанные как UTF-8, они есть h, i и двухбайтовая последовательность для é, что даёт hié. Прочитанные как latin1, каждый байт это свой собственный символ, что даёт hié. Страница, которая декодирует поле с неверной меткой, получает правдоподобную строку вместо ошибки, поэтому протокол, который не называет свою кодировку, оставляет читателя угадывать между двумя допустимыми ответами.
Самые крупные поля нуждаются в собственных геттерах, и они меняют тип значения:
bigint -> value=18446744073709551615 mixed-add=TypeError
getBigUint64 вернул полное беззнаковое шестидесятичетырёхбитное значение как BigInt, что является единственным способом его представить, потому что Number теряет точность выше 2^53. Затем зонд добавил 1 к нему как Number и получил TypeError, что является отказом языка молча смешивать два числовых типа. Страница, которая читает шестидесятичетырёхбитное поле и хочет сравнить его с Number, должна конвертировать намеренно, и конверсия это место, где теряется точность, если она вообще происходит.
Знаковая форма, getBigInt64, важна по той же причине по другую сторону от нуля. Шестидесятичетырёхбитный счётчик, который переполняется, или знаковая метка времени из протокола, который допускает отрицательные значения, нуждаются в знаковом геттере, а чтение беззнаково превращает малое отрицательное в огромное положительное. Два геттера читают одни и те же восемь байтов и различаются только тем, как интерпретируется верхний бит, поэтому таблица полей, которая записывает "шестидесятичетырёхбитное целое" без знаковости, записала недостаточно, чтобы воспроизвести значение.
Есть ещё одна граница, которую стоит назвать. BigInt нельзя передать в сериализатор JSON, поэтому страница, которая читает шестидесятичетырёхбитное поле и пытается залогировать разобранный объект, выбрасывает исключение на поле, которое является BigInt, тогда как все остальные поля логируются нормально. Путь записи должен конвертировать намеренно, обычно в десятичную строку, и страница, которая пропускает конверсию, теряет всю строку лога, а не одно поле. Это та же форма, что и view со смещением: сбой громкий на точной границе, и запись должна назвать тип, чтобы это объяснить.
Записать бинарное чтение
Бинарное чтение поддерживает узкое утверждение: этот рантайм, этот буфер, это смещение и этот порядок байтов дали это значение. Пять полей сохраняют его проверяемым:
- Порядок байтов, с которым читалось каждое поле, потому что по умолчанию big-endian, а поле из little-endian файла читается с обратными байтами.
- Смещение и длину view, а не только буфера, потому что чтение за концом view выбрасывает исключение, даже когда у буфера есть место.
- Знаковость и ширину каждого целочисленного поля, потому что знаковое чтение беззнакового байта превращает
200в-56. - Ширину float, потому что
Float32иFloat64расходятся в значении, которое возвращают для одного и того же литерала. - Кодировку текста, потому что одни и те же байты это
hiéв UTF-8 иhiéв latin1.
Публичные источники
- MDN: DataView
- MDN: DataView.prototype.getUint32
- MDN: DataView.prototype.getBigUint64
- MDN: ArrayBuffer
- ECMAScript: DataView Objects
- BotBrowser: automation consistency reference
Практический вывод
Передавайте флаг порядка байтов при каждом чтении и записи, потому что по умолчанию big-endian, а поле из локального little-endian файла нет. Используйте DataView для заголовка со смешанными ширинами и типизированный массив для однородного блока, и помните, что собственные границы view решают, что может затронуть чтение. Называйте знаковость, ширину и кодировку текста для каждого поля и трактуйте чтение BigInt64 как отдельный тип, а не как крупный Number. Для самого view элементов читайте View над ArrayBuffer и типизированным массивом; для превращения байтов в строки читайте Границы atob и btoa.
Эта статья входит в руководство: Что такое отпечаток браузера?
Похожие статьи
ArrayBuffer и TypedArray: один буфер, много видов
ОтпечаткиTextDecoder и TextEncoder: байты против строк
ОтпечаткиICU: псевдонимы часовых поясов и TZ, который вы отдаете
ОтпечаткиНаблюдаемость криптографической случайности и отпечатки браузера
ОтпечаткиСортировка массива и компараторы: функция с изъяном
Отпечаткиbtoa и atob: границы Latin-1 и дополнение на практике
Переведите BotBrowser из исследований в продакшн
Используйте эти руководства, чтобы понять модель, а затем перейти к кроссплатформенной валидации, изолированным контекстам и масштабируемому браузерному развертыванию.