Источник случайности в crypto-js: ветка сборки
Прочитайте код crypto-js 4.2.0 и 3.1.2, затем измерьте, какой вызов энтропии делает каждая версия, сколько вызовов стоит запрос и что может изменить подставной объект crypto.
BotBrowser Team
Нужна структурированная документация по теме Отпечатки?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
BotBrowser может повторять разрешенный fixture на том же origin под объявленным профилем и сохранять ограниченные наблюдения о том, какой API вызвала страница и как часто, но он не может заглянуть в пул энтропии браузера, подтвердить качество случайности или превратить счетчик вызовов в признак личности. Этот разбор читает две опубликованные сборки crypto-js и затем измеряет наблюдаемую часть: какой источник энтропии привязывает каждая версия, сколько стоит один запрос и что может подменить тестовая заглушка.
Кратко
[email protected]обращается кcrypto.getRandomValuesна каждое слово, которое заполняет;[email protected]обращается кMath.random. Внешне API одинаков, поэтому различить их можно только по разрешенному источнику.- Один запрос
WordArray.random(n)делает примерноn / 4обращений к энтропии, поэтому 64 байта стоят шестнадцати обращений к объекту crypto, а не одного. - Цикл привязки в
core.jsприсваивает три глобальных значения без проверки, найдено ли что-то раньше.globalThis.cryptoперезаписывает заглушку наwindow.crypto, и поэтому набор тестов jsdom, который подменяет толькоwindow.crypto, видит ноль вызовов своей заглушки. - После загрузки модуля подмена метода на удерживаемом объекте crypto действует, а подмена всего объекта
globalThis.cryptoнет. - Заглушка, которая выбрасывает исключение, заставляет
4.2.0выдать собственную общую ошибку. КMath.randomон не откатывается.
Содержание
- Какой источник энтропии привязывает каждая сборка
- Сколько стоит один случайный запрос
- Где заглушка проигрывает более позднему глобальному значению
- Откуда берется шестнадцатеричный текст
- Что берет из источника шифрование по фразе
- Записывайте показания энтропии библиотеки
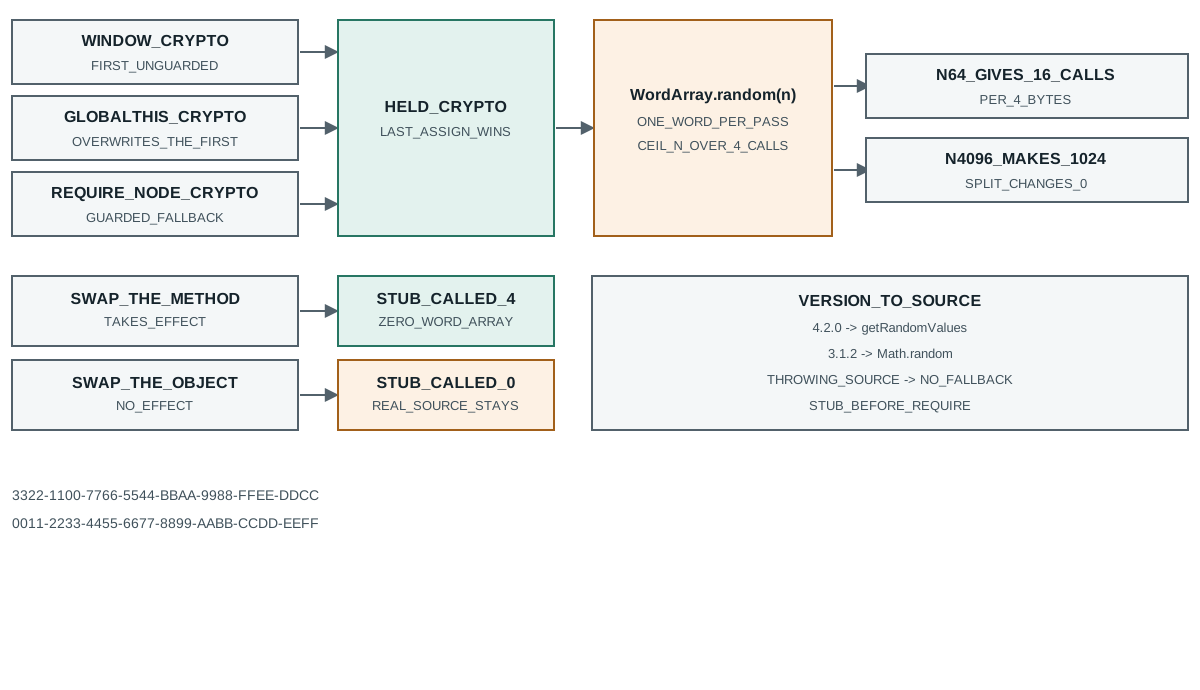
Какой источник энтропии привязывает каждая сборка
Опубликованный core.js из [email protected] начинается с объявления var crypto; и затем выполняет шесть присваиваний в фиксированном порядке. Порядок важнее комментариев рядом, потому что только последние три присваивания проверяют, найден ли уже источник.
// [email protected] core.js
if (typeof window !== 'undefined' && window.crypto) crypto = window.crypto;
if (typeof self !== 'undefined' && self.crypto) crypto = self.crypto;
if (typeof globalThis !== 'undefined' && globalThis.crypto) crypto = globalThis.crypto;
if (!crypto && typeof window !== 'undefined' && window.msCrypto) crypto = window.msCrypto;
if (!crypto && typeof global !== 'undefined' && global.crypto) crypto = global.crypto;
if (!crypto && typeof require === 'function') crypto = require('crypto');
У первых трех строк нет защиты, поэтому каждая может перезаписать результат предыдущей. В браузере self и window это один объект, так что вторая строка бессмысленно переписывает первую. В процессе Node, который вдобавок определяет объект window, третья строка перезаписывает и первую, и вторую значением globalThis.crypto. Защищенные строки тогда важны только если вообще ничего не нашлось.
Эта деталь объясняет результат теста, который иначе выглядит невозможным. Набор jsdom часто определяет globalThis.window = { crypto: заглушка }, чтобы управлять случайностью, затем загружает библиотеку и ждет вызовов заглушки. В современном процессе Node он не видит ни одного, потому что globalThis.crypto существует и третья незащищенная строка заменяет заглушку до того, как модуль закончит загрузку.
Измерение это подтверждает. Два дочерних процесса стартуют одинаково, кроме одной строки, и каждый считает вызовы заглушки и встроенного источника за один запрос WordArray.random(16):
window stub with globalThis.crypto present -> {"stubCalls":0,"allZero":false}
window stub with globalThis.crypto absent  -> {"stubCalls":4,"allZero":true}
В первом случае заглушка не получила ничего, а реальный объект crypto получил четыре вызова. Во втором, когда globalThis.crypto равен undefined до загрузки, заглушка получила все четыре и вернула массив слов целиком из нулей, что и должна давать заглушка, заполняющая нулевые байты.
Две версии библиотеки стоят по разные стороны одного API. Обе дают CryptoJS.lib.WordArray.random(nBytes), и полученный объект в обеих одинаков по форме, поэтому тест, который проверяет только sigBytes, проходит на любой. Инструментирование обоих источников в одном процессе их разделяет:
one call each in one process: getRandomValues=4 (v4.2.0) Math.random=4 (v3.1.2)
v3.1.2 random(16): Math.random=4
Четыре вызова getRandomValues для современной сборки и четыре вызова Math.random для 3.1.2 на один и тот же запрос в 16 байт. Старый помощник читает Math.random() и масштабирует его до 32-битного целого; новый просит у объекта crypto new Uint32Array(1) и берет нулевой элемент. Ни один путь заметно не медленнее для страницы, и ни один не меняет возвращаемый тип, поэтому номер версии в package.json остается единственным дешевым способом узнать, какая из них внутри собранного файла.
Сколько стоит один случайный запрос
Помощник слов заполняет одно 32-битное слово за проход, поэтому число итераций прямо следует за числом запрошенных байтов. Измерение объекта crypto вместо часов делает правило видимым:
v4.2.0 random(4) -> getRandomValues calls=1
v4.2.0 random(16) -> getRandomValues calls=4
v4.2.0 random(64) -> getRandomValues calls=16
Шестнадцать вызовов на запрос в 64 байта, а не один. Стоимость равна Math.ceil(n / 4) для положительного целого, а квота браузера применяется к каждому вызову, а не к запросу, поэтому практический предел это 16 384 вызова по четыре байта, а не 65 536 байт за один вызов. Задача, которая порождает много случайного материала в цикле, платит много маленьких проверок квоты вместо одной большой.
У этого правила есть прямое следствие для fixture, который хочет остаться внутри квоты. Четыре тысячи девяносто шесть байт стоят тысячи двадцати четырех обращений к объекту crypto, и разделение этого бюджета на восемь вызовов по пятьсот двенадцать байт стоит столько же, потому что каждый из них сам делится на сто двадцать восемь слов по четыре байта. Группировка на границе API не уменьшает число обращений к энтропии; это делает только общий объем байтов. Цикл, который порождает много материала ключа в тесте, дойдет до квоты при том же общем размере, просит ли он один массив или много.
Другая сторона того же правила это время. На измеренной машине тысяча запросов по тридцать два байта завершились за несколько миллисекунд, этого достаточно мало, чтобы стоимость цикла была незаметна рядом со стоимостью того, для чего материал используется. Поэтому именно счетчик вызовов, а не длительность, полезно записывать: длительность меняется с машиной и нагрузкой, а счетчик нет.
Дробные и некорректные размеры показывают границу цикла, и ни один из них не выбрасывает исключение:
random(0) -> words=0 sigBytes=0 hexLen=0
random(4) -> words=1 sigBytes=4 hexLen=8
random(4.5) -> words=2 sigBytes=4.5 hexLen=10
random(16) -> words=4 sigBytes=16 hexLen=32
random(-1) -> words=0 sigBytes=-1 hexLen=0
Отрицательный запрос возвращает пустой массив слов, у которого sigBytes равен -1, и шестнадцатеричный кодировщик выводит пустую строку вместо исключения. Код, который доверяет sigBytes как проверке длины, получает значение ложное, но не нулевое, то есть ровно то значение, которое проходит проверку if (words.sigBytes) и затем падает в сериализаторе.
Для корректного запроса длина вывода стабильна. Пять тысяч запросов по шестнадцать байт в одном процессе дали тридцать два шестнадцатеричных символа каждый раз:
5000 calls of random(16): hex length min=32 max=32
Эту стабильность стоит назвать, потому что она разделяет две вещи, которые тест может спутать. Фиксированная длина доказывает, что кодировщик согласован; она ничего не говорит о случайности за символами. Эти два утверждения требуют разных доказательств, и только первое дешево проверить.
Где заглушка проигрывает более позднему глобальному значению
Подмена источника случайности обычная практика для детерминированного набора тестов, и отказ незаметен: заглушка установлена, проверки проходят, а заглушку ни разу не вызвали. Два места ведут себя по-разному после того, как модуль уже загружен.
post-load swaps -> {"methodSwapAllZero":true,"objectSwapAllZero":false}
Замена getRandomValues на объекте, который библиотека уже удерживает, меняет следующий результат, и массив слов возвращается целиком из нулей. Замена globalThis.crypto на новый объект после этого не меняет ничего, потому что библиотека сохранила ссылку на объект, разрешенный при загрузке, и больше не смотрит на глобальное значение. Первая форма это то, что тест может использовать; вторая молча оставляет реальный источник на месте.
Порядок важен по той же причине. Набор, который задает globalThis.window.crypto и затем загружает библиотеку, борется с третьим незащищенным присваиванием. Задать или очистить globalThis.crypto до загрузки это то размещение, которое достигает цикла привязки в момент его выполнения.
Третье отдельное поведение это случай, когда объект crypto есть, но отказывает. Заглушка, чей getRandomValues всегда выбрасывает, дала это:
getRandomValues always throws -> threw: Native crypto module could not be used to get secure random number.
Библиотека поглощает исходную ошибку и выбрасывает свое простое сообщение. Исходное имя отказа уже не видно, когда его видит вызывающий код, поэтому странице, которая хочет отличить проблему квоты от отсутствующего источника, нужно проверять сам объект crypto, а не ошибку библиотеки. Столь же важно, что 4.2.0 в этом случае не откатывается к Math.random. Риск тихой деградации принадлежит 3.1.2, где Math.random это источник, а не запасной путь.
Вызывающий код все же может различить две поломки, не читая библиотеку. Проверьте, есть ли у объекта crypto getRandomValues, до запроса; если есть, выброшенная ошибка пришла от источника, а не от отсутствующей привязки. Эта проверка стоит одного чтения свойства и превращает неоднозначную ошибку в решение, что и нужно fixture, чтобы записать source-missing отдельно от source-refused.
Откуда берется шестнадцатеричный текст
Массив слов хранит 32-битные слова, и шестнадцатеричный кодировщик читает их от старшего байта к младшему. В этом шаге от версии ничего не зависит; меняется то, как группа из четырех байтов становится словом. Если пропустить одни и те же шестнадцать байтов энтропии через две трактовки, эффект становится виден: Та же граница группировки возникает, когда текст кодируют для передачи: границы btoa и atob показывают, как байтовая строка и строка символов расходятся, и почему шаг декодирования обязателен до совпадения текста.
entropy bytes: 00112233445566778899aabbccddeeff
WordArray(little-endian words, as the randomBytes branch) -> 3322110077665544bbaa9988ffeeddcc
WordArray(big-endian words)                               -> 00112233445566778899aabbccddeeff
endianness changes the hex: true
Оба запуска потребили одинаковые байты и дали разный текст. Разница в правиле группировки, а не в энтропии: одно чтение считает каждую группу из четырех байтов little-endian, другое big-endian, и кодировщик честно печатает то 32-битное значение, которое получил. Поэтому сравнение двух машин с разной группировкой сообщает о различии, не имеющем отношения к случайности.
Знаковая форма не добавляет второго различия. Слова -1146447480 и -1122868 и их беззнаковые эквиваленты 3148519816 и 4293844428 кодируются в одни и те же шестнадцать шестнадцатеричных символов, потому что кодировщик маскирует каждый байт:
signed words [-1146447480,-1122868] -> bbaa9988ffeeddcc
unsigned words [3148519816,4293844428] -> bbaa9988ffeeddcc
sign is lost in the hex: true
Именно поэтому ветка Node, которая читает четыре байта через readInt32LE() и может давать отрицательные слова, все равно согласуется с веткой браузера на little-endian машине. Измеренная машина сообщила little-endian, и на ней обе ветки образуют одинаковые слова из одинаковых байтов. На big-endian машине это было бы не так, потому что ветка браузера берет машинную трактовку элемента Uint32Array, а ветка Node явно фиксирует little-endian. Последняя фраза это чтение двух путей кода, а не измерение: здесь выполнялся только little-endian случай, а big-endian случай остается открытой проверкой для того, у кого есть такое железо.
Практический вывод для сравнения между машинами уже, чем кажется. Если две машины запускают одну сборку и обе little-endian, ветка не важна и шестнадцатеричный текст совпадает. Если версии различаются, меняется источник, и текст совпадает только случайно. Разница между двумя артефактами говорит, какая из двух переменных сдвинулась, только если порядок байтов записан рядом, а это еще одно поле, которое нужно записи.
Что берет из источника шифрование по фразе
У AES.encrypt две похожие формы входа, которые по-разному используют источник случайности. Если передать строку как ключ, библиотека выводит ключ и IV, и этот путь сначала создает соль. Если передать уже разобранный ключ с явным IV, вывод ключа пропускается полностью.
AES.encrypt(passphrase) -> getRandomValues calls=2
AES.encrypt(key+iv) -> getRandomValues calls=0
passphrase output header="Salted__" saltBytes=8
explicit key+iv deterministic across runs: true
Восемь байтов соли стоят двух вызовов, что соответствует правилу одного слова за проход. Строка вывода несет восемь байтов соли перед шифротекстом за фиксированным заголовком, поэтому два запуска с одной фразой и одним открытым текстом различаются только этими восемью байтами и всем, что из них выведено. Форма с явным ключом сделала ноль вызовов и дала одинаковый вывод в двух запусках, это свойство нужно детерминированному тесту и его не должно быть у сохраненного артефакта.
Два значения по умолчанию для вывода ключа тоже далеко разнесены по стоимости. Путь по фразе использует совместимый с OpenSSL вывод с одной итерацией по умолчанию, а отдельный помощник PBKDF2 использует 250 000:
EvpKDF keySize=12 iterations=1: 0.06 milliseconds
PBKDF2 default iterations=250000: 851 milliseconds
Обе цифры получены на одной машине и меняются с нагрузкой, поэтому считайте их порядком величины, а не эталоном. То, что они подтверждают, стабильно: выбор помощника по фразе для сохраненного артефакта покупает соль и быстрый вывод, а не медленный, а повышение числа итераций это отдельное решение, которое вызывающий код должен принять явно.
Записывайте показания энтропии библиотеки
Запись, которая выдерживает ревью, называет свои входы и свои границы. Шесть полей покрывают наблюдаемую часть без сохранения сгенерированного материала:
- Имя пакета и точная версия, плюс файл, который поставляет помощник слов, потому что порядок привязки это свойство этого файла.
- Счетчики вызовов по источникам,
getRandomValuesиMath.random, на запрос объявленного размера. - Размер запроса и полученный
sigBytes, чтобы счетчик можно было сверить с правилом одного слова за проход. - Порядок байтов машины, потому что он решает, совпадут ли две ветки в тексте.
- Ставилась ли заглушка до или после загрузки модуля и какой объект она заменила.
- Текст ошибки, полученный когда объект crypto отказывает, включая то, сохранилось ли исходное имя.
Эта запись это то, против чего набор тестов может утверждать, и она остается достаточно короткой для заметки на ревью. Чего она не может подтвердить, так это любое утверждение о качестве случайности, уникальности или о том, что страница сообщила бы о машине. Счетчик вызовов это форма, а не измерение энтропии, и стабильная шестнадцатеричная длина это свойство кодировщика, а не доказательство о стоящем за ним источнике. О контракте на стороне браузера, куда попадают эти вызовы, читайте наблюдаемость криптографической случайности и отпечатки браузера, а о закрепленном сборщике, который отделяет результаты по компонентам от собственного дайджеста, читайте сбор и происхождение FingerprintJS OSS.
Две привычки сохраняют честность чтения библиотеки во времени. Первое, повторяйте счетчик после любого обновления зависимости, потому что смена версии может поменять источник, не меняя API; это ровно разница между 3.1.2 и 4.2.0. Второе, записывайте проверку, которая провалилась бы при изменении порядка привязки, здесь это число вызовов заглушки с глобальным значением и без него. Запись, которая хранит только полученную длину, не обнаружит ни одного из двух изменений.
Публичные источники
- Исходный код crypto-js: core.js
- Выпуски crypto-js
- MDN: Crypto.getRandomValues
- Спецификация Web Cryptography API
- MDN: Math.random
Итоги
Прочитайте помеченный core.js той сборки, которую вы действительно публикуете, затем посчитайте вызовы, полученные каждым источником на запрос известного размера. Запишите версию, счетчики, порядок байтов и размещение заглушки. Считайте полученный текст результатом кодировщика, держите энтропию вне записи и повторяйте счетчик каждый раз, когда зависимость сдвигается.
Эта статья входит в руководство: Что такое отпечаток браузера?
Похожие статьи
Наблюдаемость криптографической случайности и отпечатки браузера
ОтпечаткиClient Hints Fingerprinting: HTTP-заголовки и идентичность
ОтпечаткиUnicode: четыре идентичности одного текста
ОтпечаткиЧто такое отпечаток шрифтов? Согласованность текста между платформами
ОтпечаткиBotD: какие детекторы действительно выполняются
ОтпечаткиКак hardwareConcurrency раскрывает реальные ядра вашего CPU
Переведите BotBrowser из исследований в продакшн
Используйте эти руководства, чтобы понять модель, а затем перейти к кроссплатформенной валидации, изолированным контекстам и масштабируемому браузерному развертыванию.