Сортировка массива и компараторы: функция с изъяном
Сортируйте фиксированные массивы: строковый порядок по умолчанию, мутация на месте, стабильная сортировка, куда попадают undefined и NaN, плохой компаратор и переполнение.
BotBrowser Team
Нужна структурированная документация по теме Отпечатки?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
BotBrowser поддерживает повтор authorized same-origin фикстуры под объявленным профилем и сохраняет ограниченные наблюдения о порядке, в который страница отсортировала массив, но он не может изменить, как среда реализует алгоритм сортировки, не может сделать компаратор согласованным, если он не согласован, и не превращает результат сортировки в сигнал идентичности. Этот обзор сортирует фиксированные массивы компаратором по умолчанию и явными компараторами, затем фиксирует, почему порядок по умолчанию это строковый порядок, почему сортировка мутирует на месте, как стабильная сортировка держит равные ключи в порядке вставки, куда попадают undefined и NaN, почему несогласованный компаратор дает неверный и тихий порядок, и почему компаратор вычитания переполняется на больших числах.
Кратко
- Сортировка по умолчанию превращает каждый элемент в строку и упорядочивает по единицам кода UTF-16, поэтому
[10,9,1,100].sort()дает[1,10,100,9], а не числовой порядок. sortмутирует массив на месте и возвращает ту же ссылку, поэтому тот, кто ждет копию, молча меняет источник.- Числовой компаратор
(a, b) => a - bдает[1,9,10,100], ожидаемый порядок, но компаратор вычитания переполняется, когда разрыв превышает диапазон двойной точности. - Сортировка стабильна, поэтому строки, что сравниваются равными, держат порядок вставки, то есть
bdacдля двух ключей, разбитых2,1,2,1. undefinedи дыры сортируют в конец; компаратор, возвращающийNaN, трактуется как0для этой пары, поэтому элемент держит относительную позицию.- Компаратор, который не согласован (не транзитивен), может дать неверный порядок без броска, потому что алгоритм предполагает, что компаратор это полный порядок.
toSortedвозвращает копию и оставляет источник нетронутым, это способ сортировать без мутации.
Содержание
- Почему порядок по умолчанию это строковый порядок
- Почему сортировка мутирует на месте
- Где стабильная сортировка держит равные ключи
- Куда попадают undefined и NaN
- Почему несогласованный компаратор дает неверный порядок
- Записывайте показания сортировки
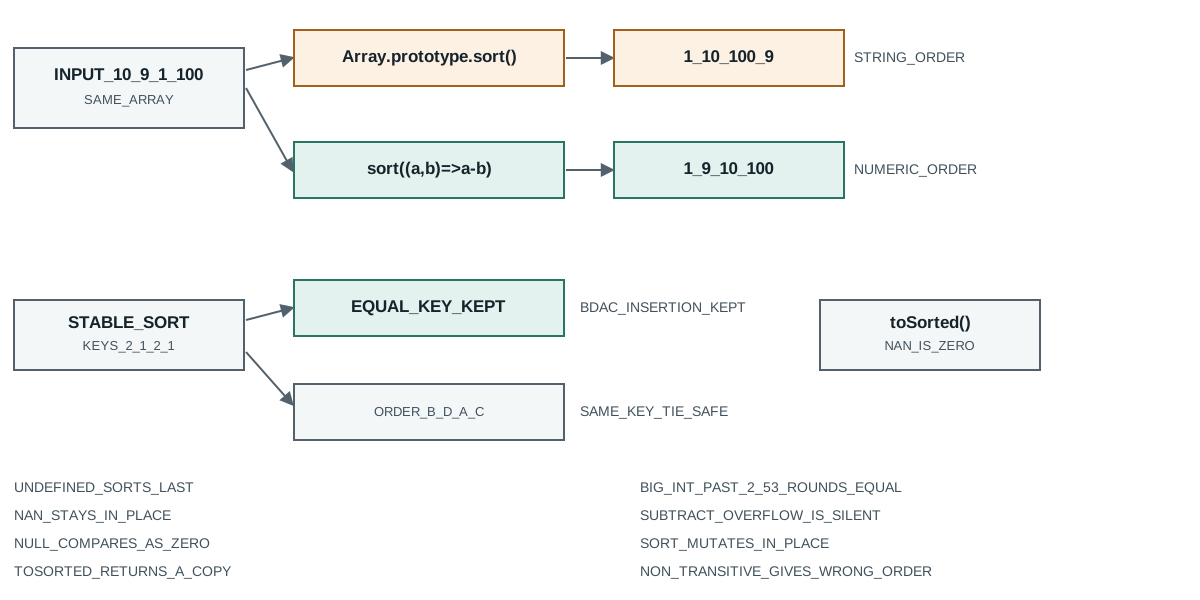
Почему порядок по умолчанию это строковый порядок
Array.prototype.sort без компаратора не сортирует числа как числа. Он превращает каждый элемент в строку и упорядочивает строки по единице кода UTF-16. Проба сортирует те же четыре числа обоими способами:
Array.sort=function node=v26.9.0
[10,9,1,100].sort() -> [1,10,100,9]
[10,9,1,100].sort((a,b)=>a-b) -> [1,9,10,100]
Сортировка по умолчанию возвращает 1, 10, 100, 9, потому что как строки "1" идет перед "10", который идет перед "100", который идет перед "9" по единице кода: первый символ каждой решает, а "9" больше "1", поэтому те четыре числа, что кончаются не на 9, идут первыми. Форма с компаратором возвращает 1, 9, 10, 100, ожидаемый числовой порядок. Оба вызова сортируют один массив и полностью расходятся, и только один совпадает с интуицией «отсортировано».
Этот разрыв есть самый частый дефект сортировки: разработчик вызывает sort() на массиве чисел, видит правдоподобный результат и никогда не замечает, что порядок лексикографический. Он выглядит верным для одной цифры и строк из одной цифры, и ломается в момент, когда появляется значение из двух цифр. Исправление всегда одно: передавать компаратор для чисел, никогда не полагаться на умолчание, потому что умолчание определено для строк и верно только случайно на малом входе.
Строковый порядок также объясняет, почему умолчание обрабатывает смешанные типы по их строковой форме. Проба сортирует смешанный массив из булева, числа и строки вместе, и порядок следует форме String() каждого элемента, а не правилу по типу. Тот, кто предполагает, что сортировка по умолчанию это «естественный порядок», получает порядок единиц кода, который для ASCII ставит заглавную перед строчной, а акцентированные буквы помещает после всей ASCII.
Проба делает порядок единиц кода явным на смешанном входе строк и булевых:
["b","a","C","á"].sort() -> ["C","a","b","á"]
[true,false,2,1].sort() -> [1,2,false,true]
Четыре строки сортируют в "C", "a", "b", "á", потому что заглавная C имеет меньшую единицу кода, чем строчная a, а акцентированная á имеет большую единицу кода, чем любая простая ASCII буква, так что она идет последней. Тот, кто ждет алфавитного порядка, поместил бы "á" рядом с "a" и, может быть, не ждал бы "C" перед "a", но сортировка по умолчанию не алфавитная и никогда этого не заявляет. Смешанный массив булевых и чисел сортирует в 1, 2, false, true, потому что "1" и "2" как строки идут перед "false" и "true", чьи первые буквы f и t имеют большие единицы кода, чем цифры.
Это поведение объясняет, почему сортировка по меткам из пользовательского ввода не может использовать умолчание. Две метки, что различаются только регистром, сортируют в чувствительный к регистру порядок, которого читатель не ждет, а метка, начинающаяся с цифры, сортирует перед любой меткой, начинающейся с буквы. Альтернативы с учетом локали, String.prototype.localeCompare и Intl.Collator, сортируют по правилам языка, а не по единицам кода, поэтому список, который читатель воспринимает как алфавитный, нуждается в одной из них, а не в умолчании. Запись, которая хранит отсортированный по умолчанию список меток, хранит порядок единиц кода, который воспроизводим, но не есть порядок, который читатель назвал бы сортированным.
Цена ошибки здесь это список, который стабилен и воспроизводим, но читается как несортированный для любого, кто на него смотрит. Панель, что сортирует имена аккаунтов компаратором по умолчанию, ставит каждый аккаунт с заглавной первой буквой перед каждым аккаунтом со строчной, и ставит акцентированные имена после всего блока ASCII, что не есть порядок, который оператор, просматривающий список, ждет. Порядок никогда не бросает, никогда не меняется между запусками на одном движке и молча не совпадает с намерением, что есть худшая комбинация, потому что ничто в тесте, что проверяет только «отсортировано ли», не поймало бы это, если только тест не кодирует то же неверное правило. Тест, написанный против компаратора по умолчанию, проходит; тест, написанный против ожидания читателя, падает, и они расходятся на каждом списке, что содержит смешанный регистр или акцентированное имя.
Есть и арифметическая причина, по которой порядок по умолчанию удивляет на близких по значению числах. Поскольку умолчание сравнивает строковые формы символ за символом, "2" и "20" сравниваются на первом символе и равняются там до того, как второй решит, поэтому список id 2, 20, 3 сортирует в 2, 20, 3 как строки, но читатель ждет 2, 3, 20 как числа. Чем длиннее общий префикс, тем позже решение и тем сильнее текстовый порядок расходится с числовым, поэтому дефект становится более заметным по мере того, как идентификаторы набирают цифры.
Компаратор по умолчанию также решает порядок объектов и массивов внутри массива, место, куда вызывающий редко смотрит. Любой объект превращается в строку "[object Object]", поэтому массив простых объектов, отсортированный компаратором по умолчанию, остается в порядке вставки, потому что каждый элемент сравнивается равным. Массив массивов превращает каждый внутренний массив в его элементы, соединенные запятой, поэтому внешняя сортировка упорядочивает по тексту внутреннего содержимого, а не по длине или полю. Тот, кто сортирует список записей компаратором по умолчанию и ждет стабильный, осмысленный порядок, получает порядок вставки для объектов и текстовый порядок для вложенных массивов, и ни один не есть задуманный порядок. Урок в том, что компаратор по умолчанию осмыслен только для массива примитивов, чьи строковые формы упорядочивают так, как хочет вызывающий, узкий случай, которого смешанный или структурный массив никогда не удовлетворяет.
У компаратора по умолчанию есть и форма производительности, которую вызывающий может не ждать. Превращение каждого элемента в строку стоит выделения на элемент на сравнение в худшем случае, а сортировка, что сравнивает ту же пару больше одного раза, повторяет эту работу, поэтому сортировка по умолчанию на большом числовом массиве медленнее компаратора, что вычитает. Медленность не есть дефект, но она есть симптом той же корневой причины: компаратор по умолчанию написан для сравнения строк, и числовой массив, прогнанный через него, платит стоимость превращения в строку на каждом сравнении за порядок, который вызывающий не хотел. Код, что переходит на числовой компаратор, получает и правильный порядок, и меньше работы, редкий случай, когда верная версия еще и быстрее.
Строковый порядок умолчания также объясняет, почему сортировка списка чисел, записанных как строки, кажется верной какое-то время. Список строк из одной цифры "1" до "9" сортирует в числовой порядок, потому что каждая строка это один символ и порядок единиц кода совпадает с числовым порядком для одной цифры. Дефект появляется только когда значение имеет две цифры, потому что тогда "10" сортирует перед "2" на первом символе. Фикстура, построенная из значений из одной цифры, поэтому проходит с сортировкой по умолчанию, и тот же код падает на производственных данных, что содержат значение десять или больше. Разрыв между проходящей фикстурой и падающим производственным случаем целиком о том, сколько цифр у значений, что сортировка никогда не сообщает.
Почему сортировка мутирует на месте
sort не является чистой функцией своего входа: он переупорядочивает массив, на котором вызван, и возвращает тот же массив. Проба сортирует массив из трех элементов и проверяет, то же ли возвращенное значение, что и объект источника:
same reference -> true; array now [1,2,3]
Возвращенный массив это та же ссылка, что вход (result === arr равно true), и массив источника теперь 1, 2, 3. Тот, кто пишет const sorted = arr.sort(), а затем использует arr в другом месте, молча переупорядочил arr, потому что sorted и arr один объект. Это реальный дефект в коде, что держит исходный порядок для отображения и также хочет отсортированную копию, потому что сортировка разрушила исходный порядок на месте.
Способ сортировать без мутации это toSorted, который возвращает новый массив и оставляет источник нетронутым. Проба подтверждает разницу: после toSorted источник все еще 3, 1, 2, а возвращенный массив 1, 2, 3, и это разные ссылки. Тот, кто хочет и исходный порядок, и отсортированный вид, нуждается в toSorted или явном slice() перед sort, а не в sort на оригинале.
Эта мутация также объясняет, почему сортировка внутри рендера опасна. Если компонент сортирует массив общего состояния, чтобы его показать, сортировка мутирует состояние на каждом рендере, и последующее чтение состояния видит отсортированный порядок вместо порядка, в котором оно было загружено. Исправление то же: сортируйте копию, и записывайте, какой массив тронула сортировка, чтобы читатель знал, есть ли наблюдаемый порядок сохраненный порядок или временная сортировка.
Пример toSorted выше уже показывает безопасную альтернативу, и она окупается, как только исходный порядок важен. Тот, кому нужны и загруженный порядок, и отсортированный вид, использует toSorted или slice(), а затем sort, и источник остается как был загружен. Стоимость это одно выделение, ничтожное рядом со стоимостью массива состояния, что мутирует под компонентом, который предполагал, что владеет порядком.
Есть связанная ловушка в компараторе, что сортирует по полю, которое может отсутствовать. Компаратор, что читает a.key - b.key на элементе, чье key равно undefined, дает NaN, которое сортировка трактует как равно, поэтому элемент держит относительную позицию вместо перехода в определенный слот. Результат это порядок, где строки с отсутствующим полем остаются вперемешку со строками, с которыми их сравнивали, что выглядит отсортированным на первый взгляд и не является. Исправление в том, чтобы решить, где принадлежит отсутствующее поле, сортировать его в конец явной ветвью и записать это решение, потому что сортировка сама его не сдвинет.
Эта мутация на месте также делает ненадежной сортировку, составленную с другой мутацией. Если вызывающий сортирует один массив, а затем делает splice второго, и оба делят элементы по ссылке, splice читает порядок, что оставила сортировка, который может не быть порядком, что вызывающий предполагал, что общий массив все еще имеет. Сортировка на месте это запись в общую память всякий раз, когда объект массива общий, и запись, что не говорит, был ли массив общим, клонированным или свежепостроенным, не может знать, увидело ли последующее чтение отсортированный порядок или порядок до того, как другой код его сбросил.
Идентичность ссылки также объясняет, почему проверка равенства после сортировки может обмануть. Тот, кто сравнивает отсортированный массив с самим собой, чтобы доказать «ничего не изменилось», находит их равными, потому что сортировка вернула тот же объект, хотя содержимое изменилось. Тест, что хочет доказать, что сортировка оставила источник нетронутым, должен сравнивать с копией, взятой до сортировки, а не с той же ссылкой, потому что равенство ссылки верно, мутировала сортировка или нет. Вариант toSorted снимает двусмысленность, возвращая отдельный объект, поэтому проверка ссылки различает «вернулась копия» и «источник был перезаписан».
Мутация на месте также меняет смысл имени переменной, что обещает порядок. Константа с именем insertionOrder, переданная в sort и затем прочитанная, больше не хранит порядок вставки, потому что сортировка переписала массив за именем. Имя лжет о содержимом, и читатель, что доверяет имени, читает отсортированный порядок там, где код задумывал порядок прибытия. Поскольку мутация невидима в месте вызова, когда возвращенное значение игнорируется, ничто в коде, что читает имя, не показывает, что порядок изменился, и запись, что хранит массив под этим именем, хранит отсортированный порядок под меткой, что утверждает обратное.
Самый безопасный шаблон это сортировать только внутри функции, что потребляет отсортированный результат, и передавать клон в эту функцию, когда источник важен в другом месте. Функция, что принимает массив и возвращает его отсортированный порядок, должна либо документировать, что сортирует на месте, либо возвращать toSorted, и вызывающий должен решить один раз, можно ли менять массив источника. Код, что смешивает оба, сортируя на месте в одном месте и полагаясь на исходный порядок в другом, производит дефект, что зависит от порядка вызовов, самый трудный для воспроизведения, потому что он падает только когда два вызывающих выполняются в определенной последовательности.
Мутация также взаимодействует с поверхностной копией так, что удивляет того, кто думает, что копии достаточно. slice() копирует массив ссылок, но не элементы, поэтому сортировка копии по полю переупорядочивает ссылки без мутации элементов, и исходный массив держит свой порядок тех же ссылок. Это безопасно для порядка массива, но если сортировка затем пишет в элементы, чтобы записать отсортированную позицию, запись достигает общих элементов, и элементы исходного массива меняются хотя его порядок нет. Различие между «порядок массива изменился» и «элементы изменились» это ровно то различие, что нужно записи, и ни sort, ни slice один не говорит, какое случилось.
Замороженный массив это единственный случай, когда мутация на месте падает громко. Сортировка массива Object.freeze бросает в строгом режиме вместо тихого переупорядочивания, что есть единственный способ, которым мутация объявляет себя как запись. Код, что хочет гарантировать, что никогда не мутирует общий массив, может заморозить его в разработке, так случайный sort бросает вместо того, чтобы оставить тонкое переупорядочивание, и затем использовать toSorted там, где порядок действительно нужен. Заморозка это дешевый способ превратить тихую мутацию в громкую, та же сделка, что делает запись, когда хранит, мог ли источник меняться.
Где стабильная сортировка держит равные ключи
Сортировка стабильна: элементы, что сравниваются равными, держат свой относительный порядок вставки. Проба сортирует четыре строки с двумя разными ключами и проверяет порядок строк с равным ключом:
stable sort -> bdac
Строки входа это a (ключ 2), b (ключ 1), c (ключ 2) и d (ключ 1). После сортировки по ключу по возрастанию порядок b, d, a, c: две строки с ключом 1 держат b перед d, и две с ключом 2 держат a перед c. Каждая группа с равным ключом сохранила порядок вставки, что есть то, что значит «стабильна» и что позволяет сортировать по первичному ключу, затем по вторичному, и получать ожидаемый составной порядок.
Стабильность не всегда была гарантирована; старые движки использовали нестабильные алгоритмы, и вторичная сортировка могла перемешать первую. Спецификация теперь требует стабильной сортировки, поэтому код, что на нее полагается, верен на любом текущем движке. Практическое следствие в том, что поток «сортировать по столбцу, затем по другому столбцу» безопасен только потому, что сортировка стабильна, и запись, что хранит результат одной сортировки, не может отличить стабильный исход от нестабильного без записи также порядка до сортировки строк с равным ключом.
Стабильный порядок также делает ненужным многоключевой компаратор во многих случаях. Вместо компаратора, что сравнивает ключ A затем ключ B, вызывающий может сортировать по B сначала и A затем, полагаясь на стабильность, чтобы держать порядок B внутри равных значений A. Оба подхода дают один порядок, когда компаратор согласован, и версия в две прохода читается легче, но верна только потому, что сортировка стабильна.
Гарантия стабильности также решает, что может обещать таблица «сортировать по столбцу» после второго клика. Таблица, что сначала сортирует по одному столбцу, затем по другому, полагается на стабильность, чтобы держать первый порядок внутри второго, и если бы движок не был стабилен, второй клик разбросал бы первый порядок и таблица показала бы порядок без смысла, который ни один заголовок столбца не описывает. Поскольку спецификация теперь требует стабильности, составной порядок держится на любом текущем движке, но запись, что хранит только конечный порядок и не последовательность сортировок, не может доказать, что составной порядок выведен так, как таблица заявляет.
Есть более тонкое следствие для компаратора, что стабилен, но не согласован. Стабильная сортировка сохраняет порядок элементов, что компаратор называет равными, поэтому компаратор, что ошибочно называет равными два неравных элемента, держит их в порядке, в котором они пришли, что может выглядеть правдоподобно и быть неверным. Стабильность делает неверный порядок похожим на намеренный, потому что стабильная сортировка никогда не перемешивает равные элементы, поэтому дефект прячется за самой гарантией, что заставляет работать многоключевые сортировки. Запись, что захватывает порядок до сортировки элементов, которые компаратор мог бы уравнять, есть единственный способ отличить верный составной порядок от стабильной сортировки на сломанном компараторе.
Стабильность также решает, есть ли сортировка на уже отсортированных данных no-op. Сортировка в две прохода по A затем B, запущенная на данных, уже в порядке A, оставляет порядок A нетронутым внутри равных значений B, поэтому повторный запуск тех же двух проходов ничего не меняет. Один компаратор, что читает только B, запущенный на тех же данных, переупорядочивает строки по B и тянет равенства A в порядок B, иной результат от версии в две прохода, хотя оба «отсортированы по B». Какой верен, зависит от того, хотел ли вызывающий вторичный ключ, и стабильная сортировка это то, что заставляет версию в две прохода значить то, чем она кажется.
Для записи порядок до сортировки равных ключей это поле, что превращает стабильный результат в воспроизводимый. Конечный отсортированный массив один не говорит, какой из двух элементов с равным ключом пришел первым, потому что оба порядка суть допустимые исходы стабильной сортировки на одном входе по порядку прибытия. Только порядок до сортировки плюс компаратор плюс гарантия стабильности закрепляют результат, и запись, что хранит конечный массив без порядка до сортировки, сохранила один из нескольких допустимых исходов и назвала его исходом.
Стабильность также важна для дедупликации, что следует за сортировкой. Код, что сортирует массив и затем убирает соседние дубликаты, чтобы держать «первый» каждой серии, полагается на стабильность, чтобы держать в начале каждой серии элемент, пришедший первым. На стабильном движке первый пришедший элемент выигрывает дедупликацию, и на нестабильном мог бы выиграть другой, что меняет выжившее значение. Поскольку сортировка теперь стабильна, первый пришедший элемент всегда выживает, и запись, что хранит дедуплицированный результат без порядка до сортировки, не может сказать, какой элемент остался и почему.
Составная сортировка в две прохода имеет стоимость, которую один компаратор прячет. Сортировать дважды прогоняет алгоритм дважды, и второй проход переупорядочивает весь массив по первичному ключу, пока стабильность сохраняет вторичный порядок внутри равенств. Один компаратор, что сравнивает первичный затем вторичный, делает работу в один проход и дает тот же результат, но он должен сам справляться со вторичным сравнением и оставаться согласованным на трех полях, что теперь сравнивает. Какой бы подход код ни выбрал, запись должна сказать, какой использован, потому что результат в две прохода и результат в один проход на одних данных совпадают только когда компаратор есть согласованный полный порядок на составном ключе.
Стабильность также делает безопасной постраничную сортировку. Сервер, что возвращает вторую страницу отсортированного списка, полагается на стабильный порядок, чтобы строки второй страницы не повторяли строку с первой, когда две строки равняются по ключу сортировки. Без стабильности порядок равенства произволен по странице, и строка может появиться на обеих страницах или ни на одной, классический баг пагинации, который никакая ошибка не сообщает. Стабильная сортировка делает порядок равенства детерминированным в одном проходе, но между двумя отдельными запросами порядок равенства зависит от порядка, в котором сервер прочитал строки, поэтому стабильная сортировка клиента не может спасти страницу, что сервер построил с нестабильным порядком. Запись должна захватить, какая сторона сортировала и была ли эта сторона стабильной.
Куда попадают undefined и NaN
undefined, дыры массива и NaN не ведут себя как обычные числа под сортировкой, и проба показывает, куда идет каждый:
[3,undefined,1].sort() -> [1,3,null]
[3,undefined,1].sort((a,b)=>a-b) -> [1,3,null]
[1,null,3].sort((a,b)=>a-b) -> [null,1,3]
[3,NaN,1].sort((a,b)=>a-b) -> [3,null,1]
Напечатанный null в первых двух строках это взгляд сериализатора: JSON.stringify отображает слот массива, что хранит undefined (после сортировки, что толкнула его в конец), как null, потому что массив не может хранить undefined в JSON. Хранимое значение это undefined в конце, и сортировка толкнула его туда, потому что сортировка по умолчанию трактует undefined как больше любого определенного элемента и всегда сортирует его последним. Форма с компаратором делает то же, поскольку спецификация отправляет undefined в конец независимо от компаратора.
Строка null это настоящее значение: null сравнивается как 0 под a - b, поэтому [1, null, 3] сортирует в null, 1, 3, с null в начале, как если бы он был нулем. Строка NaN самая острая: NaN в сравнении с любым другим значением возвращает NaN, что сортировка трактует как 0, поэтому NaN не двигается относительно элементов, с которыми сравнивался, и массив держит свой порядок 3, NaN, 1. Компаратор, что возвращает NaN для всей сортировки, трактуется как «равно» для каждой пары, поэтому порядок сохраняется.
Эти два поведения объясняют, почему запись отсортированного должна назвать, хранит ли она undefined, дыры или NaN. Отсортированный список чисел, что молча содержит NaN, не сортирует в числовой порядок, что ждет читатель, потому что NaN остается где был, и остальное сортирует вокруг него. Запись, что хранит только напечатанный массив, с NaN, уже превращенным сериализатором в null, не может быть перезапущена в тот же порядок без знания, что NaN там был.
Строка NaN также меняет, как сортировка сочетается с фильтром. Код, что сортирует, затем фильтрует головной элемент, полагается на сортировку, что поставит известный элемент в голову; если массив содержит NaN, что остался на месте, головной элемент не минимум, и фильтр удаляет не тот элемент. NaN остается где был вставлен, и сортировка его там оставляет, поэтому голова отсортированного массива это наименьший из элементов, что сортировка реально сдвинула, что может быть иным элементом, чем минимум всего массива. Запись, что отмечает наличие NaN, есть то, что позволяет читателю знать, что головной элемент не обязательно минимум, и код, что фильтрует до сортировки, избегает ловушки целиком.
Случаи undefined, дыры и NaN делят один урок для фикстуры: тестируйте массив так, как он реально приходит, а не как он выглядит после шага очистки. Фикстура, что предварительно сортирует очищенный массив, проходит, и тот же код на массиве с undefined в конце или бродячим NaN ведет себя иначе без броска. Шаг очистки скрывает именно тот вход, что сортировка обрабатывает специально, и запись, что хранит очищенный массив, сохранила версию, что сортировка трактует как обычную, а не ту версию, что ей дает производственный путь.
Взаимодействие undefined и компаратора стоит еще одного шага, потому что оно решает, ведет ли себя компаратор на смешанных значениях как умолчание или нет. Компаратор, что складывает или вычитает определенное значение и undefined, дает NaN, и спецификация отправляет undefined в конец еще до того, как компаратор опрошен, поэтому арифметика не выполняется для этой пары. Это значит, что компаратор, что упал бы на undefined в простом цикле, безопасен внутри сортировки, потому что сортировка убирает элементы undefined сначала. Тот, кто префильтрует undefined из массива перед сортировкой, сделал работу, которую сортировка сделала бы и так, а тот, кто их оставляет, получает определенный, воспроизводимый результат вместо исключения.
Значение null это случай, что ведет себя ни как undefined, ни как число, что ждет читатель. null превращается в 0 под вычитанием, поэтому компаратор сортирует его в числовую голову, и тот, кто трактует null как «пропущено» и ждет его в конце, находит его в начале. Различие между «пропущено как undefined» и «пропущено как null» поэтому меняет результат сортировки, и запись, что хранит только напечатанный массив с обоими отображенными как null, не может сказать, какое представление использовал источник. Тот, кто перезапускает сортировку на хранимой форме, получает иной порядок от оригинала всякий раз, когда два представления были смешаны, потому что одно сортировало в конец, а другое в начало.
Почему несогласованный компаратор дает неверный порядок
Алгоритм сортировки предполагает, что компаратор описывает полный порядок: если он говорит, что a не больше b и b не больше c, тогда a не больше c, и a сравнивается равно самому себе. Компаратор, что это рушит, может дать неверный порядок без броска. Проба сортирует компаратором, что сравнивает только четность, и показывает и безобидный, и сломанный случай:
sort(()=>0) keeps order -> [3,1,2,5,4]
non-transitive comparator -> [2,4,6,8,10,1,3,5,7,9,11]
sort(() => 0) говорит, что каждая пара равна, поэтому алгоритм оставляет массив как был: 3, 1, 2, 5, 4. Это безобидно и предсказуемо. Нетранзитивный компаратор (a, b) => (a % 2) - (b % 2) говорит, что каждое четное число меньше каждого нечетного, но он не согласован: четное, нечетное и другое четное могут сравниваться по кругу. Результат 2, 4, 6, 8, 10, 1, 3, 5, 7, 9, 11 ставит все четные сначала и нечетные после, но внутри нечетной группы порядок 1, 3, 5, 7, 9, 11 и внутри четных 2, 4, 6, 8, 10 оказываются по возрастанию только потому, что вход был таким; иной вход может оставить четные перемешанными, и ничего не бросает.
Компаратор, что возвращает значение больше разрыва двойной точности между двумя числами, имеет тот же режим отказа от другой причины. Проба сортирует три значения вокруг 2^53 компаратором вычитания:
big subtract sort -> ["-9007199254740992","1","9007199254740992"]
2^53 это наибольшее целое, ниже которого каждое целое представимо точно как double, и целое на единицу выше не представимо, поэтому (2^53) - (2^53 + 1) не может равняться -1; оно округляется до 0, и компаратор сообщает два неравных числа как равные. Компаратор вычитания на этом диапазоне поэтому дает произвольный, но стабильный порядок вместо числового, и отказ тихий. Исправление в том, чтобы написать компаратор с явными ветвями меньше-чем и больше-чем, что возвращают -1, 1 или 0, а не вычитать.
Переполнение тихо так же, как строковый порядок тих, и стоит сказать, почему оба делят корень. Оба дефекта идут от доверия сравнению, что легко написать и неверно на части его входа: компаратор по умолчанию доверяет строковой форме числа, а компаратор вычитания доверяет тому, что разница помещается в double. Оба дают стабильный, не бросающий порядок, что выглядит отсортированным для входов, что разработчик тестирует, и расходится на входах, что важны, поэтому ни один не ловит тест, что проверяет только, что код запустился. Исправление для обоих в том, чтобы сделать сравнение явным и полным на реальном домене, и записать домен, чтобы последующий читатель знал, на каких входах компаратор валидирован.
Требование согласованности и требование переполнения встречаются в одном месте: компаратор должен определить полный порядок на значениях, что реально увидит. Компаратор, написанный для чисел, что получает NaN, null, undefined или строку, больше не полный порядок на своем входе, и сортировка даст порядок, что строгий тест сравнения отвергнет без броска. Лекарство в том, чтобы нормализовать входы перед сортировкой, или написать компаратор, что явно обрабатывает каждый тип, а затем записать, какие типы обработаны, потому что сортировка сама никогда не жалуется на компаратор, которому не может доверять.
Записывайте показания сортировки
Показания сортировки поддерживают узкое утверждение: эта среда, этот массив, с этим компаратором, произвели этот порядок. Шесть полей сохраняют их проверяемыми, и ни одно не предполагает, что массив числовой или что компаратор согласован:
- Компаратор, записанный как исходный текст или как выбор «по умолчанию», потому что сортировка по умолчанию упорядочивает по строке, а любой явный компаратор определяет свой порядок.
- Мутировала ли сортировка массив источника или вернула копию, потому что
sortмутирует на месте, аtoSortedвозвращает копию, и хранимый порядок без этого нельзя приписать правильному массиву. - Порядок до сортировки любой группы равных ключей, потому что стабильная сортировка его сохраняет, а хранимый результат один не показывает, какой равный элемент пришел первым.
- Хранил ли массив
undefined, дыры илиNaN, потому что они сортируют в конец или остаются на месте вместо следования числовому порядку, а сериализатор превращает их вnull. - Является ли компаратор согласованным полным порядком, потому что нетранзитивный или переполняющий компаратор дает неверный порядок без броска.
- Типы элементов, потому что смешанный массив сортирует по строковой форме каждого элемента под компаратором по умолчанию, а не по общему числовому порядку.
Чего такие показания не могут показать, так это ничего о том, как сервер или вторая среда отсортирует те же данные. Страница сортирует свой массив, но сервер, что возвращает предварительно отсортированный список, мог использовать иной компаратор, и стабильная сортировка клиента не может восстановить порядок, который сервер не отправил. О порядке ключей, что сериализатор дает объекту, Порядок ключей объекта показывает, почему целочисленные ключи сортируют в начало, а строковые держат порядок вставки, а о контейнере, что копия сохраняет, structuredClone против JSON показывает, какие типы выживают при глубокой копии и что обход через JSON обрушивает.
Две привычки сохраняют показания честными со временем. Во-первых, всегда передавайте явный компаратор для чисел и пишите его с ветвями меньше-чем и больше-чем, а не вычитанием, так большой разрыв не округлится до равенства. Во-вторых, записывайте, мутировала ли сортировка источник и каков был порядок равных ключей до сортировки, так хранимый порядок атрибутируем, а стабильный результат отличим от удачного.
Публичные источники
- MDN: Array.prototype.sort
- MDN: Array.prototype.toSorted
- MDN: стабильность сортировки
- ECMAScript: Array.prototype.sort
- MDN: Number.MAX_SAFE_INTEGER
- BotBrowser: справка по согласованности автоматизации
Итоги
Относитесь к компаратору как к части контракта данных: сортировка по умолчанию упорядочивает по строке и превращает [10,9,1,100] в [1,10,100,9], поэтому всегда передавайте явный числовой компаратор, написанный с ветвями меньше-чем и больше-чем, а не вычитанием, чтобы разрыв за пределами 2^53 не округлился до равенства. Знайте, что sort мутирует на месте, а toSorted возвращает копию, что сортировка стабильна, поэтому равные ключи держат порядок вставки, что undefined и дыры сортируют в конец, а NaN остается на месте, и что компаратор, что не есть согласованный полный порядок, дает неверный и тихий результат. Записывайте компаратор, мутировал ли источник, порядок до сортировки равных ключей и любой undefined, дыру или NaN, так хранимый порядок атрибутируем, а стабильный результат отличим от удачного.
Читать дальше
О порядке ключей, что сериализатор дает объекту, читайте Порядок ключей объекта; о том, какие типы контейнеров выживают при глубокой копии до того, как запустится хоть одна сортировка, читайте structuredClone против JSON.
Эта статья входит в руководство: Что такое отпечаток браузера?
Похожие статьи
Порядок ключей объекта: целые сортируют, строки стоят
ОтпечаткиРазбор URL и search params: что меняет обход
ОтпечаткиstructuredClone против JSON: что сохраняет глубокая копия
ОтпечаткиTextDecoder и TextEncoder: байты против строк
ОтпечаткиUnicode: четыре идентичности одного текста
Отпечаткиbtoa и atob: границы Latin-1 и дополнение на практике
Переведите BotBrowser из исследований в продакшн
Используйте эти руководства, чтобы понять модель, а затем перейти к кроссплатформенной валидации, изолированным контекстам и масштабируемому браузерному развертыванию.