btoa и atob: границы Latin-1 и дополнение на практике
Запустите btoa и atob на строках с акцентами, CJK и эмодзи, чтобы увидеть, где каждая бросает исключение, что возвращает atob, обязательно ли дополнение и что отклоняется.
BotBrowser Team
Нужна структурированная документация по теме Отпечатки?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
BotBrowser поддерживает повтор разрешенного fixture на том же origin под объявленным профилем и сохраняет ограниченные наблюдения о том, какой API кодирования вызвала страница и какое исключение она получила, но он не меняет то, как среда реализует btoa или atob, не может заставить кодировщик только для Latin-1 принять астральные символы и не превращает ошибку кодирования в отпечаток. Этот разбор запускает обе функции на строках с акцентами, CJK и эмодзи, а затем фиксирует, где каждая бросает исключение, что возвращает atob и какие входы декодируются без дополнения.
Кратко
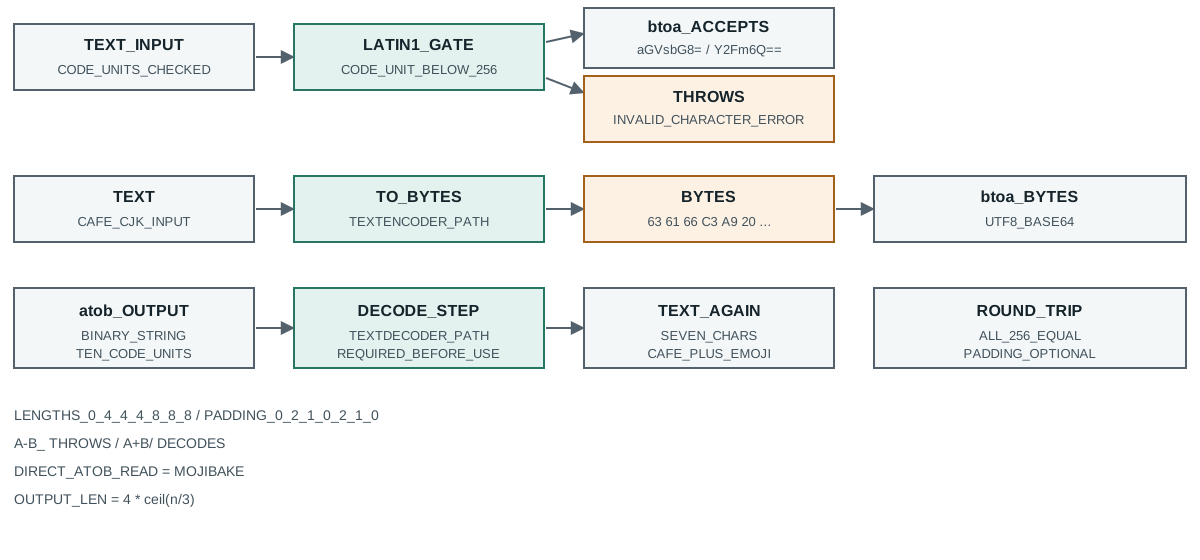
btoaпринимает только кодовые единицы меньше 256."café"кодируется,"ÿ"кодируется, а"Ā"(U+0100) и"😀"бросаютInvalidCharacterError.- Стандартный подход сначала переводит текст в байты через
unescape(encodeURIComponent(text)), а затем передает эти байты вbtoa. Результат тогда равен байтам UTF-8 исходной строки. atobвозвращает двоичную строку, а не текст. Прямое чтение дает искаженный текст; второй шаг декодирования возвращает те же байты к исходному тексту.atobпринимает вход без дополнения и отклоняет алфавит, безопасный для URL:"a-b_"бросает, а"a+b/"декодируется.- Длина вывода равна
4 * ceil(n / 3), поэтому 0-6 байт дают длины 0, 4, 4, 4, 8, 8, 8 с соответствующим дополнением.
Содержание
- Где btoa отклоняет вход
- Обертка, которая переводит текст в байты
- Что возвращает atob и зачем нужен второй шаг
- Дополнение, его отсутствие и алфавит, безопасный для URL
- Арифметика длины и полный обход всех байтов
- Записывайте показания кодирования
Где btoa отклоняет вход
Стандарт HTML определяет btoa над кодовыми единицами, и ограничение уже, чем ожидает большинство вызывающего кода. Каждая кодовая единица входной строки должна быть меньше 256, что значит, что проходит только текст Latin-1. Измерение на шести строках делает границу точной:
btoa("hello") -> ok aGVsbG8=
btoa("café") -> ok Y2Fm6Q==
btoa("ÿ") -> ok /w==
btoa("Ā") -> THREW InvalidCharacterError
btoa("😀") -> THREW InvalidCharacterError
btoa("中文") -> THREW InvalidCharacterError
Два результата удивляют. "café" кодируется без жалоб, потому что буква с акцентом в этом литерале это один код-пункт U+00E9, который меньше 256, так что исключение не срабатывает. "ÿ" это U+00FF, последняя кодовая единица, которая еще вписывается, и она тоже кодируется. Первый отказ это "Ā" на U+0100, сразу за границей, и исключение это InvalidCharacterError.
Строка с эмодзи показывает, почему отказ не про «не ASCII» как грубую категорию. Эмодзи вне базовой многоязыковой плоскости, поэтому хранится как суррогатная пара, и обе половины это кодовые единицы выше 255. btoa видит кодовую единицу 0xD83D и отказывает, еще не посмотрев на вторую половину. Кто проверяет только текстом Западной Европы («café» любимый пример), может выпустить путь, который работает в каждой ручной проверке и ломается в первый раз, когда приходит эмодзи или имя CJK.
Объект ошибки стоит записывать, потому что это единственный сигнал, который получает страница. Нет частичного вывода и нет возвращаемого статуса, поэтому код, оборачивающий btoa в блок try, может отличить нарушение Latin-1 от отсутствующей функции только по имени. Текст сообщения короткий и не задан стандартом, поэтому fixture должен проверять error.name, а не сообщение.
Ничто в этой границе не зависит от версии среды. Ограничение вписано в алгоритм, поэтому браузер и Node совпадают, и тест, который воспроизводит исключение в Node, воспроизведет его в браузере, выполняющем ту же страницу.
Есть вторая причина, почему границу легко прочитать неверно: строка с акцентом и строка с отказом выглядят одинаково на экране. "café" и "Ā" оба читаются как «буква с знаком», но один кодируется, а другой бросает, потому что решающее свойство это числовой код-пункт, а не визуальная форма. Составная é это один код-пункт меньше 256; составная Ā это один код-пункт выше; а разложенная é, записанная как e плюс комбинирующий акут, это два код-пункта, второй из которых U+0301 и все еще меньше 256, так что она тоже кодируется. Кто рассуждает по внешнему виду, а не по код-пунктам, предскажет неверный исход хотя бы в одном из трех случаев.
Поэтому API, ориентированный на байты, плохо сочетается с текстом из формы, буфера обмена или URL. Эти источники обычно дают разложенные формы, соединения нулевой ширины и последовательности эмодзи, и каждая меняет то, какие кодовые единицы доходят до btoa. Запись код-пунктов падающего входа, а не только его отрисованного текста, это то, что позволяет позднему читателю воспроизвести исключение.
Обертка, которая переводит текст в байты
Широко копируемая починка это идиома из двух шагов. encodeURIComponent превращает текст в строку с процентным кодированием байтов UTF-8, а unescape возвращает каждый %XX к представляемому им байту, оставляя строку, чьи кодовые единицы это ровно байты UTF-8. Передача этой строки в btoa дает Base64 от байтов UTF-8.
wrap("café") -> Y2Fmw6k= byteCount=5 btoaMatchesUtf8=true
wrap("😀") -> 8J+YgA== byteCount=4 btoaMatchesUtf8=true
wrap("中文") -> 5Lit5paH byteCount=6 btoaMatchesUtf8=true
Из этих строк следуют три факта. Счетчики байтов совпадают с длиной UTF-8, а не с длиной строки JavaScript: "café" это четыре кодовые единицы, но пять байтов, "😀" это две кодовые единицы, но четыре байта, а "中文" это две кодовые единицы, но шесть байтов. Полученный Base64 равен Base64 того же текста, закодированного собственным кодировщиком UTF-8 среды, что проба проверяет напрямую флагом btoaMatchesUtf8. И обертка никогда не бросает для этих входов, потому что к моменту запуска btoa каждая кодовая единица уже байт.
Идиома работает, и она также несет два риска, которые стоит назвать. unescape объявлен устаревшим, и линтер, настроенный на современный JavaScript, пометит его, так что кодовая база, применяющая это правило, не может использовать эту точную форму. И проход через процентное кодирование выделяет три промежуточные строки, что важно, если вызов сидит в горячем цикле, кодирующем тысячи малых значений. Современная замена строит байтовую строку через TextEncoder:
function btoaUtf8(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = '';
  for (const byte of bytes) binary += String.fromCharCode(byte);
  return btoa(binary);
}
Эта версия избегает unescape и дает тот же Base64, потому что TextEncoder выводит байты UTF-8 напрямую. Это та форма, которую стоит преподавать, поскольку устаревшая идиома выживает только потому, что предшествует TextEncoder в старых средах.
Что возвращает atob и зачем нужен второй шаг
atob это обратная к btoa, а не обратная к btoaUtf8. Она возвращает двоичную строку, чьи кодовые единицы это декодированные байты, и не знает и не заботится о том, что исходник был текстом UTF-8. Чтение этой двоичной строки так, будто это текст, это и есть дефект, дающий искаженный текст, и измерение показывает точные байты:
atob(b64) is a binary string of 10 code units: 63 61 66 c3 a9 20 f0 9f 98 80
  read as text directly -> "café ð.." equalToOriginal=false
  after escape/decode  -> "café 😀" equalToOriginal=true
Десять байтов, и каждый совпадает с кодировкой UTF-8 строки "café 😀": 63 61 66 это caf, c3 a9 это двухбайтовая последовательность для é, 20 это пробел, а f0 9f 98 80 это четырехбайтовая последовательность для эмодзи. Декодированные байты верны. Отказ происходит, когда код обращается с десятибайтовой двоичной строкой так, будто это исходник из десяти символов, которым она не является: у исходника семь символов, а счетчик байтов десять.
Этот разрыв объясняет, почему наивная реализация кажется работающей, пока не перестает. Для чистого ASCII один байт равен одному символу, поэтому atob с последующим прямым использованием дает верный ответ, и каждая проверка с английским текстом проходит. В момент, когда значение содержит многобайтовый символ, байтовая строка и текстовая строка расходятся, и код, пропустивший второй шаг, сохраняет испорченные данные. Проба делает порчу конкретной на строке CJK:
wrong-path round trip of "中文测试" -> "ä¸æ..." equal=false
Верный путь зеркалит кодировщик: взять двоичную строку из atob, восстановить байты и декодировать их как UTF-8. Устаревшая пара это decodeURIComponent(escape(binary)); современная строит Uint8Array из двоичной строки и запускает TextDecoder:
function atobUtf8(encoded) {
  const binary = atob(encoded);
  const bytes = Uint8Array.from(binary, char => char.charCodeAt(0));
  return new TextDecoder().decode(bytes);
}
Обе формы возвращают те же десять байтов к семи символам. Урок, который fixture должен записать, это то, что atob успешно выполнился в обоих случаях, поэтому проверка, утверждающая только «не бросил», не обнаружит искаженный текст. Запись должна сравнивать декодированный текст с исходным, а это другое утверждение, чем проверка, что вызов вернул.
Числовое сравнение делает разрыв невозможным упустить. Исходная строка имеет семь символов; двоичная строка из atob имеет десять кодовых единиц. Три лишние приходят целиком из двух многобайтовых символов, é добавляет один байт, а эмодзи добавляет два, всего три. Кто проверяет декодированное значение, сравнивая длины с исходным текстом, увидит несовпадение для каждой строки, содержащей любой символ вне ASCII, а кто пропускает сравнение, сохранит более длинную байтовую строку и заметит это только когда последующий парсер ее отвергнет.
Та же арифметика объясняет, почему дефект переживает случайное тестирование. Fixture, который кодирует и декодирует только "hello", видит пять байтов на входе, строку Base64 из восьми символов и пять символов на выходе, так что исходник и декодированный текст совпадают и обход выглядит точным. В момент, когда акцентный символ входит в значение, счетчик байтов и счетчик символов разделяются, и дефект появляется позже, а не в наборе тестов, который никогда не подавал не ASCII строку.
Дополнение, его отсутствие и алфавит, безопасный для URL
Base64 дополняет вывод до кратного четырем символами =, и вызывающий код часто предполагает, что декодер требует это дополнение. Измерение показывает, что atob принимает обе формы:
atob("aGVsbG8") -> ok "hello"
atob("aGVsbG8=") -> ok "hello"
Первая строка теряет финальный =, и atob все равно возвращает "hello". Эта снисходительность полезна, когда сервер убирает дополнение для более короткого URL, но она также значит, что декодер нельзя использовать для проверки, что вход был правильно дополнен. Если fixture должен отклонять вход без дополнения, эта проверка идет перед atob, а не внутри него.
Алфавит это другая история. Стандартный Base64 использует + и /; вариант, безопасный для URL, использует - и _. atob реализует только стандартный алфавит, поэтому символы, безопасные для URL, бросают:
atob("a-b_") -> THREW InvalidCharacterError
atob("a+b/") -> ok "kæÿ"
Вторая строка декодирует четыре символа в три байта, которые случайно образуют корректную строку из трех символов. Первая бросает на первом безопасном для URL символе, который встречает. Кто получает токен из URL, сегмента JWT или слага имени файла, держит тогда Base64, безопасный для URL, и передача его прямо в atob падает ровно на входах, использующих два замененных символа. Починка это перевод из двух строк перед декодированием: заменить - на + и _ на /, затем восстановить дополнение, если длина не кратна четырем. Этот перевод дешев, и его отсутствие частая причина «работает для некоторых токенов, падает для других», потому что короткий токен может не содержать ни одного замененного символа.
Арифметика длины и полный обход всех байтов
Длина вывода следует фиксированному правилу, по которому можно размера буфер или обнаружить усеченную строку без декодирования. Каждая группа из трех входных байтов становится четырьмя выходными символами, а финальная группа из одного или двух байтов дополняется до этой ширины:
bytes=0 base64Len=0 padding=0
bytes=1 base64Len=4 padding=2
bytes=2 base64Len=4 padding=1
bytes=3 base64Len=4 padding=0
bytes=4 base64Len=8 padding=2
bytes=5 base64Len=8 padding=1
bytes=6 base64Len=8 padding=0
Шаблон повторяется каждые три байта: кратное трем без дополнения, один оставшийся байт дает два =, а два оставшихся байта дают один. Так что длина вывода это 4 * ceil(n / 3), а счетчик дополнения (3 - n mod 3) mod 3. Вызывающий код может предсказать закодированный размер до кодирования, что важно, когда значение должно уместиться в лимит столбца или бюджет URL: каждые три байта стоят четыре символа, так что кодирование известного счетчика байтов имеет известный потолок.
Эта предсказуемость полезна не только для размера буфера. Поскольку закодированная длина это чистая функция счетчика байтов, декодер может отклонить усеченную строку без разбора: если значение утверждает, что кодирует определенное число байтов, но его длина не 4 * ceil(n / 3), что-то обрезали. Одно дополнение не надежный сигнал, так как atob принимает строку без дополнения, но общая длина все же ограничивает то, что строка может представлять.
Полный диапазон байтов замыкает круг. Кодирование всех 256 возможных значений байтов через btoa и декодирование обратно через atob возвращает строку, идентичную побайтово:
all 256 bytes via btoa/atob: byteIdentical=true length=256
Этот результат гарантия, которая реально нужна от пары: какие байты входят, такие возвращаются без изменений, для всего диапазона Latin-1, без потерь и подстановки. Он также показывает границу из предыдущего раздела в обратную сторону. btoa обрабатывает каждое значение байта от 0 до 255, поэтому текст Latin-1 кодируется, и отклоняет только кодовые единицы выше 255, поэтому любой текст вне Latin-1 нуждается сначала в переводе в байты. Две половины статьи описывают одну границу с противоположных сторон.
Записывайте показания кодирования
Запись кодирования, выдерживающая ревью, называет границу и доказывает ее. Шесть полей покрывают наблюдаемую часть, и ни одно не хранит секретное значение:
- Среда и имена функций, чтобы читатель знал, что результаты от стандартных
btoaиatob, а не от polyfill. - Точные строки, которые закодировались, и точные, которые бросили, с именем ошибки, чтобы граница Latin-1 была воспроизводима.
- Применялась ли обертка текст-в-байты и какой счетчик байтов она дала, в сравнении с собственным кодировщиком UTF-8 среды.
- Выполнялся ли шаг декодирования, и равен ли результат исходнику как текст, а не просто вернула ли
atob. - Алфавит в использовании, стандартный или безопасный для URL, и было ли дополнение.
- Счетчик байтов и полученная длина вывода, чтобы можно было сверить правило
4 * ceil(n / 3).
Чего такая запись не может показать, так это ничего о секретности данных. Base64 это кодирование, а не шифрование, и читатель может обратить его за один шаг, поэтому запись должна хранить равенство обхода и счетчики байтов вместо декодированного содержимого. О более широком вопросе, как обработка текста и кодирования страницы взаимодействует со строками, которые она сообщает, читайте нормализация Unicode и идентичности текста, а о том, как байтовые решения среды проявляются в другом API, читайте сравнение источников случайности в crypto-js.
Две привычки сохраняют честность чтения во времени. Первое, утверждайте по имени ошибки и счетчикам байтов, а не по тексту сообщения, потому что граница стандартизирована, а сообщение нет. Второе, включайте хотя бы одну не Latin-1 строку и один безопасный для URL токен в каждый fixture, который трогает эти функции, чтобы две самые частые тихие поломки не прошли зеленый набор тестов.
Публичные источники
- MDN: глобальная функция btoa()
- MDN: глобальная функция atob()
- Стандарт HTML: снисходительное декодирование base64
- RFC 4648: кодировки данных Base16, Base32 и Base64
- MDN: TextEncoder
Итоги
Проверьте, что каждая кодовая единица меньше 256, прежде чем вызывать btoa, и переводите текст в байты через TextEncoder, а не полагайтесь на вход. Считайте atob обратной к байтовой строке и всегда декодируйте результат обратно в текст перед использованием. Переведите Base64, безопасный для URL, в стандартный алфавит и восстановите дополнение, записывайте счетчики байтов и имя ошибки, и держите не Latin-1 строку и безопасный для URL токен в fixture, чтобы тихие поломки оставались видимыми.
Эта статья входит в руководство: Что такое отпечаток браузера?
Похожие статьи
Unicode: четыре идентичности одного текста
ОтпечаткиЧто такое отпечаток шрифтов? Согласованность текста между платформами
ОтпечаткиИсточник случайности в crypto-js: ветка сборки
Отпечаткиua-parser-js: Client Hints, боты и предел 500
ОтпечаткиНаблюдаемость криптографической случайности и отпечатки браузера
ОтпечаткиFingerprinting измерения текста: субпиксельное отслеживание
Переведите BotBrowser из исследований в продакшн
Используйте эти руководства, чтобы понять модель, а затем перейти к кроссплатформенной валидации, изолированным контекстам и масштабируемому браузерному развертыванию.