TextDecoder и TextEncoder: байты против строк
Декодируйте фиксированные байты с разными метками: псевдонимы, BOM, недопустимый байт, почему разрыв фрагмента теряет символ и почему различаются длины.
BotBrowser Team
Нужна структурированная документация по теме Отпечатки?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
BotBrowser поддерживает повтор authorized same-origin фикстуры под объявленным профилем и сохраняет ограниченные наблюдения о байтах, которые страница закодировала, и о строке, которую вернул декодер, но он не может заставить TextEncoder выдавать метку, отличную от UTF-8, не меняет декодер, в который разрешается метка, и не превращает результат декодирования в сигнал идентичности. Этот обзор декодирует фиксированный набор байтовых последовательностей с несколькими метками и фиксирует, какие метки являются псевдонимами, как обрабатывается маркер порядка байтов, когда режим fatal бросает исключение вместо замены, почему граница фрагмента теряет многобайтовый символ и почему длина в байтах и длина строки различаются для одного и того же текста.
Кратко
TextEncoderвсегда UTF-8 и игнорирует любую метку, переданную его конструктору;new TextEncoder({encoding:"latin1"}).encodingпо-прежнему печатаетutf-8.- Метки
latin1,iso-8859-1иwindows-1252разрешаются в один декодер, поэтомуcaféв байтах UTF-8 возвращается какcafé, и узнать, какая метка была записана, нельзя. - Маркер порядка байтов UTF-8 по умолчанию отбрасывается и сохраняется только с
ignoreBOM: true, поэтому одни и те же байты декодируются в одну строку или в две в зависимости от опции, которую почти никто не задает. - Нефатальное декодирование заменяет недопустимый байт на U+FFFD, а
fatal: trueбросаетTypeError; усеченная многобайтовая последовательность становится одним символом замены без ошибки. - Разбиение многобайтового символа между двумя вызовами теряет его, если не задан
stream: true, а потоковый результат склеивается с исходной строкой. - Одиночный суррогат кодируется в один U+FFFD, поэтому обход туда и обратно может изменить значение, хотя каждый вызов успешен;
caféэто четыре единицы UTF-16 и пять байтов UTF-8.
Содержание
- Какая метка в какой декодер разрешается
- Как обрабатываются маркер порядка байтов и недопустимая последовательность
- Почему граница фрагмента теряет символ
- Где расходятся длина в байтах и длина строки
- Записывайте показания кодека
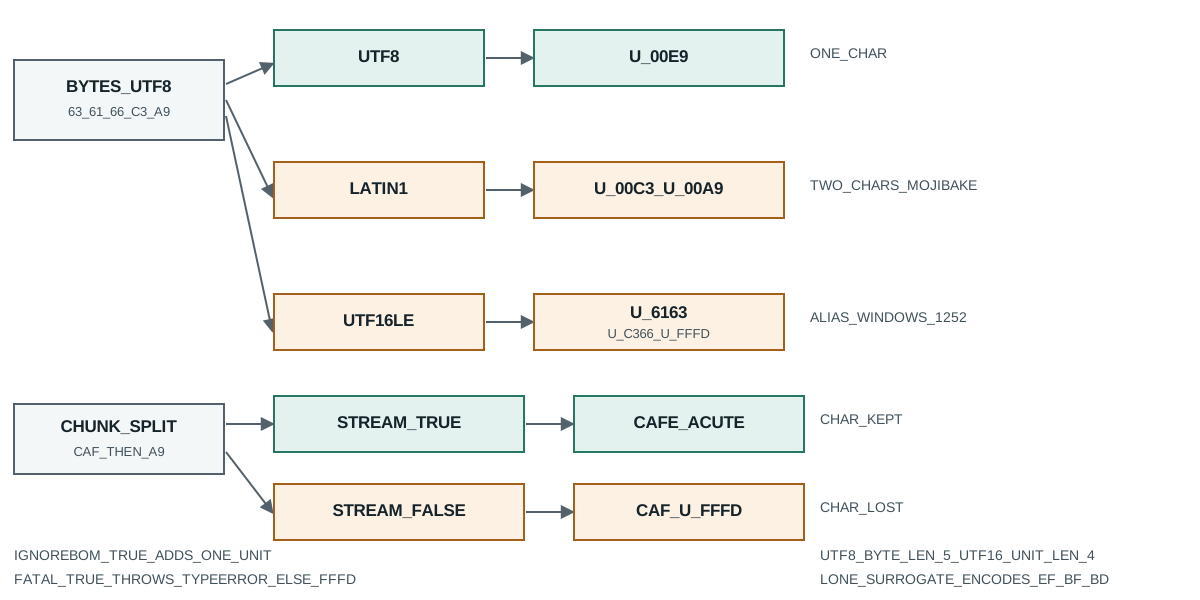
Какая метка в какой декодер разрешается
Конструктор принимает метку, а не точное имя кодировки, и стандарт отображает множество меток на один декодер. Проба декодирует пять байтов UTF-8 слова café (63 61 66 c3 a9) с четырьмя метками и печатает строку, которую возвращает каждая:
TextDecoder=function TextEncoder=function node=v26.9.0
TextEncoder.encoding = "utf-8"
encode("café") -> 63 61 66 c3 a9
encode("😀") -> f0 9f 98 80
new TextEncoder({encoding:"latin1"}) -> "utf-8"
new TextDecoder("utf-8").decode(0x63 61 66 c3 a9) -> "café"
new TextDecoder("latin1").decode(0x63 61 66 c3 a9) -> "café"
new TextDecoder("iso-8859-1").decode(0x63 61 66 c3 a9) -> "café"
new TextDecoder("windows-1252").decode(0x63 61 66 c3 a9) -> "café"
new TextDecoder("utf-16le").decode(0x63 61 66 c3 a9) -> "慣썦�"
В этих строках два факта. Во-первых, TextEncoder сообщает utf-8 независимо от переданной метки; у объекта просто нет другой кодировки, поэтому тот, кто пишет latin1 и ждет однобайтовый вывод, получает многобайтовый вывод и ни одного предупреждения. Во-вторых, три однобайтовые метки схлопываются в один декодер. latin1, iso-8859-1 и windows-1252 являются псевдонимами в таблице меток стандарта, и windows-1252 это декодер, в который разрешаются все три. Декодирование байтов UTF-8 любой из них читает каждый байт как символ, поэтому двухбайтовая последовательность c3 a9 становится двумя символами Ã и ©.
Этот схлопывание и есть источник классического дефекта неверно закодированного текста: производитель записал UTF-8, а потребитель объявил Latin-1, или наоборот. Дефект не является ошибкой одной стороны; это расхождение между меткой, которую использовал производитель, и меткой, которую предположил потребитель. Результат из двух символов детерминирован и обратим, поэтому повторное декодирование тех же байтов в UTF-8 точно восстанавливает café. Проверка, которая это ловит, состоит в сравнении декодированной строки с ожидаемым текстом, а не в сравнении длин в байтах, потому что обе формы неверно закодированного текста занимают одно и то же число байтов.
Четвертая метка показывает, чего стоит неверное семейство. utf-16le читает те же байты по два как 16-битные единицы little-endian, поэтому 63 61 становится одним символом, 66 c3 другим, а оставшийся a9 символом замены. Ничего не бросается. Тот, кто получает байты от источника, который действительно произвел UTF-16, и объявляет LE, получает строку, просто не ту, а тот, кто объявляет неверный порядок байтов для настоящего UTF-16, получает еще другую строку. Метка является частью контракта данных, поэтому фикстура, которая декодирует без записи метки, записала непроверяемый результат.
У этой строки есть и второе прочтение, не менее важное: декодер потребил нечетное число байтов. Декодер UTF-16 читает одну единицу на два байта, поэтому вход из пяти байтов оставляет один байт без пары, и декодер превращает одиночный байт в U+FFFD, а не отбрасывает его. Таким образом, количество символов в результате говорит кое-что о четности входа, хотя метка выглядела верной. Конвейер, который декодирует тело UTF-8 четной длины неверным двухбайтовым семейством, скроет этот сигнал, потому что четное число байтов не оставляет ничего лишнего, и замена, которая выдала бы расхождение, никогда не появляется. Расхождение метки дешево заметить только тогда, когда оно еще и ломает четность байтов, что является хрупким способом обнаружения.
Неизвестная метка это единственный случай, который падает громко, а не молча:
new TextDecoder("utf-99") -> THREW RangeError
Конструктор отвергает метку, которой нет в таблице стандарта, с RangeError, прежде чем прочитан хотя бы один байт. Именно на это фикстура должна полагаться при опечатке, потому что проблема называется при создании. Любое другое расхождение выше возвращает строку и идет дальше, поэтому единственная надежная защита от верной, но неверной метки это утвердить декодированное значение.
Как обрабатываются маркер порядка байтов и недопустимая последовательность
Маркер порядка байтов это три байта в начале данных UTF-8 (EF BB BF) или два в начале данных UTF-16 (FF FE для little-endian). Стандарт обрабатывает маркер UTF-8 особым образом: по умолчанию декодер убирает его из вывода, а с ignoreBOM: true оставляет. Проба показывает оба результата для одного входа:
decode(EF BB BF 41) default -> "A"
decode(EF BB BF 41) ignoreBOM:true -> "A"
decode(FF FE 41 00) as utf-16le -> "A"
Первая строка декодирует маркер, за которым следует байт 41 (A), и возвращает единственный символ A. Вторая возвращает два символа: невидимый U+FEFF, за которым следует A, поэтому result.length равен 2, а не 1. Сравнение двух строк терпит неудачу, сравнение их длин отличается на единицу, и ни одна не ошибочна; опция решила исход. Потребитель, который берет ignoreBOM из конфигурации, и производитель, который этого не делает, это ровно то расхождение, которое превращает одну правильную строку в две неравные.
Строка UTF-16 показывает маркер, обработанный по тому же правилу в другом декодере: FF FE это маркер little-endian, декодер его потребляет, а оставшиеся 41 00 декодируются в A. Декодер UTF-16, который ожидает другой порядок байтов, читает FF FE как одну единицу и производит другой первый символ, поэтому маркер и порядок байтов должны совпасть до того, как совпадет текст.
Недопустимая последовательность это отдельное от маркера решение, и его задает fatal:
decode(A FF B) non-fatal -> "A�B"
decode(A FF B) fatal -> THREW TypeError
decode(E4 B8) truncated -> "�"
Байт FF недопустим нигде в UTF-8. Без fatal декодер выдает один U+FFFD вместо него и продолжает, поэтому результат это A, символ замены, затем B: три символа на три входных байта, один из них заменен. С fatal: true те же байты бросают TypeError. Конвейер, который не должен получать испорченный текст, должен задать fatal, потому что нефатальный результат это допустимая строка, которая молча отличается от входа.
Усеченный случай удивляет больше всего. E4 B8 это первые два байта трехбайтового символа, и декодер не может его завершить в конце входа, поэтому выдает один символ замены. Ошибка не бросается, хотя данные были обрезаны. Поэтому проверка количества байтов проходит на усеченном входе: декодер всегда возвращает строку, и только значение показывает, что символ потерян.
Почему граница фрагмента теряет символ
Сетевой ответ, чтение файла и сообщение worker приходят фрагментами, а граница фрагмента может попасть в середину многобайтового символа. У TextDecoder есть два режима для этого, и проба разрезает пять байтов UTF-8 слова café после четырех байтов, так что первый фрагмент кончается на первом байте двухбайтового é:
stream split mid-sequence: first="caf" second="é"
non-stream split mid-sequence -> "caf�"
Путь без потока декодирует каждый фрагмент как целую единицу. Первый фрагмент это caf плюс байт c3, который начинает двухбайтовый символ, продолжения которого во фрагменте нет, поэтому декодер превращает одиночный c3 в один символ замены и возвращает caf, за которым следует U+FFFD. é исчез. Путь с потоком и stream: true удерживает конечный c3 вместо замены, поэтому первый вызов возвращает caf, второй получает a9 и возвращает é, и два результата склеиваются в café.
Поэтому любой декодер, который читает поток, должен передавать stream: true на каждом фрагменте, кроме последнего, и вызвать декодер еще раз без аргумента, чтобы слить хвост. Цикл, который декодирует каждый фрагмент без опции, теряет один символ на каждой границе, попадающей внутрь многобайтовой последовательности, и потеря молчаливая: общая длина уменьшается на одну или более единиц, и каждый вызов возвращает строку. Фикстура, которая сравнивает склеенный результат с исходной строкой, это ловит; фикстура, которая проверяет только то, что декодирование удалось, нет.
Тот же механизм появляется, когда страница читает ReadableStream и декодирует пошагово, и когда worker собирает сообщение заново. В обоих случаях исправление это одна и та же опция и финальный слив, а сбой без него это фиксированное число символов замены, равное числу разорванных последовательностей. Количество это полезная диагностика: один символ замены на границе фрагмента означает один разрыв, а серия из них означает, что фрагменты не были выровнены по ширине символа.
Финальный слив легко забыть, потому что каждый промежуточный вызов уже вернул строку. После последнего фрагмента декодер, который еще удерживает конечные байты, должен быть вызван один раз без входа, и только этот вызов выдаст символ, который завершают удержанные байты. Цикл, который останавливается после последнего фрагмента, оставляет хвост внутри декодера, поэтому склеенный вывод короче на символы, которые эти байты произвели бы. Фикстура, которая сравнивает склеенный вывод с исходным, ловит пропуск; фикстура, которая проверяет только то, что ни один вызов не бросил, нет, потому что ни один и не бросил.
Где расходятся длина в байтах и длина строки
TextEncoder пишет UTF-8, поэтому длина строки в байтах это ее длина в UTF-8, а не в UTF-16. Оба совпадают только для текста из символов ниже U+0080. Проба измеряет четыре строки обоими способами:
"hello" stringLength=5 byteLength=5
"café" stringLength=4 byteLength=5
"中文" stringLength=2 byteLength=6
"😀" stringLength=2 byteLength=4
Для hello пять символов ASCII стоят пять байтов, потому что каждая кодовая точка ASCII это одна единица и один байт. Для café четыре буквы стоят пять байтов, потому что é это одна единица UTF-16, но два байта UTF-8. Для двух символов CJK две единицы стоят шесть байтов, потому что каждый это три байта в UTF-8. Для эмодзи две единицы UTF-16 (суррогатная пара) стоят четыре байта, потому что одна кодовая точка выше базовой плоскости это четыре байта UTF-8. Лимит хранения, выраженный в байтах, и лимит отображения, выраженный в символах, поэтому расходятся на разный коэффициент для каждой письменности, и бюджет, написанный для ASCII, отвергает или принимает неверное количество не-ASCII текста.
Производитель этих байтов часто вид над ArrayBuffer, и ArrayBuffer и TypedArray показывает, почему те же восемь байтов сообщают длину в байтах 8 под Uint8Array, но длину в элементах 2 под Uint32Array, и почему сохраненный псевдоним subarray умирает, когда буфер источника повторно используется.
Случай суррогата несет второе расхождение, потому что одиночный суррогат не является допустимым текстом, и TextEncoder его переписывает:
encode(lone high surrogate) -> ef bf bd
round trip lone surrogate length=1 equal=false
Закодированные байты это ef bf bd, один U+FFFD, потому что у одиночного суррогата нет формы UTF-8. Декодирование этих байтов возвращает один символ замены, поэтому длина строки совпадает с длиной входа, равной одному, но значение отличается, и проверка равенства ложна. Обход туда и обратно может поэтому сохранить длину и одновременно изменить значение, и поэтому сравнение длин не является тестом обхода туда и обратно. Резка строки по произвольному индексу создает ровно эту форму, потому что разрез внутри суррогатной пары оставляет одну половину одиночной.
Записывайте показания кодека
Показания кодека поддерживают узкое утверждение: эта среда, эта метка, эта опция, этот вход произвели эту строку. Шесть полей сохраняют их проверяемыми, и ни одно не хранит текст, который декодер мог бы переинтерпретировать:
- Метка, переданная декодеру, и порядок байтов, который она подразумевает, потому что несколько меток это псевдонимы и одна метка может читать байты двумя способами.
- Вход как байтовая последовательность, а не как отрендеренный текст, потому что две разные байтовые последовательности могут рендериться одинаково и одна последовательность может читаться с несколькими метками.
- Был ли задан
ignoreBOM, потому что он меняет длину строки на единицу для тех же байтов. - Был ли задан
fatal, потому что он решает между брошенной ошибкой и замененным символом замены. - Был ли задан
streamна фрагмент и запускался ли финальный слив, потому что оба решают, выживет ли разорванный символ. - Длина в байтах UTF-8 и длина в единицах UTF-16, записанные отдельно, потому что два числа отвечают на разные вопросы об одном и том же тексте.
Чего такие показания не могут показать, так это ничего о байтах до их прихода. Декодеру дана байтовая последовательность; он не говорит, написал ли производитель UTF-8, Latin-1 или UTF-16, и расхождение между производителем и потребителем это самая частая причина неверно закодированного текста выше. О более широком вопросе, как страница сообщает текст, пришедший из другого слоя, читайте нормализация Unicode и сигналы идентичности текста, где описано, почему два начертания одного видимого текста сравниваются неравно, и границы btoa и atob, где описана более старый однобайтовый путь кодирования, который бросает на том же не-ASCII тексте, который UTF-8 принимает.
Две привычки сохраняют показания честными со временем. Во-первых, записывайте метку и опции вместе с декодированной строкой, а не строку одну, потому что голую строку нельзя вывести заново, не зная, какие опции ее произвели. Во-вторых, сравнивайте декодированное значение с ожидаемым и, для обхода туда и обратно, сравнивайте исходную строку с декодированным результатом, а не длины, потому что символ замены и исходная единица могут занимать одну длину, различаясь значением.
Публичные источники
- MDN: TextEncoder
- MDN: TextDecoder
- MDN: TextDecoderStream
- Стандарт WHATWG Encoding
- Приложение 15 стандарта Unicode: формы нормализации
- BotBrowser: справка по согласованности автоматизации
Итоги
Относитесь к метке как к части контракта данных: latin1, iso-8859-1 и windows-1252 разрешаются в один декодер, TextEncoder всегда UTF-8 и игнорирует любую переданную метку, а неизвестная метка это единственная, что бросает при создании. Выбирайте ignoreBOM осознанно и выбирайте fatal, когда испорченный текст не должен проходить молча. Декодируйте потоки с stream: true и сливайте хвост, иначе разорванный многобайтовый символ станет символом замены. Записывайте метку, байты, опции и обе длины отдельно и сравнивайте декодированное значение, а не длину, чтобы одиночный суррогат, кодируемый в один U+FFFD, не прошел зеленую проверку.
Читать дальше
Чтобы углубиться в текстовый слой, нормализация Unicode и сигналы идентичности текста дает несколько длин и порядков одной видимой строки, а границы btoa и atob дает более старый способ упаковать байты в строку и то, где он падает на не-ASCII тексте.
Эта статья входит в руководство: Что такое отпечаток браузера?
Похожие статьи
btoa и atob: границы Latin-1 и дополнение на практике
ОтпечаткиArrayBuffer и TypedArray: один буфер, много видов
ОтпечаткиUnicode: четыре идентичности одного текста
Отпечаткиua-parser-js: Client Hints, боты и предел 500
ОтпечаткиРазбор URL и search params: что меняет обход
ОтпечаткиKeyboard Layout API, локаль и конфиденциальность
Переведите BotBrowser из исследований в продакшн
Используйте эти руководства, чтобы понять модель, а затем перейти к кроссплатформенной валидации, изолированным контекстам и масштабируемому браузерному развертыванию.