ArrayBuffer и TypedArray: один буфер, много видов
Читайте один ArrayBuffer через Uint8Array, Uint32Array и DataView: байты против элементов, slice копирует и subarray делит, порядок байтов и transfer отсоединяет источник.
BotBrowser Team
Нужна структурированная документация по теме Отпечатки?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
BotBrowser поддерживает повтор authorized same-origin фикстуры под объявленным профилем и сохраняет ограниченные наблюдения о байтах, которые страница прочитала через вид, и о числах, которые она произвела, но он не может изменить порядок байтов хоста, против которого читает DataView, не может заставить копию и псевдоним вести себя одинаково и не превращает длину вида в сигнал идентичности. Этот обзор берет один ArrayBuffer и читает его через Uint8Array, Uint32Array и DataView, затем фиксирует, почему те же восемь байтов несут три разные длины, почему slice копирует, а subarray делит буфер, чем отличаются чтение big-endian и чтение little-endian одних и тех же байтов, как ведут себя доступ вне диапазона и целочисленное переполнение, и как transfer оставляет источник отсоединенным.
Кратко
- У буфера в 8 байтов
.byteLengthравно 8 для любого вида, ноUint8Array.lengthравно 8,Uint32Array.lengthравно 2, аFloat64Array.lengthравно 1; длина считает элементы, а не байты. - Все три вида делят одни и те же байты, поэтому запись через один видна через другие, потому что они обертывают один буфер, а не копируют его.
sliceвозвращает копию на новом буфере, поэтому запись в нее оставляет источник неизменным;subarrayвозвращает вид на том же буфере, поэтому запись в него меняет источник.DataView.setUint32(0, 0x01020304, false)пишет01 02 03 04, и чтение тех же байтов big-endian дает0x01020304, а little-endian дает0x04030201.Uint32Arrayчитает в порядке хоста, который на этой машине little-endian, поэтому те же байты дают0x04030201, совпадая с little-endian чтениемDataView, а не с big-endian.- Запись вне диапазона отбрасывается, а чтение вне диапазона равно
undefined;Uint8Arrayдает 0 для 256,Int8Arrayдает -56 для 200, аUint8ClampedArrayограничивает 300 до 255. buffer.transfer(4)отсоединяет источник (byteLengthстановится 0) и возвращает копию в 4 байта; использование отсоединенного источника бросаетTypeError.
Содержание
- Почему у одного буфера три разные длины
- Почему slice копирует, а subarray делит буфер
- Как те же байты читаются big-endian и little-endian
- Где оказываются доступ вне диапазона и переполнение
- Где окно вида и transfer меняют источник
- Записывайте двоичные показания
Почему у одного буфера три разные длины
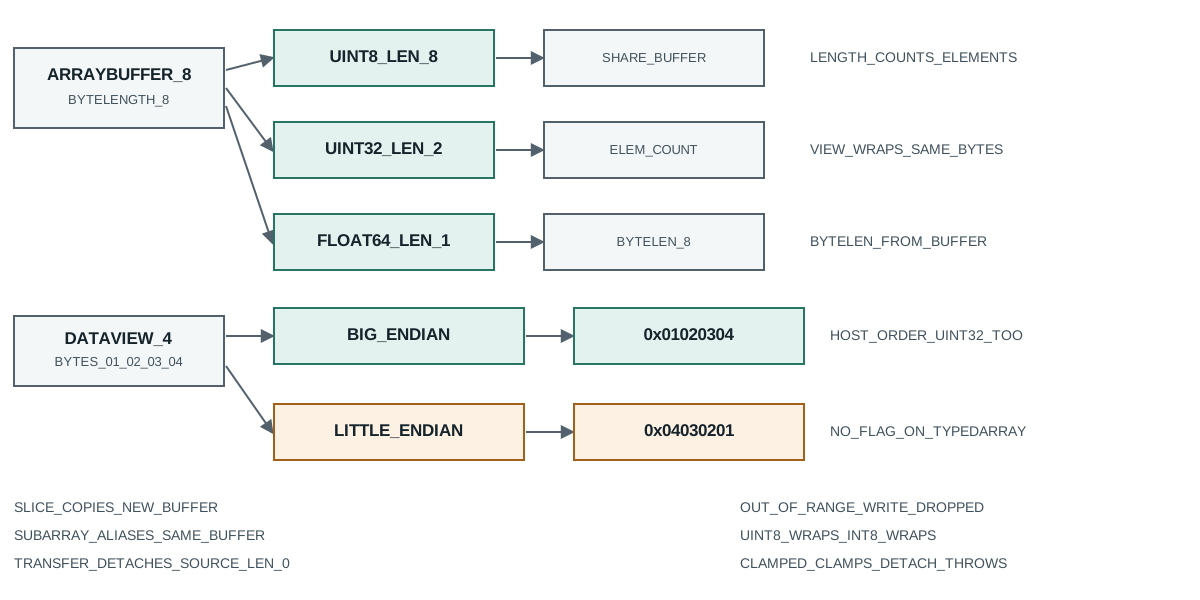
Буфер это блок байтов без понятия о том, что значат байты. Вид придает этот смысл, и размер элемента, который он использует, решает, сколько элементов помещается в том же блоке. Проба выделяет буфер в 8 байтов и строит на нем три вида:
ArrayBuffer=function DataView=function node=v26.9.0
new ArrayBuffer(8): byteLength=8
same buffer: Uint8Array.length=8 Uint32Array.length=2 Float64Array.length=1
all share bytes: u8.buffer===u32.buffer true
Буфер сообщает byteLength 8 независимо от того, какой вид его читает. Uint8Array читает один байт на элемент, поэтому его length равно 8. Uint32Array читает четыре байта на элемент, поэтому его length равно 2. Float64Array читает восемь байтов на элемент, поэтому его length равно 1. Три числа, которые описывают одни и те же восемь байтов, и только одно из них это счетчик байтов.
Это различие есть первый дефект в двоичном пути кода: тот, кто читает view.length и умножает на один байт на элемент, получает неверный счетчик байтов для любого вида, кроме байтового. Свойство byteLength это то, что всегда считает байты, и оно совпадает у всех трех видов, потому что это свойство окна буфера, а не типа элемента. Проверка идентичности .buffer подтверждает, что три вида обертывают одно выделение, поэтому запись через байтовый вид видна через 32-битный вид, что и есть то, на что опирается декодер, когда заполняет байты, а затем читает их как целые числа.
Практическое следствие в том, что длина, записанная в запись, должна называть вид, который ее произвел. Запись, которая говорит "длина 8", неоднозначна: это длина в байтах или длина Uint8Array, но Uint32Array на тех же байтах сказал бы два. Обе верны и отвечают на разные вопросы, поэтому записи нужен размер элемента рядом с числом.
То же рассуждение решает, как вид сообщает счетчик байтов, когда буфер не кратен размеру элемента. Uint32Array на буфере в 10 байтов предоставляет только два полных четырехбайтовых элемента, которые помещаются, а два конечных байта оказываются вне любого элемента, который он может адресовать. byteLength вида отражает только покрытые им байты, поэтому два оставшихся байта не читаются и не пишутся через него, и анализатор, который предполагает, что каждый байт буфера достижим через вид, молча теряет хвост. Выбор типа элемента для буфера, который ему не выровнен, поэтому это решение о том, какие байты адресуемы, а не только о том, сколько элементов сообщает длина.
Почему slice копирует, а subarray делит буфер
Два метода похожи и ведут себя противоположно. slice возвращает новый вид, опирающийся на новый буфер, а subarray возвращает новый вид, опирающийся на тот же буфер. Проба меняет каждый и проверяет, изменился ли источник:
slice then mutate: src[1]=2 sliced[0]=99
subarray then mutate: src[1]=42 sub[0]=42
slice shares buffer: false; subarray shares buffer: true
После slice(1, 4) запись 99 в копию оставляет src[1] на его исходном 2, и проверка идентичности буфера сообщает, что копия не делит буфер источника. После subarray(1, 4) запись 42 в подвиду меняет src[1] на 42, и проверка сообщает, что подвида делит буфер источника. Оба метода принимают те же аргументы и производят виды тех же трех элементов, но один это копия, а другой псевдоним.
Декодер, который читает кадр, берет slice для тела и сохраняет его, может повторно использовать буфер источника для следующего кадра, потому что копия владеет своими байтами. Декодер, который берет subarray для того же и затем повторно использует буфер источника для следующего кадра, перезаписывает сохраненное тело, потому что подвида все еще указывает в буфер, который только что изменился. Это классический дефект псевдонима: код выглядит верным, счетчик элементов верен, а сохраненные байты молча оказываются байтами следующего кадра.
Исправление в том, чтобы намеренно решить, что нужно записи. Копия стоит выделения и переживает повторное использование источника; псевдоним не стоит ничего и становится недействительным в момент изменения источника. Запись, которая хранит subarray, должна держать буфер источника живым и неизменным или сначала скопировать байты через slice, и она должна говорить, что именно сделала, потому что сохраненный псевдоним и сохраненная копия неотличимы только по счетчику элементов.
Как те же байты читаются big-endian и little-endian
Порядок байтов решает, какой конец многобайтового числа идет первым. DataView принимает явный аргумент littleEndian, и проба пишет одно 32-битное значение и читает его обоими способами:
setUint32 big-endian bytes: 01 02 03 04
DataView read BE -> 0x1020304
DataView read LE -> 0x4030201
Uint32Array (host order) -> 0x4030201
host is little-endian: true
Запись 0x01020304 с littleEndian в false (big-endian) кладет байты как 01 02 03 04. Чтение их через getUint32(0, false) восстанавливает 0x01020304, а чтение тех же четырех байтов через getUint32(0, true) восстанавливает 0x04030201, значение с перевернутыми байтами. Байты не изменились; изменилась только интерпретация, и обе верны под своим флагом.
Строка Uint32Array показывает ловушку. У вида типизированного массива нет аргумента порядка байтов; он читает в родном порядке хоста. Эта машина little-endian, поэтому Uint32Array читает 0x04030201, совпадая с little-endian чтением DataView. Декодер, который разбирает сетевой заголовок через Uint32Array вместо DataView, поэтому получает верный ответ на little-endian хосте и неверный на big-endian хосте, без изменения кода. Вот почему двоичный формат всегда называет свой порядок байтов и почему декодер, который должен следовать спецификации, использует DataView с явным флагом, а не вид типизированного массива.
Строка host is little-endian это дешевый способ записать, в какую сторону склоняется машина: выделить Uint16Array со значением 1, прочитать его буфер как байты и проверить, равен ли первый байт 1. Запись, которая хранит разобранные целые числа без записи порядка хоста, нельзя перезапустить к тем же числам на другой машине, потому что те же байты воспроизводят значение только под предполагаемым порядком.
Есть и второе, более тихое следствие того, как вид сообщает число. Uint32Array выдает целое без знака, поэтому значение с установленным старшим битом читается как большое положительное, а не отрицательное, и формат, который использует знаковое 32-битное поле, нуждается в Int32Array или вызове DataView.getInt32, чтобы прочитать его верно. Два вида на одинаковых байтах могут расходиться в величине и знаке одного поля, потому что тип элемента несет знак вместе с шириной. Запись, которая фиксирует сырые байты и тип элемента вместе, можно перечитать как любой из них, а запись, которая фиксирует только число, уже выбрала одну интерпретацию.
Где оказываются доступ вне диапазона и переполнение
Типизированные массивы не растут и не бросают на индексе за пределами их длины. Проба пишет за конец и читает за концом:
write index 10 on length 3: undefined length=3
Float64Array out-of-range read index 5 -> undefined
Запись 5 в индекс 10 массива длиной 3 ничего не делает: длина остается 3, а индекс читается как undefined, потому что запись была вне окна элементов и была отброшена. Чтение вне диапазона на Float64Array также возвращает undefined, а не NaN, потому что чтение за длиной это вовсе не числовое чтение. Анализатор, который доверяет смещениям от пользователя и пишет по вычисленному индексу, поэтому может молча терять данные, при каждом успешном вызове, и только проверка длины перед записью это ловит.
Запись значения, которое не помещается, имеет свое поведение, и три типа массива показывают три исхода:
Uint8Array 256 -> 0; Int8Array 200 -> -56
Uint8ClampedArray 300 -> 255
Uint8Array хранит младшие 8 бит, поэтому 256 становится 0; Int8Array хранит знаковое 8-битное значение, поэтому 200 становится -56. Оба оборачивают по модулю диапазона элемента без ошибки. Uint8ClampedArray ограничивает вместо обертывания, поэтому 300 становится 255, а отрицательное значение стало бы 0. Буфер пикселей, который ждет ограничения и получает Uint8Array, оборачивает, поэтому яркое значение переполняется в темное, тогда как то же значение на Uint8ClampedArray насыщается до белого. Тип элемента есть часть контракта данных, и запись, которая говорит "массив байтов" без указания, ограничивает он или оборачивает, не описала арифметику.
Где окно вида и transfer меняют источник
Вид может покрывать поддиапазон буфера, а буфер можно передать. Оба меняют то, чем является источник, и проба измеряет каждый:
view window: byteOffset=4 byteLength=4 buffer.byteLength=16
after transfer(4): source.byteLength=0 moved.byteLength=4
source use after detach -> THREW TypeError
Строка окна показывает Uint8Array, построенный на буфере в 16 байтов со смещением 4 и длиной 4. byteLength вида равно 4, его byteOffset равно 4, но нижележащий buffer.byteLength по-прежнему 16. Запись, которая хранит только длину вида, занижает буфер, а запись, которая хранит только длину буфера, завышает вид; эти два числа описывают разные окна на одной памяти, и оба нужны, чтобы найти байты.
Строка transfer показывает, что он делает. До вызова источник это 8 байтов; после buf.transfer(4) byteLength источника равен 0, а возвращенный буфер содержит 4 байта. Источник отсоединен, и любое последующее использование вида на нем бросает TypeError, что проба и запечатлевает. Transfer перемещает байты в новый буфер и оставляет старый непригодным, поэтому код, который держит ссылку на старый буфер и читает его после transfer, получает исключение, а не устаревшие данные. Это громкий сбой и потому легко ловится, но код, который передает буфер, который другая часть программы все еще надеется прочитать, упадет на следующем чтении, поэтому владение переданным буфером должно быть записано.
Связанная граница в том, что вывод кодировщика это вид Uint8Array, а не обычный массив: TextEncoder.encode("café") возвращает объект, чей byteLength равен 5 и который проходит instanceof Uint8Array. Этот вид есть вход, который измеряет раздел о длине выше, поэтому счетчик байтов, который декодер читает потом, это то же число, что запись должна хранить.
Записывайте двоичные показания
Двоичные показания поддерживают узкое утверждение: эта среда, этот порядок байтов, этот вид и этот вход произвели эти числа. Шесть полей сохраняют их проверяемыми, и ни одно не хранит значение, которое другой вид переинтерпретировал бы:
byteLengthбуфера и, для вида, егоbyteOffsetиbyteLength, потому что окно и буфер это разные диапазоны.- Тип элемента каждого вида, использованного для чтения байтов, потому что один буфер несет 8, 2 или 1 элемент в зависимости от размера элемента.
- Порядок байтов хоста, потому что вид типизированного массива читает родной порядок, а
DataViewпринимает явный флаг. - Является ли производный вид копией
sliceили псевдонимомsubarray, потому что только псевдоним меняется, когда буфер источника повторно используется. - Поведение ограничения или обертывания типа элемента, потому что значение вне диапазона элемента либо оборачивает по модулю диапазона, либо насыщается до границы.
- Был ли буфер передан и что стало с его
byteLength, потому что отсоединенный источник бросает при следующем использовании, а не читает устаревшие байты.
Чего такие показания не могут показать, так это ничего о том, откуда пришли байты. Буфер заполняет какой-то производитель, и читатель, который его разбирает, не знает, написал ли производитель UTF-8, сетевой заголовок в big-endian или сериализованное число в порядке хоста. О текстовой стороне тех же байтов TextDecoder и TextEncoder показывает, почему те же четыре байта UTF-8 декодируются в одну строку под одной меткой и в неверно закодированную строку под другой. О стороне копии structuredClone против JSON показывает, какие типы контейнеров выживают при глубокой копии и что обход через JSON обрушивает, что есть решение на уровне контейнера, предшествующее чтению на уровне байтов.
Две привычки сохраняют показания честными со временем. Во-первых, записывайте тип элемента и порядок байтов вместе с числами, потому что целое число, прочитанное из тех же байтов, различается под каждым. Во-вторых, храните, является ли вид копией или псевдонимом, и сравнивайте байты, а не только счетчик элементов, потому что псевдоним, указывающий в повторно используемый буфер, имеет тот же счетчик элементов, что и копия, которую он заменил, но несет другие байты.
Публичные источники
- MDN: ArrayBuffer
- MDN: TypedArray
- MDN: DataView
- MDN: ArrayBuffer.prototype.transfer
- ECMAScript: объекты DataView
- BotBrowser: справка по согласованности автоматизации
Итоги
Относитесь к виду как к части контракта данных: byteLength считает байты, length считает элементы, и буфер в 8 байтов несет 8, 2 или 1 элемент в зависимости от вида. Знайте, что slice копирует, а subarray делит буфер, поэтому сохраненный псевдоним умирает, когда буфер источника повторно используется. Читайте двоичные форматы через DataView с явным порядком байтов, а не через вид типизированного массива, который следует порядку хоста, и записывайте, little-endian ли хост. Ожидайте, что запись вне диапазона отбрасывается, а чтение вне диапазона равно undefined, и что Uint8ClampedArray ограничивает там, где Uint8Array оборачивает. Записывайте окно, тип элемента, порядок байтов, выбор копии или псевдонима и исход transfer, и сравнивайте байты, а не счетчик элементов, чтобы устаревший псевдоним не прошел зеленую проверку.
Читать дальше
О том, что те же байты значат как текст, читайте TextDecoder и TextEncoder; о том, какие типы контейнеров выживают при глубокой копии до того, как прочитан хоть один байт, читайте structuredClone против JSON.
Эта статья входит в руководство: Что такое отпечаток браузера?
Похожие статьи
TextDecoder и TextEncoder: байты против строк
ОтпечаткиUnicode: четыре идентичности одного текста
ОтпечаткиICU: псевдонимы часовых поясов и TZ, который вы отдаете
Отпечаткиbtoa и atob: границы Latin-1 и дополнение на практике
ОтпечаткиstructuredClone против JSON: что сохраняет глубокая копия
ОтпечаткиИсточник случайности в crypto-js: ветка сборки
Переведите BotBrowser из исследований в продакшн
Используйте эти руководства, чтобы понять модель, а затем перейти к кроссплатформенной валидации, изолированным контекстам и масштабируемому браузерному развертыванию.