Intl.Collator: порядок локали против кодовых единиц
Один прогон по фиксированным спискам: чем сравнение по локали отличается от сортировки по кодовым единицам, как опции меняют результат и что сообщает resolvedOptions.
BotBrowser Team
Нужна структурированная документация по теме Отпечатки?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
BotBrowser поддерживает воспроизведение авторизованной same-origin фикстуры под объявленным профилем и сохраняет ограниченную запись о том, что страница отсортировала и в какой локали, но он не может изменить данные коллации, которые поставляет среда выполнения, не может заставить две локали согласовать один порядок и не может восстановить коллацию, которую использовало сравнение, задним числом. Этот обзор прогоняет одну проверку по десяти фиксированным спискам и фиксирует, чем сравнение по локали отличается от простой сортировки по кодовым единицам, как numeric, sensitivity, caseFirst и ignorePunctuation каждый по-своему меняют результат, что на самом деле сообщает resolvedOptions(), к чему откатывается неподдерживаемая локаль и почему передача коллатора вместо его функции compare бросает исключение.
Кратко
- Сортировка по кодовым единицам ставит
Áppleпоследним, а сортировка по локали ставит его третьим, так что два порядка расходятся на тех же пяти словах. - Локаль меняет порядок одной и той же пары: шведский ставит
äпослеz, немецкий и английский ставят её раньше, поэтому проверка печатаетpair-sv -> z,äиpair-de -> ä,z. numeric: trueставитitem2передitem10, тогда как по умолчанию они трактуются как текст, иitem10идёт передitem2.sensitivityрешает, какие различия учитываются:baseсчитаетa,Aиáравными,accentотделяет форму с диакритикой, аcaseотделяет заглавную.ignorePunctuation: trueделаетabиa-bравными, тогда как по умолчанию они сравниваются как разные.caseFirstпроявляется только когда регистр вообще имеет значение, и он меняетAaBbнаaAbB.resolvedOptions()сообщает коллацию, которую предоставила среда, включая коллацию, названную в теге локали, а неподдерживаемая локаль откатывается кen-US, а не бросает исключение.Array.prototype.sort(collator)бросаетTypeError; работает толькоsort(collator.compare).
Содержание
- Что сравнивает коллатор, а что не делает сортировка по кодовым единицам
- Как numeric и sensitivity меняют результат
- Где регистр, пунктуация, эквивалентность и локальный регистр входят в порядок
- Где каноническая эквивалентность и локальный регистр удивляют сортировку
- Что сообщает resolvedOptions и что откатывается
- Почему коллатор нельзя передать в sort напрямую
- Записывайте показания коллации
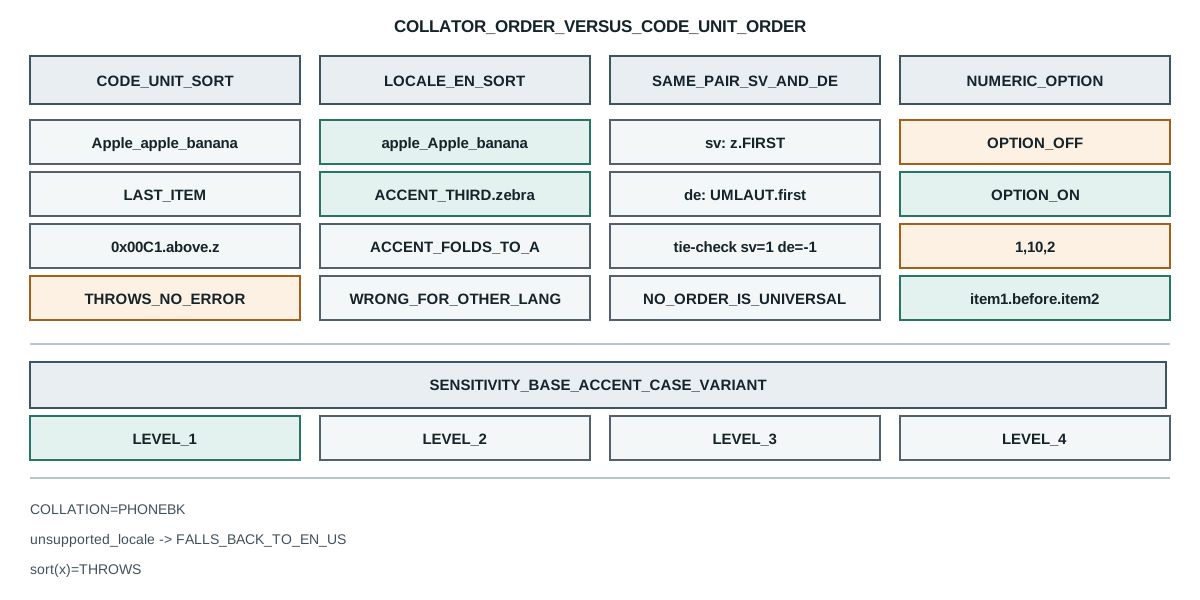
Что сравнивает коллатор, а что не делает сортировка по кодовым единицам
Сортировка Array.prototype.sort() по умолчанию сравнивает кодовые единицы UTF-16. Коллатор сравнивает текст так, как его упорядочивает язык: диакритика сворачивается в базовую букву, регистр является вторичным различием, и каждая локаль решает, где стоит буква. Проверка сортирует те же пять слов обоими способами:
node=v26.9.0
icu=78.3 unicode=17.0
code-unit -> Apple,apple,banana,zebra,Ápple
locale-en -> apple,Apple,Ápple,banana,zebra
pair-sv -> z,ä
pair-de -> ä,z
pair-en -> ä,z
numeric-off -> item1,item10,item2
numeric-on -> item1,item2,item10
sensitivity-base -> a-vs-A=0 a-vs-á=0 a-vs-b=-1
sensitivity-accent -> a-vs-A=0 a-vs-á=-1 a-vs-b=-1
sensitivity-case -> a-vs-A=-1 a-vs-á=0 a-vs-b=-1
sensitivity-variant -> a-vs-A=-1 a-vs-á=-1 a-vs-b=-1
punct-kept -> 1
punct-ignored -> 0
caseFirst-upper -> AaBb
caseFirst-lower -> aAbB
caseFirst-upper-base -> Aa vs aA
resolved -> locale=de-u-co-phonebk numeric=true sensitivity=accent collation=phonebk
fallback-locale -> en-US
passthrough -> sort(collator)=TypeError sort(collator.compare)=ab
tie-check -> sv(ä vs z)=1 de(ä vs z)=-1
Разница с обычной сортировкой та же, что Сортировка массива и компараторы показывает для самого компаратора. Первые две строки это вся суть в миниатюре. У Ápple кодовая единица выше z, поэтому сортировка по кодовым единицам выталкивает его в конец; язык видит Á как A с диакритикой, поэтому сортировка по локали ставит его к другим словам на а. Ни один порядок не неверен, и страница, которая сравнивает список между двумя средами выполнения, не называя вторую, записала результат, который зависит от того, какую сортировку она использовала.
Вторая пара это более сложный случай. ä в шведском не просто a с диакритикой; это своя собственная буква, и она сортируется после z. Немецкий держит её рядом с a. Проверка печатает два порядка рядом, и страница, которая жёстко зашивает любой из них как "тот самый" порядок, ломается на другом языке. Строка tie-check показывает то же самое как результат сравнения, а не как отсортированный список: одна и та же пара возвращает 1 в шведском и -1 в немецком.
Как numeric и sensitivity меняют результат
numeric: true переключает последовательность цифр с текстового сравнения на числовое, и проверка показывает разницу на трёх элементах списка:
numeric-off -> item1,item10,item2
numeric-on -> item1,item2,item10
По умолчанию item10 читается как символы "1", "0", поэтому идёт перед item2 как "2". С numeric среда читает последовательность цифр как число десять, поэтому item2 идёт первым. Страница, которая сортирует имена файлов или строки таблицы коллатором по умолчанию и ожидает естественный порядок, получает первую строку, а не вторую.
sensitivity решает, какие различия сравнение сообщает вообще, и проверка сравнивает три пары на каждом из четырёх уровней:
sensitivity-base -> a-vs-A=0 a-vs-á=0 a-vs-b=-1
sensitivity-accent -> a-vs-A=0 a-vs-á=-1 a-vs-b=-1
sensitivity-case -> a-vs-A=-1 a-vs-á=0 a-vs-b=-1
sensitivity-variant -> a-vs-A=-1 a-vs-á=-1 a-vs-b=-1
base сообщает 0 и для пары по регистру, и для пары по диакритике, поэтому a, A и á все равны, и только b стоит отдельно. accent начинает отделять форму с диакритикой, но всё ещё считает a и A равными. case делает обратное: отделяет заглавную и снова сворачивает диакритику. variant отделяет всё. Таблица поиска с ключом по строке, приведённой к нижнему регистру и очищенной от диакритики, делает вручную то, что sensitivity: 'base' делает одной опцией, а таблица, которая хочет, чтобы A и a совпадали, но á сортировалась отдельно, хочет accent.
Это различие важно для вопроса об отпечатке не меньше, чем для сортировки. Страница, которая группирует строки по sensitivity: 'base', и страница, которая группирует по variant, дают разное число групп из одного и того же входа, поэтому показание "число различных значений" должно называть sensitivity, иначе оно несравнимо между двумя страницами.
В той же таблице есть ловушка второго порядка. sensitivity: 'base' сообщает 0 для a против á, и страница, которая трактует этот 0 как "эти строки имеют одно и то же значение", сольёт две записи, которые пользователь считает различными. Сравнения сообщают порядок, а не равенство: 0 означает, что у коллатора нет мнения о том, что идёт первым, и Map с ключом по исходным строкам всё равно хранит обе. Дедупликация должна отдельно решить, означает ли ничья "оставить первую", "оставить обе" или "слить", и коллатор на этот вопрос не отвечает.
Четыре уровня также вкладываются в фиксированном порядке, и знание порядка предсказывает каждую строку. base игнорирует диакритику и регистр; accent добавляет различение диакритики; case вместо этого добавляет различение регистра и держит диакритику свёрнутой; variant добавляет и то, и другое. Поэтому accent и case расходятся на разных парах, а не один является более строгой версией другого, и поэтому страница, которой нужно "то же слово, любой регистр, любая диакритика", хочет base, а не цепочку ручных нормализаций.
Где регистр, пунктуация, эквивалентность и локальный регистр входят в порядок
ignorePunctuation заставляет коллатор пропускать пунктуацию при сравнении, и проверка показывает эффект на одной паре:
punct-kept -> 1
punct-ignored -> 0
ab и a-b различаются, когда пунктуация учитывается, и равны, когда нет. Страница, которая сортирует список имён с дефисами и ожидает, что ab и a-b останутся врозь, полагается на умолчание, а страница, которая дедуплицирует коллатором с игнорируемой пунктуацией, сольёт их. Опция это выбор политики, а не деталь.
Та же опция меняет то, что строка поиска считает совпадением. Фильтр, который приводит запрос к нижнему регистру и сравнивает коллатором по умолчанию, держит a-b и ab врозь, поэтому ввод ab ничего не находит в списке, который содержит только a-b. Выключение пунктуации делает запрос совпадающим, а выключение также делает a.b и a-b совпадающими друг с другом, что обычно и ожидает читатель от поля поиска и редко хочет фильтр точного совпадения. Одна опция, два продукта, противоположные умолчания.
caseFirst задаёт, какой регистр идёт первым, когда регистр вообще является различием, и проверка показывает и эффект, и его предел:
caseFirst-upper -> AaBb
caseFirst-lower -> aAbB
caseFirst-upper-base -> Aa vs aA
При чувствительности по умолчанию upper ставит заглавную перед строчной в каждой паре, а lower меняет это. Третья строка это предел: при sensitivity: 'base' два регистра равны, поэтому caseFirst нечего упорядочивать, и напечатанный результат это просто порядок входа в каждом случае. Опцию, у которой нет эффекта, пока не задана другая опция, легко прочитать как сломанную, и проверка это самый дешёвый способ увидеть, что это не так.
Эту зависимость стоит сформулировать как правило: caseFirst это разрушитель ничьих внутри сравнения, которое уже различает регистр, и выше этого уровня он ничего не делает. Страница, которая задаёт caseFirst: 'upper' и sensitivity: 'base' и ожидает заглавные первыми, задала две опции, которые взаимно отменяются, и исправление в том, чтобы убрать переопределение sensitivity, а не добавить ручное сравнение. Последняя строка проверки показывает, что оба порядка входа выживают нетронутыми, и это видимая форма отмены.
Где каноническая эквивалентность и локальный регистр удивляют сортировку
Два из самых запутанных поведений вовсе не про флаги опций; они происходят из того, как коллатор трактует текст, который выглядит одинаково, и текст, регистр которого зависит от языка. Вторая проверка записывает оба.
Первое это каноническая эквивалентность. Букву é можно хранить как одну кодовую точку или как e, за которой следует комбинирующий знак диакритики, и эти две строки не равны:
normalization-text -> nfc.length=1 nfd.length=2 equal=false
normalization-collate -> base=0 variant=0
Длины различаются, и сравнение строк говорит, что они разные, но коллатор сообщает 0 и на base, и даже на variant чувствительности, потому что эти два написания канонически эквивалентны, и данные коллации сворачивают их вместе. Страница, которая сравнивает коллатором, поэтому трактует две побайтно разные строки как одно и то же слово, а страница, которая сравнивает через === или Map, нет. Это расхождение это самый частый источник "сортируется правильно, но поиск не находит": сортировка использовала коллатор, а поиск использовал сырую строку.
Первое также объясняет, почему сравнение по коллации и сравнение строк расходятся, что Нормализация Unicode разбирает со стороны строки. Второе это локальный регистр. В турецком I приводится к нижнему регистру как ı без точки, а i приводится к верхнему как İ с точкой, которая является другой буквой, нежели английская I:
dotted-i-tr -> i-vs-I=1 i-vs-İ=-1
dotted-i-en -> i-vs-I=-1 i-vs-İ=-1
turkish-lower -> tr=ı en=i
Под турецким коллатор ставит i после I и перед İ, поэтому i и I больше не одна и та же буква ни по регистру, ни по порядку; под английским он ставит i перед обеими. Последняя строка показывает то же расхождение на уровне строки: 'I'.toLocaleLowerCase('tr') это ı, тогда как английский вызов возвращает i. Страница, которая приводит к нижнему регистру без локали и затем сравнивает, получает английский порядок в обеих локалях, и поэтому сравнение с учётом локали и свёртку регистра с учётом локали нужно выбирать вместе, а не по одной.
Есть третья форма, которую стоит записать, потому что она ломает допущение, что сортировка по кодовым единицам "достаточно близка". Астральные символы, которые занимают две кодовые единицы, при простой сортировке сортируются по своей первой кодовой единице, а при коллаторе по своему весу коллации:
astral-codeunit -> 61,7a,1f600
astral-collator -> 1f600,61,7a
Простая сортировка ставит эмодзи последним, потому что его ведущая единица выше z; коллатор ставит его первым, потому что его вес коллации идёт перед буквами. Страница, которая смешивает астральные символы со списком имён и сортирует по умолчанию, получает порядок, которого не ждёт ни один читатель, и исправление это коллатор, а не ручная перестановка.
Наконец, пролог ко всему этому в том, что localeCompare и коллатор согласуются, и это самый дешёвый способ подтвердить гипотезу перед построением коллатора:
localeCompare-vs-collator -> ä-z:-1/-1 a-b:-1/-1
hoisted-vs-per-call -> same=true order=Alpha,bravo,charlie,delta
Первая строка показывает, что 'ä'.localeCompare('z', 'de') и немецкий коллатор возвращают одинаковый -1, поэтому проверку можно начать с однострочника и тянуться к коллатору только когда нужны опции. Вторая строка показывает, что вынесенный коллатор и коллатор, создаваемый на каждое сравнение, дают один и тот же порядок, что подтверждает более раннее утверждение, что вынос меняет стоимость, а не результат.
Что сообщает resolvedOptions и что откатывается
resolvedOptions() возвращает то, что среда действительно предоставила, после применения и тега локали, и опций:
resolved -> locale=de-u-co-phonebk numeric=true sensitivity=accent collation=phonebk
У коллатора запросили de-u-co-phonebk с двумя опциями, и разрешённая локаль сохраняет расширение -u-co-phonebk и сообщает collation=phonebk отдельно. Это разделение важно, потому что страница может прочитать любое из полей и получить другую строку, а запись, которая хранит только locale и отбрасывает collation, потеряла ту часть, что решила порядок. Телефонная коллация ставит ä вместе с ae в немецком, что снова третий порядок, отличный и от простого немецкого, и от шведского, который печатался в предыдущем разделе.
Неподдерживаемая локаль не бросает исключение. Проверка запрашивает zz-ZZ:
fallback-locale -> en-US
Среда откатилась к en-US и сказала об этом. Страница, которая читает локаль из заголовка или параметра запроса и передаёт её прямо в коллатор, поэтому всегда получает коллатор, и только resolvedOptions().locale раскрывает, что запрос не был удовлетворён. Запись, которая хранит запрошенную локаль вместо разрешённой, записала намерение, а не измерение.
Почему коллатор нельзя передать в sort напрямую
Коллатор это объект с методом compare, а Array.prototype.sort() принимает функцию, а не объект с совместимым методом. Проверка передаёт сам коллатор:
passthrough -> sort(collator)=TypeError sort(collator.compare)=ab
Первая половина бросает TypeError, потому что аргумент не вызываемый; вторая половина сортирует правильно, потому что collator.compare это связанная функция. Это ошибка в одно слово при обзоре кода и исключение времени выполнения в продакшене, и её стоит назвать, потому что сообщение от sort вовсе не упоминает коллаторы.
Та же форма объясняет более тонкую ошибку. Коллатор, созданный один раз и переиспользуемый, это больше, чем фабрика для compare; он хранит локаль и опции, и его compare привязан к ним. Страница, которая создаёт новый коллатор на каждое сравнение внутри callback сортировки, перестраивает состояние ICU тысячи раз, что правильно и медленно, а страница, которая выносит один коллатор из цикла, получает тот же порядок быстрее. Проверка не может показать разницу во времени на списке из пяти элементов, и порядок в обоих случаях одинаков, поэтому выбор исключительно про стоимость.
Записывайте показания коллации
Показание коллации поддерживает узкое утверждение: эта среда, эта версия ICU, эта локаль и эти опции дали эти порядки. Пять полей делают его проверяемым:
- Среда и её версия ICU, потому что проверка печатает
icu=78.3 unicode=17.0, а другая ICU поставляет другие данные коллации. - Запрошенная локаль и разрешённая локаль, потому что неподдерживаемый тег откатывается молча.
- Разрешённая коллация, потому что расширение
-u-co-меняет порядок и сообщается отдельно от локали. - Четыре опции, которые меняют результат,
numeric,sensitivity,caseFirstиignorePunctuation, потому что два коллатора с одной локалью и разными опциями расходятся. - Использованное сравнение,
sort()илиcollator.compare, потому что передача объекта бросает исключение.
Публичные источники
- MDN: Intl.Collator
- MDN: Intl.Collator.prototype.compare
- MDN: Intl.Collator.prototype.resolvedOptions
- ECMA-402: Collator Objects
- Unicode TR35: Collation
- BotBrowser: automation consistency reference
Практический вывод
Называйте коллатор всякий раз, когда порядок покидает страницу: локаль, разрешённую коллацию и четыре опции, потому что каждая из них меняет результат на одном и том же входе. Предпочитайте sensitivity ручной свёртке регистра и диакритики, и трактуйте ignorePunctuation как решение политики, а не деталь. Передавайте collator.compare в sort, никогда сам коллатор, и выносите один коллатор из цикла. О числовом сравнении, которое сортировка по умолчанию делает неверно, читайте Сортировка массива и компараторы; о данных локали за порядком читайте Данные локали Intl API.
Эта статья входит в руководство: Что такое отпечаток браузера?
Похожие статьи
Unicode: четыре идентичности одного текста
ОтпечаткиСортировка массива и компараторы: функция с изъяном
ОтпечаткиICU: псевдонимы часовых поясов и TZ, который вы отдаете
ОтпечаткиПорядок ключей объекта: целые сортируют, строки стоят
ОтпечаткиКомбинаторы Promise: первый отказ и вечное ожидание
ОтпечаткиРазбор URL и search params: что меняет обход
Переведите BotBrowser из исследований в продакшн
Используйте эти руководства, чтобы понять модель, а затем перейти к кроссплатформенной валидации, изолированным контекстам и масштабируемому браузерному развертыванию.