Unicode: четыре идентичности одного текста
Запустите ICU хоста на предкомпонованных, разложенных, эмодзи и хангыль строках, чтобы увидеть четыре длины одного видимого текста и почему промахивается ключ.
BotBrowser Team
Нужна структурированная документация по теме Отпечатки?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
BotBrowser поддерживает повтор разрешенного fixture на том же origin под объявленным профилем и сохраняет ограниченные наблюдения о том, что сообщает страница, но он не может заставить страницу вернуть каноническую строку, для которой она никогда не вызывала normalize(), изменить, какую версию Unicode несет конкретная сборка ICU, или сделать счет кластеров графем равным длине в единицах. Этот разбор запускает ICU из рантайма Node на фиксированном наборе строк и сообщает четыре разных числа, которые страница может прочитать для одного видимого текста: длину в единицах, число кодовых точек, число кластеров графем и длину после нормализации.
TL;DR
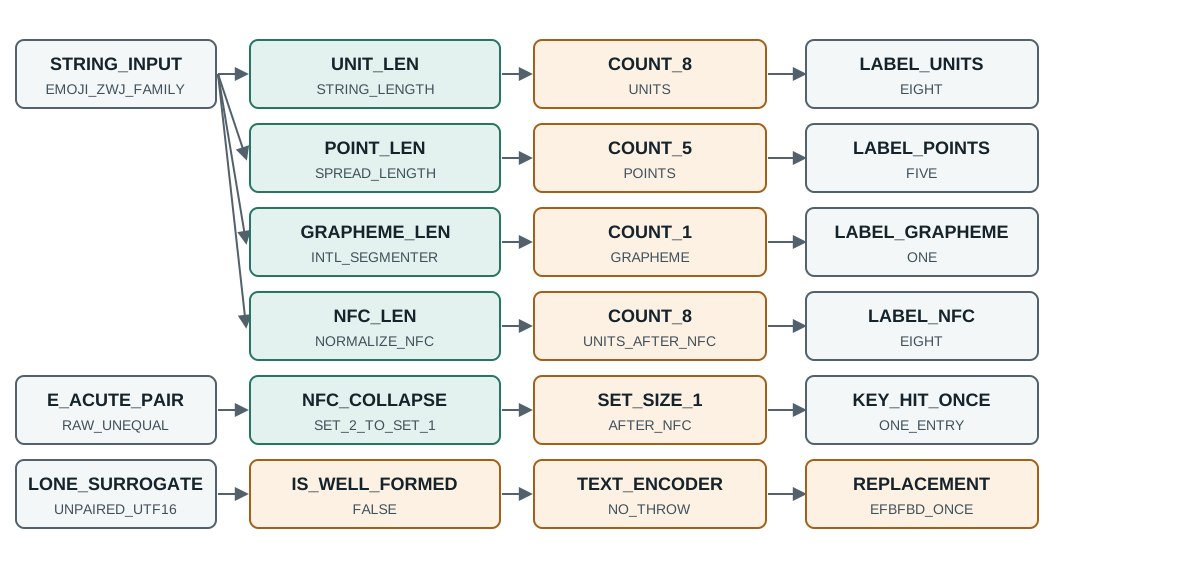
éкак одна кодовая точка и какeплюс комбинирующий акут не равны как строки, равны после NFC и дают два разных значенияString.length.Setс двумя написаниями имеет размер два; тот же набор после NFC имеет размер один, поэтому поиск по ключу может промахнуться на тексте, который читатель видит идентичным.- Эмодзи увеличивают разрыв: одно семейное эмодзи это восемь единиц, пять кодовых точек и один кластер графем.
- Одиночный суррогат проваливает
isWellFormed()иTextEncoderпишет один символ замены, поэтому кодирование с потерей наблюдаемо без какой-либо ошибки. - Сопоставление, регистр и сегментация зависят от переданной локали, а сортировка по умолчанию вообще не использует сопоставитель.
- Каждое число здесь из одной сборки ICU и одной версии Unicode; другая сборка может дать другое.
Contents
- Какой рантайм и какая версия Unicode
- Четыре длины для одного видимого текста
- Где ключ промахивается на идентичном тексте
- Где одиночный суррогат становится символом замены
- Где регистр меняет длину строки
- Где сопоставление и сегментация зависят от локали
- Как записать чтение текста без преувеличения
Какой рантайм и какая версия Unicode
Проба печатает рантайм, ICU и Unicode до любого измерения, потому что каждое число ниже это свойство этой тройки. Запуск сообщил node=v26.9.0, icu=78.3, unicode=17.0 и tz=2026a. Другая сборка ICU может нести другие таблицы регистра, другую таблицу сопоставления и другой набор правил сегментации, поэтому чтение без этих версий не воспроизводимо. То же правило привязки к версии применяет разбор псевдонимов часовых поясов ICU, где разрешённая строка это поиск в поставляемой таблице, а не чтение часов.
Версия Unicode значит больше, чем кажется. Новые последовательности эмодзи, новые комбинирующие знаки и исправления свойств приходят со сменой версии, и каждая из них меняет хотя бы одну из четырех длин ниже для некоторой строки. Запись «страница сообщила длину 8» без версии Unicode нельзя сравнить с другой машиной, потому что тот же видимый текст может быть восемью единицами в одной сборке и девятью в другой, когда новая последовательность получает свойство, меняющее ее сегментацию.
Четыре длины для одного видимого текста
Первая проба измеряет каждую строку четырьмя способами: length считает единицы кода UTF-16, [...s].length считает кодовые точки, Intl.Segmenter с гранулярностью графемы считает то, что читатель воспринимает как один символ, а normalize('NFC').length считает единицы после канонической композиции.
e-acute-precomposed: units=1 points=1 nfc=1 nfd=2 cps=U+00E9
e-acute-decomposed: units=2 points=2 nfc=1 nfd=2 cps=U+0065 U+0301
emoji-zwj-family: units=8 points=5 nfc=8 nfd=8 cps=U+1F468 U+200D U+1F469 U+200D U+1F467
emoji-skin-tone: units=4 points=2 nfc=4 nfd=4 cps=U+1F44D U+1F3FD
hangul-syllable: units=1 points=1 nfc=1 nfd=2 cps=U+AC00
hangul-jamo: units=2 points=2 nfc=1 nfd=2 cps=U+1100 U+1161
Шесть строк с четырьмя различными наборами: предкомпонованная строка é и предкомпонованная строка хангыля делят один, а две разложенные строки делят другой. Две строки é различаются в единицах и точках, но совпадают после NFC, классический случай. Строка семейного эмодзи показывает наибольший разброс: восемь единиц, пять кодовых точек и одна графема. Строки хангыля показывают, что NFC компонует два чамо в один слог, поэтому нормализованная длина точно совпадает с предкомпонованной строкой.
Практическое следствие в том, что «длина» это не одно измерение. Страница, которая записывает str.length для отображаемого имени, записывает число единиц UTF-16, которое для имени с эмодзи может быть вдвое больше того, что читатель назвал бы числом символов. Страница, которая записывает [...str].length, записывает кодовые точки, которые все еще считают семейное эмодзи пятью. Только сегментатор совпадает с читателем.
Счет графем это то, что совпадает с восприятием, и проба делает совпадение явным:
segmenter graphemes=1 units=8 points=5
segmenter graphemes=1 units=4 points=2
segmenter graphemes=1 units=2 points=2
segmenter graphemes=1 units=4 points=2
Четыре разные строки, три различных счета единиц, по одной графеме. Валидатор, ограничивающий имя двадцатью единицами, отклонил бы пять семейных эмодзи, которые человек читает как пять символов; валидатор с лимитом в двадцать графем принял бы их и сохранил сорок единиц и двадцать пять кодовых точек. Лимит и читатель измеряют разное, и оба защитимы, пока запись говорит, что именно использовалось.
Где ключ промахивается на идентичном тексте
Две строки é уже предполагают режим отказа, и вторая проба измеряет его напрямую:
NFC equal: true
raw equal: false
name keys equal raw: false | nfc equal: true
Set size with two spellings: 2
Set size after NFC: 1
Два написания одного имени неравны как строки и равны после NFC. В Set как ключи они дают две записи; пропущенные сначала через normalize('NFC') дают одну. Это весь механизм за дубликатом аккаунта, который не находит инструмент поддержки, за кешем, который промахивается на каждом запросе, потому что клиент присылает другое написание, и за списком блокировок, который не срабатывает, потому что запись набрана на клавиатуре, которая компонует, а трафик приходит с той, которая не компонует.
Ничего в этом отказе не экзотично. Клавиатура macOS обычно дает разложенный текст для акцентированных латинских букв, клавиатура Windows обычно дает предкомпонованный, а копирование из PDF может дать любой в зависимости от отображения глифов шрифта. Оба написания выглядят на экране одинаково и сравниваются как неравные в любом языке, который сравнивает строки по единице кода.
Исправление не в том, чтобы нормализовать все везде, потому что NFKC меняет символы, которые некоторые системы считают разными, и нормализация может сломать побайтовую подпись. Исправление в том, чтобы нормализовать на границе, где решается идентичность: ключ поиска, значение записи кеша, сравнение в проверке дубликатов. Запись должна говорить, какую форму она сохранила, потому что сохраненную нормализованную строку нельзя сравнить с ненормализованной, не нормализовав снова.
Где одиночный суррогат становится символом замены
Нормализация не исправляет недопустимый текст. Строка с одиночным суррогатом не является правильно сформированной, и проба показывает и проверку, и потерю:
lone-surrogate isWellFormed=false units=3
lone-surrogate bytes=61 ef bf bd 62
replacement count=1
isWellFormed() возвращает false, а TextEncoder пишет ef bf bd вместо плохой единицы: один символ замены U+FFFD. Кодирование ничего не бросает. Страница, которая отправляет такую строку на сервер, отправляет строку, отличную от той, которую держала, и ничто в вызове не сообщило о подстановке.
Эта молчаливая подстановка и есть причина, по которой круговой обмен может изменить значение. Кодировать, передать, декодировать, и возвращенный текст уже не равен входному, при этом каждый шаг завершился успешно. Fixture, который проверяет только «запрос завершился», этого не заметит; fixture, который сравнивает строку до кодирования со строкой после декодирования, заметит, и разница это ровно символы замены.
У подстановки есть и следствие для счета, которое легко упустить. Строка с одним одиночным суррогатом и строка с одним символом замены обе занимают три единицы во входе пробы, поэтому проверка длины проходит, хотя значение отличается. Два символа замены из двух плохих единиц дают строку, которая уже не проходит круговой обмен вовсе, а повторный цикл кодирования и декодирования не добавляет новых замен, то есть fixture, который кодирует дважды и сравнивает, дает ложное прохождение на данных, поврежденных уже на первом проходе.
Нарезка строк это самый частый способ случайно создать такую фигуру. Разрез строки из трех единиц на индексе два или взятие первых четырех из пяти может разорвать суррогатную пару и оставить половину в одиночестве. Полученная строка остается допустимой строкой JavaScript ожидаемой длины, поэтому ничего не бросает; это раскрывает только isWellFormed() или сравнение байтов после кодирования. Fixture, который обрезает пользовательский текст до бюджета отображения без проверки границы, даст ровно этот дефект на любом входе с символом вне BMP рядом с разрезом.
Где регистр меняет длину строки
Смена регистра это не посимвольная подстановка, сохраняющая длину, и три частых символа показывают три разных поведения:
case "ß" upper="SS" upperUnits=2 lower="ß" lowerUnits=1
case "İ" upper="İ" upperUnits=1 lower="i̇" lowerUnits=2
case "Dž" upper="DŽ" upperUnits=1 lower="dž" lowerUnits=1
Немецкая эсцет разворачивается в две буквы в верхнем регистре. Турецкая заглавная I с точкой сохраняет одну единицу в верхнем регистре, но разворачивается в две единицы в нижнем в английской локали, потому что нижняя форма это i плюс комбинирующая точка. Титульный диграф меняет один символ на другой без изменения длины. Три символа, три исхода, и только один сохраняет счет единиц.
Система, которая хранит ключ без учета регистра, переводя в верхний регистр, изменит поэтому длину некоторых идентификаторов, а система, которая ограничивает длину до смены регистра, может отклонить идентификатор, ставший длиннее после. Оба легко исправить, когда известно расширение, и оба невидимы, если единственный тестовый вход это ASCII.
Измерение локали ухудшает это способом, который легко упустить, потому что одна и та же буква отображается по-разному в зависимости от переданной локали:
case "I" lower(tr)="ı" upper(tr)="I" lower(en)="i"
case "i" lower(tr)="i" upper(tr)="İ" lower(en)="i"
case "İ" lower(tr)="i" upper(tr)="İ" lower(en)="i̇"
case "ı" lower(tr)="ı" upper(tr)="I" lower(en)="ı"
В турецкой локали I в нижнем регистре дает ı без точки, а i в верхнем дает İ с точкой, тогда как в английской обе отображаются в привычную пару. Третья строка самая острая: İ в нижнем регистре дает одну единицу по-турецки и две по-английски. Сравнение без учета регистра, фиксирующее локаль, получает одно поведение; сравнение, полагающееся на локаль по умолчанию, получает то, что выбрал рантайм, и оно может отличаться от того, что сообщает профиль.
Текст также доходит до страницы через стек шрифтов прежде, чем любой из этих счетов начнет иметь значение, и одна и та же строка может измеряться иначе, когда глифы приходят из другого начертания. Рендеринг шрифтов CJK описывает, как стек меняет измерение, а данные локали API Intl и переносимый формат описывает сторону форматирования той же зависимости от локали, о которой этот раздел.
Где сопоставление и сегментация зависят от локали
Сортировка это третье место, где локаль меняет ответ, и проба показывает три разных порядка для одних и тех же четырех слов:
sort en: apple < äpple < zebra < Zebra
sort sv: apple < zebra < Zebra < äpple
sort default: Zebra < apple < zebra < äpple
en compare zebra/Zebra: -1
Английская локаль ставит äpple сразу после apple, шведская ставит его в конец, потому что ä это отдельная буква после z, а сортировка по умолчанию ставит Zebra первой, потому что сравнивает единицы кода и заглавная Z идет раньше строчной a. Список, который страница выводит отсортированным, будет поэтому различаться между двумя сессиями, отличающимися только локалью, а сравнение снимков этого списка покажет разницу, целиком относящуюся к сопоставлению.
Тот же сопоставитель решает и равенство, когда отображение индексируется по отсортированному тексту, потому что Intl.Collator возвращает ноль для строк, которые сравнение по умолчанию считает разными. Проба измеряет и это, на четырех уровнях чувствительности:
sensitivity base: e-acute vs e=0 a vs A=0
sensitivity accent: e-acute vs e=1 a vs A=0
sensitivity case: e-acute vs e=0 a vs A=-1
sensitivity variant: e-acute vs e=1 a vs A=-1
На базовой чувствительности обе пары сравниваются равными, поэтому ключ, построенный таким сопоставителем, слил бы é с e и a с A. На чувствительности к акценту пары расходятся в противоположных направлениях. Функция «поиска дубликатов», построенная на сопоставителе с неверной чувствительностью, сливает или разделяет ровно те случаи, которые должна была обрабатывать, и настройка невидима в выводе.
Сегментация слов добавляет еще одно число, которое расходится с очевидным токенизатором:
word segments=5 ["Version","155.0.0","ships","café","file"]
whitespace tokens=6 vs segmenter words=5
Разделение по пробелам дает шесть токенов, а сегментатор дает пять сегментов вида слова, и весь разрыв это обведенная цифра ①, которую сегментатор помечает isWordLike false. Если ее убрать, оба счета станут пять, а замена лигатуры fi на f тоже оставляет оба на пяти, значит лигатура не причина. «Число слов», записанное в fixture, целиком зависит от метода, который его дал.
Числовое сопоставление это последний переключатель, меняющий порядок, и меняет он сильно:
numeric on: 1.2.0 < 1.9.0 < 1.10.0
numeric off: 1.10.0 < 1.2.0 < 1.9.0
С включенным числовым сравнением версии сортируются так, как ожидает страница релизов. Без него они сортируются как текст, и 1.10.0 идет перед 1.2.0. Список версий, отсортированный сопоставителем без числовой опции, выглядит неверным для любого читателя и остается внутренне согласованным, что делает его трудным для обнаружения в diff.
Как записать чтение текста без преувеличения
Чтение текста подтверждает узкое утверждение: этот рантайм, этот ICU, эта версия Unicode и эта локаль с этим входом дали эти четыре числа. Оно не говорит, что читатель видит то же самое, что другая сборка совпадет или что сервер нормализовал строку так же.
Храните шесть полей, и запись останется проверяемой. Версии рантайма, ICU и Unicode, потому что таблицы регистра, сопоставления и сегментации идут с ними. Вход как передан, желательно как кодовые точки, а не как отрисованный текст, потому что два входа могут выглядеть одинаково. Четыре длины с названным методом для каждой. Локаль и чувствительность сопоставителя, потому что обе меняют ответ. Форму нормализации, примененную на границе. И то, дал ли путь кодировщика символ замены, потому что эта подстановка меняет значение без ошибки.
Страница документации описывает, как BotBrowser выравнивает поверхности шрифтов и navigator с загруженным профилем. Этот разбор добавляет сторону чтения: что рантайм делает с текстом, который несут эти поверхности, какую из четырех длин возвращает конкретный API и где локаль решает сравнение, которое читатель считает фиксированным. Согласованная настройка и правильное чтение получившейся строки это разные вопросы.
Для любого решения о реальной сессии используйте разрешенный интеграционный результат системы, которая решает, вместо экстраполяции из этой пробы. Длина, записанная в fixture, и производственный вердикт это разные виды свидетельства.
Practical conclusion
Записывайте версии рантайма, ICU и Unicode, вход как кодовые точки, четыре длины с их методами, локаль и чувствительность сопоставителя, форму нормализации на границе и то, написал ли кодировщик символ замены. В этой сборке é имеет два разных счета единиц, набор из двух записей сжимается в одну после NFC, семейное эмодзи это восемь единиц и одна графема, одиночный суррогат кодируется в один символ замены без ошибки, регистр может удвоить длину, а порядок сопоставления зависит от локали.
Sources
- MDN: String.prototype.normalize
- MDN: Intl.Segmenter
- MDN: Intl.Collator
- Unicode Standard Annex 15: формы нормализации
- Unicode Standard Annex 29: сегментация текста
- MDN: TextEncoder
- Документация BotBrowser о шрифтах
Next reading
Используйте рендеринг шрифтов CJK для того, как один текст измеряется по-разному в разных стеках шрифтов, и данные локали API Intl и переносимый формат для стороны форматирования той же зависимости от локали.
Эта статья входит в руководство: Что такое отпечаток браузера?
Похожие статьи
ICU: псевдонимы часовых поясов и TZ, который вы отдаете
Отпечаткиua-parser-js: Client Hints, боты и предел 500
ОтпечаткиВоспроизводимость шумового зерна для повторяемых запусков
ОтпечаткиКак hardwareConcurrency раскрывает реальные ядра вашего CPU
ОтпечаткиFingerprinting измерения текста: субпиксельное отслеживание
ОтпечаткиДетерминированный режим: воспроизводимые отпечатки
Переведите BotBrowser из исследований в продакшн
Используйте эти руководства, чтобы понять модель, а затем перейти к кроссплатформенной валидации, изолированным контекстам и масштабируемому браузерному развертыванию.