Разбор URL и search params: что меняет обход
Разберите необычные URL и строки запроса, чтобы увидеть, где new URL бросает, что перезаписывает нормализация, как идут дубли ключей и порядок, и почему set не равен присваиванию.
BotBrowser Team
Нужна структурированная документация по теме Отпечатки?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
BotBrowser поддерживает повтор разрешенного fixture на том же origin под объявленным профилем и сохраняет ограниченные наблюдения о том, какой URL разобрала страница и что переписал разборщик, но он не меняет то, как среда реализует алгоритм URL из WHATWG, не может разрешить относительную строку без базы и не превращает нормализованный URL в признак личности. Этот разбор проверяет набор неудобных URL и строк запроса, а затем фиксирует, где именно new URL бросает, какие символы перезаписывает нормализация, как выживают дубли ключей и знаки плюс, и почему установка параметра запроса отличается от присваивания сырой строки запроса.
Кратко
new URLс относительной строкой и без базы бросаетTypeError. Та же строка разрешается относительно базы, а пробелы в пути становятся%20.- Разбор это нормализация, а не идентичность:
HTTPS://Example.TEST:443/a/../b/./cстановитсяhttps://example.test/b/c, теряя порт по умолчанию и разрешая сегменты с точками. URLSearchParamsсохраняет дубли ключей, трактует+как пробел и кодирует&и=внутри значения при сериализации.sort()переупорядочивает по ключу; порядок вставки сохраняется до вызова, поэтому обход может изменить строку, не меняя данные.searchParams.setкодирует значение иначе, чем присваиваниеurl.searchв сыром виде: первый кодирует пробелы по процентам, второй оставляет их разборщику.
Содержание
- Где new URL бросает и где база спасает
- Что перезаписывает нормализация
- Дубли ключей, знаки плюс и кодирование значений
- Порядок и стоимость обхода
- Установка параметра против присваивания search
- Записывайте показания URL
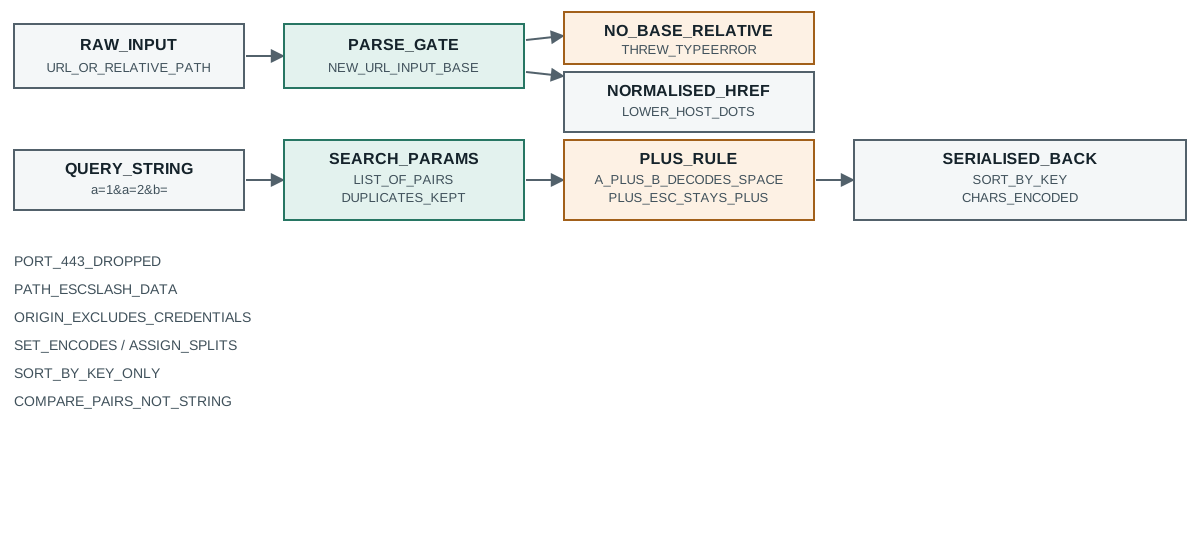
Где new URL бросает и где база спасает
У конструктора две формы, и только одна может разрешить относительную ссылку. Без базы вход уже должен быть абсолютным URL; строка только с путем не к чему присоединить, и разборщик бросает: Разобранный URL это тоже значение, которое нужно скопировать перед сохранением, и structuredClone против JSON показывает, какие типы и ссылки сохраняет глубокая копия и какие тихо теряет обход через JSON.
new URL("/a/b?x=1", undefined) -> "THREW TypeError"
new URL("/a/b?x=1", "https://example.test") -> "https://example.test/a/b?x=1"
new URL("a b", "https://example.test/dir/") -> "https://example.test/dir/a%20b"
new URL("../../x", "https://example.test/a/b/c") -> "https://example.test/x"
Первая строка это частая ошибка: код, который получает значение из конфигурации, поля формы или ссылки и вызывает new URL(value) без базы, бросит для каждого относительного пути, а блок try, глотающий ошибку, превращает неверный URL в тихий undefined. Вторая строка показывает исправление, разрешая ту же строку относительно базы.
Третья и четвертая строки показывают, что разрешение это не конкатенация строк. Пробел в относительном пути кодируется по процентам в %20, а ../../x поднимается на три уровня от /a/b/c, давая /x, а не буквальное добавление. Кто ожидает, что сырой вход переживет обход через конструктор, удивится в обоих случаях, потому что выход это нормализованный URL, а не переданная строка.
Это различие важно для проверок равенства. Две строки, адресующие один ресурс, могут разбираться в один href, а одна строка может разбираться в другой href после нормализации. Fixture, который сравнивает входную строку с выходной, чтобы доказать, что ничего не изменилось, упадет на любом входе, которому нужна нормализация, а тот, что сравнивает два разобранных URL, чтобы доказать их эквивалентность, может пройти даже когда входы выглядели разными.
Что перезаписывает нормализация
Разборщик переводит схему и хост в нижний регистр, отбрасывает порт по умолчанию, разрешает сегменты с точками и кодирует по процентам символы, недопустимые в каждом компоненте. Четыре входа показывают перезаписи рядом:
raw="HTTPS://Example.TEST:443/a/../b/./c"
  href="https://example.test/b/c"
  origin="https://example.test" protocol="https:" port=""
raw="https://example.test/a%2Fb?q=a b#frag ment"
  href="https://example.test/a%2Fb?q=a%20b#frag%20ment"
  pathname="/a%2Fb" search="?q=a%20b" fragment="#frag%20ment"
raw="https://user:[email protected]/x"
  username="user" password="pass"
Первый вход теряет три вещи сразу: схема и хост в верхнем регистре становятся строчными, явный :443 исчезает, потому что это порт по умолчанию для https, а /a/../b/./c сворачивается в /b/c. Кто сохранил исходную строку и сравнивает ее с href, увидит расхождение, которое целиком есть нормализация.
Второй вход показывает более тонкий момент. Кодированный слэш %2F в пути выживает без изменений, потому что это намеренный escape символа, который иначе изменил бы структуру пути; сырой пробел в запросе и фрагменте становится %20; и пробел во фрагменте тоже кодируется. Так путь сохраняет кодированный слэш, а запрос и фрагмент кодируют буквальный пробел. Наивный проход «кодировать все» или «декодировать все» по всему URL испортил бы %2F, и именно поэтому разборщик обрабатывает каждый компонент по своим правилам.
Третий вход показывает, что учетные данные разбираются в username и password и обратно сериализуются в href, а origin их исключает. Это важно для журнала: origin безопасно записывать и сравнивать, а href может нести имя пользователя и пароль, которые не следует писать в журнал или в запись fixture. Показания, которые хранят href для URL с учетными данными, хранят секрет; те, что хранят origin и pathname, нет.
У каждого компонента свой набор правил, и это причина, по которой один проход кодирования или декодирования по всему URL небезопасен. Схема и хост сравниваются и хранятся в нижнем регистре; порт отбрасывается, когда равен значению по умолчанию для схемы; путь разрешает сегменты с точками и хранит кодированный слэш как данные; запрос применяет правило плюса к пробелу и кодирует зарезервированные символы; а фрагмент кодирует сырой пробел, но сохраняет структуру фрагмента. Кто берет весь href, применяет decodeURIComponent и передает результат в new URL, обычно получит другой URL, потому что шаг декодирования превращает кодированные слэши и амперсанды в символы, которые разборщик читает как структуру. Безопасная единица это компонент, а не вся строка.
Эта компонентная модель также объясняет, почему два URL, которые выглядят разными, могут быть идентичны после разбора. HTTPS://Example.TEST:443/b/c и https://example.test/b/c дают один href, потому что разборщик переводит в нижний регистр и отбрасывает порт по умолчанию прежде всего остального. Шаг дедупликации, сравнивающий сырые строки, сочтет их разными и сохранит обе, а шаг, сравнивающий разобранные href, их схлопывает. Что верно, зависит от цели: ключ кэша хочет схлопнутую форму, чтобы обе записи попали в одну запись, а журнал аудита может хотеть сырую форму, чтобы сохранить исходный вход. Запись должна говорить, какую форму хранит.
Дубли ключей, знаки плюс и кодирование значений
URLSearchParams это список пар, а не карта, и из этого следует несколько поведений. Дубли ключей выживают, пустое значение присутствует, но пусто, а значение, содержащее & или =, кодируется по процентам при сериализации списка:
params.getAll(a) -> ["1","2"]
params.get(b) -> ""
params.get(c) -> "&="
params.toString() -> "a=1&a=2&b=&c=<encoded ampersand><encoded equals>"
getAll возвращает оба значения a, так что код с get('a') видит только первое и тихо отбрасывает остальные. get('b') возвращает пустую строку, которая отличается от null для отсутствующего ключа: одиночный b= присутствует с пустым значением, и код, проверяющий if (value), считает оба ложными. Значение, которое декодировалось в &=, обратно сериализуется с амперсандом и равно, закодированными снова, так что сырая строка проходит обход, но декодированное значение показывает символы, которые вызывающий код действительно хотел.
Знак плюс это другая ловушка. В строке запроса + означает пробел, так что значение, которое законно содержит знак плюс, должно кодироваться по процентам как %2B:
searchParams from a+b -> "a b"
Map-like set round trip -> "q=a%2Bb"
Первая строка показывает new URLSearchParams('q=a+b').get('q'), возвращающий "a b", потому что разборщик прочитал плюс как пробел. Вторая показывает, что построение того же списка из объекта со значением a+b сериализует его в q=a%2Bb, так что плюс сохраняется как данные. Асимметрия это дефект: кто строит запрос конкатенацией, пишет q=a+b и потом читает a b, а кто идет через URLSearchParams и объект значений, сохраняет плюс. Два пути расходятся на одном и том же задуманном значении, и только один проходит обход.
Три разных escape декодируются в два разных символа, и только показания, перечисляющие их отдельно, ловят разницу. Сырой + декодируется в пробел, %20 декодируется в пробел, а %2B декодируется в плюс. Так что q=a+b, q=a%20b и q=a%2Bb это три разные кодировки: первые два несут значение a b, а третья несет a+b. Кто нормализует запрос, декодируя его и перекодируя универсальным кодировщиком, схлопывает первые два в одну форму и может потерять или изобрести плюс в третьей, в зависимости от кодировщика. Записанная форма ?a=%2B+%20 из дампа разбора это ровно тот триплет в одном параметре: знак плюс, затем пробел, затем пробел, декодированные из %2B, + и %20 соответственно, и перекодирование, трактующее все три как данные, изменило бы строку, хотя декодированное значение не меняется.
Дубли ключей взаимодействуют с тем же декодированием. Запрос a=1&a=2&b= разбирается в три пары, две с ключом a и одну с ключом b и пустым значением, и обратно сериализуется в идентичную строку a=1&a=2&b=. Эта идентичность стоит записи, потому что это исключение, а не правило: эта строка уже в канонической сериализации, так что разбор и обратная сериализация оставляют ее прежней, а строка с сырым пробелом или неканоническим escape изменилась бы. Fixture, использующий только уже канонические входы, никогда не увидит нормализацию, и поэтому хотя бы один неканонический вход принадлежит набору.
Порядок и стоимость обхода
У списка есть порядок вставки, и sort() переупорядочивает его по ключу. До вызова sort() порядок это тот, в котором добавляли:
insertion order -> "k9=9&k8=8&k7=7&k6=6&k5=5&k4=4&k3=3&k2=2&k1=1&k0=0"
sorted order -> "k0=0&k1=1&k2=2&k3=3&k4=4&k5=5&k6=6&k7=7&k8=8&k9=9"
Десять ключей, добавленных в убывающем порядке, сериализуются в этом порядке, и sort() превращает их в возрастающий. Данные идентичны до и после; меняется только сериализованная строка. Это стоимость обхода: если fixture строит запрос, сериализует его, разбирает снова и сравнивает строки, сравнение может упасть только из-за порядка. Fixture, сравнивающий набор пар, а не строку, стабилен.
Есть второе следствие для дублей ключей. sort() стабилен для ключей, которые сравниваются равными, так что две записи с одним ключом сохраняют относительный порядок вставки после сортировки. Кто ожидает, что sort() также упорядочит значения внутри дублирующего ключа, этого не получит; значения остаются в порядке добавления, и меняется только группировка ключей.
Эта стабильность проверяема и стоит сказать прямо: после sort() строка a=1&a=2 остается a=1&a=2, а не a=2&a=1, потому что два ключа сравниваются равными и порядок стабилен. Кто хочет упорядоченные значения внутри дублирующего ключа, должен отсортировать их отдельно перед добавлением, а кто предполагает, что sort() это сделал, выпустит нестабильный вывод, который меняется между запусками по мере изменения порядка вставки. Правило для записи: sort() сортирует только по ключу, а равные ключи сохраняют порядок входа.
Длина это еще одна причина, по которой обход не есть преобразование. Разбор запроса в список и обратная сериализация может изменить длину строки, даже когда пары идентичны, потому что один %20 становится +, а сырой пробел становится %20 в зависимости от пути. Fixture, который утверждает фиксированную длину в байтах после обхода, пройдет на одних входах и упадет на других по причинам, не имеющим отношения к дефекту. Измерение числа пар и набора ключей сохраняет утверждение стабильным среди вариантов кодирования, которые все верны.
Установка параметра против присваивания search
Есть два способа изменить запрос у объекта URL, и они кодируют по-разному:
set("q","a b+c&d=e") href -> "https://example.test/?q=a+b%2Bc%26d%3De"
search = "?q=a b+c&d=e" href -> "https://example.test/?q=a%20b+c&d=e"
Первая строка идет через searchParams.set, который кодирует значение по правилам строки запроса: пробел становится +, плюс становится %2B, а & и = становятся %26 и %3D, так что все значение остается внутри одного параметра. Вторая строка присваивает url.search напрямую сырую строку, так что разборщик видит & и = как разделители: значение становится a b (с пробелом, закодированным в %20), а c и d становятся отдельными параметрами.
Два результата это не один и тот же URL, и разница не косметическая. set сохраняет задуманное значение нетронутым; сырое присваивание делит его на три параметра, потому что символы, разделяющие параметры, это те, которые вызывающий код хотел как данные. Кто строит строку запроса вручную и присваивает ее, должен закодировать по процентам каждый зарезервированный символ перед присваиванием, а кто использует set, передает сырое значение и позволяет API его закодировать.
Есть также различие в пробелах, которое стоит отметить. set дал + для пробела, а сырое присваивание дало %20. Оба декодируются в пробел, но две сериализации различаются, так что побайтовое сравнение двух значений href падает, хотя они несут один логический параметр. Это еще одна причина сравнивать разобранные значения, а не сериализованные строки.
Записывайте показания URL
Показания URL, выдерживающие ревью, говорят, что разобрано и что изменилось. Шесть полей покрывают наблюдаемую часть, и ни одно не хранит учетные данные:
- Входная строка и использованная база, или факт, что база не дана и разбор бросил.
- Полученные
origin,pathname,searchиfragment, записанные отдельно, а не однимhref, чтобы учетные данные и нормализация были видны. - Список пар запроса как записи
[key, value], включая дубли и пустые значения, а не одну восстановленную строку. - Был ли пробел
+или%20в сериализованном запросе, потому что оба декодируются одинаково, но сериализуются по-разному. - Порядок пар и вызывался ли
sort(), так как порядок меняет строку, не меняя данные. - Как изменен запрос, через
searchParams.setили сырое присваиваниеsearch, потому что оба кодируют зарезервированные символы по-разному.
Чего такая запись не может показать, так это ничего о том, как сервер или прокси истолкует тот же URL. Клиент разбирает одним способом, серверный фреймворк может декодировать и переразобрать запрос по своим правилам, а редирект может переписать строку в пути. О более широком вопросе, как разобранный URL страницы взаимодействует со строками, которые она сообщает, читайте обнаружение протокола URL и приватность и границы btoa и atob, где описан слой кодирования, через который проходят значения запроса.
Две привычки сохраняют честность чтения во времени. Первое, записывайте origin и список пар, а не один href, чтобы нормализация и учетные данные были видны, а не сливались в непрозрачную строку. Второе, сравнивайте разобранные пары, а не сериализованные строки, чтобы порядок и выбор + против %20 не превратили верный обход в ложную ошибку.
Публичные источники
- MDN: URL
- MDN: URLSearchParams
- Стандарт URL от WHATWG
- RFC 3986: синтаксис унифицированного идентификатора ресурса
- MDN: encodeURIComponent
Итоги
Всегда давайте базу, когда URL может быть относительным, и ожидайте, что разборщик нормализует, а не сохраняет входную строку. Рассматривайте URLSearchParams как список пар, чтобы дубли ключей и пустые значения выживали, и помните, что + декодируется в пробел. Используйте searchParams.set для изменения значения и позволяйте ему кодировать зарезервированные символы, или сами кодируйте каждый зарезервированный символ перед присваиванием search. Записывайте origin и список пар, а не один href, и сравнивайте разобранные пары, а не сериализованные строки.
Эта статья входит в руководство: Что такое отпечаток браузера?
Похожие статьи
btoa и atob: границы Latin-1 и дополнение на практике
Отпечаткиua-parser-js: Client Hints, боты и предел 500
ОтпечаткиstructuredClone против JSON: что сохраняет глубокая копия
ОтпечаткиUnicode: четыре идентичности одного текста
ОтпечаткиБезопасная обработка внешних URL в профилях
Отпечаткиwebgl_debug_renderer_info: что GPU раскрывает страницам
Переведите BotBrowser из исследований в продакшн
Используйте эти руководства, чтобы понять модель, а затем перейти к кроссплатформенной валидации, изолированным контекстам и масштабируемому браузерному развертыванию.