DataView : ordre des octets, alignement et bornes
Une sonde sur des tampons fixes : ordre par défaut, lectures non alignées, erreurs de bornes, précision des flottants, tampons partagés, vues décalées et getters BigInt.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
BotBrowser prend en charge la relecture d’un fixture autorisé du même origine sous un profil déclaré et conserve une trace bornée de l’agencement binaire qu’une page a lu et dans quel ordre d’octets, mais il ne peut pas changer l’ordre d’octets qu’utilise un protocole, ne peut pas faire qu’un tableau typé tolère un décalage non aligné, et ne peut pas récupérer un champ une fois qu’une lecture hors bornes a levé une exception. Cette revue exécute une sonde sur neuf tampons fixes et consigne l’ordre d’octets par défaut contre un ordre explicite, le fait que les lectures non alignées fonctionnent alors qu’une vue de tableau typé refuse, qu’une lecture hors bornes lève une exception alors qu’un tableau typé abandonne silencieusement l’écriture, quelle précision chaque largeur de flottant donne, comment une vue et un tableau typé partagent un tampon, ce que rapporte une vue décalée, comment les octets deviennent du texte, et ce qu’apportent les getters BigInt.
Résumé
setUint32écrit l’octet de poids fort en premier par défaut, donc0x01020304se range comme01020304et se relit16909060en big-endian contre67305985en little-endian.- Un
DataViewlit à n’importe quel décalage, doncsetUint32(1, ...)fonctionne, tandis qu’unUint32Arrayau décalage un lève uneRangeError. - Un
getUint32hors bornes lève uneRangeError, tandis quetyped[10] = 7sur un tableau de quatre octets est abandonné silencieusement et la longueur reste quatre. Float32ne peut pas contenir0.1exactement et se relit0.10000000149011612, tandis queFloat64se relit0.1, donc la largeur qu’utilise un champ fait partie de son sens.- Un
DataViewet unUint8Arraysur le même tampon voient leurs écritures mutuelles, donc une écriture d’octet change ce que lit la vue. - Une vue décalée rapporte son propre
byteLengthetbyteOffsettandis quebuffer.byteLengthreste toute l’allocation, et une lecture un cran après la fin de la vue lève une exception. - Les octets ne sont pas du texte : les mêmes quatre octets se décodent comme
hiéen UTF-8 ethiéen latin1. getBigUint64renvoie unBigInt, et lui ajouter unNumberlève uneTypeError.
Sommaire
- Quel ordre d’octets un DataView écrit par défaut
- Où une vue est plus permissive qu’un tableau typé
- Ce que coûte chaque largeur en précision
- Ce qu’une vue décalée rapporte et comment le tampon est partagé
- Comment les octets deviennent du texte et où entre BigInt
- Consigner une lecture binaire
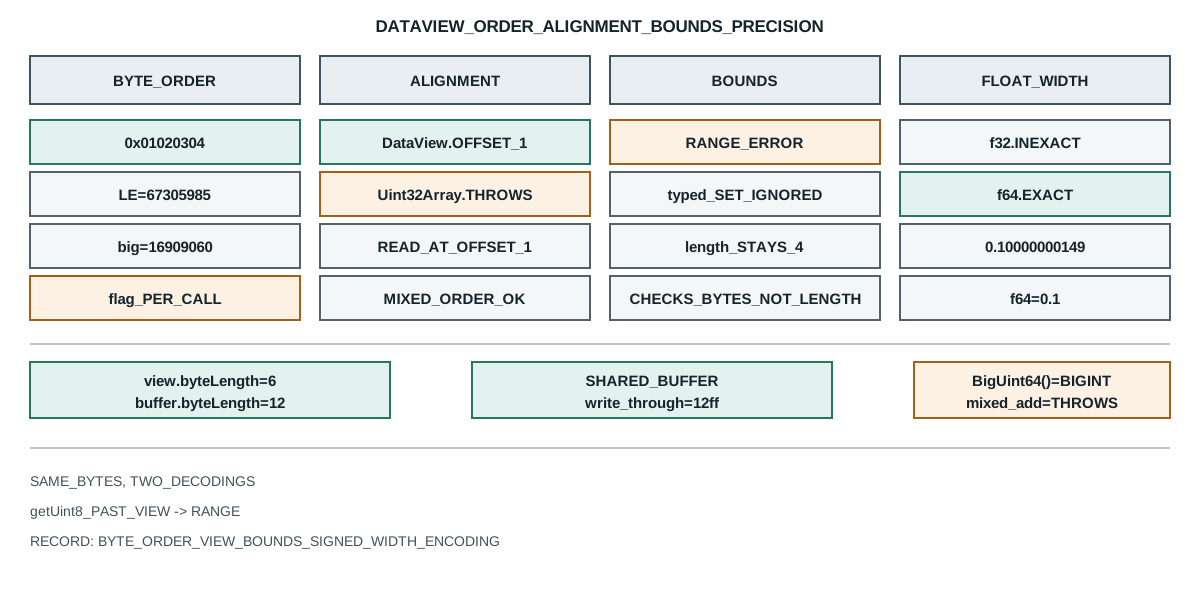
Quel ordre d’octets un DataView écrit par défaut
DataView choisit l’ordre des octets à chaque appel, et par défaut c’est le big-endian. La sonde écrit un entier puis le relit des deux façons :
node=v26.9.0
default-bytes -> 01020304 readLE=67305985 readBE=16909060
unaligned-read -> deadbeef
typed-aligned-required -> RangeError
bounds -> dataview=RangeError typed-set-ignored=true length=4
float-precision -> f32=0.10000000149011612 f64=0.1 f32-exact=false
method-set -> Int8,Uint8,Int16,Uint16,Int32,Uint32,Float32,Float64,BigInt64,BigUint64
shared-buffer -> bytes=12340000 view=1234
write-through -> view-after-byte-write=12ff
offset-view -> byteLength=6 byteOffset=4 bufferByteLength=12
getUint8-at-view-end -> 0 end-throws=RangeError
decode -> utf8=hié latin1=hié bytes=4
bigint -> value=18446744073709551615 mixed-add=TypeError
Les quatre octets sur le fil sont 01 02 03 04 dans l’ordre mémoire, et la même mémoire se lit comme deux nombres différents selon le drapeau. 16909060 vaut 0x01020304, la lecture qui correspond à l’écriture, et 67305985 vaut 0x04030201, les mêmes octets lus à l’envers. Donc l’écriture a placé l’octet de poids fort de 0x01020304 au décalage zéro. Un lecteur qui passe true là où l’écrivain a utilisé le défaut voit l’entier inversé octet par octet, et l’erreur est invisible dans un vidage hexadécimal parce que les octets semblent corrects.
Cette asymétrie est pourquoi un champ réseau a toujours son ordre d’octets écrit dans la spécification, tandis qu’un format de fichier écrit par un processus local hérite en général de l’ordre de l’hôte. Le défaut est big-endian, ce qui coïncide avec la plupart des en-têtes réseau et est l’inverse de l’ordre de l’hôte sur toute cible grand public actuelle, donc une page qui omet le drapeau lit à l’envers un fichier binaire écrit localement. Passer le drapeau explicitement est la seule façon pour un enregistrement de déclarer ce qu’il a lu, dans un sens comme dans l’autre.
Il y a une conséquence de second ordre qui attrape un lecteur qui se souvient pourtant du drapeau. Le drapeau est par appel, pas par vue, donc un même DataView peut lire son premier champ en big-endian et son second en little-endian, et les deux sont légitimes. Un format binaire avec un en-tête big-endian hérité suivi d’un corps little-endian a exactement cette forme, et un analyseur qui fixe l’ordre une fois, à la construction, n’a aucun moyen de l’exprimer. Le drapeau doit voyager avec le champ, ce qui signifie que la table de champs de l’analyseur doit nommer l’ordre à côté de la largeur et du signe.
Les méthodes de flottant prennent le même drapeau, et l’échec y est encore plus discret. Un Float32 écrit en big-endian et lu en little-endian ne lève pas d’exception et ne produit pas un entier faux reconnaissable ; il produit un petit dénormal ou une valeur énorme, tous deux ressemblant à des mesures plausibles jusqu’à ce que la page les compare à une plage. Un lecteur qui valide un flottant contre des bornes attendues ne détecte la collision que lorsque les bits inversés tombent hors de la plage, et une page qui fait aveuglément confiance à la valeur n’a aucune détection.
Où une vue est plus permissive qu’un tableau typé
Un DataView n’exige pas que son décalage soit aligné sur la largeur qu’il lit, alors qu’une vue de tableau typé l’exige. La sonde écrit et lit un entier au décalage un :
unaligned-read -> deadbeef
typed-aligned-required -> RangeError
Le DataView a lu les quatre octets à partir du décalage un et renvoyé la valeur qu’il avait écrite. Le Uint32Array sur le même tampon au même décalage a levé une RangeError, parce qu’une vue de tableau typé exige que son byteOffset soit un multiple de la taille de son élément. C’est la différence structurelle : un DataView est un curseur sur des octets, et un tableau typé est une fenêtre qui doit s’aligner sur sa propre grille d’éléments.
La sémantique des éléments du tableau typé est traitée par ArrayBuffer et vues de tableau typé. Le choix entre les deux en découle. Un analyseur qui parcourt un en-tête champ par champ avec des largeurs mixtes et sans remplissage utilise un DataView. Une page qui lit un grand bloc d’un seul type, comme un tampon de pixels ou un tableau d’échantillons, utilise un tableau typé et paie une fois l’exigence d’alignement. Une page qui a besoin des deux peut créer un DataView et plusieurs vues de tableau typé sur le même tampon, une pour chaque usage, parce qu’elles partagent toutes la mémoire.
La règle d’alignement a une conséquence de performance facile à inverser. Une lecture alignée de tableau typé peut correspondre à un seul chargement machine, tandis qu’une lecture DataView doit assembler les octets et peut être plus lente sur le même champ. C’est pourquoi une page qui analyse une boucle chaude d’un seul type d’élément utilise un tableau typé même quand le tampon n’est pas aligné au début, en avançant jusqu’au premier décalage aligné et en sautant les octets de tête, et pourquoi une page qui analyse un en-tête froid et à largeurs mixtes utilise un DataView et accepte le coût par champ. Les deux ne sont pas interchangeables à la même vitesse, et choisir l’un pour la raison de l’autre est une source courante d’analyseur lent et aussi difficile à corriger plus tard.
Les bornes se comportent différemment dans les deux, et la différence est la dangereuse. La sonde lit un entier après la fin et écrit un octet après la fin :
bounds -> dataview=RangeError typed-set-ignored=true length=4
La lecture DataView a levé une RangeError, ce qui arrête un analyseur au champ exact qui ne pouvait pas être lu. L’écriture du tableau typé à l’indice dix sur un tableau de quatre octets n’a rien fait du tout, et la longueur est restée quatre, donc une page qui remplit un tampon par indice et ne vérifie la longueur qu’après ne peut pas distinguer une écriture abandonnée d’une écriture réussie. Dans un chemin de code qui décode une entrée non fiable, le comportement qui lève une exception est celui qui échoue bruyamment et le silencieux est celui qui produit un résultat plausible mais faux.
Ce que coûte chaque largeur en précision
La vue expose dix types d’éléments, et les deux largeurs de flottant diffèrent par ce qu’elles peuvent représenter :
method-set -> Int8,Uint8,Int16,Uint16,Int32,Uint32,Float32,Float64,BigInt64,BigUint64
float-precision -> f32=0.10000000149011612 f64=0.1 f32-exact=false
Les deux largeurs ont reçu le même littéral 0.1, et seule la lecture soixante-quatre bits est revenue 0.1. La lecture trente-deux bits a renvoyé 0.10000000149011612, qui est la valeur la plus proche qu’un flottant trente-deux bits peut contenir. Une page qui lit un champ comme Float32, l’arrondit pour l’affichage et le compare à un 0.1 stocké obtient une discordance qui n’a rien à voir avec les données.
Les largeurs entières ont le même problème sous une autre forme. Int8 et Uint8 ne diffèrent qu’au-delà de 127, où la forme signée déborde vers le négatif, donc un octet que l’émetteur a écrit 200 se lit -56 via getInt8. Une page qui choisit le getter signé pour un champ que la spécification déclare non signé obtient un nombre négatif dans une plage documentée comme positive, et l’erreur n’apparaît qu’une fois qu’une valeur franchit le point médian.
Le cas Float64 montre aussi pourquoi une comparaison de deux flottants entre deux runtimes demande du soin. La valeur 0.1 n’est exactement représentable en binaire à aucune largeur, et la lecture soixante-quatre bits n’a affiché 0.1 que parce que l’affichage l’a arrondie. Un enregistrement qui stocke la valeur affichée plutôt que les bits bruts a stocké un nombre arrondi, et deux runtimes qui s’accordent sur l’affichage peuvent encore contenir des bits différents.
Le même point de précision décide comment un condensé ou une somme de contrôle se compare. Une page qui lit un mot de condensé trente-deux bits comme Float32 et le compare à un littéral stocké compare des valeurs arrondies, et deux condensés qui ne diffèrent que par les bits faibles peuvent se comparer égaux après l’aller-retour. Le remède est de garder un condensé binaire dans sa largeur entière, d’utiliser getUint32 plutôt qu’un getter flottant, et de comparer les entiers directement. Une somme de contrôle n’est jamais un flottant, et la lire comme un flottant est l’erreur qui fait passer une vérification qui devrait échouer.
Comment une vue et un tableau typé partagent un tampon
Un DataView détient une référence à un ArrayBuffer, pas une copie, donc toute autre vue sur ce tampon voit la même mémoire. La sonde écrit via le DataView puis via le Uint8Array :
shared-buffer -> bytes=12340000 view=1234
write-through -> view-after-byte-write=12ff
L’écriture big-endian de 0x1234 s’est rangée comme 12 34 00 00, ce que la vue d’octets a vu. Écrire 0xff sur le deuxième octet a changé l’entier que lit la vue en 0x12ff sans toucher du tout au DataView. Une page qui fait un instantané d’une vue et s’attend à ce qu’il reste stable à travers les écritures d’une autre vue a une valeur périmée ; une page qui s’appuie délibérément sur le partage a un moyen bon marché de réinterpréter la même mémoire.
Ce partage est pourquoi un DataView convient bien à un analyseur de protocole qui veut aussi une somme de contrôle au niveau des octets. L’analyseur lit des champs via la vue, et un Uint8Array sur le même tampon additionne les octets, et ni l’un ni l’autre ne copie le tampon. Le coût est que toute mutation est visible partout, donc un analyseur qui réécrit dans le tampon qu’il lit peut corrompre une somme de contrôle calculée plus tôt, à moins que l’ordre soit fixé.
Ce qu’une vue décalée rapporte et comment le tampon est partagé
Une vue peut être créée sur une tranche d’un tampon, et elle rapporte la tranche plutôt que l’allocation :
offset-view -> byteLength=6 byteOffset=4 bufferByteLength=12
getUint8-at-view-end -> 0 end-throws=RangeError
La vue couvre six octets à partir du décalage quatre, et son buffer.byteLength rapporte encore toute l’allocation de douze octets. Une page qui calcule un décalage de champ à partir de buffer.byteLength au lieu du byteLength propre à la vue lit au-delà de la tranche, ce qui est pourquoi la dernière ligne compte : lire l’indice six, un cran après les six octets de la vue, lève une exception même si le tampon sous-jacent a de la place. Ce sont les bornes de la vue, pas celles du tampon, qui décident ce qu’une lecture peut toucher.
Cette distinction est celle qui fait trébucher un sous-analyseur. Une fonction à qui l’on passe une vue sur une tranche de charge utile ne peut pas lire le champ suivant de la trame externe, parce que la vue se termine là où la tranche se termine, et l’exception est le seul signal que l’appelant a passé une vue plus étroite que ce que la fonction supposait. Un enregistrement qui stocke la longueur du tampon mais pas le décalage et la longueur de la vue ne peut pas reconstruire quelles lectures étaient légales.
Comment les octets deviennent du texte et où entre BigInt
Le côté texte du même tampon a sa propre frontière, que les limites d’atob et btoa traite pour le cas base64. Les octets ne sont pas du texte tant qu’un encodage n’est pas nommé, et les mêmes quatre octets se décodent de deux façons :
decode -> utf8=hié latin1=hié bytes=4
Les quatre octets sont 68 69 c3 a9. Lus comme UTF-8, ce sont h, i et la séquence de deux octets pour é, donnant hié. Lus comme latin1, chaque octet est son propre caractère, donnant hié. Une page qui décode un champ avec la mauvaise étiquette obtient une chaîne plausible plutôt qu’une erreur, donc un protocole qui ne nomme pas son encodage laisse le lecteur deviner entre deux réponses valides.
Les plus grands champs ont besoin de leurs propres getters, et ils changent le type de la valeur :
bigint -> value=18446744073709551615 mixed-add=TypeError
getBigUint64 a renvoyé la pleine valeur non signée soixante-quatre bits comme un BigInt, qui est la seule façon de la représenter, parce qu’un Number perd de la précision au-delà de 2^53. La sonde a ensuite ajouté 1 en tant que Number et obtenu une TypeError, qui est le langage refusant de mélanger silencieusement les deux types numériques. Une page qui lit un champ soixante-quatre bits et veut le comparer à un Number doit convertir délibérément, et la conversion est là où la précision se perd si elle a lieu.
La forme signée, getBigInt64, compte pour la même raison de l’autre côté de zéro. Un compteur soixante-quatre bits qui déborde, ou un horodatage signé d’un protocole qui autorise des valeurs négatives, a besoin du getter signé, et le lire non signé change un petit négatif en un énorme positif. Les deux getters lisent les mêmes huit octets et ne diffèrent que dans l’interprétation du bit de poids fort, donc une table de champs qui enregistre « entier soixante-quatre bits » sans le signe n’a pas enregistré assez pour reproduire la valeur.
Il y a une borne de plus qui vaut la peine d’être nommée. Un BigInt ne peut pas être passé au sérialiseur JSON, donc une page qui lit un champ soixante-quatre bits et essaie de journaliser l’objet analysé lève une exception sur le champ qui est un BigInt alors que tous les autres champs se journalisent bien. La route d’enregistrement doit convertir délibérément, généralement en chaîne décimale, et une page qui saute la conversion perd toute la ligne de journal plutôt que le seul champ. C’est la même forme que la vue décalée : l’échec est bruyant à la borne exacte, et l’enregistrement doit nommer le type pour l’expliquer.
Consigner une lecture binaire
Une lecture binaire étaye une affirmation étroite : ce runtime, ce tampon, ce décalage et cet ordre d’octets ont produit cette valeur. Cinq champs la gardent vérifiable :
- L’ordre d’octets avec lequel chaque champ a été lu, parce que le défaut est big-endian et qu’un champ d’un fichier little-endian se lit inversé octet par octet.
- Le décalage et la longueur de la vue, pas seulement du tampon, parce qu’une lecture après la fin de la vue lève une exception même quand le tampon a de la place.
- Le signe et la largeur de chaque champ entier, parce qu’une lecture signée d’un octet non signé change
200en-56. - La largeur du flottant, parce que
Float32etFloat64ne sont pas d’accord sur la valeur qu’ils renvoient pour le même littéral. - L’encodage du texte, parce que les mêmes octets sont
hiéen UTF-8 ethiéen latin1.
Sources publiques
- MDN : DataView
- MDN : DataView.prototype.getUint32
- MDN : DataView.prototype.getBigUint64
- MDN : ArrayBuffer
- ECMAScript : objets DataView
- BotBrowser : référence de cohérence de l’automatisation
Conclusion pratique
Passez le drapeau d’ordre d’octets à chaque lecture et écriture, parce que le défaut est big-endian et qu’un champ d’un fichier local little-endian ne l’est pas. Utilisez un DataView pour un en-tête à largeurs mixtes et un tableau typé pour un bloc homogène, et rappelez-vous que ce sont les bornes propres à la vue qui décident ce qu’une lecture peut toucher. Nommez le signe, la largeur et l’encodage du texte pour chaque champ, et traitez une lecture BigInt64 comme un type à part plutôt qu’un grand Number. Pour la vue d’éléments elle-même, lisez ArrayBuffer et vues de tableau typé ; pour convertir des octets en chaînes, lisez les bornes de atob et btoa.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
ArrayBuffer et TypedArray : un tampon, plusieurs vues
EmpreinteTextDecoder et TextEncoder : octets contre chaînes
EmpreinteICU : alias de fuseau et la TZ que vous rapportez
EmpreinteObservabilité de l’aléa cryptographique et empreintes du navigateur
EmpreinteTri de tableau et comparateurs : un piège subtil
Empreintebtoa et atob : la frontière Latin-1
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.