Source aléatoire de crypto-js : quelle branche
Lisez le code de crypto-js 4.2.0 et 3.1.2, puis mesurez la source d’entropie que chaque version appelle, le coût en appels d’une requête et ce qu’une doublure peut changer.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
BotBrowser prend en charge le rejeu d’un fixture autorisé de même origine sous un profil déclaré et la conservation d’observations bornées sur l’API qu’une page a appelée et à quelle fréquence. Il ne peut pas inspecter le réservoir d’entropie du navigateur, ne certifie pas la qualité du hasard et ne transforme pas un nombre d’appels de bibliothèque en signal d’identité. Cette revue lit deux builds publiés de crypto-js, puis mesure la partie observable : quelle source d’entropie chaque version lie, ce que coûte une requête et ce qu’une doublure de test peut remplacer.
Résumé
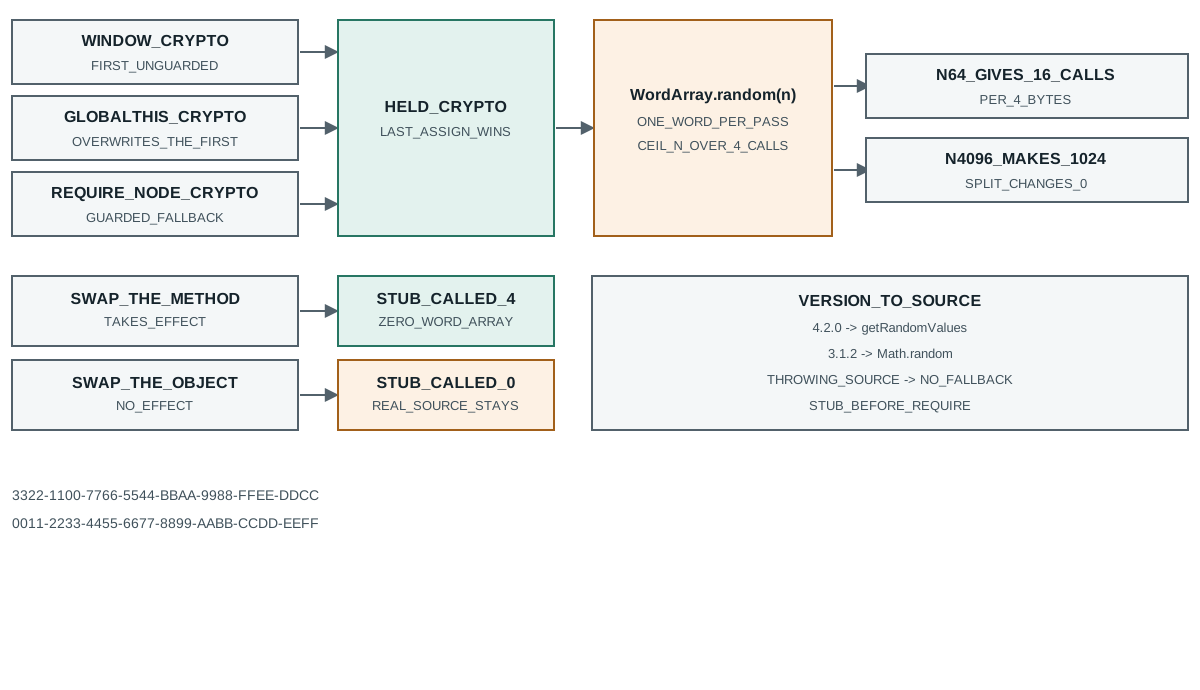
[email protected]atteintcrypto.getRandomValuespour chaque mot qu’il remplit ;[email protected]atteintMath.random. La surface d’API paraît identique, donc seule la source résolue les distingue.- Une requête
WordArray.random(n)produit environn / 4appels d’entropie, donc 64 octets coûtent seize allers-retours vers l’objet crypto et non un seul. - La boucle de liaison de
core.jsaffecte trois globales sans vérifier qu’une source existe déjà.globalThis.cryptoécrase une doublure posée surwindow.crypto, et c’est pourquoi une suite jsdom qui ne simule quewindow.cryptoobserve zéro appel vers sa doublure. - Une fois le module chargé, remplacer la méthode sur l’objet crypto retenu agit ; remplacer l’objet
globalThis.cryptoentier n’agit pas. - Une doublure qui lève une exception fait que
4.2.0émet sa propre erreur générique. Elle ne revient pas àMath.random.
Sommaire
- Quelle source d’entropie chaque build lie
- Ce que coûte une requête aléatoire
- Où une doublure perd face à une globale plus tardive
- D’où vient le texte hexadécimal
- Ce qu’un chiffrement par phrase prend à la source
- Consigner une lecture d’entropie de bibliothèque
Quelle source d’entropie chaque build lie
Le core.js publié de [email protected] commence par une déclaration var crypto; puis exécute six affectations dans un ordre fixe. L’ordre compte plus que les commentaires voisins, car seules les trois dernières affectations testent si une source a déjà été trouvée.
// [email protected] core.js
if (typeof window !== 'undefined' && window.crypto) crypto = window.crypto;
if (typeof self !== 'undefined' && self.crypto) crypto = self.crypto;
if (typeof globalThis !== 'undefined' && globalThis.crypto) crypto = globalThis.crypto;
if (!crypto && typeof window !== 'undefined' && window.msCrypto) crypto = window.msCrypto;
if (!crypto && typeof global !== 'undefined' && global.crypto) crypto = global.crypto;
if (!crypto && typeof require === 'function') crypto = require('crypto');
Les trois premières lignes n’ont pas de garde, donc chacune peut écraser le résultat de la précédente. Dans un navigateur, self et window sont le même objet, donc la deuxième réécrit la première sans rien changer. Dans un processus Node qui définit aussi un objet window, la troisième écrase la première et la deuxième avec globalThis.crypto. Les lignes gardées ne comptent donc que si rien n’a été trouvé du tout.
Ce détail explique un résultat de test qui paraît sinon impossible. Une suite jsdom définit souvent globalThis.window = { crypto: doublure } pour contrôler le hasard, charge ensuite la bibliothèque et guette les appels vers la doublure. Dans un processus Node moderne la suite n’en voit aucun, car globalThis.crypto existe et la troisième ligne non gardée remplace la doublure avant que le module ait fini de charger.
La mesure le confirme. Deux processus enfants démarrent à l’identique sauf une ligne, et chacun compte les appels à la doublure et à la source native sur une requête WordArray.random(16) :
window stub with globalThis.crypto present -> {"stubCalls":0,"allZero":false}
window stub with globalThis.crypto absent  -> {"stubCalls":4,"allZero":true}
Dans le premier cas la doublure n’a rien reçu et l’objet crypto réel a reçu quatre appels. Dans le second, avec globalThis.crypto mis à undefined avant le chargement, la doublure a reçu les quatre et produit un tableau de mots tout à zéro, ce qu’une doublure qui remplit avec des octets nuls doit produire.
Les deux versions de la bibliothèque se situent de part et d’autre de la même API. Toutes deux exposent CryptoJS.lib.WordArray.random(nBytes), et l’objet obtenu a la même forme dans les deux, donc un test qui ne vérifie que sigBytes passe avec l’une ou l’autre. Instrumenter les deux sources dans un même processus les sépare :
one call each in one process: getRandomValues=4 (v4.2.0) Math.random=4 (v3.1.2)
v3.1.2 random(16): Math.random=4
Quatre appels à getRandomValues pour le build moderne et quatre à Math.random pour 3.1.2, sur la même requête de 16 octets. L’aide héritée lit Math.random() et le met à l’échelle d’un entier de 32 bits ; l’aide moderne demande new Uint32Array(1) à l’objet crypto et prend l’élément zéro. Aucun chemin n’est visiblement plus lent pour une page, et aucun ne change le type renvoyé, donc le numéro de version dans package.json reste le seul moyen peu coûteux de savoir lequel un bundle contient.
Ce que coûte une requête aléatoire
L’aide de mots remplit un mot de 32 bits par passe, donc le nombre d’itérations suit directement le nombre d’octets demandé. Mesurer l’objet crypto plutôt que l’horloge rend la règle visible :
v4.2.0 random(4) -> getRandomValues calls=1
v4.2.0 random(16) -> getRandomValues calls=4
v4.2.0 random(64) -> getRandomValues calls=16
Seize appels pour une requête de 64 octets, pas un. Le coût vaut Math.ceil(n / 4) pour un entier positif, et le quota du navigateur s’applique par appel et non par requête, donc la limite pratique est de 16 384 appels de quatre octets et non de 65 536 octets en un seul appel. Un flux de travail qui produit beaucoup de matière aléatoire dans une boucle paie donc beaucoup de petites vérifications de quota au lieu d’une grande.
Cette règle a une conséquence directe pour un fixture qui veut rester dans le quota. Quatre mille quatre-vingt-seize octets coûtent mille vingt-quatre allers-retours vers l’objet crypto, et découper ce budget en huit appels de cinq cent douze octets coûte le même total, car chacun de ces appels est lui-même découpé en cent vingt-huit mots de quatre octets. Regrouper à la frontière de l’API ne réduit pas le nombre d’appels d’entropie ; seul le total d’octets le fait. Une boucle qui produit beaucoup de matière de clé dans un test atteindra le quota au même total, qu’elle demande un tableau ou plusieurs.
L’autre face de la même règle est le temps. Sur la machine mesurée, mille requêtes de trente-deux octets ont terminé en cinq millisecondes environ, assez peu pour que le coût de la boucle soit invisible à côté de celui de l’usage de la matière. C’est pourquoi le nombre d’appels, et non la durée, est ce qu’il faut consigner : la durée bouge avec la machine et la charge, le nombre non.
Les tailles fractionnaires et invalides montrent le bord de la boucle, et aucune ne lève :
random(0) -> words=0 sigBytes=0 hexLen=0
random(4) -> words=1 sigBytes=4 hexLen=8
random(4.5) -> words=2 sigBytes=4.5 hexLen=10
random(16) -> words=4 sigBytes=16 hexLen=32
random(-1) -> words=0 sigBytes=-1 hexLen=0
Une requête négative renvoie un tableau de mots vide dont sigBytes vaut -1, et l’encodeur hexadécimal n’émet rien au lieu de lever. Un appelant qui se fie à sigBytes comme contrôle de longueur obtient une valeur fausse mais non nulle, exactement le genre de valeur qui passe un if (words.sigBytes) puis échoue plus loin dans un sérialiseur.
Pour une requête bien formée la longueur de sortie reste stable. Cinq mille requêtes de seize octets dans un processus ont produit trente-deux caractères hexadécimaux à chaque fois :
5000 calls of random(16): hex length min=32 max=32
Cette stabilité mérite d’être dite car elle sépare deux choses qu’un test pourrait confondre. Une longueur fixe prouve que l’encodeur est cohérent ; elle ne dit rien du hasard derrière les caractères. Ces deux affirmations exigent des preuves différentes, et seule la première est peu coûteuse à vérifier.
Où une doublure perd face à une globale plus tardive
Simuler la source aléatoire est une pratique courante pour une suite déterministe, et le défaut est subtil : la doublure est installée, les assertions passent et la doublure n’a jamais été appelée. Deux emplacements se comportent différemment une fois le module chargé.
post-load swaps -> {"methodSwapAllZero":true,"objectSwapAllZero":false}
Remplacer getRandomValues sur l’objet que la bibliothèque retient déjà change le résultat suivant, et le tableau de mots revient tout à zéro. Remplacer ensuite globalThis.crypto par un objet neuf ne change rien, car la bibliothèque a gardé une référence à l’objet résolu au chargement et ne relit jamais la globale. La première forme est celle qu’un test peut utiliser ; la seconde laisse la vraie source en place sans prévenir.
L’ordre compte pour la même raison. Une suite qui pose globalThis.window.crypto puis charge la bibliothèque se bat contre la troisième affectation non gardée. Poser ou vider globalThis.crypto avant le chargement est l’emplacement qui atteint la boucle de liaison au moment où elle s’exécute.
Ce qui arrive quand l’objet crypto existe mais refuse est un troisième comportement distinct. Une doublure dont getRandomValues lève toujours a produit ceci :
getRandomValues always throws -> threw: Native crypto module could not be used to get secure random number.
La bibliothèque absorbe l’erreur d’origine et lève son propre message. Le nom d’origine du refus a disparu quand l’appelant le voit, donc une page qui veut distinguer un problème de quota d’une source absente doit inspecter l’objet crypto et non l’erreur levée par la bibliothèque. Tout aussi important, 4.2.0 ne revient pas à Math.random dans ce cas. Le risque de dégradation silencieuse appartient à 3.1.2, où Math.random est la source et non le repli.
Un appelant peut néanmoins séparer les deux pannes sans lire la bibliothèque. Vérifiez si l’objet crypto expose getRandomValues avant la requête ; s’il le fait, l’erreur levée vient de la source et non d’une liaison absente. Ce contrôle coûte une lecture de propriété et transforme une erreur ambiguë en décision, ce dont un fixture a besoin pour consigner source-missing à part de source-refused.
D’où vient le texte hexadécimal
Le tableau de mots stocke des mots de 32 bits, et l’encodeur hexadécimal les lit de l’octet le plus significatif au moins. Rien dans cette étape ne dépend de la version ; ce qui varie est la façon dont un groupe de quatre octets devient un mot. Faire passer les mêmes seize octets d’entropie par deux interprétations rend l’effet visible : La même frontière de regroupement apparaît quand le texte est encodé pour le transport : frontières de btoa et atob montre comment une chaîne d’octets et une chaîne de caractères divergent, et pourquoi une étape de décodage est obligatoire avant que le texte concorde.
entropy bytes: 00112233445566778899aabbccddeeff
WordArray(little-endian words, as the randomBytes branch) -> 3322110077665544bbaa9988ffeeddcc
WordArray(big-endian words)                               -> 00112233445566778899aabbccddeeff
endianness changes the hex: true
Les deux exécutions ont consommé des octets identiques et produit un texte différent. La différence tient à la règle de regroupement, non à l’entropie : une lecture traite chaque groupe de quatre octets comme little-endian, l’autre comme big-endian, et l’encodeur imprime fidèlement la valeur de 32 bits reçue. Une comparaison entre deux machines qui regroupent différemment signale donc une différence sans rapport avec le hasard.
La forme signée n’ajoute pas une seconde différence. Les mots -1146447480 et -1122868 et leurs équivalents non signés 3148519816 et 4293844428 encodent les mêmes seize caractères hexadécimaux, car l’encodeur masque chaque octet :
signed words [-1146447480,-1122868] -> bbaa9988ffeeddcc
unsigned words [3148519816,4293844428] -> bbaa9988ffeeddcc
sign is lost in the hex: true
C’est pourquoi la branche Node, qui lit quatre octets avec readInt32LE() et peut donc produire des mots négatifs, reste d’accord avec la branche navigateur sur une machine little-endian. La machine mesurée a rapporté little-endian, et sur elle les deux branches forment les mêmes mots à partir des mêmes octets. Une machine big-endian ne le ferait pas, car la branche navigateur prend l’interprétation machine d’un élément Uint32Array tandis que la branche Node fixe little-endian explicitement. Cette dernière phrase est une lecture des deux chemins de code, pas une mesure : seul le cas little-endian a été exécuté ici, et le cas big-endian reste une vérification ouverte pour qui dispose de ce matériel.
La leçon pratique pour une comparaison entre machines est plus étroite qu’il n’y paraît. Si deux machines exécutent le même build et sont little-endian, la branche n’importe pas et l’hexadécimal concorde. Si les versions diffèrent, la source change et l’hexadécimal ne concorde que par coïncidence. Un écart entre deux artefacts dit laquelle des deux variables a bougé seulement si l’ordre des octets est consigné à côté, un champ de plus pour le registre.
Ce qu’un chiffrement par phrase prend à la source
AES.encrypt a deux formes d’entrée proches qui utilisent la source aléatoire différemment. Passer une chaîne comme clé fait dériver clé et IV par la bibliothèque, et ce chemin génère d’abord un sel. Passer une clé déjà analysée avec un IV explicite saute entièrement la dérivation.
AES.encrypt(passphrase) -> getRandomValues calls=2
AES.encrypt(key+iv) -> getRandomValues calls=0
passphrase output header="Salted__" saltBytes=8
explicit key+iv deterministic across runs: true
Huit octets de sel coûtent deux appels, ce qui correspond à la règle d’un mot par passe. La chaîne de sortie porte le sel de huit octets devant le texte chiffré derrière un en-tête fixe, donc deux exécutions avec la même phrase et le même texte clair ne diffèrent que par ces huit octets et tout ce qui en dérive. La forme à clé explicite n’a fait aucun appel et a produit une sortie identique sur deux exécutions, propriété dont un test déterministe a besoin et qu’un artefact stocké ne doit pas avoir.
Les deux valeurs par défaut de dérivation de clé sont aussi très éloignées en coût. Le chemin par phrase utilise une dérivation compatible OpenSSL avec une itération par défaut, tandis l’aide PBKDF2 autonome en utilise 250 000 :
EvpKDF keySize=12 iterations=1: 0.06 milliseconds
PBKDF2 default iterations=250000: 851 milliseconds
Ces deux chiffres viennent d’une machine et bougent avec la charge, donc traitez-les comme un ordre de grandeur et non comme une référence. Ce qu’ils soutiennent est stable : choisir l’aide par phrase pour un artefact stocké achète un sel et une dérivation rapide, pas lente, et relever le nombre d’itérations est une décision distincte que l’appelant doit prendre explicitement.
Consigner une lecture d’entropie de bibliothèque
Une lecture qui survit à une revue nomme ses entrées et ses limites. Six champs couvrent la partie observable sans stocker de matière générée :
- Le nom du paquet et la version exacte, plus le fichier qui fournit l’aide de mots, car l’ordre de liaison est une propriété de ce fichier.
- Les nombres d’appels par source,
getRandomValuesetMath.random, sur une requête de taille déclarée. - La taille de la requête et le
sigBytesobtenu, pour confronter le nombre d’appels à la règle d’un mot par passe. - L’ordre des octets de la machine, car il décide si les deux branches s’accordent sur le texte.
- Si la doublure a été posée avant ou après le chargement du module, et quel objet elle a remplacé.
- Le texte d’erreur produit quand l’objet crypto refuse, y compris si le nom d’origine a survécu.
Ce registre est ce contre quoi une suite peut affirmer, et il reste assez court pour une note de revue. Ce qu’il ne peut pas soutenir est une affirmation sur la qualité du hasard, l’unicité ou ce qu’une page dirait de la machine. Un nombre d’appels est une forme, pas une mesure d’entropie, et une longueur hexadécimale stable est une propriété de l’encodeur et non une preuve sur la source. Pour le contrat côté navigateur que ces appels atteignent, voir observabilité du hasard cryptographique et empreintes du navigateur, et pour un collecteur figé qui sépare les résultats par composant de son propre résumé, voir collecte et provenance FingerprintJS OSS.
Deux habitudes gardent une lecture de bibliothèque honnête dans le temps. D’abord, refaites le compte après toute mise à jour de dépendance, car un changement de version peut changer la source sans changer l’API ; c’est exactement la différence entre 3.1.2 et 4.2.0. Ensuite, consignez le contrôle qui échouerait si l’ordre de liaison changeait, soit ici le nombre d’appels à la doublure avec et sans globale native. Un registre qui ne garde que la longueur produite ne détecte ni l’un ni l’autre.
Sources publiques
- Code de crypto-js : core.js
- Versions de crypto-js
- MDN : Crypto.getRandomValues
- Spécification de l’API Web Cryptography
- MDN : Math.random
Conclusion
Lisez le core.js étiqueté du build que vous publiez réellement, puis comptez les appels reçus par chaque source sur une requête de taille connue. Notez la version, les nombres d’appels, l’ordre des octets et l’emplacement de la doublure. Traitez le texte produit comme un résultat d’encodeur, gardez l’entropie hors du registre, et refaites le compte dès que la dépendance bouge.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
Observabilité de l’aléa cryptographique et empreintes du navigateur
EmpreinteClient Hints Fingerprinting : en-têtes HTTP et identité
EmpreinteUnicode : quatre identités de texte lues par une page
EmpreinteQu'est-ce que l'empreinte des polices ? Cohérence du texte
EmpreinteBotD : quels détecteurs s’exécutent vraiment
EmpreinteComment hardwareConcurrency révèle les cœurs réels de votre CPU
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.