ArrayBuffer et TypedArray : un tampon, plusieurs vues
Lisez un ArrayBuffer via Uint8Array, Uint32Array et DataView : octets contre éléments, slice copie et subarray partage, ordre des octets et transfer détache la source.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
BotBrowser prend en charge la relecture d’un fixture autorisé du même origine sous un profil déclaré et conserve des observations bornées sur les octets qu’une page a lus via une vue et les nombres qu’elle a produits, mais il ne peut pas changer l’ordre des octets de l’hôte contre lequel lit un DataView, ne peut pas faire qu’une copie et un alias se comportent pareil et ne transforme pas la longueur d’une vue en signal d’identité. Cette revue prend un ArrayBuffer et le lit avec Uint8Array, Uint32Array et DataView, puis consigne pourquoi les mêmes huit octets portent trois longueurs différentes, pourquoi slice copie tandis que subarray partage, comment une lecture big-endian et une lecture little-endian des mêmes octets diffèrent, comment se comportent l’accès hors bornes et le dépassement d’entier, et comment un transfer laisse la source détachée.
Résumé
- Un tampon de 8 octets a
.byteLength8 pour toute vue, maisUint8Array.lengthvaut 8,Uint32Array.lengthvaut 2 etFloat64Array.lengthvaut 1 ; la longueur compte des éléments, pas des octets. - Les trois vues partagent les mêmes octets, donc une écriture via l’une se voit via les autres, parce qu’elles enveloppent un tampon au lieu de le copier.
slicerenvoie une copie sur un nouveau tampon, donc une écriture dedans laisse la source intacte ;subarrayrenvoie une vue sur le même tampon, donc une écriture dedans change la source.DataView.setUint32(0, 0x01020304, false)écrit01 02 03 04, et relire les mêmes octets en big-endian donne0x01020304tandis qu’en little-endian on obtient0x04030201.- Un
Uint32Arraylit dans l’ordre de l’hôte, qui sur cette machine est little-endian, donc les mêmes octets donnent0x04030201, identique à la lecture little-endian duDataViewet non à la big-endian. - Une écriture hors bornes est écartée et une lecture hors bornes vaut
undefined;Uint8Arraydonne 0 pour 256,Int8Arraydonne -56 pour 200 etUint8ClampedArrayborne 300 à 255. buffer.transfer(4)détache la source (byteLengthpasse à 0) et renvoie une copie de 4 octets ; utiliser la source détachée lèveTypeError.
Sommaire
- Pourquoi un tampon a trois longueurs différentes
- Pourquoi slice copie et subarray partage
- Comment les mêmes octets se lisent big-endian et little-endian
- Où tombent l’accès hors bornes et le dépassement
- Où la fenêtre d’une vue et un transfer changent la source
- Consigner une lecture binaire
Pourquoi un tampon a trois longueurs différentes
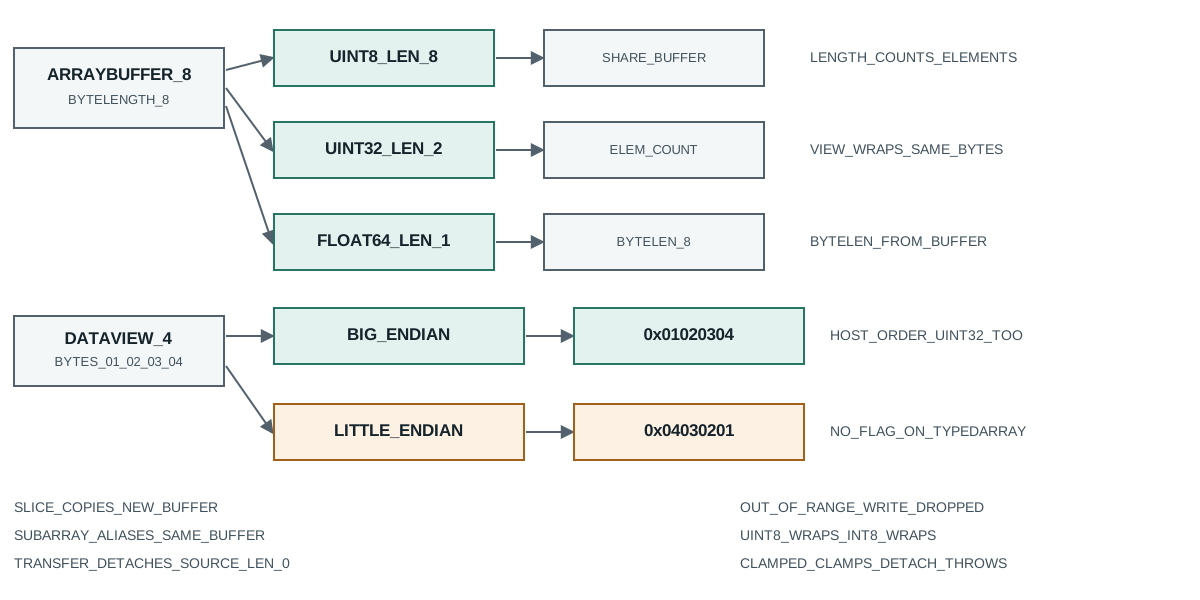
Un tampon est un bloc d’octets sans notion de ce que signifient les octets. Une vue apporte ce sens, et la taille d’élément qu’elle utilise décide combien d’éléments tiennent dans le même bloc. La sonde alloue un tampon de 8 octets et construit trois vues dessus :
ArrayBuffer=function DataView=function node=v26.9.0
new ArrayBuffer(8): byteLength=8
same buffer: Uint8Array.length=8 Uint32Array.length=2 Float64Array.length=1
all share bytes: u8.buffer===u32.buffer true
Le tampon signale byteLength 8 quelle que soit la vue qui le lit. Le Uint8Array lit un octet par élément, donc sa length vaut 8. Le Uint32Array lit quatre octets par élément, donc sa length vaut 2. Le Float64Array lit huit octets par élément, donc sa length vaut 1. Trois nombres qui décrivent les mêmes huit octets, et un seul est un compte d’octets.
Cette distinction est le premier défaut d’un chemin de code binaire : qui lit view.length et le multiplie par un octet par élément obtient le mauvais compte d’octets pour toute vue sauf celle des octets. La propriété byteLength est celle qui compte toujours des octets, et elle concorde sur les trois vues parce qu’elle est une propriété de la fenêtre du tampon, non du type d’élément. Le contrôle d’identité de .buffer confirme que les trois vues enveloppent une seule allocation, donc une écriture via la vue d’octets se voit via la vue 32 bits, ce qui est exactement ce dont un décodeur dépend quand il remplit des octets puis les lit comme des entiers.
La conséquence pratique est qu’une longueur écrite dans un registre doit nommer la vue qui l’a produite. Un registre qui dit « longueur 8 » est ambigu : c’est une longueur en octets ou une longueur Uint8Array, mais un Uint32Array sur les mêmes octets dirait deux. Les deux sont correctes et répondent à des questions différentes, donc le registre a besoin de la taille d’élément à côté du nombre.
Le même raisonnement décide comment une vue signale un compte d’octets quand le tampon n’est pas un multiple entier de la taille d’élément. Un Uint32Array sur un tampon de 10 octets n’expose que les deux éléments complets de quatre octets qui tiennent, et les deux octets finaux sont hors de tout élément qu’il peut adresser. Le byteLength de la vue ne reflète que les octets qu’elle couvre, donc les deux octets restants ne sont ni lisibles ni inscriptibles par elle, et un analyseur qui suppose que chaque octet du tampon est atteignable par la vue abandonne la queue en silence. Choisir le type d’élément pour un tampon qui n’y est pas aligné est donc une décision sur quels octets sont adressables, pas seulement sur combien d’éléments une longueur signale.
Pourquoi slice copie et subarray partage
Deux méthodes se ressemblent et se comportent à l’inverse. slice renvoie une vue nouvelle adossée à un tampon nouveau, et subarray renvoie une vue nouvelle adossée au même tampon. La sonde mute chacune et vérifie si la source a changé :
slice then mutate: src[1]=2 sliced[0]=99
subarray then mutate: src[1]=42 sub[0]=42
slice shares buffer: false; subarray shares buffer: true
Après slice(1, 4), écrire 99 dans la copie laisse src[1] à son 2 d’origine, et le contrôle d’identité de tampon signale que la copie ne partage pas le tampon de la source. Après subarray(1, 4), écrire 42 dans la sous-vue met src[1] à 42, et le contrôle signale que la sous-vue partage le tampon de la source. Les deux méthodes prennent les mêmes arguments et produisent des vues des mêmes trois éléments, mais l’une est une copie et l’autre un alias.
Un décodeur qui lit une trame, prend un slice pour le corps et le stocke peut réutiliser le tampon source pour la trame suivante, parce que la copie possède ses propres octets. Un décodeur qui prend un subarray pour la même chose puis réutilise le tampon source pour la trame suivante écrase le corps stocké, parce que la sous-vue pointe encore dans le tampon qui vient de changer. C’est un défaut d’alias classique : le code paraît correct, le compte d’éléments est juste, et les octets stockés sont en silence ceux de la trame suivante.
Le correctif est de décider volontairement ce dont un registre a besoin. Une copie coûte une allocation et survit à la réutilisation de la source ; un alias ne coûte rien et est invalidé dès que la source change. Un registre qui stocke un subarray doit garder le tampon source vivant et intact ou copier les octets avec slice d’abord, et devrait dire lequel des deux il a fait, parce qu’un alias stocké et une copie stockée sont indiscernables par le seul compte d’éléments.
Comment les mêmes octets se lisent big-endian et little-endian
L’ordre des octets décide quel bout d’un nombre multioctet vient en premier. DataView prend un argument explicite littleEndian, et la sonde écrit une valeur de 32 bits et la lit des deux façons :
setUint32 big-endian bytes: 01 02 03 04
DataView read BE -> 0x1020304
DataView read LE -> 0x4030201
Uint32Array (host order) -> 0x4030201
host is little-endian: true
Écrire 0x01020304 avec littleEndian à faux (big-endian) pose les octets en 01 02 03 04. Les relire avec getUint32(0, false) reconstruit 0x01020304, et relire les mêmes quatre octets avec getUint32(0, true) reconstruit 0x04030201, la valeur aux octets inversés. Les octets n’ont pas changé ; seule l’interprétation a changé, et les deux sont correctes sous leur propre option.
La ligne du Uint32Array montre le piège. Une vue de tableau typé n’a pas d’argument d’ordre des octets ; elle lit dans l’ordre natif de l’hôte. Cette machine est little-endian, donc le Uint32Array lit 0x04030201, identique à la lecture little-endian du DataView. Un décodeur qui analyse un en-tête réseau via un Uint32Array au lieu d’un DataView obtient donc une bonne réponse sur un hôte little-endian et une mauvaise sur un hôte big-endian, sans changement de code. C’est pourquoi un format binaire nomme toujours son ordre des octets et pourquoi un décodeur qui doit suivre la spécification utilise DataView avec une option explicite plutôt qu’une vue de tableau typé.
La ligne host is little-endian est le moyen peu coûteux de consigner de quel côté penche la machine : allouer un Uint16Array contenant 1, lire son tampon comme octets, et vérifier si le premier octet vaut 1. Un registre qui stocke des entiers analysés sans consigner l’ordre de l’hôte ne peut pas être réexécuté vers les mêmes nombres sur une autre machine, parce que les mêmes octets ne reproduisent la valeur que sous l’ordre supposé.
Il y a une seconde conséquence plus discrète sur la façon dont une vue signale un nombre. Uint32Array produit un entier non signé, donc une valeur dont le bit haut est posé se lit comme un grand nombre positif plutôt que négatif, et un format qui utilise un champ 32 bits signé a besoin d’Int32Array ou d’un appel DataView.getInt32 pour le lire correctement. Deux vues sur des octets identiques peuvent diverger sur la magnitude et le signe du même champ, parce que le type d’élément porte le signe en plus de la largeur. Un registre qui capture les octets bruts et le type d’élément ensemble peut être relu comme l’un ou l’autre, tandis qu’un registre qui ne capture que le nombre s’est déjà engagé sur une interprétation.
Où tombent l’accès hors bornes et le dépassement
Les tableaux typés ne grandissent pas et ne lèvent pas sur un indice au-delà de leur longueur. La sonde écrit au-delà de la fin et lit au-delà de la fin :
write index 10 on length 3: undefined length=3
Float64Array out-of-range read index 5 -> undefined
Écrire 5 à l’indice 10 d’un tableau de longueur 3 ne fait rien : la longueur reste 3 et l’indice relu vaut undefined, parce que l’écriture était hors de la fenêtre d’éléments et a été écartée. Une lecture hors bornes sur un Float64Array renvoie aussi undefined plutôt que NaN, parce que lire au-delà de la longueur n’est pas une lecture numérique. Un analyseur qui fait confiance à des décalages fournis par l’utilisateur et écrit à un indice calculé peut donc perdre des données en silence, chaque appel réussissant, et seul un contrôle de longueur avant l’écriture le détecte.
Écrire une valeur qui ne tient pas a son propre comportement, et trois types de tableau montrent trois issues :
Uint8Array 256 -> 0; Int8Array 200 -> -56
Uint8ClampedArray 300 -> 255
Uint8Array stocke les 8 bits bas, donc 256 devient 0 ; Int8Array stocke une valeur 8 bits signée, donc 200 devient -56. Les deux bouclent modulo la plage de l’élément sans erreur. Uint8ClampedArray borne au lieu de boucler, donc 300 devient 255 et une valeur négative deviendrait 0. Un tampon de pixels qui attend un borne et reçoit un Uint8Array boucle, donc une valeur claire déborde vers une valeur sombre, tandis que la même valeur sur un Uint8ClampedArray sature en blanc. Le type d’élément fait partie du contrat de données, et un registre qui dit « un tableau d’octets » sans nommer s’il borne ou boucle n’a pas décrit l’arithmétique.
Où la fenêtre d’une vue et un transfer changent la source
Une vue peut couvrir une sous-plage d’un tampon, et un tampon peut être transféré. Les deux changent ce qu’est la source, et la sonde mesure chacun :
view window: byteOffset=4 byteLength=4 buffer.byteLength=16
after transfer(4): source.byteLength=0 moved.byteLength=4
source use after detach -> THREW TypeError
La ligne de fenêtre montre un Uint8Array construit sur un tampon de 16 octets avec un décalage de 4 et une longueur de 4. Le byteLength de la vue vaut 4 et son byteOffset vaut 4, mais le buffer.byteLength sous-jacent reste 16. Un registre qui ne stocke que la longueur de la vue sous-estime le tampon, et un registre qui ne stocke que la longueur du tampon surestime la vue ; les deux nombres décrivent des fenêtres différentes sur la même mémoire, et les deux sont nécessaires pour localiser les octets.
La ligne du transfer montre ce qu’il fait. Avant l’appel la source fait 8 octets ; après buf.transfer(4) le byteLength de la source vaut 0 et le tampon renvoyé porte 4 octets. La source est détachée, et tout usage ultérieur d’une vue dessus lève TypeError, que la sonde capture. Un transfer déplace les octets vers un nouveau tampon et laisse l’ancien inutilisable, donc le code qui garde une référence à l’ancien tampon et le lit après un transfer obtient une exception plutôt que des données périmées. C’est un échec bruyant donc facile à repérer, mais le code qui transfère un tampon qu’une autre partie du programme espère encore lire échouera à la lecture suivante, donc la propriété d’un tampon transféré doit être consignée.
Une frontière liée est que la sortie de l’encodeur est une vue Uint8Array, pas un tableau ordinaire : TextEncoder.encode("café") renvoie un objet dont le byteLength vaut 5 et qui passe instanceof Uint8Array. Cette vue est l’entrée que mesure la section des longueurs ci-dessus, donc le compte d’octets qu’un décodeur lit ensuite est le même nombre qu’un registre devrait stocker.
Consigner une lecture binaire
Une lecture binaire soutient une affirmation étroite : cet environnement, cet ordre des octets, cette vue et cette entrée ont produit ces nombres. Six champs la gardent vérifiable, et aucun ne stocke une valeur qu’une autre vue réinterpréterait :
- Le
byteLengthdu tampon et, pour une vue, sonbyteOffsetet sonbyteLength, parce que la fenêtre et le tampon sont des plages différentes. - Le type d’élément de chaque vue utilisée pour lire les octets, parce qu’un tampon porte 8, 2 ou 1 éléments selon la taille d’élément.
- L’ordre des octets de l’hôte, parce qu’une vue de tableau typé lit l’ordre natif tandis qu’un
DataViewprend une option explicite. - Si une vue dérivée est une copie
sliceou un aliassubarray, parce que seul l’alias change quand le tampon source est réutilisé. - Le comportement de borne ou de boucle du type d’élément, parce qu’une valeur hors de la plage de l’élément soit boucle modulo la plage, soit sature à la borne.
- Si le tampon a été transféré et ce qu’est devenu son
byteLength, parce qu’une source détachée lève à l’usage suivant au lieu de lire des octets périmés.
Ce qu’une telle lecture ne peut pas montrer, c’est quoi que ce soit sur l’origine des octets. Un tampon est rempli par un producteur, et qui l’analyse ne sait pas si le producteur a écrit UTF-8, un en-tête réseau en big-endian ou un nombre sérialisé dans l’ordre de l’hôte. Pour le côté texte des mêmes octets, TextDecoder et TextEncoder montre pourquoi les mêmes quatre octets UTF-8 décodent en une chaîne sous une étiquette et en une chaîne mal encodée sous une autre. Pour le côté copie, structuredClone face à JSON montre quels types de conteneur survivent à une copie profonde et ce qu’un aller-retour JSON fait s’effondrer, qui est la décision au niveau du conteneur qui précède une lecture au niveau des octets.
Deux habitudes gardent la lecture honnête avec le temps. D’abord, consignez le type d’élément et l’ordre des octets à côté des nombres, parce qu’un entier lu des mêmes octets diffère sous chacun. Ensuite, stockez si une vue est une copie ou un alias, et comparez les octets plutôt que le seul compte d’éléments, parce qu’un alias qui pointe dans un tampon réutilisé a le même compte d’éléments que la copie qu’il a remplacée tout en portant des octets différents.
Sources publiques
- MDN : ArrayBuffer
- MDN : TypedArray
- MDN : DataView
- MDN : ArrayBuffer.prototype.transfer
- ECMAScript : objets DataView
- BotBrowser : référence de cohérence d’automatisation
Conclusion
Traitez la vue comme faisant partie du contrat de données : byteLength compte des octets, length compte des éléments, et un tampon de 8 octets porte 8, 2 ou 1 éléments selon la vue. Sachez que slice copie et que subarray partage, donc un alias stocké meurt quand le tampon source est réutilisé. Lisez les formats binaires via DataView avec un ordre des octets explicite, non via une vue de tableau typé qui suit l’ordre de l’hôte, et consignez si l’hôte est little-endian. Attendez qu’une écriture hors bornes soit écartée et qu’une lecture hors bornes vaille undefined, et attendez que Uint8ClampedArray borne là où Uint8Array boucle. Consignez la fenêtre, le type d’élément, l’ordre des octets, le choix copie ou alias et l’issue du transfer, et comparez les octets plutôt que le compte d’éléments pour qu’un alias périmé ne passe pas un contrôle vert.
Lecture suivante
Pour ce que les mêmes octets signifient comme texte, lisez TextDecoder et TextEncoder ; pour quels types de conteneur survivent à une copie profonde avant qu’aucun octet ne soit lu, lisez structuredClone face à JSON.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
TextDecoder et TextEncoder : octets contre chaînes
EmpreinteUnicode : quatre identités de texte lues par une page
EmpreinteICU : alias de fuseau et la TZ que vous rapportez
Empreintebtoa et atob : la frontière Latin-1
EmpreintestructuredClone face à JSON : copies profondes
EmpreinteSource aléatoire de crypto-js : quelle branche
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.