TextDecoder et TextEncoder : octets contre chaînes
Décodez des octets fixes avec plusieurs étiquettes : alias, BOM, octet invalide, pourquoi un morceau coupé perd un caractère et pourquoi les longueurs diffèrent.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
BotBrowser prend en charge la relecture d’un fixture autorisé du même origine sous un profil déclaré et conserve des observations bornées sur les octets qu’une page a encodés et la chaîne qu’un décodeur a renvoyée, mais il ne peut pas faire émettre à TextEncoder une étiquette autre que UTF-8, ne change pas le décodeur auquel une étiquette se résout et ne transforme pas un résultat de décodage en signal d’identité. Cette revue décode un ensemble fixe de séquences d’octets avec plusieurs étiquettes et consigne lesquelles sont des alias, comment une marque d’ordre des octets est traitée, quand le mode fatal lève au lieu de substituer, pourquoi une frontière de morceau perd un caractère multioctet et pourquoi une longueur d’octets et une longueur de chaîne diffèrent pour le même texte.
Résumé
TextEncoderest toujours UTF-8 et ignore toute étiquette passée à son constructeur ;new TextEncoder({encoding:"latin1"}).encodingimprime quand mêmeutf-8.- Les étiquettes
latin1,iso-8859-1etwindows-1252se résolvent au même décodeur, donccaféen octets UTF-8 revient sous la formecaféet rien ne dit quelle étiquette a été écrite. - La marque d’ordre des octets UTF-8 est retirée par défaut et conservée seulement avec
ignoreBOM: true, donc les mêmes octets décodent en une chaîne ou en deux selon une option que presque personne ne fixe. - Un décodage non fatal remplace un octet invalide par U+FFFD, tandis que
fatal: truelèveTypeError; une séquence multioctet tronquée devient un caractère de remplacement sans aucune erreur. - Couper un caractère multioctet entre deux appels le perd sauf si
stream: trueest activé, et le résultat en flux se recolle à la chaîne d’origine. - Un substitut isolé s’encode en un seul U+FFFD, donc un aller-retour peut changer la valeur alors que chaque appel réussit ;
caféfait quatre unités UTF-16 et cinq octets UTF-8.
Sommaire
- Quelle étiquette se résout à quel décodeur
- Comment une marque d’ordre des octets et une séquence invalide sont traitées
- Pourquoi une frontière de morceau perd un caractère
- Où la longueur d’octets et celle de chaîne diffèrent
- Consigner une lecture de codec
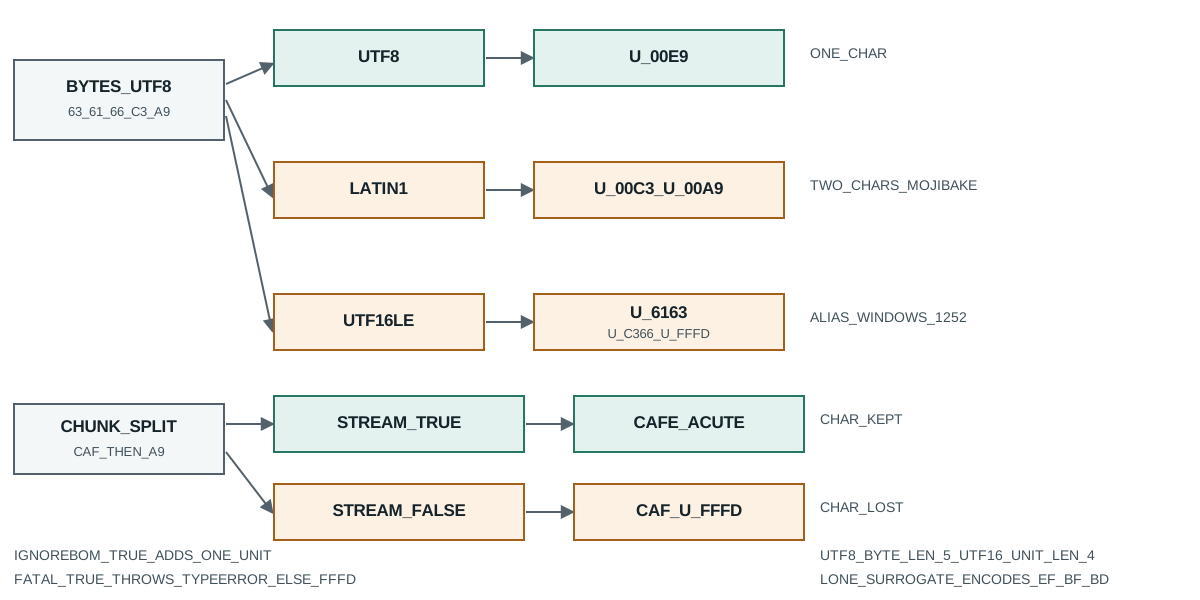
Quelle étiquette se résout à quel décodeur
Le constructeur prend une étiquette, pas un nom exact d’encodage, et la norme associe de nombreuses étiquettes à un seul décodeur. La sonde décode les cinq octets UTF-8 de café (63 61 66 c3 a9) avec quatre étiquettes et imprime la chaîne que chacune renvoie :
TextDecoder=function TextEncoder=function node=v26.9.0
TextEncoder.encoding = "utf-8"
encode("café") -> 63 61 66 c3 a9
encode("😀") -> f0 9f 98 80
new TextEncoder({encoding:"latin1"}) -> "utf-8"
new TextDecoder("utf-8").decode(0x63 61 66 c3 a9) -> "café"
new TextDecoder("latin1").decode(0x63 61 66 c3 a9) -> "café"
new TextDecoder("iso-8859-1").decode(0x63 61 66 c3 a9) -> "café"
new TextDecoder("windows-1252").decode(0x63 61 66 c3 a9) -> "café"
new TextDecoder("utf-16le").decode(0x63 61 66 c3 a9) -> "慣썦�"
Deux faits tiennent dans ces lignes. D’abord, TextEncoder signale utf-8 quelle que soit l’étiquette passée ; l’objet n’a simplement pas d’autre encodage, donc qui écrit latin1 en attendant une sortie d’un octet obtient une sortie multioctet et aucun avertissement. Ensuite, les trois étiquettes à un octet s’effondrent en un décodeur. latin1, iso-8859-1 et windows-1252 sont des alias dans la table d’étiquettes de la norme, et windows-1252 est le décodeur auquel les trois se résolvent. Décoder des octets UTF-8 avec l’une d’elles lit chaque octet comme un caractère, donc la séquence de deux octets c3 a9 devient les deux caractères à et ©.
Cet effondrement est la source du défaut classique de texte mal encodé : un producteur a écrit UTF-8 et un consommateur a déclaré Latin-1, ou l’inverse. Le défaut n’est la faute d’aucun côté seul ; c’est un écart entre l’étiquette qu’un producteur a utilisée et celle qu’un consommateur a supposée. Le résultat de deux caractères est déterministe et réversible, ce qui explique qu’un redécodage des mêmes octets en UTF-8 restaure café exactement. Le contrôle qui le détecte consiste à comparer la chaîne décodée au texte attendu, non à comparer des longueurs d’octets, parce que les deux formes du texte mal encodé occupent le même nombre d’octets.
La quatrième étiquette montre ce que coûte une mauvaise famille. utf-16le lit les mêmes octets deux par deux comme des unités de 16 bits little-endian, donc 63 61 devient un caractère, 66 c3 un autre, et le a9 restant un caractère de remplacement. Rien ne lève. Qui reçoit des octets d’une source qui a réellement produit de l’UTF-16 et déclare LE obtient une chaîne, simplement pas celle attendue, et qui déclare le mauvais ordre des octets pour du vrai UTF-16 obtient encore une autre chaîne. L’étiquette fait partie du contrat de données, donc un fixture qui décode sans consigner l’étiquette a consigné un résultat non vérifiable.
Il y a une seconde lecture de cette ligne qui compte autant : le décodeur a consommé un nombre impair d’octets. Un décodeur UTF-16 lit une unité par deux octets, donc une entrée de cinq octets laisse un octet sans partenaire, et le décodeur transforme l’octet isolé en U+FFFD au lieu de le jeter. Le nombre de caractères du résultat dit donc quelque chose sur la parité de l’entrée même si l’étiquette semblait valide. Un flux qui décode un corps UTF-8 de longueur paire avec la mauvaise famille de deux octets masquera ce signal, parce qu’un nombre d’octets pair ne laisse rien d’isolé et que la substitution qui aurait signalé l’écart n’apparaît jamais. L’écart d’étiquette n’est donc repérable à peu de frais que lorsqu’il casse aussi la parité des octets, ce qui est une détection fragile.
Une étiquette inconnue est le seul cas qui échoue bruyamment plutôt que silencieusement :
new TextDecoder("utf-99") -> THREW RangeError
Le constructeur rejette une étiquette absente de la table de la norme avec RangeError, avant de lire un octet. C’est la forme sur laquelle un fixture devrait compter pour une faute de frappe, parce qu’elle nomme le problème à la construction. Tout autre écart ci-dessus renvoie une chaîne et continue, donc le seul garde-fou fiable contre une étiquette valide mais fausse est d’affirmer la valeur décodée.
Comment une marque d’ordre des octets et une séquence invalide sont traitées
Une marque d’ordre des octets fait trois octets au début de données UTF-8 (EF BB BF) ou deux au début de données UTF-16 (FF FE pour little-endian). La norme traite la marque UTF-8 à part : par défaut le décodeur la retire de la sortie, et avec ignoreBOM: true il la laisse. La sonde montre les deux résultats pour la même entrée :
decode(EF BB BF 41) default -> "A"
decode(EF BB BF 41) ignoreBOM:true -> "A"
decode(FF FE 41 00) as utf-16le -> "A"
La première ligne décode une marque suivie de l’octet 41 (A) et renvoie l’unique caractère A. La seconde renvoie deux caractères : un U+FEFF invisible suivi de A, donc result.length vaut 2 et non 1. Une comparaison des deux chaînes échoue, une comparaison de leurs longueurs diffère d’un, et aucune n’est fausse ; l’option a décidé du résultat. Un consommateur qui prend ignoreBOM dans une configuration et un producteur qui ne le fait pas, c’est exactement la séparation qui transforme une chaîne correcte en deux chaînes inégales.
La ligne UTF-16 montre la marque traitée par la même règle dans un autre décodeur : FF FE est la marque little-endian, le décodeur la consomme, et le 41 00 restant décode en A. Un décodeur UTF-16 qui attend l’autre ordre des octets lit FF FE comme une seule unité et produit un premier caractère différent, donc la marque et l’ordre des octets doivent s’accorder avant que le texte le fasse.
Une séquence invalide est une décision distincte d’une marque, et fatal la fixe :
decode(A FF B) non-fatal -> "A�B"
decode(A FF B) fatal -> THREW TypeError
decode(E4 B8) truncated -> "�"
L’octet FF n’est valide nulle part en UTF-8. Sans fatal, le décodeur émet un U+FFFD à sa place et continue, donc le résultat est A, un caractère de remplacement, puis B : trois caractères pour trois octets d’entrée, dont un substitué. Avec fatal: true les mêmes octets lèvent TypeError. Un flux qui ne doit pas recevoir de texte corrompu devrait fixer fatal, parce que le résultat non fatal est une chaîne valide qui diffère silencieusement de l’entrée.
Le cas tronqué est celui qui surprend le plus. E4 B8 sont les deux premiers octets d’un caractère de trois octets, et le décodeur ne peut pas le compléter en fin d’entrée, donc il émet un caractère de remplacement. Aucune erreur n’est levée alors même que les données étaient courtes. C’est pourquoi un contrôle du nombre d’octets passe sur une entrée tronquée : le décodeur renvoie toujours une chaîne, et seule la valeur révèle qu’un caractère a été perdu.
Pourquoi une frontière de morceau perd un caractère
Une réponse réseau, une lecture de fichier et un message de worker arrivent par morceaux, et une frontière de morceau peut tomber au milieu d’un caractère multioctet. TextDecoder a deux modes pour cela, et la sonde coupe les cinq octets UTF-8 de café après quatre octets, donc le premier morceau se termine sur le premier octet du é de deux octets :
stream split mid-sequence: first="caf" second="é"
non-stream split mid-sequence -> "caf�"
La voie sans flux décode chaque morceau comme une unité complète. Le premier morceau est caf plus l’octet c3, qui entame un caractère de deux octets dont la suite manque au morceau, donc le décodeur transforme le c3 isolé en un caractère de remplacement et renvoie caf suivi de U+FFFD. Le é a disparu. La voie en flux avec stream: true garde le c3 final au lieu de le substituer, donc le premier appel renvoie caf, le second reçoit a9 et renvoie é, et les deux résultats se concatènent en café.
C’est pourquoi tout décodeur qui lit un flux doit passer stream: true sur chaque morceau sauf le dernier, et rappeler le décodeur une fois sans argument pour vider la fin. Une boucle qui décode chaque morceau sans l’option perd un caractère à chaque frontière qui tombe dans une séquence multioctet, et la perte est silencieuse : la longueur totale diminue d’une ou plusieurs unités et chaque appel renvoie une chaîne. Un fixture qui compare le résultat concaténé à la chaîne d’origine le détecte ; un fixture qui vérifie seulement que le décodage a réussi ne le détecte pas.
Le même mécanisme apparaît quand une page lit un ReadableStream et décode de façon incrémentale, et quand un worker réassemble un message. Dans les deux cas le correctif est la même option et un vidage final, et l’échec sans lui est un nombre fixe de caractères de remplacement égal au nombre de séquences coupées. Le compte est un diagnostic utile : un caractère de remplacement à une frontière de morceau signifie une coupure, et une série signifie que les morceaux n’étaient pas alignés sur la largeur des caractères.
Un vidage final est facile à oublier parce que chaque appel intermédiaire a déjà renvoyé une chaîne. Après le dernier morceau, un décodeur qui garde encore des octets finaux doit être appelé une fois sans entrée, et seul cet appel émet le caractère que les octets gardés complètent. Une boucle qui s’arrête après le dernier morceau laisse la fin dans le décodeur, donc la sortie jointe est courte des caractères que ces octets auraient produits. Un fixture qui compare la sortie jointe à l’original détecte l’omission ; un fixture qui vérifie seulement qu’aucun appel n’a levé ne le détecte pas, parce qu’aucun ne l’a fait.
Où la longueur d’octets et celle de chaîne diffèrent
TextEncoder écrit UTF-8, donc la longueur d’octets d’une chaîne est sa longueur UTF-8, pas sa longueur UTF-16. Les deux ne coïncident que pour un texte fait de caractères sous U+0080. La sonde mesure quatre chaînes des deux façons :
"hello" stringLength=5 byteLength=5
"café" stringLength=4 byteLength=5
"中文" stringLength=2 byteLength=6
"😀" stringLength=2 byteLength=4
Pour hello, cinq caractères ASCII coûtent cinq octets parce que chaque point de code ASCII est une unité et un octet. Pour café, les quatre lettres coûtent cinq octets parce que é est une unité UTF-16 mais deux octets UTF-8. Pour les deux caractères CJK, deux unités coûtent six octets parce que chacun fait trois octets en UTF-8. Pour l’emoji, deux unités UTF-16 (une paire de substitution) coûtent quatre octets, parce qu’un point de code au-delà du plan de base fait quatre octets UTF-8. Une limite de stockage exprimée en octets et une limite d’affichage exprimée en caractères diffèrent donc d’un facteur différent selon l’écriture, et un budget écrit pour l’ASCII rejette ou accepte la mauvaise quantité de texte non ASCII.
Le producteur de ces octets est souvent une vue sur un ArrayBuffer, et ArrayBuffer et TypedArray montre pourquoi les mêmes huit octets signalent une longueur d’octets 8 sous un Uint8Array mais une longueur d’éléments 2 sous un Uint32Array, et pourquoi un alias subarray stocké meurt quand le tampon source est réutilisé.
Le cas du substitut porte un second écart, parce qu’un substitut isolé n’est pas du texte valide et TextEncoder le réécrit :
encode(lone high surrogate) -> ef bf bd
round trip lone surrogate length=1 equal=false
Les octets encodés sont ef bf bd, un U+FFFD, parce qu’un substitut isolé n’a pas de forme UTF-8. Décoder ces octets renvoie un unique caractère de remplacement, donc la longueur de chaîne correspond à la longueur d’entrée de un, mais la valeur diffère et le test d’égalité est faux. Un aller-retour peut donc conserver la longueur et changer la valeur en même temps, et c’est pourquoi une comparaison de longueurs n’est pas un test d’aller-retour. Couper une chaîne à un index arbitraire crée exactement cette forme, parce qu’une coupe dans une paire de substitution laisse une moitié isolée.
Consigner une lecture de codec
Une lecture de codec soutient une affirmation étroite : cet environnement, cette étiquette, cette option, cette entrée ont produit cette chaîne. Six champs la gardent vérifiable, et aucun ne stocke de texte qu’un décodeur pourrait réinterpréter :
- L’étiquette passée au décodeur et l’ordre des octets qu’elle implique, parce que plusieurs étiquettes sont des alias et qu’une étiquette peut lire des octets de deux façons.
- L’entrée comme séquence d’octets, pas comme texte rendu, parce que deux séquences d’octets différentes peuvent rendre pareil et qu’une séquence peut se lire avec plusieurs étiquettes.
- Si
ignoreBOMa été fixé, parce qu’il change la longueur de chaîne d’un pour les mêmes octets. - Si
fatala été fixé, parce qu’il décide entre une erreur levée et un caractère de remplacement substitué. - Si
streama été fixé par morceau et si un vidage final a tourné, parce que les deux décident si un caractère coupé survit. - La longueur d’octets UTF-8 et la longueur d’unités UTF-16 consignées séparément, parce que les deux nombres répondent à des questions différentes sur le même texte.
Ce qu’une telle lecture ne peut pas montrer, c’est quoi que ce soit sur les octets avant leur arrivée. Un décodeur reçoit une séquence d’octets ; il ne dit pas si le producteur a écrit UTF-8, Latin-1 ou UTF-16, et un écart entre producteur et consommateur est la cause la plus fréquente du texte mal encodé ci-dessus. Pour la question plus large de la façon dont une page rapporte du texte venu d’une autre couche, voir normalisation Unicode et signaux d’identité de texte, qui couvre pourquoi deux rendus du même texte visible se comparent inégaux, et limites de btoa et atob, qui couvre la voie d’encodage à un octet plus ancienne qui lève sur le même texte non ASCII que l’UTF-8 accepte.
Deux habitudes gardent la lecture honnête avec le temps. D’abord, consignez l’étiquette et les options à côté de la chaîne décodée plutôt que la chaîne seule, parce qu’une chaîne nue ne peut pas être redérivée sans savoir quelles options l’ont produite. Ensuite, comparez la valeur décodée à la valeur attendue et, pour un aller-retour, comparez la chaîne d’origine au résultat décodé plutôt que de comparer des longueurs, parce qu’un caractère de remplacement et l’unité d’origine peuvent occuper la même longueur en différant de valeur.
Sources publiques
- MDN : TextEncoder
- MDN : TextDecoder
- MDN : TextDecoderStream
- Norme WHATWG Encoding
- Annexe 15 de la norme Unicode : formes de normalisation
- BotBrowser : référence de cohérence d’automatisation
Conclusion
Traitez l’étiquette comme faisant partie du contrat de données : latin1, iso-8859-1 et windows-1252 se résolvent à un seul décodeur, TextEncoder est toujours UTF-8 et ignore toute étiquette passée, et une étiquette inconnue est la seule qui lève à la construction. Choisissez ignoreBOM volontairement et choisissez fatal quand du texte corrompu ne doit pas passer en silence. Décodez les flux avec stream: true et videz la fin, sinon un caractère multioctet coupé devient un caractère de remplacement. Consignez l’étiquette, les octets, les options et les deux longueurs séparément, et comparez la valeur décodée plutôt que la longueur pour qu’un substitut isolé encodé en un U+FFFD ne passe pas un contrôle vert.
Lecture suivante
Pour approfondir la couche texte, normalisation Unicode et signaux d’identité de texte donne les plusieurs longueurs et ordres d’une chaîne visible, et limites de btoa et atob donne la façon plus ancienne de fourrer des octets dans une chaîne et où elle échoue sur du texte non ASCII.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
btoa et atob : la frontière Latin-1
EmpreinteArrayBuffer et TypedArray : un tampon, plusieurs vues
EmpreinteUnicode : quatre identités de texte lues par une page
Empreinteua-parser-js : Client Hints, bots et un plafond de 500
EmpreinteAnalyse d’URL et des search params
EmpreinteKeyboard Layout API, préférences régionales et confidentialité
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.