Tri de tableau et comparateurs : un piège subtil
Triez des tableaux fixes : l’ordre chaîne par défaut, la mutation en place, un tri stable, où tombent undefined et NaN, un comparateur défaillant et la soustraction qui déborde.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
BotBrowser prend en charge la relecture d’un fixture autorisé du même origine sous un profil déclaré et conserve des observations bornées sur l’ordre dans lequel une page a trié un tableau, mais il ne peut pas changer la façon dont un environnement implémente l’algorithme de tri, ne peut pas rendre cohérent un comparateur qui ne l’est pas et ne fait pas d’un résultat de tri un signal d’identité. Cette revue trie des tableaux fixes avec le comparateur par défaut et des comparateurs explicites, puis consigne pourquoi l’ordre par défaut est l’ordre chaîne, pourquoi le tri mute en place, comment un tri stable garde les clés égales dans l’ordre d’insertion, où tombent undefined et NaN, pourquoi un comparateur incohérent donne un ordre faux et silencieux, et pourquoi un comparateur par soustraction déborde sur les grands nombres.
Résumé
- Le tri par défaut convertit chaque élément en chaîne et ordonne par unités de code UTF-16, donc
[10,9,1,100].sort()donne[1,10,100,9], pas l’ordre numérique. sortmute le tableau en place et renvoie la même référence, donc qui attend une copie change la source en silence.- Un comparateur numérique
(a, b) => a - bdonne[1,9,10,100], l’ordre attendu, mais un comparateur par soustraction déborde quand l’écart dépasse la plage double précision. - Le tri est stable, donc les lignes égales gardent leur ordre d’insertion, soit
bdacpour deux clés réparties2,1,2,1. undefinedet les trous tombent en fin ; un comparateur qui renvoieNaNest traité comme0pour ce couple, donc l’élément garde sa position relative.- Un comparateur qui n’est pas cohérent (non transitif) peut produire un ordre faux sans lever, car l’algorithme suppose que le comparateur est un ordre total.
toSortedrenvoie une copie et laisse la source intacte, c’est la façon de trier sans muter.
Sommaire
- Pourquoi le tri par défaut est l’ordre chaîne
- Pourquoi le tri mute en place
- Où un tri stable garde les clés égales
- Où tombent undefined et NaN
- Pourquoi un comparateur incohérent donne un ordre faux
- Consigner une lecture de tri
Pourquoi le tri par défaut est l’ordre chaîne
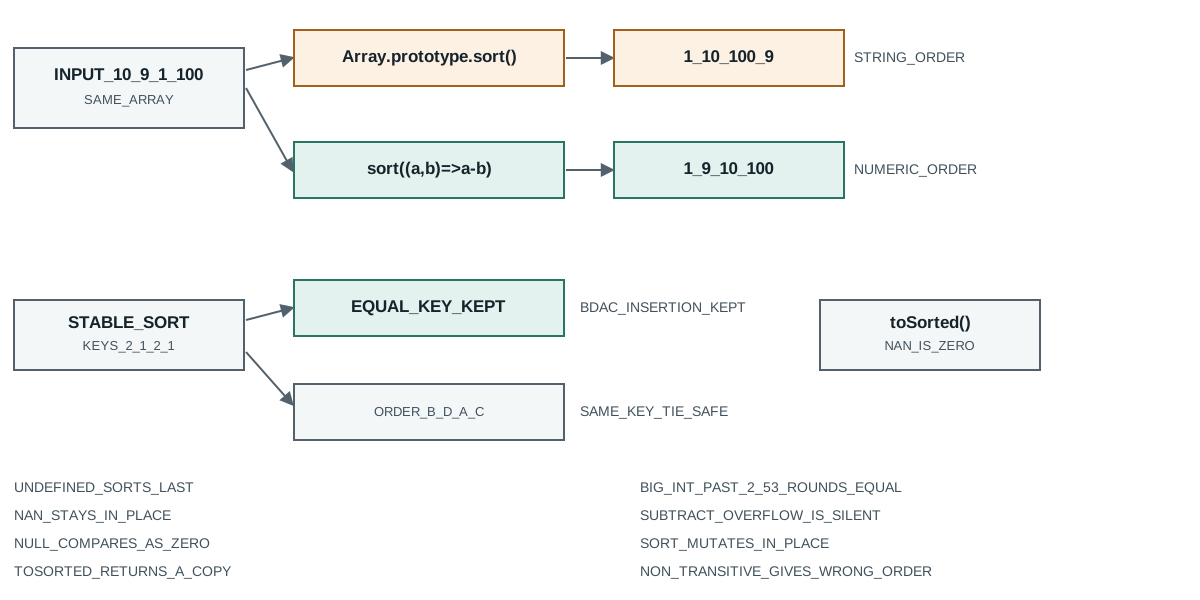
Array.prototype.sort sans comparateur ne trie pas des nombres comme des nombres. Il convertit chaque élément en chaîne et ordonne les chaînes par unité de code UTF-16. La sonde trie les mêmes quatre nombres des deux façons :
Array.sort=function node=v26.9.0
[10,9,1,100].sort() -> [1,10,100,9]
[10,9,1,100].sort((a,b)=>a-b) -> [1,9,10,100]
Le tri par défaut renvoie 1, 10, 100, 9, parce que comme chaînes "1" vient avant "10" qui vient avant "100" qui vient avant "9" par unité de code : le premier caractère de chacune décide, et "9" est plus grand que "1" donc les quatre nombres qui finissent par autre chose que 9 viennent d’abord. La forme avec comparateur renvoie 1, 9, 10, 100, l’ordre numérique attendu. Les deux appels trient le même tableau et divergent complètement, et un seul correspond à l’intuition de « trié ».
Cet écart est le défaut de tri le plus courant : un développeur appelle sort() sur un tableau de nombres, voit un résultat plausible et ne remarque jamais que l’ordre est lexicographique. Il paraît correct pour un chiffre et des chaînes d’un chiffre, et casse dès qu’une valeur à deux chiffres apparaît. Le correctif est toujours de passer un comparateur pour les nombres, jamais de compter sur le défaut, parce que le défaut est défini pour les chaînes et ne paraît correct que par hasard sur une petite entrée.
L’ordre chaîne explique aussi pourquoi le défaut traite les types mixtes par leur forme de chaîne. La sonde trie un tableau mixte d’un booléen, d’un nombre et d’une chaîne ensemble, et l’ordre suit la forme String() de chaque élément et non une règle par type. Qui suppose que le tri par défaut est « l’ordre naturel » obtient l’ordre d’unité de code, qui pour les lettres ASCII met la majuscule avant la minuscule et pour les lettres accentuées les place après toute lettre ASCII.
La sonde rend explicite l’ordre d’unité de code avec une entrée mixte de chaînes et de booléens :
["b","a","C","á"].sort() -> ["C","a","b","á"]
[true,false,2,1].sort() -> [1,2,false,true]
Les quatre chaînes trient en "C", "a", "b", "á", parce que la C majuscule a une unité de code plus petite que le a minuscule, et le á accentué a une unité de code plus grande que toute lettre ASCII simple, donc il finit en dernier. Qui attend l’ordre alphabétique mettrait "á" près de "a" et n’attendrait peut-être pas "C" avant "a", mais le tri par défaut n’est pas alphabétique et ne le prétend jamais. Le tableau mixte de booléens et de nombres trie en 1, 2, false, true, parce que "1" et "2" comme chaînes viennent avant "false" et "true", dont les premières lettres f et t ont des unités de code plus grandes que les chiffres.
Ce comportement explique pourquoi un tri sur des libellés venus d’une entrée utilisateur ne peut pas utiliser le défaut. Deux libellés qui diffèrent seulement par la casse trient dans un ordre sensible à la casse qu’un lecteur n’attend pas, et un libellé qui commence par un chiffre trie avant tout libellé qui commence par une lettre. Les alternatives sensibles à la locale, String.prototype.localeCompare et Intl.Collator, trient par règles de langue et non par unités de code, donc une liste qu’un lecteur perçoit comme alphabétique a besoin de l’une d’elles et non du défaut. Un registre qui stocke une liste triée par défaut de libellés a stocké l’ordre d’unité de code, qui est reproductible mais pas l’ordre qu’un lecteur appellerait trié.
Le coût d’une erreur ici est une liste qui est stable et reproductible mais se lit comme non triée pour toute personne qui la regarde. Un panneau qui trie des noms de compte avec le comparateur par défaut met tout compte à initiale majuscule avant tout compte à initiale minuscule, et met les noms accentués après tout le bloc ASCII, qui n’est pas l’ordre que l’opérateur qui parcourt la liste attend. L’ordre ne lève jamais, ne change jamais entre exécutions sur le même moteur, et manque silencieusement l’intention, qui est la pire combinaison parce que rien dans un test qui ne vérifie que « c’est trié » ne le détecterait sauf si ce test encode la même règle fausse. Un test écrit contre le comparateur par défaut passe ; un test écrit contre l’attente du lecteur échoue, et les deux divergent sur toute liste qui contient une casse mixte ou un nom accentué.
Il y a aussi une raison arithmétique pour laquelle l’ordre par défaut surprend sur des nombres proches. Comme le défaut compare les formes de chaîne caractère par caractère, "2" et "20" comparent sur leur premier caractère et s’égalisent là avant que le second décide, donc une liste d’ids 2, 20, 3 trie en 2, 20, 3 comme chaînes mais un lecteur attend 2, 3, 20 comme nombres. Plus le préfixe commun est long, plus la décision est tardive et plus l’ordre de texte diverge de l’ordre numérique, ce qui explique que le défaut devienne plus visible à mesure que les identifiants gagnent des chiffres plutôt que de rétrécir.
Le comparateur par défaut décide aussi de l’ordre des objets et des tableaux à l’intérieur du tableau, un endroit où un appelant regarde rarement. Tout objet se convertit en chaîne en "[object Object]", donc un tableau d’objets simples trié avec le comparateur par défaut reste dans son ordre d’insertion parce que tout élément compare égal. Un tableau de tableaux convertit chaque tableau interne en ses éléments joints par une virgule, donc le tri externe ordonne par le texte du contenu interne et non par longueur ni par un champ. Qui trie une liste d’enregistrements avec le comparateur par défaut et attend un ordre stable et significatif obtient l’ordre d’insertion pour les objets et un ordre de texte pour les tableaux imbriqués, et aucun n’est l’ordre envisagé. La leçon est que le comparateur par défaut n’a de sens que pour un tableau de primitifs dont les formes de chaîne ordonnent comme l’appelant le veut, un cas étroit qu’un tableau mixte ou structuré ne satisfait jamais.
Le comparateur par défaut a aussi une forme de performance qu’un appelant peut ne pas attendre. Convertir chaque élément en chaîne coûte une allocation par élément par comparaison au pire, et un tri qui compare le même couple plus d’une fois répète ce travail, donc un tri par défaut sur un grand tableau numérique est plus lent qu’un comparateur qui soustrait. La lenteur n’est pas le défaut, mais elle est le symptôme de la même racine : le comparateur par défaut a été écrit pour comparer des chaînes, et un tableau numérique poussé à travers lui paie le coût de conversion en chaîne à chaque comparaison pour un ordre que l’appelant ne voulait pas. Un code qui passe à un comparateur numérique obtient à la fois le bon ordre et moins de travail, un cas rare où la version correcte est aussi la plus rapide.
L’ordre chaîne du défaut explique aussi pourquoi trier une liste de nombres écrits comme chaînes semble correct un moment. Une liste de chaînes d’un chiffre "1" à "9" trie à l’ordre numérique, parce que chaque chaîne est un caractère et l’ordre d’unité de code coïncide avec l’ordre numérique pour un chiffre. Le défaut n’apparaît qu’une fois qu’une valeur a deux chiffres, car alors "10" trie avant "2" sur le premier caractère. Un fixture construit avec des valeurs d’un chiffre passe donc avec le tri par défaut, et le même code échoue sur des données de production qui contiennent une valeur de dix ou plus. L’écart entre un fixture qui passe et un cas de production qui échoue porte entièrement sur le nombre de chiffres des valeurs, ce que le tri ne signale jamais.
Pourquoi le tri mute en place
sort n’est pas une fonction pure de son entrée : il réordonne le tableau sur lequel il est appelé et renvoie ce même tableau. La sonde trie un tableau de trois éléments et vérifie si la valeur renvoyée est le même objet que la source :
same reference -> true; array now [1,2,3]
Le tableau renvoyé est la même référence que l’entrée (result === arr vaut true), et le tableau source est maintenant 1, 2, 3. Qui écrit const sorted = arr.sort() puis utilise arr ailleurs a réordonné arr en silence, parce que sorted et arr sont le même objet. C’est un vrai défaut dans un code qui garde l’ordre d’origine pour l’affichage et veut aussi une copie triée, parce que le tri a détruit l’ordre d’origine en place.
La façon de trier sans muter est toSorted, qui renvoie un tableau neuf et laisse la source intacte. La sonde confirme la différence : après toSorted la source est encore 3, 1, 2 et le tableau renvoyé est 1, 2, 3, et les deux sont des références distinctes. Qui veut à la fois l’ordre d’origine et une vue triée a besoin de toSorted ou d’un slice() explicite avant sort, pas de sort sur l’original.
Cette mutation explique aussi pourquoi un tri dans un rendu est dangereux. Si un composant trie un tableau d’état partagé pour l’afficher, le tri mute l’état à chaque rendu, et une lecture ultérieure de l’état voit l’ordre trié au lieu de l’ordre dans lequel il a été chargé. Le correctif est le même : trie une copie, et consigne quel tableau le tri a touché pour qu’un lecteur sache si l’ordre observé est l’ordre stocké ou un tri transitoire.
L’appel toSorted ci-dessus montre déjà l’alternative sûre, et elle se rentabilise dès que l’ordre d’origine compte. Qui a besoin à la fois de l’ordre chargé et d’une vue triée utilise toSorted, ou un slice() suivi de sort, et la source reste telle qu’elle a été chargée. Le coût est une allocation, négligeable face au coût d’un tableau d’état qui mute sous un composant qui supposait en être propriétaire.
Il y a un piège lié dans un comparateur qui trie par un champ qui peut manquer. Un comparateur qui lit a.key - b.key sur un élément dont la key est undefined donne NaN, que le tri traite comme égal, donc l’élément garde sa position relative au lieu de se déplacer vers un emplacement défini. Le résultat est un ordre où les lignes au champ manquant restent intercalées avec les lignes auxquelles elles ont été comparées, ce qui paraît trié au premier coup d’œil et ne l’est pas. Le correctif est de décider où appartient un champ manquant, de le trier en fin avec une branche explicite, et de consigner cette décision, parce que le tri lui-même ne le déplacera pas.
Cette mutation en place rend aussi peu fiable un tri composé avec une autre mutation. Si un appelant trie un tableau puis fait un splice d’un second, et que les deux partagent des éléments par référence, le splice lit l’ordre que le tri a laissé, qui peut ne pas être l’ordre que l’appelant supposait que le tableau partagé avait encore. Trier en place est une écriture en mémoire partagée dès que l’objet tableau est partagé, et un registre qui ne dit pas si le tableau a été partagé, cloné ou fraîchement construit ne peut pas savoir si une lecture ultérieure a vu l’ordre trié ou l’ordre avant qu’un autre code le réinitialise.
L’identité de référence explique aussi pourquoi une vérification d’égalité après un tri peut induire en erreur. Qui compare un tableau trié à lui-même pour prouver « rien n’a changé » les trouve égaux, parce que le tri a renvoyé le même objet, alors que le contenu a changé. Un test qui veut prouver que le tri a laissé la source intacte doit comparer à une copie prise avant le tri, pas à la même référence, parce que l’égalité de référence vaut que le tri ait muté ou non. La variante toSorted lève l’ambiguïté en renvoyant un objet distinct, donc une vérification de référence distingue « une copie est revenue » de « la source a été réécrite ».
La mutation en place change aussi le sens d’un nom de variable qui promet un ordre. Une constante nommée insertionOrder passée à sort puis relue ne garde plus l’ordre d’insertion, parce que le tri a réécrit le tableau derrière le nom. Le nom ment sur le contenu, et un lecteur qui se fie au nom lit un ordre trié là où le code voulait un ordre d’arrivée. Comme la mutation est invisible au site d’appel quand la valeur renvoyée est ignorée, rien dans le code qui lit le nom ne révèle que l’ordre a changé, et un registre qui stocke le tableau sous ce nom stocke l’ordre trié sous une étiquette qui prétend le contraire.
Le motif le plus sûr est de trier seulement dans la fonction qui consomme le résultat trié et de passer un clone à cette fonction quand la source compte ailleurs. Une fonction qui prend un tableau et renvoie son ordre trié doit soit documenter qu’elle trie en place, soit renvoyer toSorted, et un appelant doit décider une fois si le tableau source peut changer. Un code qui mélange les deux, triant en place à un endroit et dépendant de l’ordre d’origine à un autre, produit un défaut qui dépend de l’ordre des appels, le type le plus difficile à reproduire car il ne casse que quand les deux appelants s’exécutent dans une séquence particulière.
La mutation interagit aussi avec une copie superficielle d’une façon qui surprend qui croit qu’une copie suffit. Un slice() copie le tableau de références mais pas les éléments, donc trier la copie par un champ réordonne les références sans muter les éléments, et le tableau d’origine garde son ordre des mêmes références. C’est sûr pour l’ordre du tableau, mais si le tri écrit ensuite dans les éléments pour consigner la position triée, l’écriture atteint les éléments partagés et les éléments du tableau d’origine changent alors que son ordre non. La distinction entre « l’ordre du tableau a changé » et « les éléments ont changé » est exactement la distinction dont un registre a besoin, et ni un sort ni un slice seul ne disent laquelle s’est produite.
Un tableau gelé est le seul cas où la mutation en place échoue bruyamment. Trier un tableau Object.freeze lève en mode strict au lieu de réordonner en silence, ce qui est la seule façon dont la mutation s’annonce comme écriture. Un code qui veut garantir qu’il ne mute jamais un tableau partagé peut le geler en développement, ainsi un sort accidentel lève au lieu de laisser un réordonnancement subtil, puis utiliser toSorted là où un ordre est réellement nécessaire. Le gel est un moyen peu coûteux de transformer la mutation silencieuse en bruyante, le même compromis qu’un registre fait quand il stocke si la source pouvait changer.
Où un tri stable garde les clés égales
Le tri est stable : les éléments qui comparent égal gardent leur ordre d’insertion relatif. La sonde trie quatre lignes à deux clés distinctes et vérifie l’ordre des lignes de clé égale :
stable sort -> bdac
Les lignes d’entrée sont a (clé 2), b (clé 1), c (clé 2) et d (clé 1). Après tri par clé ascendante, l’ordre est b, d, a, c : les deux lignes de clé 1 gardent b avant d, et les deux de clé 2 gardent a avant c. Chaque groupe de clé égale a préservé l’ordre d’insertion, ce qui est ce que « stable » signifie et ce qui permet de trier par clé primaire puis clé secondaire et d’obtenir l’ordre composé attendu.
La stabilité n’a pas toujours été garantie ; des moteurs anciens utilisaient des algorithmes instables et un tri secondaire pouvait brouiller le premier. La spécification exige désormais un tri stable, donc un code qui en dépend est correct sur tout moteur actuel. La conséquence pratique est qu’un flux « trier par colonne, puis par autre colonne » n’est sûr que parce que le tri est stable, et un registre qui stocke le résultat d’un seul tri ne peut pas distinguer un résultat stable d’un instable sans stocker aussi l’ordre pré-tri des lignes de clé égale.
L’ordre stable rend aussi inutile un comparateur multi-clé dans bien des cas. Au lieu d’un comparateur qui compare clé A puis clé B, un appelant peut trier par B d’abord et A ensuite, en comptant sur la stabilité pour garder l’ordre B dans les valeurs A égales. Les deux approches donnent le même ordre quand le comparateur est cohérent, et la version à deux passes est plus lisible mais correcte seulement parce que le tri est stable.
La garantie de stabilité décide aussi de ce qu’un tableau « trier par colonne » peut promettre après un second clic. Un tableau qui trie d’abord par une colonne puis par une autre compte sur la stabilité pour garder le premier ordre dans le second, et si le moteur n’était pas stable le second clic disperserait le premier ordre et le tableau afficherait un ordre sans sens qu’aucun en-tête de colonne ne décrit. Comme la spécification exige désormais la stabilité, l’ordre composé tient sur tout moteur actuel, mais un registre qui stocke seulement l’ordre final et non la séquence des tris ne peut pas prouver que l’ordre composé a été dérivé comme le tableau le prétend.
Il y a une conséquence plus subtile pour un comparateur stable mais incohérent. Un tri stable préserve l’ordre des éléments que le comparateur appelle égaux, donc un comparateur qui appelle à tort égaux deux éléments inégaux les garde dans l’ordre où ils sont arrivés, ce qui peut paraître plausible et être faux. La stabilité fait paraître l’ordre faux intentionnel, parce qu’un tri stable ne brouille jamais les éléments égaux, donc le défaut se cache derrière la garantie même qui fait marcher les tris multi-clés. Un registre qui capture l’ordre pré-tri des éléments que le comparateur pourrait égaliser est le seul moyen de distinguer un ordre composé correct d’un tri stable sur un comparateur cassé.
La stabilité décide aussi si un tri sur des données déjà triées est un no-op. Un tri à deux passes par A puis B, lancé sur des données déjà en ordre A, laisse l’ordre A intact dans les valeurs B égales, donc relancer les mêmes deux passes ne change rien. Un seul comparateur qui lit seulement B, lancé sur les mêmes données, réordonne les lignes par B et entraîne les égalités de A dans l’ordre B, un résultat différent de la version à deux passes bien que les deux soient « triés par B ». Lequel est correct dépend de si l’appelant voulait une clé secondaire, et le tri stable est ce qui fait que la version à deux passes signifie ce qu’elle paraît.
Pour un registre, l’ordre pré-tri des clés égales est le champ qui transforme un résultat stable en résultat reproductible. Le tableau final trié seul ne dit pas lequel de deux éléments de clé égale est venu d’abord, parce que les deux ordres sont des résultats valides d’un tri stable sur la même entrée selon l’ordre d’arrivée. Seul l’ordre pré-tri plus le comparateur plus la garantie de stabilité fixent le résultat, et un registre qui stocke le tableau final sans l’ordre pré-tri a stocké l’un de plusieurs résultats valides et l’a appelé le résultat.
La stabilité compte aussi pour une déduplication qui suit un tri. Un code qui trie un tableau puis retire les doublons adjacents pour garder le « premier » de chaque série compte sur la stabilité pour garder en tête de chaque série l’élément arrivé en premier. Sur un moteur stable le premier élément arrivé gagne la déduplication, et sur un moteur instable un autre pourrait gagner, ce qui change la valeur qui survit. Comme le tri est désormais stable, le premier élément arrivé survit toujours, et un registre qui stocke le résultat dédupliqué sans l’ordre pré-tri ne peut pas dire quel élément a été gardé ni pourquoi.
Le tri composé à deux passes a un coût qu’un seul comparateur cache. Trier deux fois exécute l’algorithme deux fois, et la seconde passe réordonne tout le tableau par la clé primaire tandis que la stabilité préserve l’ordre secondaire dans les égalités. Un seul comparateur qui compare primaire puis secondaire fait le travail en une passe et donne le même résultat, mais il doit gérer la comparaison secondaire lui-même et rester cohérent sur les trois champs qu’il compare désormais. Quel que soit l’approche qu’un code choisit, le registre doit dire lequel il a utilisé, parce qu’un résultat à deux passes et un résultat à une passe sur les mêmes données ne coïncident que quand le comparateur est un ordre total cohérent sur la clé composée.
La stabilité est aussi ce qui rend un tri paginé sûr. Un serveur qui renvoie la page deux d’une liste triée compte sur un ordre stable pour que les lignes de la page deux ne répètent pas une ligne de la page un quand deux lignes égalisent sur la clé de tri. Sans stabilité l’ordre d’égalité est arbitraire par page, et une ligne peut apparaître sur les deux pages ou sur aucune, un bug classique de pagination qu’aucune erreur ne signale. Le tri stable rend l’ordre d’égalité déterministe dans une passe, mais entre deux requêtes séparées l’ordre d’égalité dépend de l’ordre dans lequel le serveur a lu les lignes, donc un tri stable côté client ne peut pas sauver une page que le serveur a construite avec un ordre instable. Le registre doit capturer quel côté a trié et si ce côté était stable.
Où tombent undefined et NaN
undefined, les trous de tableau et NaN ne se comportent pas comme des nombres ordinaires sous un tri, et la sonde montre où va chacun :
[3,undefined,1].sort() -> [1,3,null]
[3,undefined,1].sort((a,b)=>a-b) -> [1,3,null]
[1,null,3].sort((a,b)=>a-b) -> [null,1,3]
[3,NaN,1].sort((a,b)=>a-b) -> [3,null,1]
Le null imprimé dans les deux premières lignes est la vue du sérialiseur : JSON.stringify rend un emplacement de tableau qui garde undefined (après un tri qui l’a poussé en fin) en null, parce qu’un tableau ne peut pas garder undefined en JSON. La valeur stockée est undefined en fin, et le tri l’y a poussé parce que le tri par défaut traite undefined comme plus grand que tout élément défini et le trie toujours en dernier. La forme avec comparateur fait pareil, car la spécification envoie undefined en fin quel que soit le comparateur.
La ligne null est une valeur réelle : null compare comme 0 sous a - b, donc [1, null, 3] trie en null, 1, 3, avec null en tête comme s’il valait zéro. La ligne NaN est la plus tranchante : NaN comparé à toute autre valeur renvoie NaN, que le tri traite comme 0, donc NaN ne se déplace pas par rapport aux éléments auxquels il a été comparé et le tableau garde son ordre 3, NaN, 1. Un comparateur qui renvoie NaN pour tout un tri est traité comme « égal » pour tout couple, donc l’ordre est préservé.
Ces deux comportements expliquent pourquoi un registre trié doit nommer s’il garde undefined, des trous ou NaN. Une liste triée de nombres qui contient en silence un NaN ne trie pas à l’ordre numérique qu’un lecteur attend, parce que le NaN reste où il était et le reste trie autour de lui. Un registre qui stocke seulement le tableau imprimé, avec le NaN déjà converti en null par le sérialiseur, ne peut pas être relancé au même ordre sans savoir que le NaN était là.
La ligne NaN change aussi la façon dont un tri se compose avec un filtre. Un code qui trie puis filtre l’élément de tête compte sur le tri pour mettre un élément connu en tête ; si le tableau contient un NaN resté en place, l’élément de tête n’est pas le minimum, et le filtre retire le mauvais élément. Le NaN reste où il a été inséré et le tri l’y laisse, donc la tête du tableau trié est le plus petit des éléments que le tri a réellement déplacés, qui peut être un élément différent du minimum du tableau entier. Un registre qui note la présence d’un NaN est ce qui permet à un lecteur de savoir que l’élément de tête n’est pas nécessairement le minimum, et un code qui filtre avant de trier évite la trappe entièrement.
Les cas undefined, trou et NaN partagent une leçon pour un fixture : teste le tableau tel qu’il arrive, pas tel qu’il apparaît après une étape de nettoyage. Un fixture qui pré-trie un tableau nettoyé passe, et le même code sur un tableau avec un undefined en fin ou un NaN égaré se comporte autrement sans lever. L’étape de nettoyage cache justement l’entrée que le tri gère spécialement, et un registre qui stocke le tableau nettoyé a stocké la version que le tri traite comme ordinaire, pas la version que la voie de production lui donne.
L’interaction entre undefined et le comparateur mérite un pas de plus, car elle décide si un comparateur sur des valeurs mixtes se comporte comme le défaut ou non. Un comparateur qui ajoute ou soustrait une valeur définie et un undefined produit NaN, et la spécification envoie undefined en fin avant même que le comparateur soit consulté, donc l’arithmétique ne s’exécute jamais pour ce couple. Cela signifie qu’un comparateur qui échouerait sur undefined dans une boucle simple est sûr dans un tri, parce que le tri retire les éléments undefined d’abord. Qui pré-filtre les undefined du tableau avant de trier a donc fait un travail que le tri aurait fait de toute façon, et qui les laisse dedans obtient un résultat défini et reproductible au lieu d’une exception.
La valeur null est le cas qui ne se comporte ni comme undefined ni comme un nombre qu’un lecteur attendrait. null se convertit en 0 sous soustraction, donc un comparateur le trie en tête numérique, et qui traite null comme « manquant » et l’attend en fin le trouve au début. La distinction entre « manquant en undefined » et « manquant en null » change donc le résultat du tri, et un registre qui stocke seulement le tableau imprimé avec les deux rendus en null ne peut pas dire quelle représentation la source a utilisée. Qui relance le tri sur la forme stockée obtient un ordre différent de l’original dès que les deux représentations étaient mélangées, parce que l’une a trié en fin et l’autre en tête.
Pourquoi un comparateur incohérent donne un ordre faux
L’algorithme de tri suppose que le comparateur décrit un ordre total : s’il dit que a n’est pas plus grand que b et b n’est pas plus grand que c, alors a n’est pas plus grand que c, et a compare égal à lui-même. Un comparateur qui rompt cela peut produire un ordre faux sans lever. La sonde trie avec un comparateur qui ne compare que la parité et montre à la fois un cas bénin et un cassé :
sort(()=>0) keeps order -> [3,1,2,5,4]
non-transitive comparator -> [2,4,6,8,10,1,3,5,7,9,11]
sort(() => 0) dit que tout couple est égal, donc l’algorithme laisse le tableau tel quel : 3, 1, 2, 5, 4. C’est inoffensif et prévisible. Le comparateur non transitif (a, b) => (a % 2) - (b % 2) dit que tout nombre pair est plus petit que tout impair, mais il n’est pas cohérent : un pair, un impair et un autre pair peuvent comparer en cercle. Le résultat 2, 4, 6, 8, 10, 1, 3, 5, 7, 9, 11 met tous les pairs d’abord et les impairs après, mais dans le groupe impair l’ordre 1, 3, 5, 7, 9, 11 et dans les pairs 2, 4, 6, 8, 10 se trouvent ascendants seulement parce que l’entrée l’était ; une entrée différente peut laisser les pairs désordonnés, et rien ne lève.
Un comparateur qui renvoie une valeur plus grande que l’écart de double précision entre les deux nombres a le même mode de défaillance par une autre cause. La sonde trie trois valeurs autour de 2^53 avec un comparateur par soustraction :
big subtract sort -> ["-9007199254740992","1","9007199254740992"]
2^53 est le plus grand entier en dessous duquel tout entier est représentable exactement comme double, et un entier un au-dessus n’est pas représentable, donc (2^53) - (2^53 + 1) ne peut pas valoir -1 ; il s’arrondit à 0, et le comparateur signale deux nombres inégaux comme égaux. Un comparateur par soustraction sur cette plage donne donc un ordre arbitraire mais stable au lieu de l’ordre numérique, et l’échec est silencieux. Le correctif est d’écrire le comparateur avec des branches explicites plus-petit-que et plus-grand-que qui renvoient -1, 1 ou 0, plutôt que de soustraire.
Le débordement est silencieux de la même façon que l’ordre chaîne est silencieux, et il vaut la peine de dire pourquoi les deux partagent une racine. Les deux défauts viennent de faire confiance à une comparaison facile à écrire et fausse sur une partie de son entrée : le comparateur par défaut fait confiance à la forme de chaîne d’un nombre, et un comparateur par soustraction fait confiance à ce que la différence tienne dans un double. Les deux produisent un ordre stable et sans lever qui paraît trié pour les entrées qu’un développeur teste et diverge sur les entrées qui comptent, donc aucun n’est détecté par un test qui vérifie seulement que le code a tourné. Le correctif pour les deux est de rendre la comparaison explicite et totale sur le domaine réel, et de consigner le domaine pour qu’un lecteur ultérieur sache sur quelles entrées le comparateur a été validé.
L’exigence de cohérence et celle de débordement se rejoignent au même endroit : un comparateur doit définir un ordre total sur les valeurs qu’il verra réellement. Un comparateur écrit pour des nombres qui reçoit un NaN, un null, un undefined ou une chaîne n’est plus un ordre total sur son entrée, et le tri produira un ordre qu’un test de comparaison stricte rejette sans lever quoi que ce soit. Le remède est de normaliser les entrées avant le tri, ou d’écrire un comparateur qui gère chaque type explicitement, puis de consigner quels types ont été gérés, parce que le tri lui-même ne se plaint jamais d’un comparateur auquel il ne peut pas se fier.
Consigner une lecture de tri
Une lecture de tri soutient une affirmation étroite : cet environnement, ce tableau, avec ce comparateur, ont produit cet ordre. Six champs la gardent vérifiable, et aucun ne suppose que le tableau est numérique ou que le comparateur est cohérent :
- Le comparateur, consigné comme texte source ou comme le choix « par défaut », parce que le tri par défaut ordonne par chaîne tandis que tout comparateur explicite définit son propre ordre.
- Si le tri a muté le tableau source ou renvoyé une copie, parce que
sortmute en place ettoSortedrenvoie une copie, et un ordre stocké sans cela ne peut pas être attribué au bon tableau. - L’ordre pré-tri de tout groupe de clé égale, parce qu’un tri stable le préserve et le résultat stocké seul ne montre pas quel élément égal est venu d’abord.
- Si le tableau gardait
undefined, des trous ouNaN, parce qu’ils trient en fin ou restent en place au lieu de suivre l’ordre numérique, et un sérialiseur les convertit ennull. - Si le comparateur est un ordre total cohérent, parce qu’un comparateur non transitif ou qui déborde produit un ordre faux sans lever.
- Les types d’élément, parce qu’un tableau mixte trie par la forme de chaîne de chaque élément sous le comparateur par défaut, pas par un ordre numérique partagé.
Ce qu’une telle lecture ne peut pas montrer, c’est quoi que ce soit sur la façon dont un serveur ou un second environnement triera les mêmes données. Une page trie son propre tableau, mais un serveur qui renvoie une liste pré-triée a peut-être utilisé un comparateur différent, et un tri stable côté client ne peut pas récupérer un ordre que le serveur n’a pas envoyé. Pour l’ordre des clés qu’un sérialiseur donne à un objet, Ordre des clés montre pourquoi les clés entières trient en tête tandis que les clés chaîne gardent l’ordre d’insertion, et pour le conteneur qu’une copie garde, structuredClone face à JSON montre quels types survivent à une copie profonde et ce qu’un aller-retour JSON fait s’effondrer.
Deux habitudes gardent la lecture honnête avec le temps. D’abord, passez toujours un comparateur explicite pour les nombres et écrivez-le avec des branches plus-petit-que et plus-grand-que plutôt qu’avec une soustraction, ainsi un grand écart ne s’arrondit pas à égal. Ensuite, consignez si le tri a muté la source et quel était l’ordre des clés égales avant le tri, ainsi un ordre stocké est attribuable et un résultat stable se distingue d’un résultat chanceux.
Sources publiques
- MDN : Array.prototype.sort
- MDN : Array.prototype.toSorted
- MDN : stabilité du tri
- ECMAScript : Array.prototype.sort
- MDN : Number.MAX_SAFE_INTEGER
- BotBrowser : référence de cohérence d’automatisation
Conclusion
Traitez le comparateur comme faisant partie du contrat de données : le tri par défaut ordonne par chaîne et convertit [10,9,1,100] en [1,10,100,9], donc passez toujours un comparateur numérique explicite, écrit avec des branches plus-petit-que et plus-grand-que plutôt qu’avec une soustraction pour qu’un écart au-delà de 2^53 ne s’arrondisse pas à égal. Sachez que sort mute en place et toSorted renvoie une copie, que le tri est stable donc les clés égales gardent l’ordre d’insertion, que undefined et les trous trient en fin tandis qu’un NaN reste en place, et qu’un comparateur qui n’est pas un ordre total cohérent donne un résultat faux et silencieux. Consignez le comparateur, si la source a muté, l’ordre pré-tri des clés égales et tout undefined, trou ou NaN, ainsi un ordre stocké est attribuable et un résultat stable se distingue d’un résultat chanceux.
Lecture suivante
Pour l’ordre des clés qu’un sérialiseur donne à un objet, lisez Ordre des clés ; pour quels types de conteneur survivent à une copie profonde avant qu’aucun tri ne s’exécute, lisez structuredClone face à JSON.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
Ordre des clés : les entiers trient, les chaînes restent
EmpreinteAnalyse d’URL et des search params
EmpreintestructuredClone face à JSON : copies profondes
EmpreinteTextDecoder et TextEncoder : octets contre chaînes
EmpreinteUnicode : quatre identités de texte lues par une page
Empreintebtoa et atob : la frontière Latin-1
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.