btoa et atob : la frontière Latin-1
Exécutez btoa et atob sur des textes accentués, CJK et emoji pour voir où chacun lève, ce que renvoie atob, si le remplissage est optionnel et quel alphabet est rejeté.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
BotBrowser prend en charge le rejeu d’un fixture autorisé de même origine sous un profil déclaré et la conservation d’observations bornées sur l’API d’encodage qu’une page a appelée et sur l’erreur qu’elle a levée, mais il ne change pas la façon dont un environnement implémente btoa ou atob, ne peut pas faire accepter des caractères astraux à un encodeur limité à Latin-1, et ne transforme pas une erreur d’encodage en empreinte. Cette revue exécute les deux fonctions sur des textes accentués, CJK et emoji, puis consigne où chacune lève, ce que renvoie atob et quelles entrées se décodent sans remplissage.
Résumé
btoan’accepte que des unités de code inférieures à 256."café"encode,"ÿ"encode, mais"Ā"(U+0100) et"😀"lèventInvalidCharacterError.- L’approche standard consiste à convertir d’abord le texte en octets avec
unescape(encodeURIComponent(texte)), puis à remettre ces octets àbtoa. Le résultat égale alors les octets UTF-8 de l’original. atobrenvoie une chaîne binaire, pas du texte. La lire directement donne du texte corrompu ; une seconde étape de décodage ramène les mêmes octets à l’original.atobaccepte une entrée sans remplissage et rejette l’alphabet sûr pour URL :"a-b_"lève tandis que"a+b/"se décode.- La longueur de sortie vaut
4 * ceil(n / 3), donc 0 à 6 octets donnent des longueurs 0, 4, 4, 4, 8, 8, 8 avec le remplissage correspondant.
Sommaire
- Où btoa refuse une entrée
- L’enveloppe qui convertit le texte en octets
- Ce que renvoie atob et pourquoi une seconde étape est nécessaire
- Remplissage, omission du remplissage et alphabet sûr pour URL
- Arithmétique de longueur et aller-retour sur tous les octets
- Consigner une lecture d’encodage
Où btoa refuse une entrée
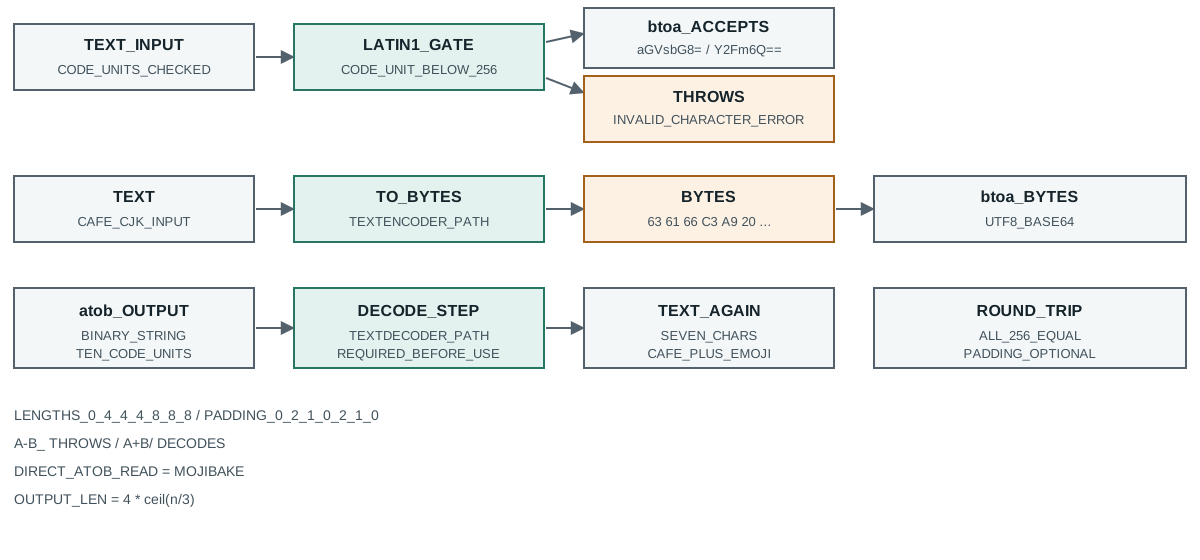
Le standard HTML définit btoa sur des unités de code, et la contrainte est plus étroite que la plupart des appelants ne l’imaginent. Chaque unité de code de la chaîne d’entrée doit être inférieure à 256, ce qui signifie que seul le texte Latin-1 passe. La mesure sur six chaînes rend la frontière exacte :
btoa("hello") -> ok aGVsbG8=
btoa("café") -> ok Y2Fm6Q==
btoa("ÿ") -> ok /w==
btoa("Ā") -> THREW InvalidCharacterError
btoa("😀") -> THREW InvalidCharacterError
btoa("中文") -> THREW InvalidCharacterError
Deux résultats surprennent. "café" encode sans protester, car la lettre accentuée de ce littéral est l’unique point de code U+00E9, inférieur à 256, donc aucune exception ne se déclenche. "ÿ" est U+00FF, la dernière unité de code qui tient encore, et elle encode aussi. Le premier refus est "Ā" en U+0100, juste après la frontière, et l’exception est InvalidCharacterError.
La ligne emoji montre pourquoi l’échec ne concerne pas « non ASCII » comme catégorie approximative. Un emoji est hors du plan multilingue de base, donc il est stocké comme paire de substitution, et les deux moitiés sont des unités de code supérieures à 255. btoa voit une unité de code de 0xD83D et refuse avant même de regarder la seconde moitié. Un appelant qui ne teste qu’avec du texte d’Europe de l’Ouest ("café" est le préféré) peut livrer un chemin qui marche à chaque test manuel et casse la première fois qu’arrive un emoji ou un nom CJK.
L’objet d’erreur mérite d’être consigné car c’est le seul signal qu’une page reçoit. Il n’y a pas de sortie partielle ni de statut renvoyé, donc un appelant qui enveloppe btoa dans un bloc try ne peut distinguer une violation Latin-1 d’une fonction absente que par le nom. Le texte du message est court et non spécifié, donc un fixture doit vérifier error.name et non le message.
Rien dans cette frontière ne dépend de la version de l’environnement. La contrainte est écrite dans l’algorithme, donc un navigateur et Node concordent, et un test qui reproduit la levée dans Node la reproduira dans le navigateur qui exécute la même page.
Une seconde raison rend la frontière facile à mal lire : la ligne accentuée et la ligne qui refuse se ressemblent à l’écran. "café" et "Ā" se lisent tous deux comme « une lettre avec une marque », mais l’un encode et l’autre lève, car la propriété décisive est le point de code numérique et non la forme visuelle. Un é composé est un point de code sous 256 ; un Ā composé est un point de code au-dessus ; et un é décomposé écrit comme e plus un accent combinant est deux points de code, dont le second est U+0301 et reste sous 256, donc il encode aussi. Un relecteur qui raisonne sur l’apparence plutôt que sur les points de code prédira le mauvais résultat sur au moins un de ces trois cas.
C’est aussi pourquoi une API orientée octets s’accorde mal avec du texte venant d’un formulaire, d’un presse-papiers ou d’une URL. Ces sources livrent couramment des formes décomposées, des jointures de largeur nulle et des séquences d’emoji, et chacune change quelles unités de code atteignent btoa. Consigner les points de code de l’entrée qui échoue, et pas seulement son texte rendu, est ce qui permet à un lecteur ultérieur de reproduire l’exception.
L’enveloppe qui convertit le texte en octets
Le correctif largement copié est une idiome en deux étapes. encodeURIComponent transforme le texte en une chaîne à codage pourcent des octets UTF-8, et unescape ramène chaque %XX à l’octet qu’il représente, laissant une chaîne dont les unités de code sont exactement les octets UTF-8. Remettre cette chaîne à btoa produit le Base64 des octets UTF-8.
wrap("café") -> Y2Fmw6k= byteCount=5 btoaMatchesUtf8=true
wrap("😀") -> 8J+YgA== byteCount=4 btoaMatchesUtf8=true
wrap("中文") -> 5Lit5paH byteCount=6 btoaMatchesUtf8=true
Trois faits sortent de ces lignes. Les nombres d’octets correspondent à la longueur UTF-8, pas à la longueur de la chaîne JavaScript : "café" fait quatre unités de code mais cinq octets, "😀" fait deux unités de code mais quatre octets, et "中文" fait deux unités de code mais six octets. Le Base64 produit égale le Base64 du même texte encodé par l’encodeur UTF-8 de l’environnement lui-même, ce que la sonde vérifie directement avec l’indicateur btoaMatchesUtf8. Et l’enveloppe ne lève jamais pour ces entrées, car au moment où btoa s’exécute, chaque unité de code est déjà un octet.
L’idiome fonctionne, et il porte aussi deux inconvénients à nommer. unescape est déprécié, et un linter configuré pour le JavaScript moderne le signalera, donc une base de code qui applique cette règle ne peut pas utiliser cette forme exacte. Et le passage par le codage pourcent alloue trois chaînes intermédiaires, ce qui compte si l’appel se trouve dans une boucle chaude qui encode des milliers de petites valeurs. Le remplacement moderne construit la chaîne d’octets avec TextEncoder :
function btoaUtf8(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = '';
  for (const byte of bytes) binary += String.fromCharCode(byte);
  return btoa(binary);
}
Cette version évite unescape et produit le même Base64, car TextEncoder émet directement les octets UTF-8. C’est la forme à enseigner, puisque l’idiome déprécié ne survit que parce qu’il précède TextEncoder dans les environnements anciens.
Ce que renvoie atob et pourquoi une seconde étape est nécessaire
atob est l’inverse de btoa, pas l’inverse de btoaUtf8. Elle renvoie une chaîne binaire dont les unités de code sont les octets décodés, et elle ne sait ni ne se soucie que l’original était du texte UTF-8. Lire cette chaîne binaire comme si c’était du texte est le défaut qui produit le texte corrompu, et la mesure montre les octets exacts :
atob(b64) is a binary string of 10 code units: 63 61 66 c3 a9 20 f0 9f 98 80
  read as text directly -> "café ð.." equalToOriginal=false
  after escape/decode  -> "café 😀" equalToOriginal=true
Dix octets, et chacun correspond à l’encodage UTF-8 de "café 😀" : 63 61 66 est caf, c3 a9 est la séquence de deux octets de é, 20 est l’espace, et f0 9f 98 80 est la séquence de quatre octets de l’emoji. Les octets décodés sont corrects. L’échec survient quand un appelant traite la chaîne binaire de dix octets comme si c’était l’original de dix caractères, ce qu’elle n’est pas : l’original a sept caractères et le nombre d’octets est dix.
Cet écart explique pourquoi une implémentation naïve paraît fonctionner jusqu’à ce qu’elle cesse. Pour l’ASCII pur, un octet égale un caractère, donc atob suivi d’un usage direct donne la bonne réponse et chaque test avec du texte anglais passe. Dès que la valeur contient un caractère multi-octets, la chaîne d’octets et la chaîne de texte divergent, et l’appelant qui a sauté la seconde étape stocke des données corrompues. La sonde rend la corruption concrète sur une chaîne CJK :
wrong-path round trip of "中文测试" -> "ä¸æ..." equal=false
Le bon chemin reflète l’encodeur : prendre la chaîne binaire de atob, reconstruire les octets et les décoder en UTF-8. L’appariement déprécié est decodeURIComponent(escape(binaire)) ; l’appariement moderne construit un Uint8Array à partir de la chaîne binaire et lance TextDecoder :
function atobUtf8(encoded) {
  const binary = atob(encoded);
  const bytes = Uint8Array.from(binary, char => char.charCodeAt(0));
  return new TextDecoder().decode(bytes);
}
Les deux formes ramènent les mêmes dix octets à sept caractères. La leçon qu’un fixture doit consigner est que atob a réussi dans les deux cas, donc une vérification qui affirme seulement « n’a pas levé » ne détecte pas le texte corrompu. Le registre doit comparer le texte décodé à l’original, ce qui est une assertion différente de vérifier que l’appel a renvoyé.
Une comparaison numérique rend l’écart impossible à manquer. La chaîne originale a sept caractères ; la chaîne binaire de atob a dix unités de code. Les trois en trop viennent entièrement des deux caractères multi-octets, é ajoutant un octet et l’emoji en ajoutant deux, soit trois au total. Un appelant qui valide une valeur décodée en comparant les longueurs à l’original verra donc un écart pour chaque chaîne contenant un caractère hors ASCII, et un appelant qui saute la comparaison stockera la chaîne d’octets plus longue et ne le remarquera que lorsqu’un analyseur en aval la rejettera.
La même arithmétique explique pourquoi le défaut survit aux tests occasionnels. Un fixture qui n’encode et décode que "hello" voit cinq octets en entrée, une chaîne Base64 de huit caractères et cinq caractères en sortie, donc l’original et le texte décodé concordent et l’aller-retour semble exact. Dès qu’un caractère accentué entre dans la valeur, le nombre d’octets et le nombre de caractères se séparent, et le défaut apparaît plus tard plutôt que dans la suite qui n’a jamais reçu de chaîne non ASCII.
Remplissage, omission du remplissage et alphabet sûr pour URL
Base64 remplit sa sortie jusqu’à un multiple de quatre avec des caractères =, et les appelants supposent souvent que le décodeur exige ce remplissage. La mesure montre que atob accepte les deux formes :
atob("aGVsbG8") -> ok "hello"
atob("aGVsbG8=") -> ok "hello"
La première chaîne perd son = final, et atob renvoie quand même "hello". Cette indulgence est utile quand un serveur retire le remplissage pour une URL plus courte, mais elle signifie aussi qu’un décodeur ne peut pas servir à valider qu’une entrée était correctement remplie. Si un fixture doit rejeter une entrée sans remplissage, ce contrôle se place avant atob, pas à l’intérieur.
L’alphabet est une autre affaire. Le Base64 standard utilise + et / ; la variante sûre pour URL utilise - et _. atob n’implémente que l’alphabet standard, donc les caractères sûrs pour URL lèvent :
atob("a-b_") -> THREW InvalidCharacterError
atob("a+b/") -> ok "kæÿ"
La seconde ligne décode quatre caractères en trois octets, qui forment par hasard une chaîne valide de trois caractères. La première lève au premier caractère sûr pour URL qu’elle rencontre. Un appelant qui reçoit un jeton d’une URL, d’un segment JWT ou d’un slug de nom de fichier tient donc du Base64 sûr pour URL, et le remettre directement à atob échoue précisément sur les entrées qui utilisent les deux caractères substitués. Le correctif est une traduction de deux lignes avant décodage : remplacer - par + et _ par /, puis restaurer le remplissage si la longueur n’est pas un multiple de quatre. Cette traduction est peu coûteuse, et son absence est une cause fréquente de « marche pour certains jetons, échoue pour d’autres », car un jeton court peut ne contenir aucun des deux caractères substitués.
Arithmétique de longueur et aller-retour sur tous les octets
La longueur de sortie suit une règle fixe qui permet de dimensionner un tampon ou de détecter une chaîne tronquée sans la décoder. Chaque groupe de trois octets d’entrée devient quatre caractères de sortie, et un groupe final d’un ou deux octets est rempli jusqu’à cette largeur :
bytes=0 base64Len=0 padding=0
bytes=1 base64Len=4 padding=2
bytes=2 base64Len=4 padding=1
bytes=3 base64Len=4 padding=0
bytes=4 base64Len=8 padding=2
bytes=5 base64Len=8 padding=1
bytes=6 base64Len=8 padding=0
Le motif se répète tous les trois octets : un multiple de trois n’a pas de remplissage, un octet restant donne deux =, et deux octets restants en donnent un. La longueur de sortie vaut donc 4 * ceil(n / 3), et le nombre de remplissages (3 - n mod 3) mod 3. Un appelant peut prédire la taille encodée avant d’encoder, ce qui compte quand la valeur doit tenir dans une limite de colonne ou un budget d’URL : chaque trois octets coûtent quatre caractères, donc un encodage d’un nombre connu d’octets a un plafond connu.
Cette prévisibilité a un usage pratique au-delà du dimensionnement de tampons. Comme la longueur encodée est une fonction pure du nombre d’octets, un décodeur peut rejeter une chaîne tronquée sans l’analyser : si une valeur affirme encoder un certain nombre d’octets mais que sa longueur n’est pas 4 * ceil(n / 3), quelque chose a été coupé. Le remplissage seul n’est pas un signal fiable, puisque atob accepte une chaîne sans remplissage, mais la longueur totale borne encore ce que la chaîne peut représenter.
La plage complète des octets ferme la boucle. Encoder les 256 valeurs d’octet possibles via btoa puis les décoder via atob renvoie une chaîne identique octet pour octet :
all 256 bytes via btoa/atob: byteIdentical=true length=256
Ce résultat est la garantie dont un appelant a réellement besoin de la paire : quels octets entrent reviennent inchangés, pour toute la plage Latin-1, sans perte ni substitution. Il montre aussi la frontière de la section précédente à l’envers. btoa gère chaque valeur d’octet de 0 à 255, c’est pourquoi le texte Latin-1 encode, et ne refuse que les unités de code supérieures à 255, c’est pourquoi tout texte hors Latin-1 a besoin d’abord de la conversion en octets. Les deux moitiés de l’article décrivent la même frontière depuis des côtés opposés.
Consigner une lecture d’encodage
Une lecture d’encodage qui survit à une revue nomme la frontière et la prouve. Six champs couvrent la partie observable, et aucun ne stocke la valeur secrète :
- L’environnement et les noms des fonctions, pour qu’un lecteur sache que les résultats viennent de
btoaetatobstandard et non d’un polyfill. - Les chaînes exactes qui ont encodé et celles qui ont levé, avec le nom de l’erreur, pour que la frontière Latin-1 soit reproductible.
- Si l’enveloppe texte-en-octets a été appliquée et quel nombre d’octets elle a produit, comparé à l’encodeur UTF-8 de l’environnement.
- Si l’étape de décodage a été exécutée, et si le résultat égale l’original comme texte, pas seulement si
atoba renvoyé. - L’alphabet en usage, standard ou sûr pour URL, et si le remplissage était présent.
- Le nombre d’octets et la longueur de sortie obtenue, pour pouvoir vérifier la règle
4 * ceil(n / 3).
Ce qu’un tel registre ne peut pas montrer, c’est quoi que ce soit sur la confidentialité des données. Base64 est un encodage, pas un chiffrement, et un lecteur peut l’inverser en une étape, donc le registre doit garder l’égalité d’aller-retour et les nombres d’octets plutôt que le contenu décodé. Pour la question plus large de la façon dont le traitement du texte et de l’encodage d’une page interagit avec les chaînes qu’elle rapporte, voir normalisation Unicode et identités de texte, et pour voir comment les choix d’octets d’un environnement se manifestent dans une autre API, voir la comparaison de la source aléatoire de crypto-js.
Deux habitudes gardent la lecture honnête dans le temps. D’abord, affirmez sur le nom de l’erreur et les nombres d’octets, pas sur le texte du message, car la frontière est standardisée et le message ne l’est pas. Ensuite, incluez au moins une chaîne non Latin-1 et un jeton sûr pour URL dans chaque fixture qui touche ces fonctions, pour que les deux échecs silencieux les plus courants ne puissent pas passer une suite verte.
Sources publiques
- MDN : fonction globale btoa()
- MDN : fonction globale atob()
- Standard HTML : décodage base64 indulgent
- RFC 4648 : encodages de données Base16, Base32 et Base64
- MDN : TextEncoder
Conclusion
Vérifiez que chaque unité de code est inférieure à 256 avant d’appeler btoa, et convertissez le texte en octets avec TextEncoder plutôt que de vous fier à l’entrée. Traitez atob comme l’inverse d’une chaîne d’octets et décodez toujours le résultat en texte avant de l’utiliser. Traduisez le Base64 sûr pour URL vers l’alphabet standard et restaurez le remplissage, consignez les nombres d’octets et le nom de l’erreur, et gardez une chaîne non Latin-1 et un jeton sûr pour URL dans le fixture pour que les échecs silencieux restent visibles.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
Unicode : quatre identités de texte lues par une page
EmpreinteQu'est-ce que l'empreinte des polices ? Cohérence du texte
EmpreinteSource aléatoire de crypto-js : quelle branche
Empreinteua-parser-js : Client Hints, bots et un plafond de 500
EmpreinteObservabilité de l’aléa cryptographique et empreintes du navigateur
EmpreinteFingerprinting par mesure de texte : suivi sous-pixel
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.