Ce que les suites de détection publiques testent vraiment
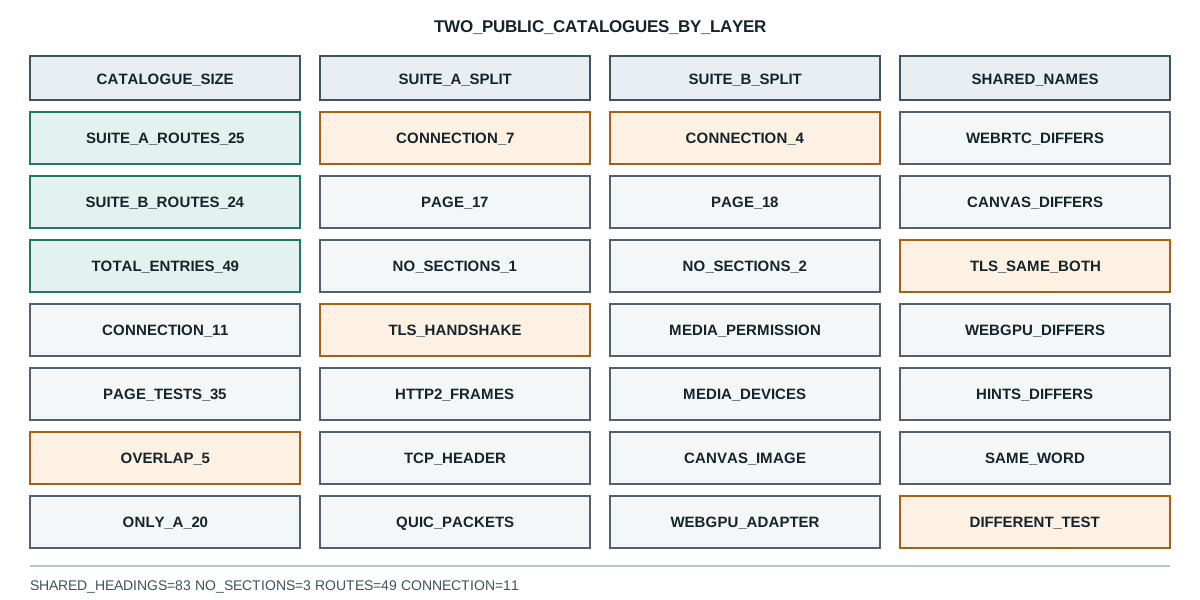
Deux suites publiques publient 49 tests à elles deux. Lire leurs propres catalogues montre que 11 lisent la connexion et que quatre noms communs sont classés différemment.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
BotBrowser garde un profil déclaré cohérent sur les surfaces qu’une page peut lire et peut conserver un enregistrement borné de ce que la page a rapporté, mais il ne peut pas faire décrire par la liste de tests d’une suite publique des couches que cette suite n’ouvre jamais, ni faire concorder deux suites sur ce que signifie un nom de test. Cette analyse lit deux suites de détection publiques depuis leurs propres pages, compte ce que chacune propose et note quels tests leurs propres titres de section placent sur la connexion plutôt que dans le document, parce que cette séparation décide de ce qu’un rapport propre de l’un ou l’autre site peut soutenir.
Résumé
- BrowserLeaks publie 25 routes de test et BrowserScan en publie 24, soit 49 entrées sans pondérer le travail de chacune.
- En lisant les titres de section de chaque page, 7 routes de BrowserLeaks et 4 de BrowserScan nomment une grandeur de la connexion, comme une poignée de main, une liste de chiffrements, une trame HTTP/2 ou un en-tête TCP.
- Il reste 17 et 18 routes dont les sections publiées restent dans le document, plus 1 et 2 routes qui ne rendent aucune section.
- Les deux catalogues partagent 5 noms de route : WebRTC, canvas, TLS, WebGPU et client hints. Ils diffèrent sur 20 et 19 routes respectivement.
- Le nom partagé TLS est le seul que les deux suites classent comme test de connexion.
- Les quatre autres noms partagés sont classés différemment, et dans chaque cas la différence porte sur ce dont parlent les sections de la page.
- BrowserScan répète 83 titres de navigation partagée sur chaque page, donc un compte brut surestime ce que dit chaque test.
- 3 pages sur les deux suites ne rendent aucun titre de section, et l’exécution les signale comme illisibles au lieu de deviner ce qu’elles testent.
Sommaire
- Ce que chaque suite publie
- Où la connexion apparaît dans une page de test
- Pourquoi un nom peut désigner deux tests
- Ce qu’un rapport propre de suite peut soutenir
- Comment les trois groupes échouent différemment
- Enregistrer une lecture de suite
Ce que chaque suite publie
Les deux sites publient leur liste de tests comme navigation, ce qui rend le catalogue lisible sans rien exécuter. La sonde récupère chaque page d’accueil, extrait toutes les routes internes, puis récupère chaque route et ne garde que les titres de section que la page ajoute elle-même : Un catalogue de suites publiques est un autre objet qu’un registre de bibliothèque : ce que les suites de détection publiques testent vraiment compte 25 et 24 routes publiées et en trouve 11 qui nomment la connexion. Un catalogue public et un registre de bibliothèque sont des objets différents, et le registre de détecteurs de BotD et les états de composants montre la forme registre tandis que les groupes de signaux de CreepJS et leur combinaison montre un repliement par groupes.
node=v26.9.0
parallel_pool=4
suite:BrowserLeaks -> front_status=200 bytes=12700 routes=25
suite:BrowserLeaks -> shared_chrome_headings=0
suite:BrowserLeaks -> routes=/ip /javascript /webrtc /canvas /webgl /fonts /geo /features /tls /proxy /settings /quic /http2 /tcp /chrome /webgpu /client-hints /dns /css /rects /donottrack /flash /silverlight /java /resource-urls
suite:BrowserScan -> front_status=200 bytes=134999 routes=24
suite:BrowserScan -> shared_chrome_headings=83
Les deux pages d’accueil diffèrent d’un facteur dix en taille, et cette différence apparaît dans les titres partagés. BrowserLeaks rend son menu sans balises de titre, donc chaque titre d’une page de test appartient à cette page. BrowserScan répète 83 titres de navigation sur chaque route, et les retirer fait la différence entre lire un test et lire le menu.
Cette soustraction n’est pas cosmétique. Avant elle, chaque route de BrowserScan ressemblait à un test de connexion, parce que le menu partagé contient les mots DNS, HTTP2, SSL et TLS. Compter les titres sans retirer le bloc partagé ferait conclure que les 24 routes testent la connexion, et ce nombre serait un artefact du modèle.
Les tailles disent aussi quelque chose sur la construction de chaque suite. Une page d’accueil de 12,700 octets qui liste 25 routes est un annuaire : elle nomme les tests et renvoie le lecteur plus loin. Une page d’accueil de 134,999 octets avec 83 entrées de navigation porteuses de titres est une coque d’application, et chaque route en hérite. Les deux choix sont légitimes et produisent des problèmes de mesure différents. Sur l’annuaire, un compte de routes est proche d’un compte de tests. Sur la coque, le lecteur doit séparer la coque de la page avant que le moindre compte ait un sens, et celui qui ne le fait pas rapporte un nombre qui appartient au modèle.
Où la connexion apparaît dans une page de test
Le classificateur lit les titres propres à chaque page et marque une page comme test de connexion quand un titre nomme une grandeur qui existe sur le fil : une poignée de main, une liste de chiffrements, un client hello chiffré, une trame HTTP/2 ou HTTP/3, un paquet QUIC, un en-tête IPv4 ou TCP, une taille de segment, un échange DNS ou une adresse de proxy.
wire:BrowserLeaks/tls -> sections=5 TLS Fingerprint | TLS Handshake | Encrypted Client Hello | Supported Cipher Suites (in order as received)
wire:BrowserLeaks/http2 -> sections=2 HTTP/2 Fingerprint | HTTP/2 Frames
wire:BrowserLeaks/tcp -> sections=5 TCP/IP Fingerprint | IPv4 Header | TCP Header | Maximum Segment Size
wire:BrowserLeaks/quic -> sections=8 QUIC Fingerprint | QUIC Connection | QUIC Initial Packets | TLS Handshake
wire:BrowserScan/tls -> sections=7 HTTP/2 Fingerprint | TLS Fingerprint | TLS handshake | TLS protocol
split:BrowserLeaks -> wire=7 page=17 unreadable=1 total=25
split:BrowserScan -> wire=4 page=18 unreadable=2 total=24
Sept et quatre. Sur 49 entrées publiées, 11 nomment une grandeur de la connexion dans leurs propres sections. Le reste décrit des choses qu’un script lit : le rendu canvas, les métriques de police, l’adaptateur WebGPU, le fuseau horaire, l’agent utilisateur, l’état des permissions.
Ce rapport est la partie utile de la mesure, et il est plus petit que ne le suggèrent les catalogues. Une suite qui publie 25 routes invite à lire qu’elle vérifie 25 choses d’un navigateur. Ce qu’elle fait en réalité, c’est vérifier 17 choses qu’une page rapporte, 7 choses qu’une connexion rapporte et 1 chose pour laquelle elle ne rend pas de sections. Les trois groupes répondent à des questions différentes, et un seul badge réussi ou échoué sur eux cache quel groupe a produit le résultat.
Pourquoi un nom peut désigner deux tests
Le recouvrement entre catalogues porte sur cinq noms :
overlap -> shared=5 webrtc canvas tls webgpu client-hints
overlap -> BrowserLeaks_only=20 BrowserScan_only=19
Cinq noms partagés sur 49 entrées est le premier constat : les deux suites sont surtout des produits différents avec un petit noyau commun. Le second constat est ce qui se passe dans ce noyau.
Les cinq qui se recouvrent sont ceux qu’un navigateur peut traiter à bas coût depuis une page : ce qu’il rend sur un canvas, ce qu’il rapporte de son adaptateur graphique, ce qu’il dit dans ses client hints, ce que produit une passe de collecte ICE et à quoi ressemble sa poignée de main. Les 39 routes que seule une suite publie sont celles qui demandent une décision sur ce qu’il faut mesurer. Une suite publie des pages pour les objets JavaScript, les polices, la géolocalisation, les requêtes média, les rectangles d’éléments, Do Not Track et les temps de ressources. L’autre publie des pages pour le balayage de ports, la vulnérabilité de version du navigateur, les lectures de gyroscope, le fuseau horaire face à la localisation IP et les permissions de périphériques média. Aucune liste n’est un sur-ensemble, donc choisir une suite revient à choisir quelles questions poser, pas quel site est plus complet.
wire:BrowserScan/tls -> sections=7 HTTP/2 Fingerprint | TLS Fingerprint | TLS handshake | TLS protocol
page:BrowserLeaks/canvas -> sections=11 Canvas Support Detection | Canvas Fingerprint | Image File Details
page:BrowserScan/canvas -> sections=5 Canvas Function Detection | Image Details | The reason for the generation of Canvas fingerprints.
page:BrowserLeaks/webrtc -> sections=8 Your Remote IP | WebRTC Support Detection | Your WebRTC IP
page:BrowserScan/webrtc -> sections=24 After authorizing media device permissions, WebRTC will leak local IP | Media Devices API Support | Audio Permissions
TLS est le seul nom partagé que les deux suites placent sur la connexion, et les deux nomment une poignée de main et une empreinte dans leurs sections. Canvas est un test de page dans les deux, et les deux parlent de l’image rendue et de ses détails. Ces deux-là sont cohérents.
WebRTC est là où la classification diverge. BrowserLeaks titre ses sections avec Your Remote IP et Your WebRTC IP, qui sont des valeurs que la page collecte. BrowserScan titre avec des permissions de périphériques média et l’affirmation que WebRTC divulguera une adresse locale après autorisation. Le même nom de route décrit une adresse collectée par la page sur un site et un chemin média conditionné par une permission sur l’autre.
WebGPU et client hints divergent de la même façon. La page WebGPU de BrowserScan nomme un rapport d’adaptateur et un résumé du rapport ; celle de BrowserLeaks nomme la détection de prise en charge et une empreinte, qui sont des lectures côté page. Pour client hints, BrowserLeaks sépare l’API JavaScript des en-têtes HTTP, et BrowserScan liste l’agent utilisateur et la prise en charge d’API. Comparer les deux sites par nom de route revient à comparer des mesures différentes.
C’est la conséquence pratique d’un vocabulaire partagé sans définition partagée. Un test nommé canvas sur un site et canvas sur un autre n’établit pas la même chose, et un rapport qui cite « le test canvas » sans dire quelle suite l’a produit laisse le lecteur incapable de savoir laquelle des deux mesures a été faite.
Le même problème apparaît à l’intérieur d’une seule suite, et c’est pourquoi les titres de section comptent plus que les noms de route. Une page canvas qui rapporte l’image rendue et les détails du fichier mesure une sortie de rendu. Une page canvas qui rapporte la détection de fonctions et la raison pour laquelle une empreinte est générée décrit une capacité et son mécanisme. Les deux sont utiles, et un résultat de l’une ne répond pas à la question de l’autre. Lire les titres est ce qui les sépare, et c’est pourquoi la sonde conserve la liste des titres à côté de la classification et pas seulement le compte.
Ce qu’un rapport propre de suite peut soutenir
La sonde rapporte wire=7 pour un catalogue et wire=4 pour l’autre, donc 11 des 49 entrées publiées atteignent la connexion à cette date. Les pages à une seule section, comme Proxy Detection, et les pages à explication, comme la page de fuite DNS avec ses quatre sections, comptent toutes deux pour une route.
wire:BrowserLeaks/ip -> sections=5 IPv6 Leak Test | DNS Leak Test | TCP/IP Fingerprint | TLS Fingerprint
wire:BrowserLeaks/proxy -> sections=1 Proxy Detection
wire:BrowserLeaks/dns -> sections=1 DNS Leak Test
wire:BrowserScan/dns-leak -> sections=4 Introduction to DNS Leak Test | How DNS leaks happen | How to perform a DNS leak test | How to Fix a DNS Leak
Les tests de connexion n’ont pas non plus tous la même forme. Certains sont des pages à une seule section qui rapportent une valeur, comme la détection de proxy, et d’autres portent une explication à côté de la mesure, comme la page de fuite DNS avec son introduction, son mécanisme et ses étapes de remédiation. Une page avec une longue explication et une page avec un seul champ mesuré comptent toutes deux pour une route dans le catalogue, donc compte de routes et couverture ne sont pas le même nombre.
Cette différence décide de ce que vaut une page de résultats. Une page à une seule section qui rapporte une valeur est une mesure sans contexte : le lecteur reçoit un nombre et doit savoir ce qu’il aurait dû être. Une page avec introduction, mécanisme et remédiation est une mesure plus un argument sur ce que le nombre signifie. Pour une équipe qui valide un profil déclaré, le premier type est un fait à comparer et le second une affirmation à vérifier, et un rapport qui traite les deux comme un seul badge perd la distinction.
Il existe une troisième forme à nommer, parce que c’est celle qui trompe le plus facilement. Une page peut rendre des sections qui décrivent un test sans que la page l’exécute, et la classification suit les sections. La page de version du navigateur en est le cas le plus clair : ses titres décrivent une déclaration de vulnérabilité et un agent utilisateur, qui sont des faits lisibles par la page, et la mesure qu’elle soutient porte sur l’alignement de version et non sur le contenu du document. Voir un avertissement de version et le traiter comme un signal d’automatisation revient à lire un fait de page comme un verdict.
Il y a une limite à énoncer. La sonde lit ce que chaque page publie comme ses sections, c’est-à-dire la description par la suite de ce qu’elle mesure. Elle n’exécute pas les scripts des suites, donc une page dont les sections restent dans le document peut encore lire un en-tête dans un code que ses sections ne mentionnent pas. La classification décrit ce que la suite dit tester, ce qui est ce dont un lecteur se sert pour choisir une suite, et elle ne remplace pas la lecture d’un résultat précis contre un profil précis.
La même limite s’applique dans l’autre sens. Une page dont les sections nomment une poignée de main n’est pas pour autant un audit complet de la connexion, car les sections sont une liste de ce que la page affiche, pas de tous les champs qu’elle inspecte. Ce que la séparation établit, c’est la taille de l’écart entre les deux groupes : 11 routes nomment la connexion et 35 restent dans le document, et ces deux groupes ne se lisent pas comme une seule note.
Deux des routes qui ne rendent rien illustrent la limite par un autre côté. Une page de réglages et un index d’outils renvoient 200 avec des dizaines de kilo-octets de balisage et aucun titre de section, et une page de commentaires fait de même. Aucune des trois n’est un test, et aucune n’est une mesure, donc l’exécution les signale comme illisibles au lieu de les ranger dans un groupe. Ce choix garde le dénominateur honnête : les compter comme tests de page gonflerait le total côté page, et les compter comme tests de connexion gonflerait le côté qui porte les affirmations les plus lourdes.
Comment les trois groupes échouent différemment
Les trois groupes ont des modes d’échec différents, et savoir de quel groupe vient un résultat dit au lecteur comment interpréter un changement. Les comptes wire et page bougent indépendamment, donc un relevé qui déplace un groupe ne dit rien de l’autre.
Un test de page change quand le document change. Un rendu canvas différent, une liste de polices différente, un fuseau horaire différent ou un état de permission différent apparaissent comme une valeur de page différente, et la même valeur sur deux exécutions signifie que le document était le même dans les deux. Cela rend les tests de page bons pour détecter une dérive dans un environnement et faibles pour comparer des environnements, car deux machines qui concordent sur chaque test de page peuvent encore différer dans la façon dont elles ont atteint le site.
Un test de connexion change quand la connexion change. Un ordre de chiffrements différent, une liste de protocoles différente, un ensemble d’en-têtes différent ou une adresse de sortie différente apparaissent sur le fil, et le document peut être identique sur deux exécutions qui diffèrent sur tout cela. Cela rend les tests de connexion bons pour comparer des environnements et faibles pour détecter une dérive dans un seul, car une connexion stable ne cache rien du document et une connexion changée ne dit pas quelle surface de page a bougé.
Une page sans sections n’est pas une mesure. C’est une page, et l’exécution le signale ainsi. La ranger dans l’un ou l’autre groupe revient à choisir une réponse que la page n’a pas donnée.
C’est toute la raison de mesurer la séparation avant d’exécuter une suite et non après. Une équipe qui prévoit de valider un profil déclaré avec une suite publique peut regarder le catalogue d’abord et voir que l’essentiel de ce que la suite rapporte décrira le document. C’est une vérification utile, et ce n’est pas la vérification que l’équipe voulait faire. L’écart entre les deux est le nombre que rapporte la sonde, et il vaut 11 sur 49 à cette date.
Enregistrer une lecture de suite
Une lecture de suite soutient une affirmation étroite : ce catalogue, lu à cette date, se répartit ainsi. Quatre champs la gardent vérifiable :
- L’empreinte de la page d’accueil, car une suite qui ajoute ou retire une route change chaque compte de cette page sans aucun changement de navigateur.
- Le bloc de titres partagés, car un modèle qui répète son menu en titres gonfle chaque compte par page jusqu’à ce qu’on le retire.
- La règle de classification, car la frontière entre test de page et test de connexion est une décision, et une autre règle produit une autre séparation.
- Les routes qui ne rendent aucune section, car une page qui ne dit rien en titres n’est pas la même chose qu’une page qui ne teste rien.
Sources publiques
- BrowserLeaks
- BrowserLeaks TLS client test
- BrowserLeaks HTTP/2 fingerprinting
- BrowserScan
- BrowserScan HTTP2, SSL and TLS fingerprint
- BotBrowser : référence de cohérence d’automatisation
Conclusion pratique
Séparez dans le rapport ce qui a été mesuré dans le document de ce qui a été mesuré sur la connexion avant de traiter un résultat propre comme large. Les catalogues ici publient 49 entrées, et 11 d’entre elles nomment une grandeur de la connexion dans leurs propres sections, donc une suite qui paraît complète sur sa page d’accueil lit surtout ce qu’une page rapporte. Quand deux suites partagent un nom de route, traitez le nom comme une étiquette et non comme une définition, car quatre des cinq noms partagés ici décrivent des mesures différentes sur les deux sites. Pour ce qu’une seule bibliothèque fait des signaux qu’elle recueille avant tout verdict, lisez les groupes de signaux de CreepJS et leur combinaison ; pour les règles qu’une page ne peut pas évaluer du tout, lisez les règles de couche réseau qu’une page ne peut pas évaluer.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
Règles de couche réseau qu’une page ne peut pas évaluer
EmpreinteBotD : quels détecteurs s’exécutent vraiment
EmpreinteLes groupes de signaux de CreepJS et leur combinaison
EmpreintePourquoi un seul signal bizarre ne condamne pas
Empreinteperformance.now : résolution et fingerprinting
EmpreinteDétection du mode sans tête dans CreepJS : trois verdicts
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.