Intl.Collator : l’ordre de locale face aux unités de code
Une sonde sur listes fixes : en quoi une comparaison de locale diffère d’un tri par unités de code, comment les options changent le résultat et ce que rapporte resolvedOptions.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
BotBrowser prend en charge la relecture d’un fixture autorisé du même origine sous un profil déclaré et conserve un relevé borné de ce qu’une page a trié et dans quelle locale, mais il ne peut pas changer les données de collation qu’un environnement embarque, ne peut pas faire tomber deux locales d’accord sur un même ordre, et ne peut pas reconstituer après coup la collation qu’une comparaison a utilisée. Cette revue exécute une sonde sur dix listes fixes et consigne en quoi une comparaison de locale diffère d’un simple tri par unités de code, comment numeric, sensitivity, caseFirst et ignorePunctuation changent chacun le résultat, ce que resolvedOptions() rapporte réellement, vers quoi retombe une locale non prise en charge, et pourquoi passer le collateur plutôt que sa fonction compare lève une erreur.
Résumé
- Un tri par unités de code place
Áppleen dernier, alors qu’un tri de locale le place en troisième, donc les deux ordres divergent sur les cinq mêmes mots. - La locale change l’ordre de la même paire : le suédois compare
äaprèsz, l’allemand et l’anglais le comparent avant, donc la sonde imprimepair-sv -> z,äetpair-de -> ä,z. numeric: trueordonneitem2avantitem10, alors que le comportement par défaut les traite comme du texte et placeitem10avantitem2.sensitivitydécide quelles différences comptent :basetraitea,Aetácomme égaux,accentsépare la forme accentuée, etcasesépare la majuscule.ignorePunctuation: truefait comparerabeta-bcomme égaux, alors que le comportement par défaut les compare comme distincts.caseFirstne se manifeste qu’une fois la casse prise en compte, et il inverseAaBbenaAbB.resolvedOptions()rapporte la collation que l’environnement a accordée, y compris une collation nommée dans l’étiquette de locale, et une locale non prise en charge retombe suren-USplutôt que de lever une erreur.Array.prototype.sort(collator)lève uneTypeError; seulsort(collator.compare)fonctionne.
Sommaire
- Ce qu’un collateur compare et qu’un tri par unités de code ignore
- Comment
numericetsensitivitychangent le résultat - Où la casse, la ponctuation, l’équivalence et la casse liée à la locale entrent dans l’ordre
- Où l’équivalence canonique et la casse liée à la locale surprennent un tri
- Ce que
resolvedOptionsrapporte et vers quoi il retombe - Pourquoi on ne peut pas passer le collateur directement à
sort - Consigner une lecture de collation
Ce qu’un collateur compare et qu’un tri par unités de code ignore
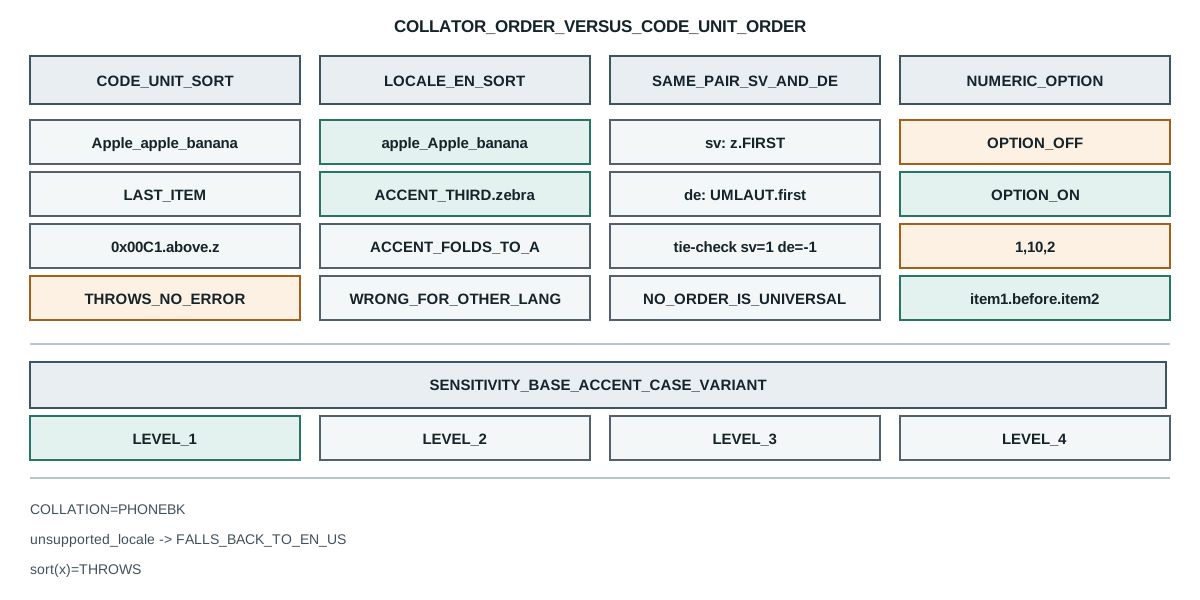
Un Array.prototype.sort() par défaut compare des unités de code UTF-16. Un collateur compare le texte comme une langue l’ordonne : les accents se replient sur leur lettre de base, la casse est une différence secondaire, et chaque locale décide où se place une lettre. La sonde trie les cinq mêmes mots des deux façons :
node=v26.9.0
icu=78.3 unicode=17.0
code-unit -> Apple,apple,banana,zebra,Ápple
locale-en -> apple,Apple,Ápple,banana,zebra
pair-sv -> z,ä
pair-de -> ä,z
pair-en -> ä,z
numeric-off -> item1,item10,item2
numeric-on -> item1,item2,item10
sensitivity-base -> a-vs-A=0 a-vs-á=0 a-vs-b=-1
sensitivity-accent -> a-vs-A=0 a-vs-á=-1 a-vs-b=-1
sensitivity-case -> a-vs-A=-1 a-vs-á=0 a-vs-b=-1
sensitivity-variant -> a-vs-A=-1 a-vs-á=-1 a-vs-b=-1
punct-kept -> 1
punct-ignored -> 0
caseFirst-upper -> AaBb
caseFirst-lower -> aAbB
caseFirst-upper-base -> Aa vs aA
resolved -> locale=de-u-co-phonebk numeric=true sensitivity=accent collation=phonebk
fallback-locale -> en-US
passthrough -> sort(collator)=TypeError sort(collator.compare)=ab
tie-check -> sv(ä vs z)=1 de(ä vs z)=-1
La différence avec un tri simple est celle que Tri de tableau et comparateurs trace pour le comparateur lui-même. Les deux premières lignes sont tout le propos en miniature. Ápple a une unité de code supérieure à z, donc le tri par unités de code le pousse à la fin ; une langue voit Á comme un A accentué, donc le tri de locale le place avec les autres mots en a. Aucun des deux ordres n’est faux, et une page qui compare une liste entre deux environnements sans nommer le second a consigné un résultat qui dépend du tri employé.
La deuxième paire est le cas plus difficile. ä n’est pas seulement un a accentué en suédois ; c’est une lettre à part entière, et il trie après z. L’allemand le garde près de a. La sonde imprime les deux ordres côte à côte, et une page qui code en dur l’un ou l’autre comme l’ordre unique casse sur l’autre langue. La ligne tie-check montre la même chose comme résultat de comparaison plutôt que comme liste triée : la même paire renvoie 1 en suédois et -1 en allemand.
Comment numeric et sensitivity changent le résultat
numeric: true fait passer une suite de chiffres d’une comparaison textuelle à une comparaison numérique, et la sonde montre la différence sur trois entrées de liste :
numeric-off -> item1,item10,item2
numeric-on -> item1,item2,item10
Le comportement par défaut lit item10 comme les caractères « 1 », « 0 », donc il vient avant item2 comme « 2 ». Avec numeric, l’environnement lit la suite de chiffres comme le nombre dix, donc item2 vient en premier. Une page qui trie des noms de fichiers ou des lignes de tableau avec un collateur par défaut et attend l’ordre naturel obtient la première ligne, pas la seconde.
sensitivity décide quelles différences la comparaison rapporte du tout, et la sonde compare trois paires sous chacun des quatre niveaux :
sensitivity-base -> a-vs-A=0 a-vs-á=0 a-vs-b=-1
sensitivity-accent -> a-vs-A=0 a-vs-á=-1 a-vs-b=-1
sensitivity-case -> a-vs-A=-1 a-vs-á=0 a-vs-b=-1
sensitivity-variant -> a-vs-A=-1 a-vs-á=-1 a-vs-b=-1
base rapporte 0 pour la paire de casse et pour la paire d’accent, donc a, A et á sont tous égaux et seul b trie à part. accent commence à séparer la forme accentuée mais traite encore a et A comme égaux. case fait l’inverse : il sépare la majuscule et replie à nouveau l’accent. variant sépare tout. Une table de correspondance indexée par une chaîne passée en minuscules et privée de ses accents fait à la main ce que sensitivity: 'base' fait en une option, et une table qui veut que A et a se confondent mais que á trie séparément veut accent.
La distinction compte pour une question d’empreinte autant que pour un tri. Une page qui regroupe des chaînes par sensitivity: 'base' et une page qui regroupe par variant produisent des nombres de groupes différents à partir de la même entrée, donc une lecture « nombre de valeurs distinctes » doit nommer la sensitivity, sinon elle n’est pas comparable entre deux pages.
Il y a un piège de second ordre dans la même table. sensitivity: 'base' rapporte 0 pour a contre á, et une page qui traite ce 0 comme « ces chaînes sont la même valeur » fusionnera deux entrées qu’un utilisateur juge distinctes. Les comparaisons rapportent un ordre, pas une égalité : 0 signifie que le collateur n’a pas d’avis sur laquelle vient en premier, et un Map indexé par les chaînes d’origine contient toujours les deux. Un dédoublonnage doit décider séparément si un ex æquo signifie « garder le premier », « garder les deux » ou « fusionner », et le collateur ne répond pas à cette question.
Les quatre niveaux s’emboîtent aussi dans un ordre fixe, et connaître cet ordre prédit chaque ligne. base ignore les accents et la casse ; accent ajoute la distinction d’accent ; case ajoute plutôt la distinction de casse et garde l’accent replié ; variant ajoute les deux. C’est pourquoi accent et case divergent sur des paires différentes au lieu que l’un soit une version plus stricte de l’autre, et pourquoi une page qui veut « même mot, n’importe quelle casse, n’importe quel accent » veut base plutôt qu’une chaîne de normalisations manuelles.
Où la casse, la ponctuation, l’équivalence et la casse liée à la locale entrent dans l’ordre
ignorePunctuation fait ignorer la ponctuation au collateur quand il compare, et la sonde montre l’effet sur une paire :
punct-kept -> 1
punct-ignored -> 0
ab et a-b diffèrent quand la ponctuation compte, et sont égaux quand elle ne compte pas. Une page qui trie une liste de noms avec traits d’union et attend que ab et a-b restent distincts s’appuie sur le comportement par défaut, et une page qui dédoublonne avec un collateur dont la ponctuation est ignorée les fusionnera. L’option est un choix de politique, pas un détail.
La même option change ce qu’une zone de recherche considère comme une correspondance. Un filtre qui passe la requête en minuscules et compare avec un collateur par défaut garde a-b et ab distincts, donc taper ab ne trouve rien dans une liste qui ne contient que a-b. Désactiver la ponctuation fait correspondre la requête, et la désactiver fait aussi correspondre a.b et a-b l’un à l’autre, ce qui est généralement ce qu’un lecteur attend d’un champ de recherche et rarement ce qu’un filtre d’exactitude veut. Une option, deux produits, des comportements par défaut opposés.
caseFirst fixe quelle casse vient en premier une fois que la casse est une différence, et la sonde montre à la fois l’effet et sa limite :
caseFirst-upper -> AaBb
caseFirst-lower -> aAbB
caseFirst-upper-base -> Aa vs aA
Avec la sensitivity par défaut, upper place la majuscule avant la minuscule dans chaque paire et lower l’inverse. La troisième ligne est la limite : sous sensitivity: 'base' les deux casses sont égales, donc caseFirst n’a rien à ordonner, et le résultat imprimé est simplement l’ordre d’entrée dans chaque cas. Une option sans effet tant qu’une autre option n’est pas réglée est facile à lire à tort comme cassée, et la sonde est le moyen le moins coûteux de voir qu’elle ne l’est pas.
Cette dépendance mérite d’être posée comme une règle : caseFirst est un départage à l’intérieur d’une comparaison qui distingue déjà la casse, et il ne fait rien au-dessus de ce niveau. Une page qui règle caseFirst: 'upper' et sensitivity: 'base' et attend les majuscules en premier a réglé deux options qui s’annulent, et le correctif est de retirer la dérogation de sensitivity plutôt que d’ajouter une comparaison manuelle. La dernière ligne de la sonde montre les deux ordres d’entrée survivre intacts, ce qui est la forme visible de l’annulation.
Où l’équivalence canonique et la casse liée à la locale surprennent un tri
Deux des comportements les plus déroutants ne portent pas du tout sur les options ; ils viennent de la façon dont le collateur traite un texte qui se ressemble et un texte dont la casse dépend d’une langue. Une seconde sonde consigne les deux.
Le premier est l’équivalence canonique. La lettre é peut être stockée comme un seul point de code ou comme e suivi d’un accent combinant, et les deux chaînes ne sont pas égales :
normalization-text -> nfc.length=1 nfd.length=2 equal=false
normalization-collate -> base=0 variant=0
Les longueurs diffèrent et une comparaison de chaînes dit qu’elles sont différentes, pourtant le collateur rapporte 0 à la fois en base et même en sensitivity variant, parce que les deux graphies sont canoniquement équivalentes et que les données de collation les replient ensemble. Une page qui compare avec un collateur traite donc deux chaînes différentes en octets comme le même mot, tandis qu’une page qui compare avec === ou un Map ne le fait pas. Cette scission est la source la plus courante de « ça trie bien mais la recherche rate » : le tri a utilisé le collateur, la recherche a utilisé la chaîne brute.
Le premier explique aussi pourquoi une comparaison par collation et une comparaison de texte divergent, ce que Normalisation Unicode traite du côté de la chaîne. Le second est la casse liée à la locale. En turc, I passe en minuscule en ı sans point, et i passe en majuscule en İ pointu, qui est une lettre différente du I anglais :
dotted-i-tr -> i-vs-I=1 i-vs-İ=-1
dotted-i-en -> i-vs-I=-1 i-vs-İ=-1
turkish-lower -> tr=ı en=i
Sous le turc, le collateur place i après I et avant İ, donc i et I ne sont plus la même lettre ni en casse ni en ordre ; sous l’anglais, il place i avant les deux. La dernière ligne montre la même scission au niveau des chaînes : 'I'.toLocaleLowerCase('tr') vaut ı alors que l’appel anglais renvoie i. Une page qui passe en minuscules sans locale puis compare obtient l’ordre anglais dans les deux locales, c’est pourquoi une comparaison sensible à la locale et un repli de casse sensible à la locale doivent être choisis ensemble plutôt qu’un à la fois.
Il y a une troisième forme à consigner parce qu’elle brise l’hypothèse qu’un tri par unités de code est « assez proche ». Les caractères astraux, qui occupent deux unités de code, trient selon leur première unité de code sous un tri simple et selon leur poids de collation sous un collateur :
astral-codeunit -> 61,7a,1f600
astral-collator -> 1f600,61,7a
Le tri simple met l’emoji en dernier parce que son unité de tête est au-dessus de z ; le collateur le met en premier parce que son poids de collation précède les lettres. Une page qui mélange des caractères astraux dans une liste de noms et trie par défaut obtient un ordre qu’aucun lecteur n’attend, et le correctif est le collateur, pas un réordonnancement manuel.
Enfin, le préambule de tout cela est que localeCompare et un collateur sont d’accord, ce qui est le moyen le moins coûteux de confirmer une hypothèse avant de construire un collateur :
localeCompare-vs-collator -> ä-z:-1/-1 a-b:-1/-1
hoisted-vs-per-call -> same=true order=Alpha,bravo,charlie,delta
La première ligne montre 'ä'.localeCompare('z', 'de') et un collateur allemand renvoyant le même -1, donc une sonde peut commencer par la ligne unique et n’atteindre un collateur que lorsqu’elle a besoin d’options. La seconde ligne montre un collateur hissé et un collateur construit par comparaison produisant le même ordre, ce qui confirme l’affirmation antérieure que hisser change le coût plutôt que le résultat.
Ce que resolvedOptions rapporte et vers quoi il retombe
resolvedOptions() renvoie ce que l’environnement a réellement accordé, une fois l’étiquette de locale et les options toutes deux appliquées :
resolved -> locale=de-u-co-phonebk numeric=true sensitivity=accent collation=phonebk
Le collateur a été demandé pour de-u-co-phonebk avec deux options, et la locale résolue garde l’extension -u-co-phonebk et rapporte collation=phonebk séparément. Cette séparation compte parce qu’une page peut lire l’un ou l’autre champ et obtenir une chaîne différente, et qu’un relevé qui ne stocke que locale et abandonne collation a perdu la partie qui a décidé de l’ordre. La collation d’annuaire ordonne ä avec ae en allemand, ce qui est encore un troisième ordre, différent à la fois de l’allemand simple et du suédois que la section précédente a imprimés.
Une locale non prise en charge ne lève pas d’erreur. La sonde demande zz-ZZ :
fallback-locale -> en-US
L’environnement est retombé sur en-US et l’a dit. Une page qui lit la locale depuis un en-tête ou un paramètre de requête et la passe telle quelle dans un collateur obtient donc toujours un collateur, et seul resolvedOptions().locale révèle que la demande n’a pas été honorée. Un relevé qui stocke la locale demandée au lieu de la locale résolue a consigné une intention, pas une mesure.
Pourquoi on ne peut pas passer le collateur directement à sort
Un collateur est un objet doté d’une méthode compare, et Array.prototype.sort() accepte une fonction, pas un objet avec une méthode compatible. La sonde passe le collateur lui-même :
passthrough -> sort(collator)=TypeError sort(collator.compare)=ab
La première moitié lève une TypeError parce que l’argument n’est pas appelable ; la seconde trie correctement parce que collator.compare est une fonction liée. C’est un bogue d’un mot en revue de code et une exception d’exécution en production, et il vaut la peine de le nommer parce que le message de sort ne mentionne pas du tout les collateurs.
La même forme explique une erreur plus subtile. Un collateur créé une fois et réutilisé est plus qu’une fabrique de compare ; il détient la locale et les options, et son compare leur est lié. Une page qui crée un nouveau collateur par comparaison à l’intérieur d’un rappel de tri reconstruit l’état ICU des milliers de fois, ce qui est correct et lent, et une page qui hisse un collateur hors de la boucle obtient le même ordre plus vite. La sonde ne peut pas montrer la différence de chronométrage sur une liste de cinq éléments, et l’ordre est identique dans les deux cas, donc le choix porte uniquement sur le coût.
Consigner une lecture de collation
Une lecture de collation étaye une affirmation étroite : cet environnement, cette version d’ICU, cette locale et ces options, ont produit ces ordres. Cinq champs la gardent vérifiable :
- L’environnement et sa version d’ICU, parce que la sonde imprime
icu=78.3 unicode=17.0et qu’un autre ICU embarque d’autres données de collation. - La locale demandée et la locale résolue, parce qu’une étiquette non prise en charge retombe en silence.
- La collation résolue, parce qu’une extension
-u-co-change l’ordre et est rapportée séparément de la locale. - Les quatre options qui changent le résultat,
numeric,sensitivity,caseFirstetignorePunctuation, parce que deux collateurs avec la même locale et des options différentes divergent. - La comparaison employée,
sort()oucollator.compare, parce que passer l’objet lève une erreur.
Sources publiques
- MDN: Intl.Collator
- MDN: Intl.Collator.prototype.compare
- MDN: Intl.Collator.prototype.resolvedOptions
- ECMA-402: Collator Objects
- Unicode TR35: Collation
- BotBrowser: référence de cohérence de l’automatisation
Conclusion pratique
Nommez le collateur chaque fois qu’un ordre quitte une page : la locale, la collation résolue et les quatre options, parce que chacune d’elles change le résultat sur la même entrée. Préférez sensitivity à un repli de casse et d’accent bricolé à la main, et traitez ignorePunctuation comme une décision de politique plutôt qu’un détail. Passez collator.compare à sort, jamais le collateur, et hissez un collateur hors de la boucle. Pour la comparaison numérique qu’un tri par défaut rate, lisez Tri de tableau et comparateurs ; pour les données de locale derrière l’ordre, lisez Données de locale de l’API Intl.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
Unicode : quatre identités de texte lues par une page
EmpreinteTri de tableau et comparateurs : un piège subtil
EmpreinteICU : alias de fuseau et la TZ que vous rapportez
EmpreinteOrdre des clés : les entiers trient, les chaînes restent
EmpreintePromise : ce qui échoue d’abord
EmpreinteAnalyse d’URL et des search params
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.