Analyse d’URL et des search params
Analysez des URL et requêtes délicates : où new URL lève, ce que la normalisation réécrit, les clés dupliquées et l’ordre, et pourquoi set n’est pas une affectation.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
BotBrowser prend en charge le rejeu d’un fixture autorisé de même origine sous un profil déclaré et la conservation d’observations bornées sur l’URL qu’une page a analysée et sur ce que l’analyseur a réécrit, mais il ne change pas la façon dont un environnement implémente l’algorithme URL du WHATWG, ne peut pas résoudre une chaîne relative sans base, et ne transforme pas une URL normalisée en signal d’identité. Cette revue analyse un ensemble d’URL et de chaînes de requête délicates, puis consigne exactement où new URL lève, quels caractères la normalisation réécrit, comment survivent les clés dupliquées et les signes plus, et pourquoi définir un paramètre de recherche diffère d’une affectation d’une chaîne de recherche brute.
Résumé
new URLavec une chaîne relative et sans base lèveTypeError. La même chaîne se résout contre une base, et les espaces du chemin deviennent%20.- Analyser, c’est normaliser, pas identité :
HTTPS://Example.TEST:443/a/../b/./cdevienthttps://example.test/b/c, en retirant le port par défaut et en résolvant les segments point. URLSearchParamsconserve les clés dupliquées, traite+comme un espace, et encode&et=dans une valeur lors de la sérialisation.sort()réordonne par clé ; l’ordre d’insertion est conservé jusqu’à l’appel, donc un aller-retour peut changer la chaîne sans changer les données.searchParams.setencode une valeur différemment d’une affectation brute deurl.search: le premier encode les espaces en pourcent, le second les laisse à l’analyseur.
Sommaire
- Où new URL lève et où une base le sauve
- Ce que la normalisation réécrit
- Clés dupliquées, signes plus et encodage des valeurs
- Ordre et coût d’un aller-retour
- Définir un paramètre face à affecter search
- Consigner une lecture d’URL
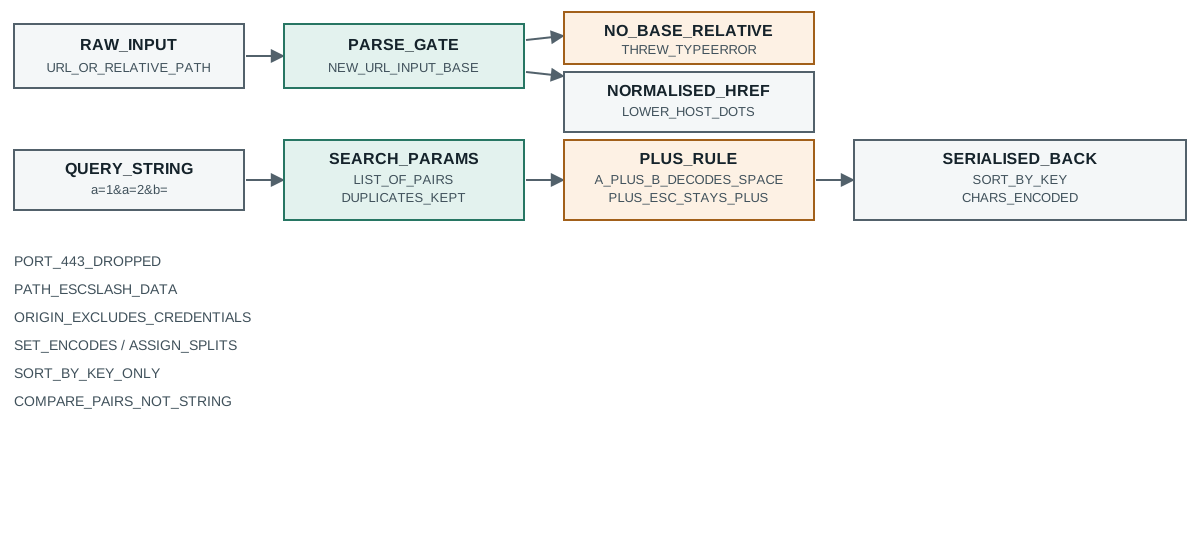
Où new URL lève et où une base le sauve
Le constructeur a deux formes, et une seule peut résoudre une référence relative. Sans base, l’entrée doit déjà être une URL absolue ; une chaîne de chemin seul n’a rien à quoi se rattacher et l’analyseur lève : Une URL analysée est aussi une valeur qu’il faut copier avant de la stocker, et structuredClone face à JSON montre quels types et références une copie profonde garde et lesquels un aller-retour JSON perd en silence.
new URL("/a/b?x=1", undefined) -> "THREW TypeError"
new URL("/a/b?x=1", "https://example.test") -> "https://example.test/a/b?x=1"
new URL("a b", "https://example.test/dir/") -> "https://example.test/dir/a%20b"
new URL("../../x", "https://example.test/a/b/c") -> "https://example.test/x"
La première ligne est le défaut courant : un code qui reçoit une valeur de configuration, d’un champ de formulaire ou d’un lien et appelle new URL(valeur) sans base lèvera pour tout chemin relatif, et un bloc try qui avale l’erreur transforme une URL erronée en undefined silencieux. La deuxième ligne montre le correctif, en résolvant la même chaîne contre une base.
Les troisième et quatrième lignes montrent que la résolution n’est pas une concaténation. Un espace dans un chemin relatif est encodé en pourcent en %20, et ../../x remonte de trois niveaux depuis /a/b/c pour produire /x, pas un ajout littéral. Un appelant qui attend de l’entrée brute qu’elle survive à un aller-retour par le constructeur est surpris dans les deux cas, car la sortie est une URL normalisée, pas la chaîne passée.
Cette distinction compte pour les comparaisons d’égalité. Deux chaînes qui adressent la même ressource peuvent s’analyser en un même href, et une chaîne peut s’analyser en un href différent après normalisation. Un fixture qui compare la chaîne d’entrée à la chaîne de sortie pour prouver que rien n’a changé échouera sur toute entrée qui a besoin de normalisation, tandis qu’un fixture qui compare deux URL analysées pour prouver leur équivalence peut réussir même quand les entrées semblaient différentes.
Ce que la normalisation réécrit
L’analyseur met en minuscules le schéma et l’hôte, retire un port par défaut, résout les segments point et encode en pourcent les caractères non autorisés dans chaque composant. Quatre entrées montrent les réécritures côte à côte :
raw="HTTPS://Example.TEST:443/a/../b/./c"
  href="https://example.test/b/c"
  origin="https://example.test" protocol="https:" port=""
raw="https://example.test/a%2Fb?q=a b#frag ment"
  href="https://example.test/a%2Fb?q=a%20b#frag%20ment"
  pathname="/a%2Fb" search="?q=a%20b" fragment="#frag%20ment"
raw="https://user:[email protected]/x"
  username="user" password="pass"
La première entrée perd trois choses d’un coup : le schéma et l’hôte en majuscules passent en minuscules, le :443 explicite disparaît car c’est le port par défaut de https, et /a/../b/./c se replie en /b/c. Un appelant qui a stocké la chaîne d’origine et la compare à href verra un écart qui est entièrement de la normalisation.
La deuxième entrée montre un point plus subtil. La barre encodée %2F dans le chemin survit inchangée, car c’est un échappement délibéré d’un caractère qui changerait sinon la structure du chemin ; l’espace brut dans la requête et le fragment devient %20 ; et l’espace dans le fragment est encodé aussi. Donc le chemin conserve une barre encodée tandis que la requête et le fragment encodent un espace littéral. Une passe naïve « tout encoder » ou « tout décoder » sur l’URL entière corromprait le %2F, ce qui est exactement pourquoi l’analyseur traite chaque composant avec ses propres règles.
La troisième entrée montre que les identifiants sont analysés en username et password puis resérialisés dans le href, tandis que origin les exclut. Cela compte pour la journalisation : origin est sûr à consigner et à comparer, tandis que href peut porter un nom d’utilisateur et un mot de passe qui ne devraient pas être écrits dans un journal ou un fixture. Une lecture qui stocke href pour une URL avec identifiants stocke le secret ; une qui stocke origin et pathname non.
Chaque composant a son propre jeu de règles, et c’est la raison pour laquelle une seule passe d’encodage ou de décodage sur toute l’URL est risquée. Le schéma et l’hôte sont comparés et stockés en minuscules ; le port est retiré quand il égale la valeur par défaut du schéma ; le chemin résout les segments point et conserve une barre encodée comme donnée ; la requête applique la règle du plus vers l’espace et encode les caractères réservés ; et le fragment encode un espace brut mais conserve la structure du fragment. Un appelant qui prend tout le href, y applique decodeURIComponent et repasse le résultat à new URL obtiendra généralement une URL différente, car l’étape de décodage transforme les barres et les esperluettes encodées en caractères que l’analyseur lit ensuite comme structure. L’unité sûre est le composant, pas la chaîne entière.
Ce modèle par composant explique aussi pourquoi deux URL qui semblent différentes peuvent être identiques après analyse. HTTPS://Example.TEST:443/b/c et https://example.test/b/c produisent le même href, car l’analyseur met en minuscules et retire le port par défaut avant tout le reste. Une étape de déduplication qui compare des chaînes brutes les traitera comme distinctes et stockera les deux, tandis qu’une étape qui compare des href analysés les replie. Lequel est correct dépend du but : une clé de cache veut la forme repliée pour que les deux graphies touchent la même entrée, tandis qu’un journal d’audit peut vouloir la forme brute pour préserver l’entrée d’origine. La lecture doit dire quelle forme elle stocke.
Clés dupliquées, signes plus et encodage des valeurs
URLSearchParams est une liste de paires, pas une carte, et plusieurs comportements en découlent. Les clés dupliquées survivent, une valeur vide est présente mais vide, et une valeur qui contient & ou = est encodée en pourcent lors de la sérialisation de la liste :
params.getAll(a) -> ["1","2"]
params.get(b) -> ""
params.get(c) -> "&="
params.toString() -> "a=1&a=2&b=&c=<encoded ampersand><encoded equals>"
getAll renvoie les deux valeurs de a, donc un appelant qui utilise get('a') ne voit que la première et écarte le reste en silence. get('b') renvoie une chaîne vide, différente de null pour une clé absente : un b= seul est présent avec une valeur vide, et un code qui vérifie if (valeur) traite les deux comme faux. Une valeur qui a décodé en &= se resérialise avec son esperluette et son signe égal encodés de nouveau, donc la chaîne brute fait l’aller-retour mais la valeur décodée montre les caractères que l’appelant voulait vraiment.
Le signe plus est l’autre piège. Dans une chaîne de requête, + signifie un espace, donc une valeur qui contient légitimement un signe plus doit être encodée en pourcent en %2B :
searchParams from a+b -> "a b"
Map-like set round trip -> "q=a%2Bb"
La première ligne montre new URLSearchParams('q=a+b').get('q') renvoyant "a b", car l’analyseur a lu le plus comme un espace. La seconde montre que construire la même liste depuis un objet avec la valeur a+b la sérialise en q=a%2Bb, donc le plus est préservé comme donnée. L’asymétrie est le défaut : un appelant qui construit une requête par concaténation écrit q=a+b puis relit a b, tandis qu’un appelant qui passe par URLSearchParams et un objet de valeurs conserve le plus. Les deux chemins divergent sur la même valeur voulue, et un seul fait l’aller-retour.
Trois échappements différents décodent en deux caractères différents, et seule une lecture qui les énumère séparément capte la différence. Un + brut décode en espace, un %20 décode en espace, et un %2B décode en plus. Donc q=a+b, q=a%20b et q=a%2Bb sont trois encodages distincts : les deux premiers portent la valeur a b, le troisième porte a+b. Un appelant qui normalise une requête en la décodant et la réencodant avec un encodeur générique replie les deux premiers en une forme et peut perdre ou inventer le plus du troisième, selon l’encodeur. La forme consignée ?a=%2B+%20 du vidage d’analyse est exactement ce triplet dans un paramètre : un signe plus, puis un espace, puis un espace, décodés de %2B, + et %20 respectivement, et un réencodage qui traite les trois comme des données changerait la chaîne bien que la valeur décodée ne change pas.
Les clés dupliquées interagissent avec le même décodage. Une requête a=1&a=2&b= s’analyse en trois paires, deux de clé a et une de clé b et valeur vide, et se resérialise en la chaîne identique a=1&a=2&b=. Cette identité mérite d’être consignée car c’est l’exception et non la règle : cette chaîne est déjà dans la sérialisation canonique, donc une analyse et une resérialisation la laissent inchangée, tandis qu’une chaîne avec un espace brut ou un échappement non canonique changerait. Un fixture qui n’utilise que des entrées déjà canoniques ne verra jamais la normalisation, c’est pourquoi au moins une entrée non canonique appartient à l’ensemble.
Ordre et coût d’un aller-retour
La liste a un ordre d’insertion, et sort() la réordonne par clé. Jusqu’à l’appel de sort(), l’ordre est celui de l’ajout :
insertion order -> "k9=9&k8=8&k7=7&k6=6&k5=5&k4=4&k3=3&k2=2&k1=1&k0=0"
sorted order -> "k0=0&k1=1&k2=2&k3=3&k4=4&k5=5&k6=6&k7=7&k8=8&k9=9"
Dix clés ajoutées en ordre décroissant se sérialisent dans cet ordre, et sort() les transforme en ordre croissant. Les données sont identiques avant et après ; seule la chaîne sérialisée change. C’est le coût d’un aller-retour : si un fixture construit une requête, la sérialise, la réanalyse et compare les chaînes, la comparaison peut échouer sur le seul ordre. Un fixture qui compare l’ensemble des paires, pas la chaîne, est stable.
Il y a une seconde conséquence pour les clés dupliquées. sort() est stable pour les clés qui comparent égal, donc deux entrées de même clé gardent leur ordre d’insertion relatif après tri. Un appelant qui attend que sort() ordonne aussi les valeurs dans une clé dupliquée ne l’obtiendra pas ; les valeurs restent dans l’ordre d’ajout, et seul le regroupement des clés change.
Cette stabilité est vérifiable et mérite d’être dite clairement : après sort(), a=1&a=2 reste a=1&a=2, pas a=2&a=1, car les deux clés comparent égal et le tri est stable. Un appelant qui veut les valeurs ordonnées dans une clé dupliquée doit les trier séparément avant de les ajouter, et un appelant qui suppose que sort() l’a fait publiera une sortie instable qui change entre les exécutions selon l’ordre d’insertion. La règle à consigner : sort() trie par clé seulement, et les clés égales gardent leur ordre d’entrée.
La longueur est une autre raison pour laquelle un aller-retour n’est pas une conversion. Analyser une requête en liste et la resérialiser peut changer la longueur de la chaîne même quand les paires sont identiques, car un %20 devient un + et un espace brut devient %20 selon le chemin pris. Un fixture qui affirme une longueur en octets fixe après un aller-retour réussira sur certaines entrées et échouera sur d’autres pour des raisons sans rapport avec un défaut. Mesurer le nombre de paires et l’ensemble des clés garde l’affirmation stable parmi les choix d’encodage qui sont tous corrects.
Définir un paramètre face à affecter search
Il y a deux façons de changer la requête sur un objet URL, et elles encodent différemment :
set("q","a b+c&d=e") href -> "https://example.test/?q=a+b%2Bc%26d%3De"
search = "?q=a b+c&d=e" href -> "https://example.test/?q=a%20b+c&d=e"
La première ligne passe par searchParams.set, qui encode la valeur avec les règles de la chaîne de requête : l’espace devient +, le plus devient %2B, et & et = deviennent %26 et %3D, donc toute la valeur reste dans un paramètre. La seconde ligne affecte url.search directement avec une chaîne brute, donc l’analyseur voit & et = comme séparateurs : la valeur devient a b (l’espace encodé en %20), et c et d deviennent des paramètres séparés.
Les deux résultats ne sont pas la même URL, et la différence n’est pas cosmétique. set garde la valeur voulue intacte ; l’affectation brute la coupe en trois paramètres car les caractères qui séparent les paramètres sont ceux que l’appelant voulait comme données. Un appelant qui construit une chaîne de recherche à la main et l’affecte doit encoder en pourcent chaque caractère réservé avant l’affectation, tandis qu’un appelant qui utilise set remet la valeur brute et laisse l’API l’encoder.
Il y a aussi une différence d’espacement à noter. set a produit + pour l’espace, tandis que l’affectation brute a produit %20. Les deux décodent en espace, mais les deux sérialisations diffèrent, donc une comparaison octet par octet des deux href échoue même si elles portent le même paramètre logique. C’est une autre raison de comparer les valeurs analysées plutôt que les chaînes sérialisées.
Consigner une lecture d’URL
Une lecture d’URL qui survit à une revue dit ce qu’elle a analysé et ce qui a changé. Six champs couvrent la partie observable, et aucun ne stocke un identifiant :
- La chaîne d’entrée et la base utilisée, ou le fait qu’aucune base n’a été fournie et que l’analyse a levé.
- Les
origin,pathname,searchetfragmentobtenus, consignés séparément plutôt qu’un seulhref, pour que les identifiants et la normalisation soient visibles. - La liste des paires de requête comme entrées
[clé, valeur], duplicats et valeurs vides compris, plutôt qu’une seule chaîne reconstruite. - Si un espace était un
+ou un%20dans la requête sérialisée, car les deux décodent pareil mais sérialisent différemment. - L’ordre des paires et si
sort()a été appelé, puisque l’ordre change la chaîne sans changer les données. - Comment la requête a été modifiée, par
searchParams.setou une affectation brute desearch, car les deux encodent les caractères réservés différemment.
Ce qu’une telle lecture ne peut pas montrer, c’est quoi que ce soit sur la façon dont un serveur ou un proxy interprétera la même URL. Un client analyse d’une façon, un framework serveur peut décoder et réanalyser la requête avec ses propres règles, et une redirection peut réécrire la chaîne en transit. Pour la question plus large de la façon dont l’URL analysée d’une page interagit avec les chaînes qu’elle rapporte, voir détection de protocole URL et vie privée et frontières de btoa et atob, qui couvre la couche d’encodage traversée par les valeurs de requête.
Deux habitudes gardent la lecture honnête dans le temps. D’abord, consignez origin et la liste des paires plutôt qu’un seul href, pour que la normalisation et les identifiants soient visibles au lieu de se fondre dans une chaîne opaque. Ensuite, comparez les paires analysées plutôt que les chaînes sérialisées, pour que l’ordre et le choix de + contre %20 ne transforment pas un aller-retour correct en faux échec.
Sources publiques
- MDN : URL
- MDN : URLSearchParams
- Standard URL du WHATWG
- RFC 3986 : syntaxe d’identifiant de ressource uniforme
- MDN : encodeURIComponent
Conclusion
Fournissez toujours une base quand une URL peut être relative, et attendez-vous à ce que l’analyseur normalise plutôt que conserve la chaîne d’entrée. Traitez URLSearchParams comme une liste de paires, pour que les clés dupliquées et les valeurs vides survivent, et rappelez-vous que + décode en espace. Utilisez searchParams.set pour changer une valeur et laissez-le encoder les caractères réservés, ou encodez vous-même chaque caractère réservé avant d’affecter search. Consignez origin et la liste des paires plutôt qu’un seul href, et comparez les paires analysées plutôt que les chaînes sérialisées.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
btoa et atob : la frontière Latin-1
Empreinteua-parser-js : Client Hints, bots et un plafond de 500
EmpreintestructuredClone face à JSON : copies profondes
EmpreinteUnicode : quatre identités de texte lues par une page
EmpreinteGestion sûre des URL externes pour les profils
Empreintewebgl_debug_renderer_info : ce que votre GPU révèle aux pages
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.