Unicode : quatre identités de texte lues par une page
Exécutez l’ICU de l’hôte sur des chaînes précomposées, décomposées, emoji et hangul pour voir les quatre longueurs lues pour un même texte et pourquoi une clé échoue.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
BotBrowser prend en charge le rejeu d’un fixture autorisé de même origine sous un profil déclaré et la conservation d’observations bornées sur ce que la page rapporte, mais il ne peut pas faire renvoyer à une page une chaîne canonique sur laquelle elle n’a jamais appelé normalize(), changer la version d’Unicode livrée avec un ICU donné, ni faire coïncider un décompte de grappes de graphèmes avec une longueur en unités. Cette revue exécute l’ICU du runtime Node sur un ensemble fixe de chaînes et rapporte quatre nombres différents qu’une page peut lire pour le même texte visible : longueur en unités, décompte de points de code, décompte de grappes de graphèmes et longueur normalisée.
TL;DR
éécrit comme un point de code et commeeplus accent combinant ne sont pas égaux comme chaînes, le sont après NFC, et produisent deux valeurs différentes deString.length.- Un
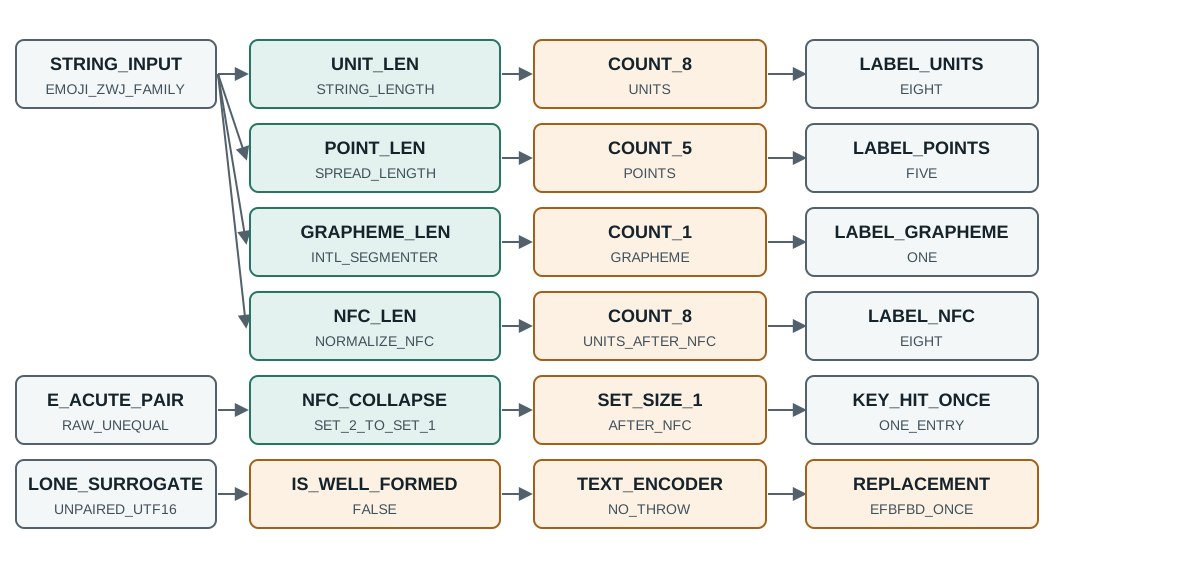
Setcontenant les deux graphies a une taille de deux ; le même ensemble après NFC a une taille de un, donc une recherche par clé peut échouer sur un texte qu’un lecteur voit identique. - Les emoji élargissent l’écart : un emoji de famille fait huit unités, cinq points de code et une grappe de graphèmes.
- Un substitut isolé échoue à
isWellFormed()etTextEncoderécrit un caractère de remplacement, donc un encodage avec perte est observable sans aucune erreur. - Collation, casse et segmentation dépendent de la locale qui leur est passée, et le
sort()par défaut n’utilise aucun collateur. - Chaque nombre vient d’une compilation d’ICU et d’une version d’Unicode ; une autre compilation peut diverger.
Contents
- Quel runtime et quelle version d’Unicode
- Quatre longueurs pour le même texte visible
- Où une clé échoue sur un texte identique
- Où un substitut isolé devient un caractère de remplacement
- Où la casse change la longueur d’une chaîne
- Où collation et segmentation dépendent de la locale
- Consigner une lecture de texte sans surestimer
Quel runtime et quelle version d’Unicode
La sonde imprime le runtime, ICU et Unicode avant toute mesure, car chaque nombre ci-dessous est une propriété de ce trio. Cette exécution a rapporté node=v26.9.0, icu=78.3, unicode=17.0 et tz=2026a. Une autre compilation d’ICU peut porter d’autres tables de casse, une autre table de collation et un autre jeu de règles de segmentation, donc une lecture sans ces versions n’est pas reproductible. La revue des alias de fuseaux ICU applique la même règle de portée aux noms de fuseaux, où la chaîne résolue est une recherche dans une table livrée et non une lecture d’horloge.
La version d’Unicode compte plus qu’il n’y paraît. De nouvelles séquences d’emoji, de nouvelles marques combinantes et des corrections de propriétés arrivent avec un saut de version, et chacune change au moins une des quatre longueurs ci-dessous pour une chaîne donnée. Un relevé qui dit « la page a rapporté une longueur de 8 » sans la version d’Unicode ne peut pas être comparé à une autre machine, car le même texte visible peut faire huit unités sur une compilation et neuf sur une autre dès qu’une nouvelle séquence gagne une propriété qui change sa segmentation.
Quatre longueurs pour le même texte visible
La première sonde mesure chaque chaîne de quatre façons : length compte les unités de code UTF-16, [...s].length compte les points de code, un Intl.Segmenter en granularité graphème compte ce qu’un lecteur perçoit comme un caractère, et normalize('NFC').length compte les unités après composition canonique.
e-acute-precomposed: units=1 points=1 nfc=1 nfd=2 cps=U+00E9
e-acute-decomposed: units=2 points=2 nfc=1 nfd=2 cps=U+0065 U+0301
emoji-zwj-family: units=8 points=5 nfc=8 nfd=8 cps=U+1F468 U+200D U+1F469 U+200D U+1F467
emoji-skin-tone: units=4 points=2 nfc=4 nfd=4 cps=U+1F44D U+1F3FD
hangul-syllable: units=1 points=1 nfc=1 nfd=2 cps=U+AC00
hangul-jamo: units=2 points=2 nfc=1 nfd=2 cps=U+1100 U+1161
Six lignes, avec quatre tuples distincts : la ligne é précomposée et la ligne hangul précomposée en partagent un, et les deux lignes décomposées en partagent un autre. Les deux lignes é diffèrent en unités et en points mais concordent après NFC, le cas classique. La ligne de l’emoji de famille montre l’écart maximal : huit unités, cinq points de code et un graphème. Les lignes hangul montrent que NFC compose deux jamo en une syllabe, donc la longueur normalisée coïncide exactement avec la ligne précomposée.
La conséquence pratique est que « longueur » n’est pas une mesure unique. Une page qui consigne str.length d’un nom affiché consigne des unités UTF-16, ce qui pour un nom riche en emoji peut valoir le double de ce qu’un lecteur appellerait le nombre de caractères. Une page qui consigne [...str].length consigne des points de code, qui comptent encore cinq fois l’emoji de famille. Seul le segmenteur concorde avec le lecteur.
Le décompte de graphèmes est celui qui correspond à la perception, et la sonde le rend explicite :
segmenter graphemes=1 units=8 points=5
segmenter graphemes=1 units=4 points=2
segmenter graphemes=1 units=2 points=2
segmenter graphemes=1 units=4 points=2
Quatre chaînes différentes, trois décomptes d’unités distincts, un graphème chacune. Un validateur qui limite un nom à vingt unités rejetterait cinq emoji de famille qu’un humain lit comme cinq caractères ; un validateur qui limite à vingt graphèmes les accepterait et stockerait quarante unités et vingt-cinq points de code. La limite et le lecteur mesurent des choses différentes, et les deux sont défendables tant que le relevé dit laquelle a été utilisée.
Où une clé échoue sur un texte identique
Les deux lignes é impliquent déjà un mode de défaillance, et la seconde sonde le mesure directement :
NFC equal: true
raw equal: false
name keys equal raw: false | nfc equal: true
Set size with two spellings: 2
Set size after NFC: 1
Deux graphies du même nom sont inégales comme chaînes et égales après NFC. Placées dans un Set comme clés, elles produisent deux entrées ; passées d’abord par normalize('NFC'), elles en produisent une. C’est tout le mécanisme derrière un compte en double qu’un outil de support ne trouve pas, un cache qui rate à chaque requête parce que le client envoie l’autre graphie, et une liste de blocage qui échoue parce que l’entrée a été saisie sur un clavier qui compose et le trafic arrive d’un clavier qui ne compose pas.
Rien dans cette défaillance n’est exotique. Un clavier macOS produit typiquement du texte décomposé pour les lettres latines accentuées, un clavier Windows produit typiquement du texte précomposé, et un copier-coller depuis un PDF peut produire l’un ou l’autre selon le mappage des glyphes de la police. Les deux graphies se rendent à l’identique à l’écran et comparent inégal dans toute langue qui compare des chaînes par unité de code.
La correction n’est pas de tout normaliser partout, car NFKC change des caractères que certains systèmes traitent comme distincts et la normalisation peut aussi casser une signature exacte en octets. La correction est de normaliser à la frontière où l’identité se décide : la clé d’une recherche, la valeur d’une entrée de cache, la comparaison dans une vérification de doublons. Un relevé devrait dire quelle forme a été stockée, car une chaîne stockée normalisée ne peut pas être comparée à une qui ne l’a pas été sans normaliser de nouveau.
Où un substitut isolé devient un caractère de remplacement
La normalisation ne répare pas un texte invalide. Une chaîne contenant un substitut isolé n’est pas bien formée, et la sonde montre à la fois le contrôle et la perte :
lone-surrogate isWellFormed=false units=3
lone-surrogate bytes=61 ef bf bd 62
replacement count=1
isWellFormed() renvoie false, et TextEncoder écrit ef bf bd à la place de l’unité fautive : un caractère de remplacement U+FFFD. L’encodage ne lève rien. Une page qui envoie une telle chaîne à un serveur envoie une chaîne différente de celle qu’elle détenait, et rien dans l’appel n’a signalé la substitution.
Cette substitution silencieuse est la raison pour laquelle un aller-retour peut modifier une valeur. Encoder, transmettre, décoder et le texte renvoyé n’est plus égal à l’entrée, alors que chaque étape a réussi. Un fixture qui vérifie seulement « la requête s’est terminée » ne le remarquera pas ; un fixture qui compare la chaîne avant encodage à la chaîne après décodage le remarquera, et la différence est exactement les caractères de remplacement.
La substitution a aussi une conséquence de décompte facile à manquer. Une chaîne avec un substitut isolé et une chaîne avec un caractère de remplacement font toutes deux trois unités dans l’entrée de la sonde, donc un contrôle de longueur passe alors que la valeur diffère. Deux caractères de remplacement issus de deux unités fautives produisent une chaîne qui ne fait plus d’aller-retour du tout, et un cycle répété d’encodage et de décodage n’ajoute pas d’autres remplacements, ce qui signifie qu’un fixture qui encode deux fois et compare donne un faux succès sur des données déjà dégradées au premier passage.
Le découpage de chaînes est la façon la plus courante de créer cette figure par accident. Couper une chaîne de trois unités à l’index deux, ou prendre les quatre premières d’une chaîne de cinq, peut séparer une paire de substituts et laisser une moitié isolée. La chaîne résultante reste une chaîne JavaScript valide de la longueur attendue, donc rien ne lève ; seul isWellFormed() ou une comparaison d’octets après encodage le révèle. Un fixture qui tronque un texte utilisateur à un budget d’affichage sans vérifier la frontière produira exactement ce défaut sur toute entrée contenant un caractère hors BMP près de la coupe.
Où la casse change la longueur d’une chaîne
Le mappage de casse n’est pas une substitution par caractère qui préserve la longueur, et trois caractères courants montrent trois comportements différents :
case "ß" upper="SS" upperUnits=2 lower="ß" lowerUnits=1
case "İ" upper="İ" upperUnits=1 lower="i̇" lowerUnits=2
case "Dž" upper="DŽ" upperUnits=1 lower="dž" lowerUnits=1
Le eszett allemand s’étend en deux lettres en majuscules. Le I majuscule pointu turc garde une unité en majuscule mais s’étend en deux unités en minuscules dans une locale anglaise, car la forme minuscule est i plus un point combinant. Le digramme en capitale de titre change un caractère en un autre sans changer la longueur. Trois caractères, trois issues, et une seule préserve le décompte d’unités.
Un système qui stocke une clé insensible à la casse en passant en majuscules changera donc la longueur de certains identifiants, et un système qui impose une longueur maximale avant la casse peut rejeter un identifiant qui devient plus long après. Les deux sont faciles à corriger une fois l’extension connue, et les deux sont invisibles si la seule entrée de test est de l’ASCII.
La dimension de locale aggrave cela d’une façon facile à manquer, car la même lettre mappe différemment selon la locale passée :
case "I" lower(tr)="ı" upper(tr)="I" lower(en)="i"
case "i" lower(tr)="i" upper(tr)="İ" lower(en)="i"
case "İ" lower(tr)="i" upper(tr)="İ" lower(en)="i̇"
case "ı" lower(tr)="ı" upper(tr)="I" lower(en)="ı"
En turc, I passe en minuscule en ı sans point et i passe en majuscule en İ pointu, tandis qu’en anglais les deux mappent vers la paire habituelle. La troisième ligne est la plus nette : İ passe en minuscule en une unité en turc et en deux en anglais. Une comparaison insensible à la casse qui fixe une locale obtient un comportement ; une comparaison qui s’en remet à la locale par défaut obtient celui qu’a choisi le runtime, qui peut différer de celui que rapporte le profil.
Le texte atteint aussi une page via une pile de polices avant que ces décomptes ne comptent, et la même chaîne peut se mesurer autrement dès que les glyphes viennent d’une autre fonte. Rendu des polices CJK couvre la façon dont la pile change la mesure, et données de locale de l’API Intl et format portable couvre le côté formatage de la même dépendance à la locale dont traite cette section.
Où collation et segmentation dépendent de la locale
Le tri est un troisième endroit où la locale change la réponse, et la sonde montre trois ordres différents pour les mêmes quatre mots :
sort en: apple < äpple < zebra < Zebra
sort sv: apple < zebra < Zebra < äpple
sort default: Zebra < apple < zebra < äpple
en compare zebra/Zebra: -1
L’anglais place äpple juste après apple, le suédois le place en dernier car ä est une lettre séparée après z, et le tri par défaut place Zebra en premier car il compare des unités de code et le Z majuscule trie avant le a minuscule. Une liste qu’une page rend triée différera donc entre deux sessions qui ne diffèrent que par la locale, et une comparaison de captures de cette liste signalera une différence qui est entièrement de la collation.
Le même comparateur décide aussi de l’égalité quand une table est indexée par du texte trié, car Intl.Collator renvoie zéro pour des chaînes que la comparaison par défaut traite comme différentes. La sonde le mesure aussi, sur quatre niveaux de sensibilité :
sensitivity base: e-acute vs e=0 a vs A=0
sensitivity accent: e-acute vs e=1 a vs A=0
sensitivity case: e-acute vs e=0 a vs A=-1
sensitivity variant: e-acute vs e=1 a vs A=-1
En sensibilité de base, les deux paires comparent égal, donc une clé construite avec un tel comparateur fusionnerait é avec e et a avec A. En sensibilité d’accent, les deux paires se séparent dans des directions opposées. Une fonction de « détection de doublons » bâtie sur un collateur à la mauvaise sensibilité fusionne ou sépare exactement les cas qu’elle devait traiter, et le réglage est invisible dans la sortie.
La segmentation de mots ajoute un nombre de plus qui diverge du tokeniseur évident :
word segments=5 ["Version","155.0.0","ships","café","file"]
whitespace tokens=6 vs segmenter words=5
Découper sur les espaces donne six jetons tandis que le segmenteur donne cinq segments de type mot, et tout l’écart vient du chiffre cerclé ①, que le segmenteur marque avec isWordLike faux. Le retirer ramène les deux décomptes à cinq, et remplacer la ligature fi par f les laisse aussi à cinq, donc la ligature n’est pas la cause. Un « nombre de mots » consigné dans un fixture dépend entièrement de la méthode qui l’a produit.
La collation numérique est le dernier commutateur qui change l’ordre, et elle le change fortement :
numeric on: 1.2.0 < 1.9.0 < 1.10.0
numeric off: 1.10.0 < 1.2.0 < 1.9.0
Avec la comparaison numérique activée, les versions se trient comme une page de versions l’attend. Sans elle, elles se trient comme du texte, et 1.10.0 précède 1.2.0. Une liste de versions triée avec un comparateur sans l’option numérique paraît fausse à tout lecteur tout en restant cohérente en interne, ce qui la rend difficile à repérer dans un diff.
Consigner une lecture de texte sans surestimer
Une lecture de texte étaye une affirmation étroite : ce runtime, cet ICU, cette version d’Unicode et cette locale, avec cette entrée, ont produit ces quatre nombres. Elle ne dit pas qu’un lecteur voit la même chose, qu’une autre compilation concorderait ni qu’un serveur a normalisé la chaîne de la même façon.
Gardez six champs et le relevé reste vérifiable. Les versions de runtime, ICU et Unicode, car les tables de casse, de collation et de segmentation viennent avec elles. L’entrée telle que fournie, idéalement en points de code plutôt qu’en texte rendu, car deux entrées peuvent se rendre à l’identique. Les quatre longueurs, avec la méthode nommée pour chacune. La locale et la sensibilité du collateur, car les deux changent la réponse. La forme de normalisation appliquée à la frontière. Et si le chemin de l’encodeur a produit un caractère de remplacement, car cette substitution change la valeur sans erreur.
La page de documentation correspondante couvre la façon dont BotBrowser aligne les surfaces de police et de navigator sur le profil chargé. Cette revue ajoute le côté lecture : ce que le runtime fait du texte que ces surfaces portent, laquelle des quatre longueurs renvoie une API donnée, et où une locale décide d’une comparaison qu’un lecteur suppose figée. Une configuration cohérente et une lecture correcte de la chaîne résultante sont deux questions distinctes.
Pour toute décision sur une session réelle, utilisez un résultat d’intégration autorisé du système qui décide plutôt que d’extrapoler depuis cette sonde. Une longueur consignée dans un fixture et un verdict de production sont deux types de preuve différents.
Practical conclusion
Consignez les versions de runtime, ICU et Unicode, l’entrée en points de code, les quatre longueurs avec leurs méthodes, la locale et la sensibilité du collateur, la forme de normalisation à la frontière, et si l’encodeur a écrit un caractère de remplacement. Dans cette compilation é a deux décomptes d’unités différents, un ensemble de deux entrées se réduit à une après NFC, un emoji de famille fait huit unités et un graphème, un substitut isolé s’encode en un caractère de remplacement sans erreur, la casse peut doubler une longueur, et l’ordre de collation change avec la locale.
Sources
- MDN : String.prototype.normalize
- MDN : Intl.Segmenter
- MDN : Intl.Collator
- Unicode Standard Annex 15 : formes de normalisation
- Unicode Standard Annex 29 : segmentation du texte
- MDN : TextEncoder
- Documentation BotBrowser sur les polices
Next reading
Consultez rendu des polices CJK pour la façon dont le même texte se mesure différemment selon la pile de polices, et données de locale de l’API Intl et format portable pour le côté formatage de la même dépendance à la locale.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
ICU : alias de fuseau et la TZ que vous rapportez
Empreinteua-parser-js : Client Hints, bots et un plafond de 500
EmpreinteReproductibilité de la graine de bruit pour des exécutions répétables
EmpreinteComment hardwareConcurrency révèle les cœurs réels de votre CPU
EmpreinteFingerprinting par mesure de texte : suivi sous-pixel
EmpreinteMode déterministe : empreintes reproductibles
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.