Web Unblocker y API de scraping: qué hacen y cuándo no
Un unblocker alojado devuelve datos, no una sesión. Esa forma de solicitud decide qué trabajos encajan y cuáles necesitan un navegador propio. Incluye un marco de costos.
BotBrowser Team
Quieres la documentación estructurada de Documentación?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Un servicio de desbloqueo alojado responde una solicitud HTTP con datos y la olvida, y esa forma de solicitud decide casi todo sobre su encaje. BotBrowser proporciona un perfil declarado que mantiene coherentes entre sí las superficies que una página puede leer en distintos lanzamientos, y no puede sustituir un grupo de proxies, una flota gestionada ni un servicio de reintentos. La documentación de los proveedores muestra qué vende realmente la categoría: una canalización de solicitudes que controla el enrutamiento, los reintentos, el renderizado y la generación de su propia huella, más un identificador de sesión que conserva una salida durante una ventana limitada, no un navegador que permanece igual.
Resumen
- Un desbloqueador es una canalización de solicitudes: envías una URL, recibes un resultado y no queda un proceso de navegador que puedas inspeccionar.
- Las piezas documentadas son el enrutamiento, los reintentos, el renderizado de JavaScript y la generación de huellas que realiza el proveedor.
- La continuidad es limitada y acotada: un proveedor documenta un identificador de sesión que mantiene una salida durante un máximo de diez minutos.
- Es continuidad de salida de red, no continuidad de identidad del navegador, y ambas responden a requisitos distintos.
- Los servicios gestionados encajan en extracciones puntuales, volúmenes pequeños y trabajos sin inicio de sesión.
- Encajan mal cuando se necesita el mismo navegador reconocible durante días o cuando el contenido de la solicitud no puede salir del perímetro propio.
- La comparación de costos es una cuestión de utilización, y el marco de abajo calcula ambos lados sin citar ningún precio.
Contenido
- Qué vende realmente la categoría
- Los límites que impone la forma de la solicitud
- Cuándo un servicio alojado es la herramienta adecuada
- Cuándo es la herramienta equivocada
- El costo, sin adornos
- Conclusión práctica
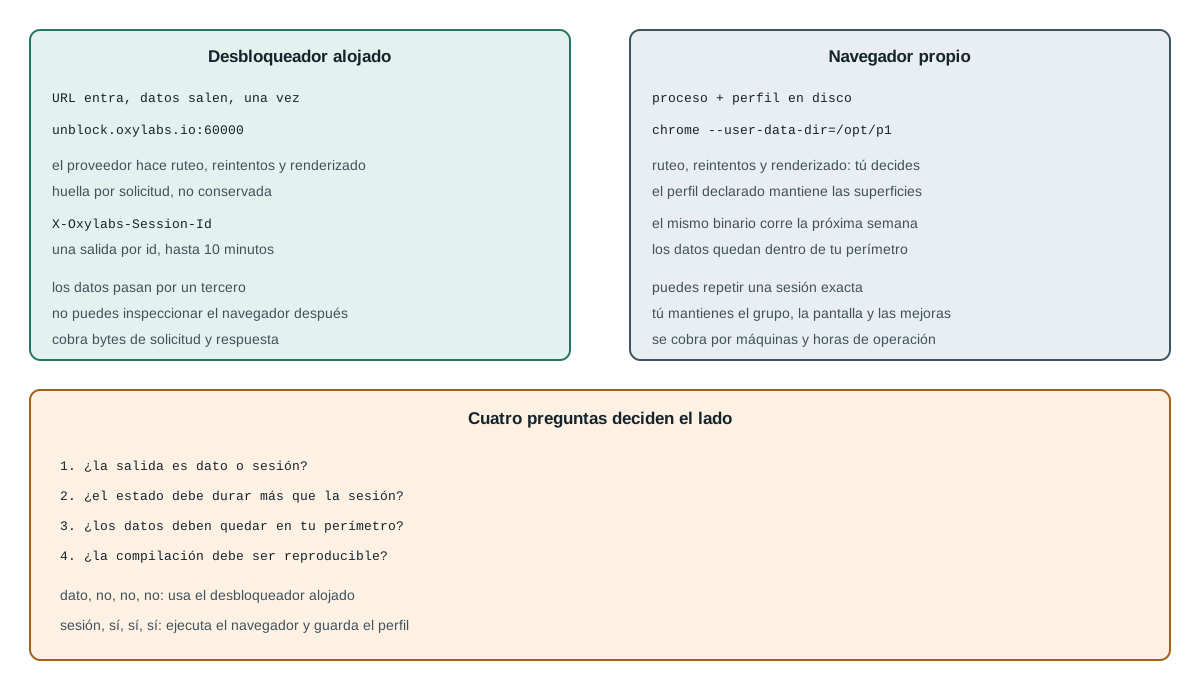
Qué vende realmente la categoría
La documentación es inusualmente explícita sobre la composición, así que esta sección puede ser breve. Oxylabs describe Web Unblocker como una solución de proxy potenciada por IA que gestiona el tipo de proxy, la generación de huellas del navegador, los reintentos automáticos, el mantenimiento de sesiones y el renderizado de JavaScript. Browserless expone la misma idea mediante endpoints REST, donde una solicitud HTTP ejecuta una tarea de navegador y devuelve un resultado en lugar de una sesión.
you send      -> https://unblock.oxylabs.io:60000  (proxy endpoint) or /content, /scrape (REST)
you receive   -> HTML, JSON or an image, once
you do not get-> a browser process, a profile directory or a build you chose
Dos detalles de esa lista importan más que la afirmación principal. El primero es la generación de huellas: la produce el proveedor, lo que significa que no está en tus manos mantenerla constante durante días. El segundo son los reintentos: el proveedor decide cuándo reintentar, lo cual resulta cómodo hasta que necesitas saber si una respuesta llegó tras tres intentos o en el primero, y la regla de facturación documentada solo deja de cobrar los intentos que no aparecen en la factura.
No se trata de una crítica. Una canalización de solicitudes es la forma correcta para una clase amplia de trabajos, y por eso existe la categoría. El punto es que la forma es una forma: determina lo que puedes afirmar después.
La forma también decide qué puedes comparar. Un equipo que elige entre una canalización alojada y un navegador propio elige en realidad entre dos modelos de protección, y qué cambia un núcleo de navegador frente a sobrescrituras de script inyectadas explica por qué una protección parcial puede ser más distintiva que ninguna. Una canalización alojada es coherente por construcción porque un solo sistema produce todos los valores; un navegador autoalojado solo es coherente si el perfil los declara todos.
assertable after a request    -> status code, body, latency, credit cost
not assertable               -> which browser build ran, which profile, which fingerprint
Los límites que impone la forma de la solicitud
Tres límites se derivan de enviar una URL y recibir un resultado, y cada uno está documentado en lugar de inferirse.
El primero es la continuidad acotada. Oxylabs documenta una cabecera X-Oxylabs-Session-Id que asigna una salida a un identificador de sesión durante un máximo de diez minutos; después se asigna otra. Es una función real y útil para flujos de varios pasos. También es una ventana de afinidad de salida, no una identidad duradera del navegador: pasados diez minutos cambia la salida de red, y nada en la respuesta indica cómo era el navegador antes ni después.
session id -> one proxy for up to 10 minutes -> new proxy afterwards
             (egress continuity, not browser continuity)
El segundo límite es que la huella se genera dentro del proveedor. La lista de funciones lo dice de forma directa y la arquitectura lo explica: un servicio que ejecuta miles de solicitudes por minuto no puede leer tu perfil desde el disco. Lo que sí puede hacer es generar uno coherente por solicitud, que es lo que promete la documentación. La consecuencia para el lector es estrecha: si el requisito es "el mismo navegador el lunes y el viernes", esta no es la capa donde hay que pedirlo.
El tercero es la ruta de los datos. Una solicitud que pasa por una canalización alojada lleva la URL, las cabeceras que configuras, las cookies que envías y el cuerpo de la respuesta a través de un tercero. Para páginas públicas suele ser aceptable; para cualquier cosa con inicio de sesión, identificador de cliente o una cláusula contractual de residencia de datos, normalmente no lo es. Es un hecho de cumplimiento, no un defecto del producto, y pertenece a la decisión antes que el precio.
Ese tercer límite tiene una prueba práctica y breve que conviene ejecutar antes de firmar nada. Enumera los campos que transporta la solicitud: la URL, cada cabecera, cada cookie, el cuerpo y la respuesta. Después pregunta, para cada campo, si puede salir legalmente del entorno donde corre el trabajo. Si un solo campo no puede, una canalización alojada queda descartada para ese objetivo por bien que rinda, y el reemplazo no es un proveedor mejor sino un navegador dentro del perímetro.
allowed to leave -> public URL, no cookies, no account identifiers
not allowed      -> session cookies, bearer tokens, customer records, regulated data
leaves your perimeter -> target URL, request headers, cookies, response body
stays with provider   -> retry history, generated fingerprint, routing decision
Otras dos propiedades afectan la reproducibilidad. Una canalización alojada se actualiza según su propio calendario, así que dos solicitudes idénticas separadas por un mes pueden ser atendidas por componentes internos distintos; además, el modelo de créditos mide tráfico, así que el tamaño del cuerpo que recibes importa tanto como el número de solicitudes. La regla de reintentos documentada es la mitad tranquilizadora: un reintento interno que termina en éxito se factura una sola vez. Ninguna de las dos cosas está oculta: ambas son visibles en la documentación y en el panel, no en la respuesta.
Hay un cuarto límite fácil de pasar por alto hasta que causa un problema: el endpoint habla HTTP, así que la única palanca sobre el navegador es el conjunto de cabeceras que documenta el proveedor. Oxylabs ofrece instrucciones personalizadas de navegador y una cabecera de renderizado de JavaScript para Web Unblocker, y ambas son genuinamente útiles. Ninguna permite afirmar qué compilación se ejecutó, qué fuentes estaban instaladas ni qué ruta de GPU se tomó, porque el navegador está detrás del endpoint y no delante de ti. Una prueba escrita contra un endpoint alojado puede afirmar los datos; no puede afirmar el navegador, y cualquier afirmación en ese sentido habla de la generación interna del proveedor, no de tu reproducción.
assertable through the endpoint -> status, body, latency, credits spent
assertable only on a browser    -> build, profile, fonts, GPU, extensions, timing
También por eso un servicio alojado es una mala elección para una suite de regresión. Una suite que compara la captura de ayer con la de hoy necesita que ambas imágenes vengan de la misma compilación, con las mismas fuentes y la misma relación de píxeles del dispositivo, mientras que un endpoint alojado varía deliberadamente esos tres aspectos en su flota para superar las comprobaciones de huella. La variación que lo hace funcionar contra un objetivo es la misma que lo vuelve inútil como referencia fija.
La respuesta práctica es una división, no un ganador. Usa el endpoint alojado cuando la pregunta sea "esta URL devuelve los datos" y usa un navegador que ejecutes tú cuando la pregunta sea "esta página sigue renderizando como antes". Ambas preguntas son legítimas y necesitan instrumentos distintos.
Cuándo un servicio alojado es la herramienta adecuada
El encaje se describe mejor como una lista de condiciones que deben cumplirse todas, porque un trabajo que satisface cuatro de cinco normalmente pertenece a otro lugar.
- La salida necesaria son datos y no una sesión, así que nada posterior tiene que controlar una página.
- El trabajo es puntual o de volumen bajo y estable, donde mantener una flota costaría más de lo que ahorra.
- Ningún estado de inicio de sesión debe sobrevivir entre solicitudes, así que la ventana de afinidad de diez minutos alcanza.
- El contenido de la solicitud es público o no sensible, así que un tercero en la ruta de datos es aceptable.
- No hace falta reproducir el navegador, solo el resultado de la extracción.
Cuando se cumplen, la canalización alojada resulta más barata en todos los sentidos que importan: una solicitud HTTP reemplaza un proceso y un 200 con cuerpo es todo el contrato. No hay máquina que mantener, ni navegador que actualizar, ni grupo que comprobar. Para eso existe la categoría, y un equipo que necesita exactamente esto no debería construirlo.
Un segundo uso legítimo es una primera pasada sobre un objetivo nuevo. Enviar unas pocas solicitudes por un servicio alojado responde si la página devuelve datos antes de que alguien escriba un arnés de navegador, y la respuesta cuesta unos pocos créditos. Diagnosticar un scraping bloqueado por capas es el método que convierte esa primera pasada en una decisión y no en una costumbre.
Un tercer uso es una carga cuyos objetivos rotan. Un trabajo de monitoreo que vigila doscientas páginas públicas no relacionadas una vez al día obtiene poco de un navegador persistente, porque cada página es un origen distinto y la identidad que importa es la coherencia por solicitud, no la continuidad. El enrutamiento alojado resuelve ese caso directamente: el proveedor elige una salida que encaja con el objetivo y el trabajo nunca necesita saber cuál fue. El mismo trabajo con un navegador propio exigiría un grupo dimensionado según los objetivos concurrentes y una regla sobre qué salida ve cada origen, más maquinaria de la que el trabajo justifica.
one origin, many runs      -> continuity matters; a browser you own
many origins, one run each -> coherence per request; a hosted pipeline
Cuándo es la herramienta equivocada
Las condiciones espejo son igual de concretas, y cada una nombra el requisito que la forma de la solicitud no puede cumplir.
- El mismo navegador debe ser reconociblemente el mismo la próxima semana, así que la identidad tiene que sobrevivir a la solicitud.
- Los datos no pueden salir de tu infraestructura, por residencia, contrato u obligación con el cliente.
- Necesitas fijar la compilación del navegador, porque una diferencia de diseño o de códec cambia el resultado.
- Necesitas repetir una sesión exacta para comparar dos ejecuciones, lo que exige conservar la sesión en vez de volver a solicitarla.
- Necesitas estado por identidad que persista durante días, y eso es un directorio de perfil, no una cabecera de sesión.
Para esos casos, el navegador tiene que ejecutarse en un lugar que controles, y el trabajo que absorbía un servicio alojado se vuelve explícito: instalar una compilación fijada, conservar un directorio de perfil, mantener sano el display o el contenedor y registrar lo que se ejecutó. Fijar una versión de Chrome for Testing es la mitad material de ese trabajo, y Browserless frente a navegadores autoalojados es la decisión vecina sobre dónde vive el proceso cuando la identidad sigue siendo tuya.
La última de esas condiciones es la que sorprende a los equipos, así que conviene explicarla. Repetir una sesión exacta significa conservar el navegador entre dos observaciones, no enviar dos veces la misma solicitud. Un endpoint alojado no puede hacerlo, porque la segunda solicitud es una sesión nueva por construcción; un navegador propio sí puede, porque el directorio de perfil y el proceso siguen ahí. Cuando un informe dice "funcionó el martes", la única forma de comprobar esa afirmación es volver al mismo navegador, y eso es una capacidad, no una comodidad.
replay definition -> same process, same profile, same build, second observation
not a replay      -> same URL sent again through a stateless endpoint
hosted unblocker  -> you own: the query, the parsing, the decision to retry
self-hosted       -> you own: the binary, the profile, the pool, the display, the record
El costo, sin adornos
Ninguno de los dos lados es un número sin tu carga de trabajo, pero ambos son calculables, y escribir la fórmula resulta más útil que leer el precio de otra persona.
hosted monthly    ~= consumed_traffic x unit_price    (request bytes + response bytes)
self-hosted cost  ~= machines x hours + ops_hours x loaded_rate + egress
crossover         -> where hosted_traffic x unit_price equals the fixed side
Dos correcciones vuelven honesta esa aritmética, y ambas salen de la propia página de facturación del proveedor, no de una suposición sobre cómo funciona un grupo de proxies. La primera es que el medidor es tráfico y no solicitudes: Oxylabs cobra los bytes de la solicitud y los bytes de la respuesta de los datos extraídos con éxito, así que un cuerpo JSON grande cuesta más que uno pequeño, y una diferencia de compresión cambia la factura sin cambiar el número de solicitudes. La segunda es la regla de reintentos, y va en dirección contraria a la intuición de la mayoría. Cuando una solicitud necesita tres intentos internos y el último tiene éxito, la documentación indica que solo se factura el tráfico consumido durante el último intento exitoso; y cuando el propio lado del proveedor falla con un 5xx, ese intento no se factura. La excepción documentada apunta al otro lado: un fallo causado por el cliente sí se factura, así que una solicitud mal formada o unas credenciales incorrectas pueden costar tráfico sin devolver datos.
Un ejemplo resuelto hace concreta la forma sin citar la tarifa de ningún proveedor. Supón que un trabajo emite cincuenta mil solicitudes al mes y una de cada diez necesita un intento interno extra antes de tener éxito, lo que suma cincuenta y cinco mil intentos. Según la regla documentada, las unidades facturadas siguen siendo cincuenta mil solicitudes exitosas, porque el intento extra dentro de una solicitud exitosa no se factura por separado. El término que sí se mueve es el tráfico: si cada éxito consume doscientos kilobytes entre solicitud y respuesta, el mes suma diez gigabytes de tráfico facturado, y un objetivo cuyo tamaño de página se duplica mueve la factura el doble de lejos que un objetivo cuya tasa de reintentos se duplica. En el lado autoalojado, el mismo trabajo cabe en unos pocos navegadores concurrentes en dos máquinas durante ocho horas al día, y la aritmética es horas de máquina más las horas que alguien dedica a actualizarlas.
requests issued          50000
internal attempts        55000  (1 in 10 needs one extra)
billed successful units  50000  (only the last, successful attempt)
billed traffic           ~10 GB at 200 kB per success
low, spiky volume   -> per-request billing follows the spikes; hosted usually cheaper
high, steady volume -> fixed machines amortise; self-hosted usually cheaper
either way          -> the identity requirement is not in this arithmetic at all
El nivel gratuito merece una frase llana en lugar de un desprecio, porque una parte importante de las búsquedas sobre esta categoría busca precisamente eso. Los proveedores publican una asignación gratuita y Oxylabs documenta un crédito de bienvenida. Una asignación gratuita es una forma legítima de evaluar una canalización; lo que no es, es una forma de ejecutar una carga que necesita concurrencia, porque los niveles gratuitos publicados limitan las sesiones concurrentes y su duración. Leer el límite antes de construir sobre el nivel gratuito separa un piloto de una caída.
Una alternativa de código abierto es lo otro que buscan esas consultas, y merece el mismo trato llano. Existe un desbloqueador autoalojado, y es esencialmente el trabajo de grupo de navegadores descrito arriba más una capa de enrutamiento y un bucle de informe de detectores, una cantidad grande de código que mantener. Vale la pena cuando el volumen es estable y los requisitos de identidad son reales; no vale la pena como forma de evitar una suscripción para un trabajo que corre dos veces por semana, porque el costo operativo de un grupo lo dominan las horas que alguien dedica a vigilarlo, no las máquinas que usa. Un grupo que nadie vigila es un grupo que falla en silencio un sábado, y la suscripción que reemplazó pagaba exactamente esa atención.
free tier        -> good for a pilot, capped on concurrency and session length
open-source      -> good at steady volume, costs engineering hours to operate
paid per request -> good for spiky or low volume, follows the spikes
Conclusión práctica
Haz cuatro preguntas en orden. ¿La salida tiene que ser datos o una sesión? ¿Algún estado debe sobrevivir más que la ventana del proveedor? ¿El contenido de la solicitud tiene que quedarse dentro de tu perímetro? ¿El navegador mismo tiene que ser reproducible? Un trabajo que responde "datos, no, no, no" pertenece a un desbloqueador alojado, y la cabecera de sesión de diez minutos le alcanza. Un trabajo que responde "sesión, sí, sí, sí" pertenece a un navegador que ejecutes tú, y ninguna cantidad de ajuste en la solicitud alojada lo sustituye.
El modo de fallo que hay que evitar es el caso mixto, donde un equipo empieza con una canalización alojada, añade un inicio de sesión, después añade un requisito persistente y sigue extendiendo la solicitud hasta construir un arnés de navegador con reintentos. En ese punto, el movimiento honesto es ejecutar el navegador, conservar el perfil y usar el servicio alojado solo para los objetivos que todavía encajan con la forma de la solicitud.
Ambos cambios cuestan menos que la alternativa, que es una canalización cuyo comportamiento nadie puede reproducir. Registra qué lado usa cada objetivo y por qué; scraping con navegador headless: qué cambia es la lista de diferencias una vez que el navegador queda de tu lado de la línea.
Fuentes
Artículos Relacionados
Browserless frente a navegadores autoalojados
Comparación¿Qué cambia un navegador antidetección?
Primeros pasosMejor navegador para web scraping: seis criterios
ComparaciónNúcleo del navegador vs scripts JavaScript en huellas digitales
DespliegueProtección de huellas del navegador para recopilar datos web
DespliegueScraping de Shopify: ¿Storefront API, Ajax o navegador?
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.