Protección de huellas del navegador para recopilar datos web
La recopilación de datos web necesita más que proxies y cabeceras. La protección de huellas mantiene coherentes canvas, WebGL, fuentes y señales del perfil en trabajos autorizados.
Quieres la documentación estructurada de Despliegue?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Por qué un proxy y unas cabeceras no describen todo el navegador
Los equipos que recopilan datos web públicos con permiso suelen empezar con la misma lista: un proxy para la ruta de red, una cabecera User-Agent razonable y un navegador que ejecute JavaScript. Esa lista resuelve problemas reales, pero no describe el navegador que la página realmente ve. La página recibe todo el entorno de ejecución: cómo se dibuja el texto en un canvas, qué capacidades gráficas se informan, qué fuentes están instaladas, cuánto tardan las operaciones habituales, qué idiomas y zona horaria declara el navegador y si esos valores coinciden con la ruta de red.
Cuando los valores no coinciden, el resultado rara vez es espectacular. Una página puede mostrar un idioma distinto del esperado, pedir una confirmación adicional, devolver una variante regional que un analista no puede reproducir o comportarse de forma diferente entre dos ejecuciones que parecían idénticas en el registro del trabajo. La causa suele ser un entorno incoherente y no una sola cabecera incorrecta. Un proxy en un país junto con un navegador que informa la zona horaria de otro es el ejemplo más común, pero los gráficos, las fuentes y los valores de pantalla pueden discrepar del mismo modo.
La protección de huellas del navegador actúa sobre esta capa. En la documentación de BotBrowser, un perfil describe un entorno concreto de navegador y dispositivo, y el navegador informa de ese entorno de forma coherente en páginas, workers y contextos nuevos. El objetivo es la privacidad y la repetibilidad en trabajos autorizados. No es una promesa de acceso a ningún sitio concreto, y las secciones siguientes indican con claridad dónde vuelve la responsabilidad al equipo que gestiona el flujo de trabajo.
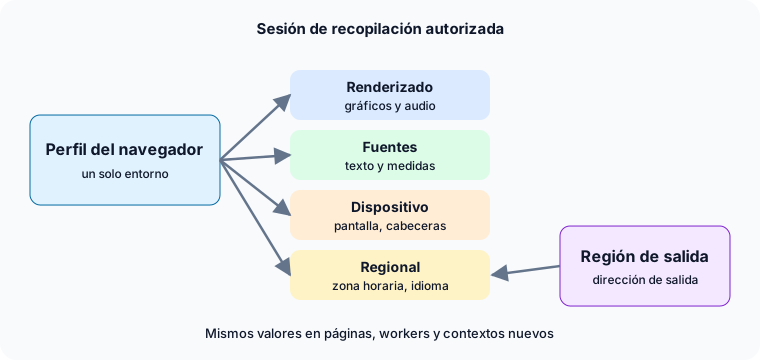
De un vistazo:
- El renderizado, las fuentes y los tiempos deben coincidir con el perfil de navegador elegido.
- La región del proxy, la zona horaria, la configuración regional y el idioma deben coincidir entre sí en la misma sesión.
- Los cambios parciales en unas pocas propiedades de JavaScript dejan huecos que un perfil completo evita.
- El ritmo de las solicitudes, los desafíos, la política de cuentas y los términos del sitio siguen siendo responsabilidad del equipo que gestiona el flujo de trabajo.
Las familias de señales que informa un navegador de recopilación
Conviene nombrar las familias de valores que una página puede leer, porque una revisión de coherencia debe cubrirlas todas. No hace falta memorizarlas como una lista de propiedades. Lo importante es que cada familia describa el mismo dispositivo.
- Renderizado de canvas. Las páginas pueden dibujar texto y formas y leer cómo las renderizó el navegador. La API Canvas es estándar, y los resultados varían con el sistema operativo, la pila gráfica y las fuentes.
- WebGL y gráficos. La API WebGL expone capacidades gráficas e información del renderizador. Una descripción gráfica que no encaja con el sistema operativo declarado es una fuente frecuente de incoherencia.
- Procesamiento de audio. La API Web Audio produce una salida que difiere ligeramente entre plataformas y versiones.
- Valores de navigator y de pantalla. La plataforma, las preferencias de idioma, las características del dispositivo y las dimensiones de pantalla describen el dispositivo declarado.
- Fuentes. Las fuentes instaladas y la forma de medir el texto dependen mucho del sistema operativo. Un servidor Linux que declara un dispositivo Windows pero renderiza con otro conjunto de fuentes es internamente incoherente.
- Client Hints y cabeceras. La marca del navegador, la plataforma y la arquitectura enviadas con las solicitudes deben coincidir con lo que ven los scripts en la página.
- Tiempos y capacidad. Los tiempos de rendimiento, el número de procesadores informado y la clase de memoria describen lo capaz que parece el dispositivo.
- Ajustes regionales. La zona horaria, la configuración regional y los idiomas describen dónde dice estar el navegador y qué idioma prefiere la persona que lo usa.
El requisito para un flujo de recopilación es fácil de enunciar: todas las familias deben describir el mismo dispositivo en el mismo lugar. Lo difícil es que la mayoría de estos valores se producen en el interior del navegador, de modo que un flujo que cambia solo los más fáciles acaba con una imagen mezclada.
Por qué los cambios parciales en JavaScript dejan huecos
Muchas configuraciones de recopilación empiezan con scripts que sobrescriben unas pocas propiedades del navegador al cargar la página. Es comprensible: es rápido de probar y funciona para la propiedad que se cambia. Pero ahí es donde entra la incoherencia.
Un script que se ejecuta dentro de la página cambia los valores cuando la página ya ha empezado a existir. En algunos contextos, el código de la página y los marcos incrustados pueden ejecutarse antes de que se aplique el cambio. Los workers dedicados, los workers compartidos y los service workers tienen su propio ámbito global, así que un valor cambiado en la página principal puede ser distinto dentro de un worker. Un iframe nuevo o un contexto de navegador nuevo parte otra vez de los valores originales, salvo que el mismo cambio se repita allí. Cada uno de esos casos es un hueco que el equipo debe controlar.
El segundo problema es la cobertura. Cambiar la cadena User-Agent no cambia cómo renderiza el navegador un canvas, qué fuentes informa, cómo se comporta su salida de audio ni qué dice su descripción gráfica. Una sola propiedad sobrescrita suele entrar en conflicto con otras que se dejaron intactas. Por ejemplo, una cadena de plataforma que nombra un sistema operativo junto a una lista de fuentes que pertenece a otro hace que ambas familias describan dispositivos distintos.
El tercer problema es el mantenimiento. Las versiones del navegador cambian elementos internos, y cada parche que depende de ellos debe volver a comprobarse. Las ejecuciones headless añaden otra capa: las diferencias entre el modo headless y el modo con ventana, como el tamaño de la ventana, la lista de plugins o detalles de renderizado, suelen tratarse una por una. El equipo acaba manteniendo una lista creciente de excepciones en lugar de una única descripción del entorno.
Un enfoque basado en perfiles invierte el modelo. En lugar de parchear valores sueltos, el navegador se inicia con un perfil que define el entorno completo, y desde el principio informa de ese entorno en páginas, workers y contextos nuevos. La documentación de BotBrowser lo describe superficie por superficie, incluida la coherencia entre workers para los valores de navigator y el audio. Esa es la afirmación acotada en la que se apoya este texto: coherencia del entorno informado, no una garantía sobre cómo reaccione un sitio.
Región del proxy, zona horaria, configuración regional e idioma en una sola sesión
De todas las familias de señales, los ajustes regionales son los más fáciles de revisar y los más fáciles de equivocar, así que merecen atención propia.
Un proxy determina la ruta de red y la dirección pública que ven los sitios. No decide qué zona horaria informa el navegador, qué configuración regional da formato a números y fechas ni qué idiomas figuran en las preferencias del navegador. Esos valores los aporta el navegador. Si se dejan en los valores predeterminados de la máquina anfitriona, un servidor de recopilación situado en una región informará la zona horaria de esa región aunque el proxy apunte a otra.
Por defecto, BotBrowser deriva la zona horaria, la configuración regional y el idioma a partir de la IP del proxy, lo que su documentación llama modo auto. Los tres valores se mantienen alineados con la región del proxy y entre sí, de modo que una sesión que sale por Alemania informa una zona horaria alemana, una configuración regional coincidente y una lista de idiomas coincidente sin más opciones. Existen sustituciones manuales para cada valor como opción de nivel con licencia. Un valor manual tiene prioridad en el ajuste que define, mientras que los ajustes que se dejan en auto siguen al proxy.
Tres detalles prácticos de la documentación merecen recordarse:
- Deja que el navegador gestione el proxy. La detección automática funciona cuando el proxy se define con la opción de proxy del propio navegador al iniciarlo. Usar en su lugar la opción de proxy del framework puede dejar la zona horaria con el valor de la máquina anfitriona.
- Los datos de ubicación del proxy deciden el resultado. El modo auto sigue la ubicación a la que corresponde la IP del proxy. Si los datos de ubicación del proveedor son incorrectos, o la dirección de salida corresponde a una región distinta de la esperada, los valores derivados siguen esa correspondencia. Es un motivo para comprobar, no para adivinar.
- Indica al navegador la dirección de salida cuando la conozcas. La documentación describe la opción
--proxy-ip(ENT Tier1) para declarar la IP pública de salida del proxy, que evita las consultas de IP en cada página y hace predecible el resultado cuando esa dirección ya se conoce.
Un inicio mínimo que se apoya en el modo auto solo necesita un perfil y un proxy:
chromium-browser \
  --bot-profile="path/to/profile.enc" \
  --proxy-server=socks5://user:pass@de-proxy.example.com:1080
Para ver todas las opciones y sus niveles de licencia, consulta la documentación de BotBrowser sobre zona horaria, configuración regional e idioma. Para entender cómo se resuelve la salida del proxy, consulta nuestra guía de configuración de proxy.
El DNS y WebRTC requieren la misma comprobación explícita. Decide a propósito dónde se resuelven los nombres (la opción --bot-local-dns, ENT Tier1, resuelve en local, y --bot-local-dns=false deja que el proxy resuelva los nombres) y confirma que WebRTC no expone una dirección fuera de la ruta del proxy; BotBrowser ofrece protección WebRTC por defecto y se recomienda un proxy para una protección completa. La guía de coherencia de proxy, DNS y WebRTC recorre esa revisión.
Cómo verificar la alineación antes de recopilar datos
No des la alineación por supuesta: confírmala una vez por cada combinación de ruta de proxy y perfil antes de ejecutar un trabajo a gran escala. Las comprobaciones siguientes usan solo lo que una persona ve en una ventana de navegador normal, y cada una tiene un resultado esperado.
- Confirma la región del proxy. Usa las herramientas del proveedor del proxy o una consulta de direcciones de confianza para anotar la región a la que corresponde la dirección de salida. Es la referencia con la que se comparan los demás valores.
- Lee la zona horaria que informa la página. Abre la consola de desarrollo del navegador en la sesión y evalúa
Intl.DateTimeFormat().resolvedOptions().timeZone, que describe la referencia de MDN sobre resolvedOptions. El resultado debe ser una zona horaria que pertenezca a la región del proxy. - Lee la lista de idiomas. La referencia de Navigator.languages describe la lista ordenada de idiomas preferidos. Evalúa
navigator.languagesy confirma que la primera entrada corresponde a la región prevista y que el orden parece una lista de preferencias normal. - Compara los formatos. Abre una página que muestre una fecha, un número con separador decimal y una moneda. Los formatos deben corresponder a la configuración regional esperada.
- Repite en un contexto nuevo. Abre un segundo contexto y una página que use un worker, y repite las cuatro primeras comprobaciones. Los valores deben coincidir con los del primer contexto, lo que confirma que el ajuste no se aplicó solo a una página.
- Registra el resultado. Guarda la etiqueta de la ruta del proxy, el nombre del perfil, la zona horaria y el primer idioma. Un registro breve facilita explicar diferencias posteriores.
Cuando una comprobación falla, cambia una sola cosa cada vez. Verifica que el proxy esté configurado en el navegador, comprueba a qué ubicación corresponde la IP del proxy y compara el perfil en uso con el dispositivo previsto. Empezar de nuevo con un contexto limpio suele ser más claro que editar un contexto que ya contiene cookies y almacenamiento de la configuración incorrecta.
Revisión del renderizado, las fuentes y los valores del dispositivo
El mismo hábito se aplica fuera de los ajustes regionales, aunque no existen respuestas correctas ligadas a una región. La pregunta es si las familias coinciden entre sí y con el perfil.
Una tabla de revisión breve mantiene la conversación concreta:
| Área | Qué confirmar |
|---|---|
| Renderizado | El comportamiento de canvas y WebGL encaja con el sistema operativo y la clase gráfica que describe el perfil |
| Fuentes | Las fuentes disponibles y la medición del texto encajan con el sistema operativo declarado |
| Dispositivo y pantalla | La plataforma, el tamaño de pantalla y las capacidades informadas describen un solo dispositivo |
| Cabeceras y scripts | Los Client Hints enviados con las solicitudes coinciden con los valores que leen los scripts en la página |
| Tiempos | El procesador y la clase de memoria informados encajan con el perfil y con la capacidad real del anfitrión |
| Ajustes regionales | La región del proxy, la zona horaria, la configuración regional y el idioma coinciden en cada contexto |
| Límites de sesión | Las cookies y el almacenamiento pertenecen a un perfil y a una ruta |
Haz la revisión con un perfil por cada familia de sistema operativo que pienses usar y reutiliza el resultado como referencia. Si una ejecución posterior produce una página distinta de la referencia, podrás comparar configuraciones en lugar de adivinar.
Se aplican dos precauciones. Primero, un perfil coherente no oculta la capacidad real del anfitrión: un perfil que describe un portátil modesto pero se ejecuta en un servidor muy grande seguirá produciendo tiempos que reflejan el anfitrión, así que conviene mantener expectativas moderadas y un perfil realista. Segundo, las ejecuciones headless y las que usan ventana deben revisarse por separado, porque un resultado válido en un modo no demuestra el otro.
Sesiones, perfiles y variación en los trabajos de recopilación
Un trabajo de recopilación rara vez es una sola página. Es una serie de sesiones, y cada sesión debe tener una identidad clara. La documentación de BotBrowser describe los perfiles como entornos completos, y los niveles con licencia añaden controles como semillas de ruido deterministas y huellas distintas para contextos de navegador distintos.
Dos ideas lo mantienen manejable.
Una sesión, un entorno. Mantén juntos las cookies, el almacenamiento, el perfil y la ruta del proxy durante toda la vida de una sesión. Si la ruta cambia, trata la sesión como nueva en lugar de cambiar la ruta bajo cookies existentes. Un historial mezclado es difícil de interpretar después y es una fuente habitual de comportamientos confusos de la página.
La variación tiene un propósito. Los perfiles distintos son útiles cuando un flujo debe representar clases de dispositivo o regiones diferentes que está autorizado a representar. La variación por sí misma solo aumenta el número de entornos que verificar. Cuando un equipo usa una semilla para repetir un resultado, la documentación describe que la misma semilla produce la misma salida, lo cual sirve para reproducir un problema y comparar ejecuciones. Trata la semilla como parte de la configuración registrada para que una ejecución posterior pueda usar el mismo valor.
Cada perfil o ruta añadido suma un coste de verificación. Empieza con el conjunto más pequeño que cubra el trabajo autorizado, verifícalo y amplíalo solo cuando aparezca una necesidad documentada.
Ritmo de solicitudes, reintentos y política de cuentas
La coherencia del navegador es solo una de las entradas que determinan cómo responde un sitio. Las demás están en manos del equipo y ningún ajuste del navegador las cambia.
- Ritmo de solicitudes. Espaciar las solicitudes de acuerdo con los límites publicados por el sitio forma parte de una recopilación autorizada. Añade pausas entre cargas de página, evita ráfagas y reduce el ritmo cuando un sitio devuelva un error o una respuesta de límite de uso.
- Reintentos. Un bucle que repite la misma solicitud sin pausa empeora las cosas. Usa esperas crecientes y un tope de intentos, y detente cuando el sitio siga rechazando.
- Desafíos interactivos. BotBrowser no resuelve desafíos interactivos. Si un flujo se encuentra con uno de forma habitual, la respuesta correcta es revisar si la recopilación está autorizada, si existe una fuente de datos oficial o una API y si el titular del sitio puede conceder acceso.
- Política de cuentas. La recopilación con sesión iniciada se rige por los términos de la cuenta. Un perfil de navegador no cambia lo que permite un acuerdo de cuenta.
- Calidad del proxy. El proveedor del proxy controla la calidad de la dirección de salida, los datos de ubicación y la disponibilidad. Un navegador bien alineado sobre un proxy mal ubicado seguirá informando la región a la que corresponde el proxy.
No son casos marginales. Son la razón principal por la que dos equipos con la misma configuración de navegador pueden ver resultados muy distintos.
Planificar la capacidad sin adivinar
Los equipos suelen preguntar cuántas sesiones puede ejecutar una máquina. La respuesta sincera es que depende del hardware y de las páginas que se recopilan. Una página solo de texto y una con scripts pesados, vídeo o imágenes grandes consumen cantidades muy distintas de memoria y procesador. Cualquier cifra citada sin describir el hardware y el tipo de página debe tratarse, como mucho, como una estimación aproximada de planificación.
Un método mejor es medir la carga propia. Ejecuta unas pocas sesiones sobre páginas representativas, observa el uso de memoria y procesador y aumenta poco a poco mientras compruebas que las cargas de página siguen terminando en un tiempo razonable. La documentación de rendimiento de BotBrowser describe varios factores que afectan al rendimiento, entre ellos las consultas al iniciar, la carga del perfil, la selección del motor gráfico y el uso de varios contextos de navegador dentro de una misma instancia en lugar de lanzar muchas instancias separadas. Úsala como punto de partida y guarda tus propias mediciones junto a tu configuración.
Al trabajar en contenedores, aplica el mismo enfoque: dimensiona el contenedor a partir de mediciones y no de una cifra publicada, y guarda los archivos de perfil en almacenamiento local rápido. Nuestra guía de implementación con Docker explica la configuración de contenedores con más detalle.
Preguntas habituales de los equipos
¿La protección de huellas garantiza el acceso a un sitio?
No. Mantiene coherente el entorno del navegador. Que un sitio acepte la sesión depende de sus propias políticas, de tu ritmo de solicitudes, de la calidad del proxy y de los términos que se apliquen a los datos. Conviene prever rechazos y tener un canal oficial para solicitar acceso cuando exista.
¿Por qué no basta con definir un User-Agent y unas pocas propiedades?
Porque esos valores son solo una parte de lo que una página puede leer. Un User-Agent cambiado junto a un renderizado, unas fuentes y unos ajustes regionales sin cambiar deja varias familias contando cosas distintas. Un perfil completo las describe juntas, y el navegador informa del mismo entorno en páginas, workers y contextos nuevos.
¿Tengo que definir la zona horaria, la configuración regional y el idioma a mano?
Normalmente no. Con un proxy configurado en el navegador, el modo auto deriva los tres valores de la IP del proxy. Los valores manuales sirven cuando se sabe que los datos de ubicación del proxy son incorrectos o cuando un flujo necesita una región concreta, y son una opción de nivel con licencia. Verifica el resultado con los pasos anteriores en cualquier caso.
¿Puedo usar mi código existente de Playwright o Puppeteer?
En general sí. La documentación describe cómo iniciar el ejecutable de BotBrowser con un perfil y un proxy desde cualquiera de los dos frameworks. Recuerda definir el proxy mediante los argumentos de inicio del navegador y no con la opción de proxy del propio framework, para que la alineación regional funcione como se documenta.
¿Necesito un perfil distinto para cada sesión?
No necesariamente. Usa tan pocos perfiles como requiera el trabajo autorizado, verifica cada uno y mantén juntos el perfil, la ruta y el almacenamiento durante la vida de una sesión. Conviene un perfil nuevo cuando el flujo deba representar una clase de dispositivo o una región distinta.
¿Es legal recopilar datos con protección de huellas?
La legalidad depende de la jurisdicción, del tipo de datos, de los términos de servicio del sitio y de normas como el RGPD o la CCPA. BotBrowser es una herramienta de privacidad, y los usuarios son responsables de asegurarse de que su recopilación esté autorizada y cumpla las normas aplicables.
Dónde encaja BotBrowser
En tus sesiones de recopilación autorizadas, BotBrowser puede derivar por defecto la zona horaria, la configuración regional y el idioma a partir de la IP del proxy (modo auto), de modo que se mantengan alineados con la región del proxy y entre sí, y la sesión informe una única identidad geográfica coherente. Así evitas la discrepancia habitual de un proxy en un país con un navegador configurado para otro. BotBrowser no puede garantizar que un sitio acepte la sesión ni resolver desafíos interactivos, y no controla la calidad ni los datos de geolocalización del proxy, el ritmo de las solicitudes, la política de cuentas ni los términos del sitio.
Usa las comprobaciones anteriores como rutina previa, guarda la configuración registrada junto a cada trabajo y reserva los cambios más profundos para los casos en que una comprobación falle. Para empezar con un perfil, descarga BotBrowser o contacta con el equipo de empresa para recibir ayuda de planificación en despliegues mayores.
Para seguir leyendo, consulta Perfiles de navegador multiplataforma para planificar perfiles entre sistemas operativos.
Fuentes
Artículos Relacionados
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.