Browserless frente a navegadores autoalojados
Un navegador gestionado entrega una sesión por CDP. Lo que no entrega es una identidad estable del navegador. Aquí está el límite, con sus límites documentados.
BotBrowser Team
Quieres la documentación estructurada de Despliegue?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Un navegador gestionado es un servicio que ejecuta el proceso del navegador y te entrega una conexión a él, y toda la decisión depende de qué partes del navegador controla. BotBrowser proporciona un perfil declarado que mantiene coherentes entre sí las superficies que una página puede leer en cada lanzamiento, y no puede sustituir una flota alojada, un intermediario de sesiones ni una cuota de concurrencia. El servicio publica más que un socket: el estado de sesión, la emulación de sistema operativo y las rutas reforzadas cubren capas distintas, y la capa que no cubren es la que decide si una sesión nueva se parece a la anterior.
Resumen
- Un navegador gestionado te da un navegador en ejecución por CDP o WebSocket; la automatización sigue siendo tuya y el resultado frente al control anti-bot también.
- Los servicios gestionados de scraping son otro producto: devuelven datos, no una sesión.
- Browserless documenta dos mecanismos de persistencia: la API de sesión guarda cookies,
localStoragey cache, y los perfiles autenticados añaden IndexedDB y dos cabeceras estables. - Su emulación de sistema operativo es un parámetro de consulta por sesión en rutas concretas, no un perfil almacenado; deja la zona horaria y el idioma a tu código o al proxy, y solo fija un viewport móvil con la persona Android.
browserless vs puppeteeres un error de categoría: uno es un servicio y el otro es la biblioteca con la que te conectas.- La facturación es concurrencia por tiempo, así que el punto de cruce frente al autoalojamiento es una cuestión de utilización, no de volumen.
- Un navegador autoalojado es la opción correcta cuando la identidad tiene que sobrevivir entre sesiones, compilaciones y máquinas; un navegador gestionado lo es cuando el trabajo no necesita una identidad.
Contenido
- Qué es un navegador gestionado
- Las tres arquitecturas en paralelo
- El estado de sesión no es identidad del navegador
- La comparación que no es una comparación
- Qué cobra realmente la factura
- Conclusión práctica
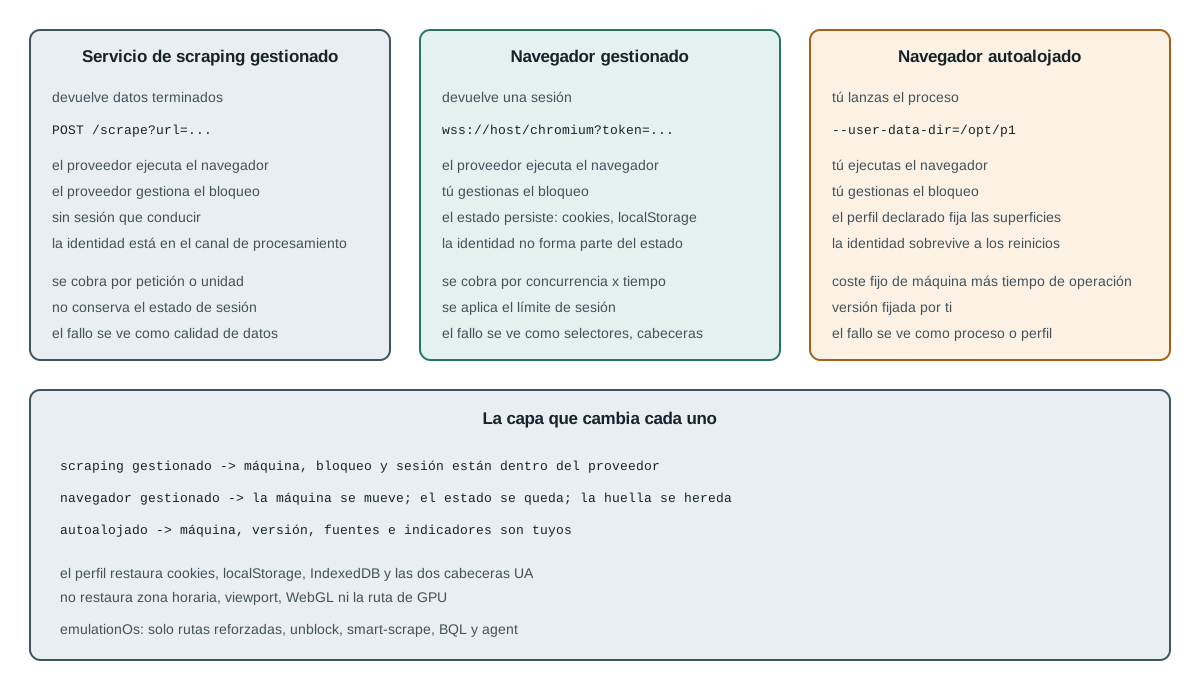
Qué es un navegador gestionado y qué no es
El servicio ejecuta un proceso del navegador en su propia infraestructura y lo expone mediante un protocolo que tu código ya habla. Browserless lo documenta como Browser-as-a-Service: conecta Puppeteer o Playwright a un endpoint WebSocket y conserva el script que ya tienes, con la cadena de conexión como único cambio. La misma cuenta también expone endpoints REST sin estado como /content, /scrape y /screenshot, donde una petición HTTP realiza una tarea del navegador y devuelve un resultado.
Esa división es lo primero que conviene mantener clara, porque las dos mitades tienen economías distintas y modos de fallo distintos. Un marco de agentes que envuelve un navegador añade una tercera capa, y cómo se reparten el trabajo un navegador gestionado y una capa de agentes es la misma pregunta un nivel más arriba.
BaaS endpoint      -> wss://.../chromium?token=...   session you drive; you own the code
REST endpoint      -> https://.../content?url=...    one request, one result, no session
self-hosted        -> chrome --user-data-dir=...     process on your machine
Lo que elimina la mitad gestionada es la superficie operativa: grupos de procesos, reinicios tras fallos, instalación de versiones y capacidad. Lo que no elimina es la capa de decisión. Sigues eligiendo el viewport, las cabeceras, el momento de la navegación y la política de reintentos, y sigues averiguando si el destino aceptó la sesión. Un navegador gestionado es otro lugar donde se ejecuta el navegador, no una conclusión distinta sobre si pasará. La misma división aparece cuando una página se arma con varias fuentes en tiempo de ejecución, y una tienda que mezcla API y datos renderizados lo muestra en un caso concreto.
El tercer producto de este espacio se confunde con facilidad con los dos anteriores. Un servicio de desbloqueo web o una API de scraping también ejecuta un navegador en el servidor, pero devuelve el resultado extraído en lugar de la sesión. Si lo que necesitas es una sesión que puedas conducir, ese producto tiene la forma equivocada por bien que funcione, y lo contrario también es cierto: automatizar un flujo página a página sobre un endpoint sin estado obliga a reconstruir el estado de sesión en cada llamada.
Una consecuencia práctica de la arquitectura es que tus herramientas locales de depuración siguen funcionando. Un endpoint WebSocket acepta los mismos mensajes del protocolo de herramientas de desarrollo que un navegador local, así que un script que registra tráfico CDP en local también lo registra contra el navegador remoto, y una traza capturada en un sitio se puede reproducir contra el otro. Lo que no se transfiere es el navegador: una extensión instalada en local, un conjunto de fuentes local o una ruta de GPU local existen solo donde están instalados, y la sesión remota tiene lo que el proveedor puso allí.
Las tres arquitecturas en paralelo
La distinción que importa en la operación es quién ejecuta el navegador, quién asume el resultado frente al control anti-bot y qué recibe de vuelta el código que llama.
| Servicio gestionado de scraping | Navegador gestionado | Navegador autoalojado | |
|---|---|---|---|
| Qué recibes | Datos terminados | Una sesión por CDP/WebSocket | Un proceso que lanzaste |
| Quién ejecuta el navegador | El proveedor | El proveedor | Tú |
| Quién gestiona el bloqueo | El proveedor | Tú | Tú |
| Identidad entre sesiones | No se expone | Estado, no huella | Lo que declare el perfil |
| Control de la versión del navegador | Elección del proveedor | Matriz del proveedor | Fijada por ti |
| Fallo que depuras | Calidad de los datos | Selectores, tiempos, cabeceras | Proceso, perfil, compilación |
Lee la tercera fila con atención, porque es la que cambia la decisión de compra. Un navegador gestionado mueve la máquina, no el problema: las rutas reforzadas de la documentación de Browserless se describen como modificaciones del comportamiento del navegador y por eso no son la opción predeterminada. Si un destino rechaza tu sesión, la sesión seguía siendo tuya para diagnosticarla.
La cuarta fila es donde los dos productos gestionados se diferencian de verdad, y donde el autoalojamiento se separa de ambos. Un servicio de scraping oculta la identidad porque la identidad está dentro de su canal de procesamiento; un navegador gestionado expone estado, que es algo más estrecho; un navegador autoalojado expone el navegador completo, y es el único de los tres donde la huella es una propiedad que fijas a propósito en lugar de una propiedad que heredas.
La fila de la versión merece un ejemplo, porque es la que los equipos descubren tarde. Un proveedor que actualiza su flota según su propio calendario cambia el renderizador bajo un script que no cambió en absoluto, y una aserción de diseño que pasaba el lunes puede fallar el miércoles por un motivo que ningún commit explica. El autoalojamiento tampoco hace desaparecer ese riesgo; lo convierte en una decisión que tú programas, que es un problema distinto y normalmente preferible. La fijación de versión con Chrome for Testing es el mecanismo que convierte eso en una decisión y no en un accidente.
El estado de sesión no es identidad del navegador
Browserless documenta dos formas de conservar cosas entre conexiones, y ambas merecen lectura justamente por lo que enumeran. La primera es un comando CDP que se llama a mitad del script, Browserless.reconnect, que marca el navegador en ejecución como reconectable para que el servidor mantenga abierto el proceso durante una ventana de tiempo; la documentación señala que es solo para Puppeteer porque necesita browser.disconnect(), y que Playwright carece de esa llamada. La segunda es una API REST de sesión que aprovisiona un directorio de datos de usuario aislado por sesión y conserva datos durante días entre reinicios completos del navegador.
standard session   -> process kept alive; window in seconds to minutes; Puppeteer only
persisting state   -> isolated user-data-dir per session; survives process restarts
La API de sesión persiste cookies, localStorage y cache, que es lo que enumera la página de resumen de sesiones. La función de perfiles autenticados va más lejos y nombra cookies, localStorage e IndexedDB, y excluye sessionStorage con el argumento documentado de que reproducirlo inyecta estado obsoleto en redirecciones OAuth y flujos CSRF. Esa exclusión es una decisión de ingeniería correcta para su propósito, y el límite que traza es la parte útil: lo que se restaura es el estado de la sesión iniciada y las cabeceras que el proveedor decidió conservar, no el navegador completo que lo produjo.
Las cabeceras son la parte que mantiene honesta la afirmación anterior. Un perfil guardado desde una sesión de Browserless también recuerda el User-Agent de ese navegador, y las sesiones que lo cargan presentan el mismo; las sesiones de creación de perfil y las sesiones Brave que cargan ese perfil envían un Accept-Language estable, mientras que las demás sesiones Brave conservan la variación incorporada de Brave. Así que un perfil no es solo almacenamiento, y la afirmación justa es que lleva un inicio de sesión guardado más las dos cabeceras que el proveedor documenta, no que no lleve ninguna identidad. Lo que sigue sin llevar es todo lo demás con lo que se calcula una huella.
El parámetro de emulación de sistema operativo muestra la misma separación de capas desde el otro lado. emulationOs fija un conjunto coherente de señales derivadas del sistema: user agent, client hints, navigator.platform, el renderizador WebGL, hardwareConcurrency y la lista de dispositivos multimedia. La documentación enumera después lo que no cambia, y la lista es la parte útil: la zona horaria, el idioma y Accept-Language siguen al proxy, y para las personas de escritorio el tamaño de pantalla y el viewport quedan en el cliente. El parámetro actúa en las rutas reforzadas, en las API REST de desbloqueo y de scraping, incluidas /unblock, /smart-scrape y sus variantes con prefijo de proveedor, en las rutas BQL y en la ruta agent, y se ignora en un endpoint /chromium o /chrome simple.
emulationOs=windows  -> changes: UA, client hints, navigator.platform, WebGL renderer
                     -> keeps:   timezone, locale, Accept-Language, viewport, WebRTC
emulationOs=android  -> also sets a high-DPI mobile screen and viewport
El valor Android es la excepción que hace preciso el comportamiento de escritorio. emulationOs=android sí fija el tamaño de pantalla y la proporción de píxeles como parte de una persona móvil coherente, con emulatedDevice como forma opcional de acotarla; las personas de escritorio dejan ambos a defaultViewport o setViewport. Leer la lista de cambios sin esa excepción lleva a una conclusión equivocada sobre las pruebas móviles.
Nada de eso es un defecto. Un servicio que tiene que ejecutar miles de sesiones por hora no puede dar a cada una un binario a medida, y el límite documentado es honesto sobre dónde termina su control. La consecuencia práctica es más estrecha y más útil: si tu requisito es que la misma identidad aparezca mañana, un inicio de sesión guardado más dos cabeceras estables es menos que eso, y las superficies restantes tienen que venir de otro sitio.
Hay una segunda consecuencia para quien prueba comportamiento multi-cuenta o multi-región. Un perfil que restaura un inicio de sesión es exactamente adecuado para retomar una cuenta, y es exactamente inadecuado para demostrar que dos cuentas son distinguibles, porque la parte que las distingue no es el almacenamiento que restaura. Probar esa propiedad exige dos entornos que difieran en las superficies declaradas y sean idénticos en todo lo demás, que es una comparación que una cookie guardada no puede expresar.
La comparación que no es una comparación
Dos de las frases de autocompletado en torno a este producto son browserless vs puppeteer y browserless vs playwright, y ninguna es una comparación de igual a igual. Puppeteer y Playwright son bibliotecas que conducen un navegador; Browserless es un lugar donde ese navegador se ejecuta. Preguntar cuál gana es como preguntar si un coche supera a una carretera.
La composición es la respuesta, y difiere entre bibliotecas de una forma documentada. Con Puppeteer, el flujo estándar de reconexión funciona porque existe browser.disconnect(). Con Playwright no funciona, y por eso la documentación dirige a los usuarios de Playwright a la API REST de sesión. Si tu pila es Playwright, esa es la forma que debes planificar; si es Puppeteer, ambas formas están disponibles.
Esa asimetría también tiene un coste fuera del límite del servicio. Un flujo de reconexión que depende de desconectar un navegador vivo supone que el cliente puede distinguir una desconexión limpia de un socket caído, y un script de Playwright que reintenta tras un error de socket no hace lo mismo que un script de Puppeteer que se desconecta a propósito. Antes de elegir un mecanismo de persistencia, conviene anotar a qué evento reacciona realmente el script: una desconexión explícita, un tiempo de espera agotado o un error de transporte. Solo el primero es una decisión de ciclo de vida; los otros dos son fallos, y tratar uno como el otro produce una sesión que sobrevive más de lo que la prueba pretendía.
La comparación con el autoalojamiento sí es real, y también es donde el intercambio queda más claro. Autoalojar significa que asumes el grupo, los reinicios, las actualizaciones de versión y la planificación de capacidad. Lanzar un navegador con un directorio de datos de usuario explícito, y mantener ese directorio estable entre lanzamientos, es lo que hace reproducible una identidad; errores de lanzamiento y perfil en Puppeteer cubre las cuatro decisiones de lanzamiento que mantienen autoritativo un perfil. En un servidor ese trabajo no desaparece, se desplaza: configuración de un servidor headless es la lista de comprobación para el display, el binario y el bucle de recuperación que un endpoint gestionado absorbe por ti.
Qué cobra realmente la factura
Ambos lados se pueden calcular sin citar el precio de nadie, porque las formas son distintas. Un navegador gestionado cobra concurrencia y tiempo de sesión; un navegador autoalojado cobra máquinas y las horas de ingeniería que las mantienen en marcha.
managed monthly   ~= peak_concurrency x hours_used x unit_price
self-hosted cost  ~= machines x amortised_hours + ops_hours_per_month x loaded_rate
El punto de cruce es, por tanto, una cuestión de utilización, y la fórmula anterior nombra los tres valores que hay que medir: peak_concurrency, hours_used y unit_price. Si la concurrencia máxima es alta pero la media es baja, un plan por unidad sigue a la media y gana, porque no pagas por máquinas inactivas. Si la carga es constante y la concurrencia es moderada, una máquina capaz de estar inactiva se cobra una vez y el segundo término domina, que es donde gana el autoalojamiento. Los techos publicados de los planes describen directamente el primer término, desde un nivel gratuito con dos navegadores concurrentes y un límite de sesión de dos minutos hasta cien navegadores concurrentes con un límite de sesenta minutos, lo que basta para calcular el lado gestionado de tu propia carga sin pedir un presupuesto a nadie.
En la misma aritmética entran dos términos más. Los reinicios no son gratis en ninguno de los dos lados: un endpoint gestionado los oculta, lo que significa que aparecen como una cola de latencia en lugar de como una partida, y un grupo autoalojado los muestra como capacidad que debes reservar. El almacenamiento es el otro, porque un perfil persistido consume una asignación que una petición sin estado no consume, y una carga que guarda un estado autenticado grande por identidad paga por ese estado aunque ese día no abra un navegador.
Dos costes son fáciles de dejar fuera de esa aritmética. El primero es el trabajo de identidad: si la carga necesita un navegador estable entre sesiones, ese requisito no está todavía en ninguna de las dos columnas, y satisfacerlo dentro de una sesión gestionada significa llevar el perfil tú mismo de todos modos. El segundo es el techo de sesión: una tarea que legítimamente dura más que el tiempo máximo de sesión del plan se convierte en otra tarea, dividida en piezas reanudables, y ese rediseño es trabajo independientemente de quién aloje el navegador.
Ninguna de las dos formas es la opción predeterminada. Una exportación nocturna que no necesita inicio de sesión es más barata y más simple en un endpoint gestionado; una flota de identidades de larga vida que deben verse igual en marzo y en abril es más barata y más simple en máquinas que controlas.
Conclusión práctica
Elige por la capa, no por el logotipo. Si el trabajo es una petición independiente, una API de scraping sin estado es el camino más corto. Si el trabajo necesita una sesión real pero no una identidad persistente, un navegador gestionado elimina la superficie operativa y sus límites de sesión publicados son las restricciones con las que hay que diseñar. Si el trabajo necesita que el mismo navegador sea reconociblemente el mismo la semana que viene, ese requisito está por debajo de la capa de estado, y tiene que ser asumido en algún lugar donde puedas fijar el binario, las fuentes y los indicadores de lanzamiento.
Dos comprobaciones hacen concreta la decisión. Primero, anota si el requisito es estado o identidad; la documentación de Browserless es explícita en que sus perfiles restauran cookies, localStorage, IndexedDB, User-Agent y Accept-Language, y explícita en que emulationOs deja intactos la zona horaria, el idioma y el viewport de las personas de escritorio. Segundo, calcula la concurrencia máxima frente a la media, porque esa proporción, y no el volumen mensual, es lo que decide qué factura crece más rápido.
Cuando una sesión falla en un endpoint gestionado, el diagnóstico sigue perteneciendo al cliente: qué selectores, qué cabeceras, qué momento de navegación, qué compilación. Para saber qué compilación está instalada y cómo fijarla, lee la fijación de versión con Chrome for Testing; para saber qué puede observar una página sobre la propia sesión, lee la comparación de señales entre headless y headed.
Fuentes
Este artículo forma parte de la guía: Despliegue y versión del navegador: mapa operativo
Artículos Relacionados
Web Unblocker y API de scraping: qué hacen y cuándo no
DespliegueAutomatización de navegador con Stagehand
DespliegueSeñales de automatización y coherencia en Playwright
DespliegueScraping de Shopify: ¿Storefront API, Ajax o navegador?
DespliegueServidor MCP de Puppeteer con un build propio
DesplieguePlanificación de capacidad de BrowserContext
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.