IA para web scraping: lo que el modelo no ve
Descubre cómo una herramienta de IA reduce los datos del navegador antes de entregarlos al modelo y cómo verificar un valor extraído sin confundir contexto con página.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
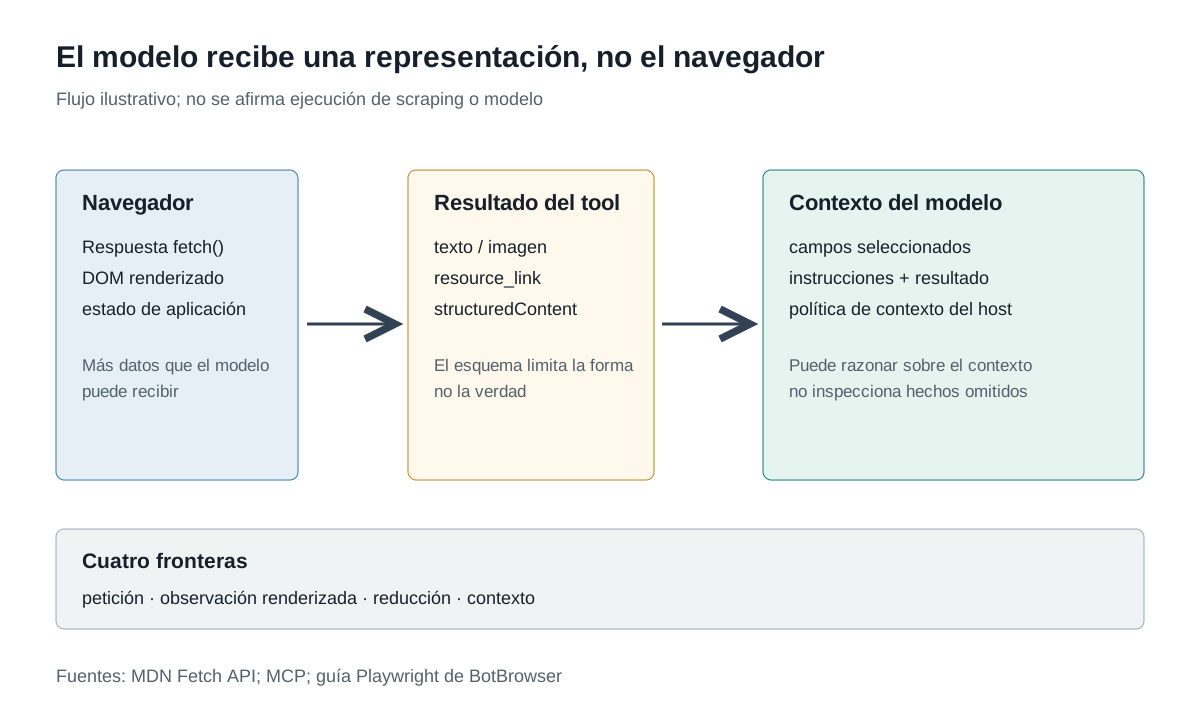
Un flujo de scraping asistido por IA puede devolver una lista ordenada de productos sin que el modelo vea nunca el estado completo del navegador que los produjo. Puede recibir una instantánea de accesibilidad, una extracción de texto, una captura, un objeto JSON seleccionado o un mensaje de herramienta. BotBrowser configura un proceso Chromium controlado con entradas documentadas de Playwright y perfil; no garantiza qué datos de la página envía la herramienta al modelo, qué conserva el modelo ni si el valor extraído es correcto. El contexto del modelo es una representación del trabajo, no el trabajo completo.
Esta frontera es distinta de elegir un servicio de scraping. La guía de evidencia de API de scraping pregunta qué decide un servicio por el llamador. El análisis de vigencia de decisiones pregunta si una observación sigue válida al ejecutar una acción. La frontera decisiva es qué sobrevive después de que el resultado del navegador o la herramienta entra en el contexto del modelo.
TL;DR
- Un navegador puede ejecutar una petición, renderizar una página y exponer muchos datos; un resultado de herramienta contiene solo lo que su implementación decide devolver.
- Que
fetch()devuelva unResponsesignifica que llegaron cabeceras, no que el estado HTTP sea exitoso ni que el cuerpo se haya analizado. - Las herramientas MCP pueden devolver texto, imágenes, audio, enlaces o recursos incrustados, con contenido estructurado y esquemas opcionales. Un esquema válido describe la forma, no la verdad.
- El contexto puede omitir un campo, una petición fallida, un elemento oculto, una redirección o una fila descartada sin que el modelo sepa que existe la omisión.
- Conserva procedencia para cada campo relevante: URL, método de obtención, versiones de navegador/herramienta, regla, validación y evidencia no devuelta.
- Verificar una afirmación puede requerir la respuesta original, una nueva observación propia, un endpoint de la aplicación o una decisión humana. El modelo no puede inventar la capa ausente.
Contenido
El modelo recibe una representación seleccionada
Imagina una página de productos construida como ejemplo. El navegador recibe HTML, ejecuta scripts, solicita datos de API y puede renderizar una lista virtual. La herramienta puede devolver una instantánea de texto con cinco nombres, una captura de la primera vista o un arreglo estructurado con título y precio. Estas salidas no son equivalentes: difieren en contenido, método y conclusiones posibles.
La especificación de herramientas MCP describe capacidades controladas por el modelo e invocadas con tools/call. Permite texto, imágenes, audio, enlaces a recursos y recursos incrustados, además de structuredContent JSON y esquemas de salida. La arquitectura MCP asigna la agregación de contexto y la integración de IA al host. Son reglas de protocolo y propiedad, no una garantía de que la herramienta devuelva el navegador completo ni que el modelo reciba cada byte.
| Frontera | Ejemplo construido | Qué puede saber el modelo | Qué queda fuera del contexto |
|---|---|---|---|
| Petición del navegador | Se solicitaron una página y una API | Solo lo que la herramienta informa | Traza completa, peticiones ajenas y tiempos originales |
| Página renderizada | Cinco tarjetas visibles y una plantilla oculta | La representación elegida por la herramienta | DOM fuera de pantalla, contenido inaccesible y estado de aplicación |
| Reducción de herramienta | [{title, price}] | Campos y metadatos devueltos | Filas descartadas, nodos fuente y criterio de selección |
| Contexto del modelo | El prompt contiene el arreglo | El arreglo y las instrucciones | Proceso del navegador, credenciales, caché y estado remoto interno |
La primera fila no se completa porque el navegador arranque correctamente. La guía de Playwright de BotBrowser muestra cómo se pasan ejecutable, perfil y proxy; esos inputs hacen explícito el entorno. No definen el esquema del resultado ni meten todas las observaciones en el prompt del modelo.
Un objeto Response no es una extracción exitosa
HTTP es un punto donde un resultado compacto puede ocultar una diferencia importante. La referencia Fetch API de MDN explica que fetch() resuelve a un Response cuando llegan las cabeceras, incluso si el estado HTTP es un error. El código debe revisar estado, cabeceras y cuerpo para decidir qué significa el resultado.
La recuperación y la extracción tienen criterios de aceptación distintos. La frontera entre rastreador y scraper evita que una URL recuperada se confunda con un registro validado antes de llegar al modelo.
La herramienta podría devolver este objeto construido:
{
  "ok": true,
  "items": [{ "title": "Example item", "price": 19.99 }]
}
ok: true indica que la herramienta eligió ese valor, no por qué. Puede significar que terminó la petición, que un analizador encontró un arreglo, que la página no lanzó una excepción o que una regla aceptó una fila. Son distintos límites de éxito. Un esquema puede validar el booleano y el arreglo, pero no decide si el resumen del modelo es verdadero ni si la página tenía más productos.
Por eso la especificación MCP distingue errores de protocolo y de ejecución, y pide a los clientes validar resultados antes de pasarlos al modelo. La validación reduce datos mal formados, no la pérdida de representación. El modelo puede razonar sobre lo recibido; no ve el Response original, la página completa ni los candidatos descartados salvo que la aplicación los conserve y los entregue.
La reducción elimina más que espacios
La extracción de texto normaliza espacios, elimina marcado y selecciona una región visible. Son operaciones útiles, pero cambian lo que se puede comprobar. En una cuadrícula con un panel de detalles, una instantánea puede conservar nombres visibles y omitir un precio solo presente en un tooltip. Una captura puede mostrar el precio sin clave de registro. Un JSON puede incluir el precio sin moneda, stock o revisión de página.
Reducir no es incorrecto por sí solo. La pregunta es si los hechos omitidos eran necesarios para la afirmación prevista. El seguimiento de precios necesita importe y moneda; la detección de cambios necesita clave y revisión; el índice de búsqueda necesita URL canónica y título. Un modelo que resume un arreglo no puede inventar de forma fiable campos que el extractor nunca incluyó.
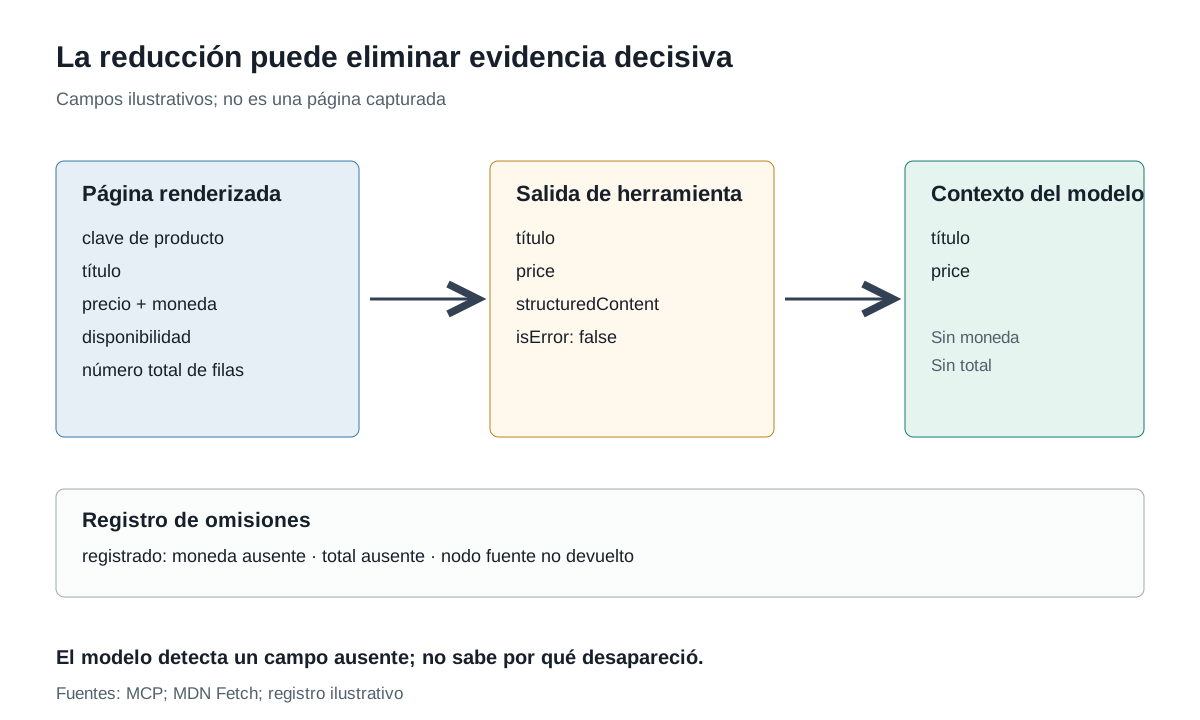
El contexto no debe describirse como un navegador en miniatura. Puede ser una instantánea de texto sin cabeceras, una imagen sin nodos DOM o un registro sin texto fuente. El resultado puede ser válido y aun así una descripción con pérdida. La respuesta correcta no es añadir todos los campos, sino nombrar los que respaldan la decisión y guardar la evidencia necesaria para verificarlos.
Un campo estructurado necesita historia de extracción
Un resultado con claves y tipos parece autoritativo, pero su historia importa más que su forma. Para el ejemplo price: 19.99, registra si procede de un selector, un rol, un campo JSON, una región OCR, una regla de texto o una entrada humana. Cada método tiene fallos y costes de verificación distintos.
| Método | Origen construido | Afirmación que apoya | Lo que no establece |
|---|---|---|---|
| Datos estructurados | Campo JSON de la aplicación | El analizador leyó el campo de esa respuesta | Que el producto esté disponible o el precio corresponda a la región |
| Instantánea DOM | Nodo de texto visible con moneda cercana | El texto apareció en esa representación | Clave estable o catálogo completo oculto |
| Imagen u OCR | Región de una captura | Los píxeles se parecían a un número | Valor original, marcado sin renderizar o todas las filas |
| Extracción por modelo | El modelo analizó un texto anterior | El modelo propuso el valor desde su contexto | Que la propuesta coincida con la fuente |
La cuarta fila va al final de forma deliberada. Un modelo puede extraer o clasificar una representación, pero su salida no prueba esa representación. Un esquema, una confianza o una segunda llamada son pruebas útiles; ninguna observa el navegador salvo que la herramienta realice una nueva observación. La página, la versión de herramienta y la regla deben acompañar al resultado.
El modelo no puede verificar lo que nunca recibió
El modelo puede comparar campos de su contexto. Puede detectar que falta currency o que un total contradice las entradas visibles. No puede detectar una fila descartada si la herramienta no informa un total, un cursor o una validación. No puede inferir un diagnóstico útil en una respuesta HTTP de error si solo recibe ok: false. No puede probar que un campo no existía en el navegador: solo que no estaba en la representación.
Es una limitación práctica de todo ciclo de extracción con modelos. El modelo puede proponer una consulta para obtener evidencia, pero el host decide si la herramienta puede ejecutarla y si el resultado es auténtico. El host MCP coordina contexto y conexiones; el navegador navega y renderiza; ninguno convierte automáticamente la respuesta remota en autoridad universal. La frontera de API de scraping ya separa el artefacto devuelto de la decisión interna del proveedor, y la misma separación se aplica al contexto del modelo.
Por eso cada campo decisivo necesita una fuente nombrada. En una página propia puede ser un JSON determinista más una comprobación de texto renderizado. En un flujo externo autorizado, un endpoint documentado o un registro confirmado por el operador. Si solo existe una imagen, debe permanecer visible que OCR es un valor derivado, no la página original.
Reconstruir la cadena del resumen a la fuente
Un resumen útil debe poder recorrerse hacia atrás. Empieza por la afirmación del modelo, identifica los campos citados, localízalos en el resultado de herramienta y llega a la observación del navegador o red que los produjo. Si falta un eslabón, el resumen puede ser una hipótesis, pero no un scraping verificado.
Considera la afirmación construida “la primera página contiene cinco productos y el más barato cuesta 19.99”. El lector debe poder preguntar: ¿qué llamada devolvió los productos? ¿cubrió todas las filas o solo la primera vista? ¿qué campo dio el precio y había currency? ¿qué comprobación independiente demuestra que página y herramienta coinciden? Repetir el número no responde.
También aparece un error de categoría: el modelo puede citar su frase anterior como si fuera una fuente. La repetición da estabilidad aparente sin añadir observación. La cadena debe terminar en una respuesta, una instantánea con método definido, una fixture determinista o un endpoint de la aplicación. Otro modelo puede revisar, pero no es evidencia original.
Mantén referencias compactas. Un digest del resultado, URL, marca temporal, ruta de campo y revisión de fixture pueden bastar en una prueba propia. No guardes credenciales, cookies o texto completo solo para aparentar una cadena completa. El objetivo es probar el campo reclamado, no conservar todos los bytes que pasaron por el navegador.
La comprobación inversa también importa. Si la herramienta devuelve un campo que el resumen omitió, no asumas automáticamente un error del modelo. La tarea pudo ser más estrecha o la política del host pudo excluirlo. Registra qué representación llegó y qué instrucción seleccionó el campo.
Por último, escribe el punto de parada. Una extracción verificada en una página no prueba la misma regla en otra región, idioma o cuenta. Un precio puede estar en una tarjeta y faltar en el detalle; un identificador puede ser estable aunque cambie la posición. Cada nuevo estado de la fuente es una nueva frontera y debe ejecutar la comprobación correspondiente.
Diseñar la verificación antes de escalar el modelo
Un registro compacto puede acompañar al resultado sin copiar la página. Debe nombrar el artefacto, la reducción y la primera pregunta pendiente:
| Campo | Valor construido | Propósito |
|---|---|---|
| Ejecución y fuente | run-04, https://example.test/products | Separa sesión y afirmación |
| Método de obtención | browser-json, screenshot-ocr, dom-snapshot | Nombra cómo se produjo la representación |
| Herramienta y esquema | catalog_extract@2, outputSchema-v3 | Mantiene versiones visibles |
| Campos seleccionados | title, price, currency | Muestra qué recibió el modelo |
| Evidencia omitida | full row count, pagination cursor | Convierte la ausencia en hecho explícito |
| Verificación | owned fixture v7 o endpoint | Nombra una comprobación independiente |
| Primera diferencia | price source field absent | Orienta la siguiente investigación |
No es una huella universal ni necesita contenido sensible. Hace visible la frontera de representación. Una síntesis del modelo puede ser útil, pero debe poder rastrearse hasta la herramienta y de allí a una observación definida. Si falta la cadena, la conclusión correcta es “no verificada de forma independiente”, no “la página no tiene ese valor”.
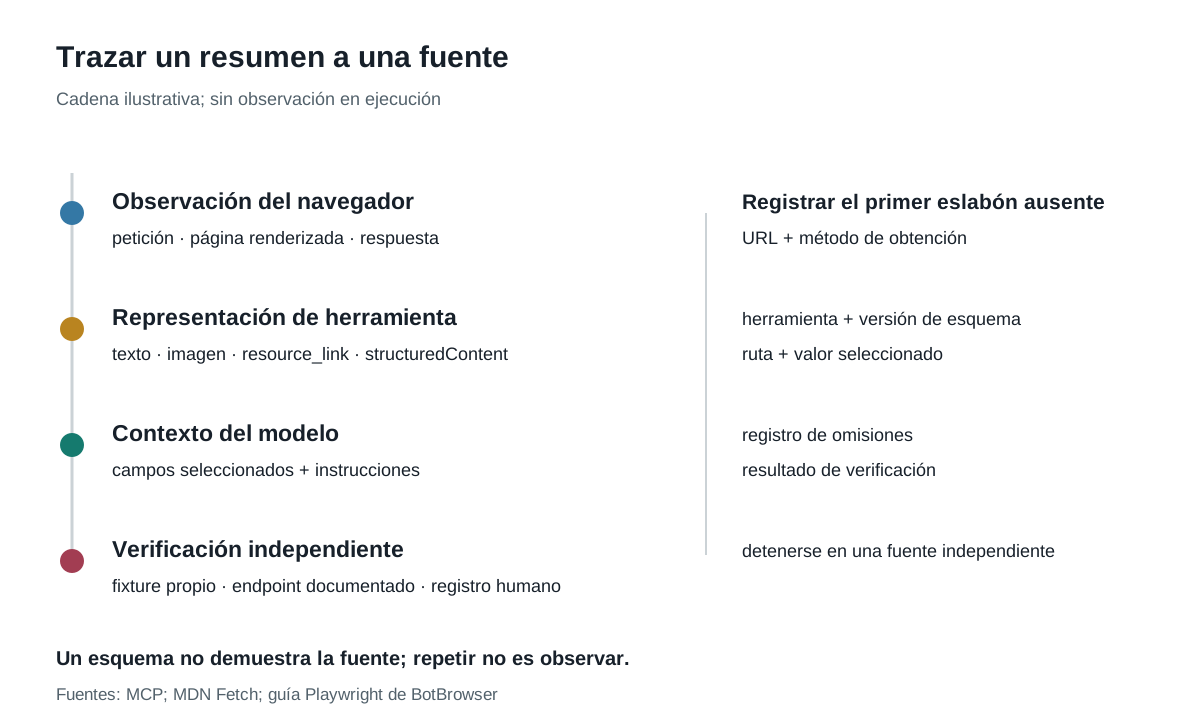
La verificación también limita coste y privacidad. Enviar una captura completa después de cada extracción conserva más detalle, pero puede exponer contenido personal ajeno y multiplicar el almacenamiento. Devolver solo los campos necesarios puede ser más seguro si la herramienta registra la reducción y la aplicación admite una comprobación. La meta es evidencia suficiente para la afirmación, no el máximo contexto.
Preguntas frecuentes
¿Un scraper de IA ve toda la página web?
No se deduce del nombre. El modelo ve la representación que el host o la herramienta le entrega: texto, imagen, objeto estructurado o un subconjunto de la observación del navegador.
¿Un resultado de herramienta exitoso es igual a un HTTP exitoso?
No. Fetch API puede resolver un Response antes de revisar el estado y la herramienta puede definir otro criterio de éxito. Separa protocolo, HTTP, análisis y aplicación.
¿Un esquema de salida prueba que el precio extraído es correcto?
No. Valida tipos y forma. La corrección requiere fuente, historia de extracción y un método de verificación adecuado.
¿Puede el modelo pedir la información que falta?
Puede proponer una llamada si el host la permite. El host controla permisos y la herramienta decide qué devuelve; el modelo no observa arbitrariamente el navegador o el servidor.
Fuentes
- MDN Fetch API
- Especificación de herramientas del servidor MCP
- Arquitectura MCP
- Configuración Playwright de BotBrowser
Conclusión práctica
Trata el contexto del modelo como una representación reducida producida por el navegador o la herramienta, no como una observación completa. Conserva fuente, método, versiones, campos seleccionados, omisiones conocidas y ruta de verificación. El modelo ayuda a interpretar lo que recibe; la aplicación debe probar los hechos importantes. BotBrowser puede hacer explícitos el proceso y los inputs del navegador, pero no rellena evidencia ausente, no hace verdadero un esquema ni garantiza un resultado del sitio.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
API de scraping web: lo que oculta la respuesta
DespliegueMCP para automatización: qué transporta el protocolo
Primeros pasosNavegadores headless para agentes de IA
DespliegueAgente de navegador: decisiones que caducan
Primeros pasosWeb crawler vs web scraper: resultados y fallos
Primeros pasosNavegador para web scraping: ¿qué tipo necesitas?
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.