MCP para automatización: qué transporta el protocolo
Distingue llamadas MCP, estado del navegador y contexto del modelo. Interpreta resultados estructurados, recursos y errores sin asumir una API universal.
BotBrowser Team
Quieres la documentación estructurada de Despliegue?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
MCP para automatización de navegadores conecta una aplicación de IA con las herramientas de un servidor; no transmite el navegador completo al modelo. Una llamada identifica una operación y aporta argumentos; la respuesta contiene las representaciones que el servidor decidió devolver. Las cookies, las pestañas abiertas y la memoria de página pueden permanecer en el navegador aunque la respuesta solo incluya un resumen breve. No existe una garantía de que permanezcan allí: una herramienta que devuelva datos sensibles puede transportarlos por el mismo protocolo. BotBrowser puede aportar el proceso Chromium controlado mediante un lanzador compatible, pero no proporciona un servidor MCP y no decide qué resultados entran en el contexto del modelo.
TL;DR
tools/listdescribe las herramientas disponibles ytools/callinvoca una por nombre. Ninguno define un vocabulario universal de acciones del navegador.- El
idde JSON-RPC relaciona una respuesta con una petición, no con una pestaña, cuenta o contexto del navegador. - Un resultado puede contener texto, imágenes, audio, enlaces a recursos, recursos incrustados y JSON estructurado. El host decide cómo llega ese material al modelo.
- La persistencia del navegador, la transmisión por protocolo y la visibilidad para el modelo son cuestiones distintas. Una respuesta pequeña no demuestra una sesión breve.
- Un error de protocolo y un resultado con
isError: trueson canales de fallo diferentes. Ninguno establece por sí solo si ocurrió una modificación en la aplicación.
Contenido
- Host, cliente, servidor y navegador tienen responsables distintos
- El descubrimiento describe una herramienta, no su implementación
- Qué contienen una llamada y su resultado
- El estado del navegador tiene una vida independiente
- Interpretar el canal de error antes de reintentar
- Elegir una representación y un límite de divulgación
- Conclusión práctica
Host, cliente, servidor y navegador tienen responsables distintos
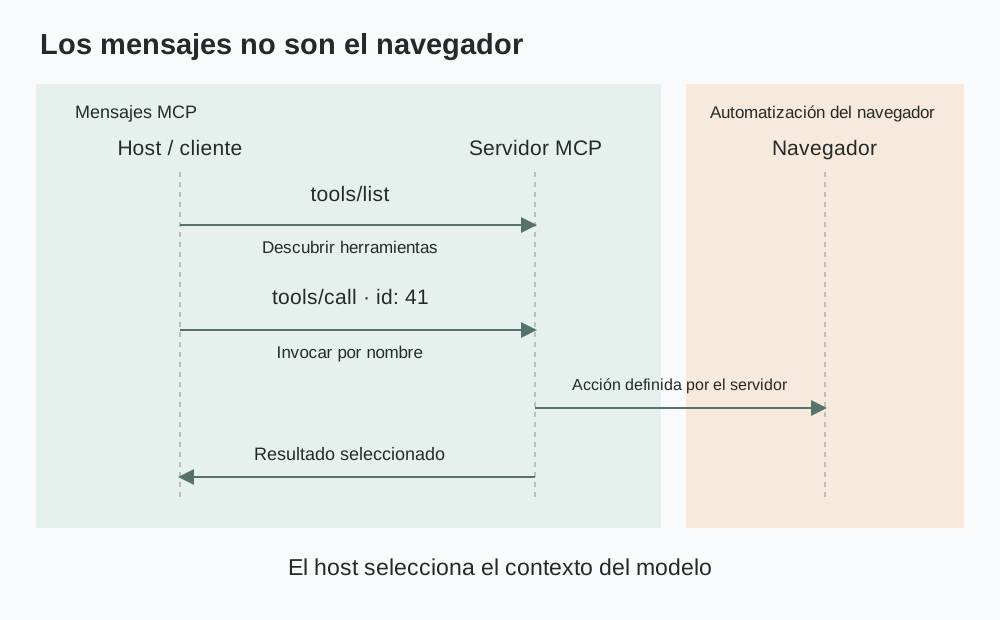
La especificación de arquitectura MCP distingue la aplicación host de sus clientes y servidores. El host gestiona la integración con la IA y la agregación de contexto. Un cliente mantiene una conexión con un servidor, que ofrece capacidades a través de ella. Después, un servidor de automatización controla un navegador mediante su propia implementación. MCP no sustituye la interfaz de automatización del navegador ni describe todos los comandos que el servidor envía a esa capa.
Por tanto, una aplicación puede tener una conexión MCP válida sin disponer de un navegador correctamente configurado. Inicializar el protocolo demuestra las capacidades negociadas de la conexión, no el ejecutable Chromium, el perfil o el estado de página. La configuración de Puppeteer MCP aborda el problema separado del lanzamiento. Esos ajustes pertenecen a la implementación del servidor y no al sobre estándar de tools/call.
La separación también opera en sentido contrario. El navegador puede renderizar correctamente una página mientras el host excluye una imagen del contexto del modelo. Una captura devuelta por la conexión demuestra un resultado de herramienta, no que un modelo concreto haya consumido sus píxeles. Para establecerlo hay que inspeccionar el ensamblado real del contexto y las modalidades admitidas por el host. El análisis de lanzamiento y responsabilidades del agente distingue la evidencia del proceso de los resultados visibles para el agente; aquí se añade el contrato del mensaje que cruza entre ambos.
La figura representa responsabilidades, no una captura de paquetes. Un despliegue real puede ejecutar el servidor localmente o en remoto. Sacarlo del portátil cambia dónde se operan el navegador y su almacenamiento, pero no elimina el control del host sobre la integración del modelo. Del mismo modo, un servidor local no demuestra que su salida siga siendo local cuando el host envía contexto a un servicio de modelos remoto.
La cuestión de despliegue no se limita a dónde se ejecuta el servidor. Importa quién controla cada copia: el directorio de estado del navegador, el resultado del servidor, el historial de conversación y cualquier petición posterior al modelo. Esas copias pueden tener políticas de conservación diferentes. La arquitectura host/cliente/servidor identifica responsabilidades; no certifica un plazo de conservación para cada implementación.
El descubrimiento describe una herramienta, no su implementación
La especificación de herramientas define tools/list para el descubrimiento. Cada herramienta tiene un nombre, un esquema de entrada e información descriptiva; también puede declarar un esquema de salida y anotaciones. La paginación importa: la primera respuesta puede incluir un cursor en lugar del catálogo completo. Ignorar las páginas posteriores puede dejar al host con una lista incompleta pese a mantener una conexión saludable.
El inputSchema describe los argumentos aceptados. No demuestra que el servidor aplique la autorización de la aplicación, que un elemento siga existiendo o que una persona haya aprobado la acción. Por ejemplo, una herramienta ilustrativa llamada fixture_read_status podría aceptar el identificador de una página de prueba pública. Ese nombre no es un estándar MCP: otro servidor puede exponer otro nombre y otros parámetros para la misma tarea de navegador.
Las descripciones ayudan al modelo a elegir herramientas, pero no constituyen una garantía ejecutable. La especificación advierte además que las anotaciones de servidores no confiables deben tratarse como no confiables. Que los metadatos describan una acción como de solo lectura exige comprobar la implementación y la autoridad reales; no concede un permiso por aparecer en el descubrimiento.
Hay tres preguntas de compatibilidad independientes:
| Capa | Contrato comprobado | Superar la comprobación no demuestra |
|---|---|---|
| Protocolo | Cliente y servidor comprenden los mensajes MCP negociados | Que exista una herramienta de navegador concreta |
| Catálogo | El nombre y el inputSchema coinciden con el llamador | Que el navegador use la sesión prevista |
| Aplicación | El destino actual y la acción autorizada coinciden con la tarea | Que éxito de transporte signifique éxito de tarea |
Un cambio de catálogo puede afectar la selección del modelo sin cambiar la versión del protocolo. Renombrar herramientas, ampliar argumentos o modificar descripciones altera la interfaz disponible. Conservar un catálogo versionado con la integración permite relacionar un fallo con los nombres y esquemas realmente descubiertos. Afirmar que ambos componentes admiten MCP es demasiado impreciso para diagnosticar un argumento rechazado por un servidor concreto.
Las herramientas también necesitan un alcance que el protocolo no puede inventar. Si hay varias pestañas, la definición debe explicar cómo se elige una. El id de petición no resuelve esa carencia. Dos peticiones con números distintos no quedan aisladas automáticamente en contextos diferentes. La selección de sesión pertenece a la semántica documentada de las herramientas, a la configuración del servidor o a otro contrato de aplicación.
Qué contienen una llamada y su resultado
Una petición tools/call incluye name y arguments dentro de un sobre JSON-RPC. El id permite relacionar la respuesta incluso si hay otras peticiones en curso. No es un identificador de sesión ni solicita por sí mismo un perfil nuevo. El intercambio siguiente es ilustrativo para una página de prueba propia; no es tráfico capturado ni la interfaz de un servidor de navegador identificado.
{
  "jsonrpc": "2.0",
  "id": 41,
  "method": "tools/call",
  "params": {
    "name": "fixture_read_status",
    "arguments": { "fixtureId": "public-status-7" }
  }
}
Una respuesta ilustrativa correcta puede incluir texto y contenido legible por máquina:
{
  "jsonrpc": "2.0",
  "id": 41,
  "result": {
    "content": [{ "type": "text", "text": "The public fixture is ready." }],
    "structuredContent": { "ready": true, "pendingJobs": 0 },
    "isError": false
  }
}
El structuredContent es un objeto JSON producido por el servidor. No es la función de salida estructurada del modelo ni demuestra que un LLM haya validado sus valores. Si la herramienta declara un outputSchema, la especificación exige al servidor una salida estructurada conforme y recomienda validación al cliente. El host puede validar antes de aceptar pendingJobs como campo numérico. Aun así, el esquema no demuestra que la observación sea reciente o veraz.
Las dos representaciones pueden contradecirse. Un texto que afirme que la página de prueba está lista junto a ready: false constituye un resultado contradictorio. No se resuelve escogiendo la mitad más conveniente. La aplicación necesita una regla de interpretación declarada o debe rechazar la inconsistencia. La validación es útil precisamente porque el transporte puede funcionar y el contenido no servir para la tarea.
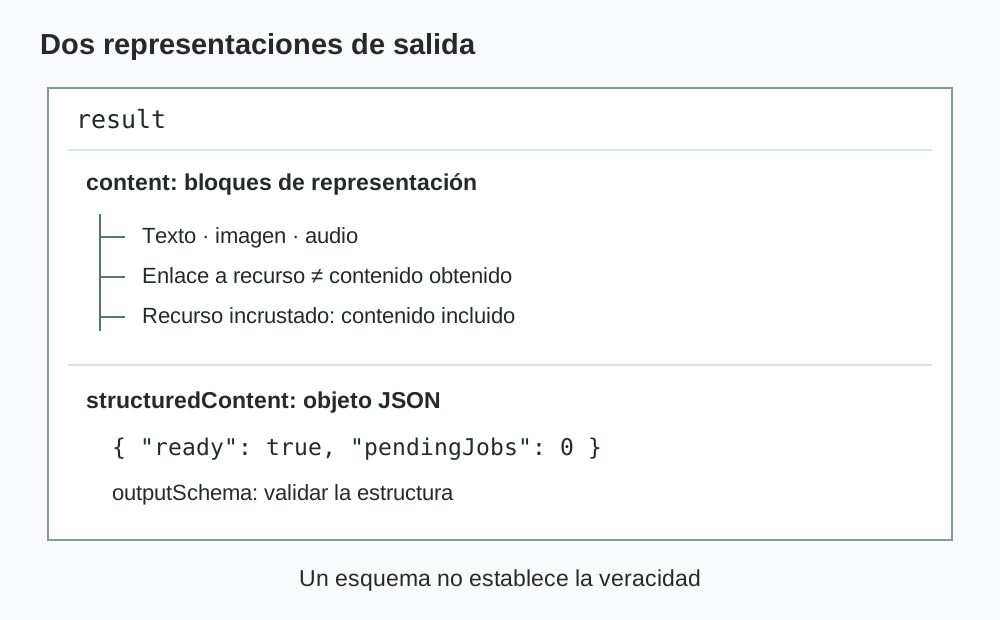
La matriz content admite más que texto. Imágenes y audio tienen formas propias; los enlaces a recursos remiten a material que no tiene por qué estar incluido en la respuesta, mientras los recursos incrustados sí llevan contenido. La especificación indica que los enlaces devueltos por herramientas no tienen por qué aparecer en resources/list. La ausencia en esa lista no demuestra que un enlace sea inválido; su presencia tampoco demuestra que se haya recuperado su contenido.
La distinción importa para contabilizar divulgaciones. Devolver un enlace, recuperar el archivo y enviar su contenido al modelo son eventos separados. Una auditoría que solo registre la respuesta original de tools/call puede omitir una consulta posterior al recurso. A la inversa, un registro con el URI de una captura no demuestra que sus bytes llegaran a la petición del modelo. Debe seguirse el tratamiento real, no estimar la divulgación a partir de un nombre de archivo.
El estado del navegador tiene una vida independiente
La documentación fijada de Playwright MCP ofrece un ejemplo concreto, no universal. Describe perfiles persistentes que conservan sesiones iniciadas y sesiones aisladas cuyo almacenamiento no persiste tras el cierre. También documenta la reutilización de un contexto entre clientes conectados. Esas opciones definen propiedad y duración del estado; no son consecuencias del número de petición JSON-RPC.
El servidor puede devolver un breve árbol de accesibilidad mientras el navegador conserva cookies y almacenamiento local. Las llamadas posteriores pueden observar páginas influidas por ese estado aunque ninguna herramienta haya devuelto explícitamente sus valores. El modelo puede recibir información específica de una cuenta sin recibir la cookie que la seleccionó. Excluir la credencial reduce una vía de divulgación, pero no convierte la representación resultante en datos no personales.
También importa la posibilidad opuesta. Una herramienta limitada a leer páginas y otra con evaluación o inspección de red amplia pueden exponer partes diferentes de la misma sesión. La documentación fijada incluye inspección de peticiones capaz de mostrar cabeceras y cuerpos. La visibilidad de datos sensibles depende de las capacidades habilitadas, la petición real y el tratamiento de resultados. Es incorrecto afirmar que los secretos nunca cruzan MCP porque el protocolo no tenga un campo llamado cookies.
Conviene distinguir tres ciclos de vida: conexión MCP, contexto del navegador y conversación del host. Cerrar una conexión no implica una promesa general del protocolo de destruir los otros dos. Un directorio persistente puede sobrevivir al reinicio del proceso y una conversación guardada puede sobrevivir a la eliminación del directorio. El modo documentado del servidor y la política del host determinan la relación efectiva.
En una tarea con cuenta, el contexto debe asignarse al trabajo autorizado antes de invocar herramientas. Si el servidor comparte contexto, abrir una conexión nueva no es un límite de aislamiento. Es una cuestión de configuración y responsabilidad, no un motivo para reescribir valores visibles en página. La integración Playwright de BotBrowser cubre la entrega explícita del ejecutable y el perfil; no promete aislamiento entre clientes MCP ni eliminación de conversaciones del host.
Interpretar el canal de error antes de reintentar
La especificación distingue errores de protocolo y errores de ejecución de herramientas. Una herramienta desconocida o una petición inválida puede representarse con un error JSON-RPC. Una herramienta que ejecuta y encuentra un fallo de tarea puede devolver un resultado con isError: true. En el segundo caso sigue existiendo un sobre result; interpretarlo siempre como acción correcta pierde la información de fallo proporcionada.
| Observación | Qué establece | Decisión de aplicación adecuada |
|---|---|---|
JSON-RPC error | La petición falló en el nivel de protocolo o despacho descrito | Revisar método, catálogo y argumentos antes de reenviar |
result.isError: true | La herramienta informó un fallo de ejecución | Leer el detalle y la semántica de la acción |
| Resultado válido sin el campo solicitado | Llegó una respuesta, pero falta parte del contrato de datos | Rechazar el campo ausente, no inventarlo |
| Desconexión después de iniciar una acción | No hay respuesta concluyente | Consultar el estado autoritativo antes de repetir una escritura |
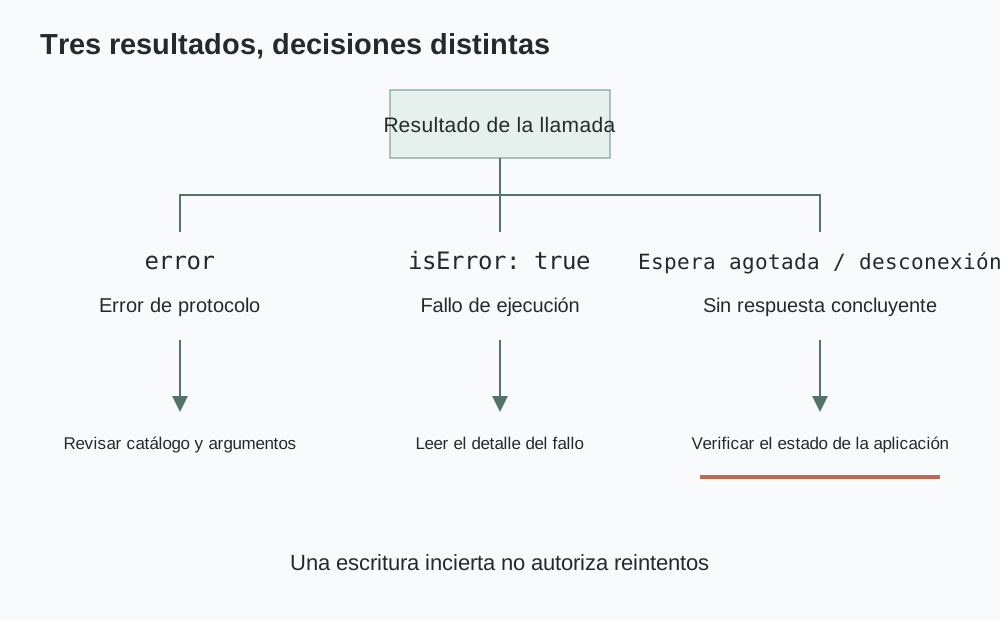
La última fila es una inferencia de aplicación, no una garantía especial de MCP. La conexión puede caer después de que un botón active una modificación en servidor y antes de que la herramienta responda. Ni un timeout ni la ausencia de respuesta demuestran que la modificación no sucedió. Para una escritura autorizada debe usarse el estado o mecanismo de idempotencia de la aplicación cuando exista. Si falta esa evidencia, corresponde a un operador resolver el resultado incierto, no al agente adivinarlo.
Incluso un error explícito necesita contexto. Una herramienta puede leer una página, intentar una interacción y fallar al obtener la captura final. El error puede referirse a la captura sin deshacer la interacción anterior. El canal indica que la ejecución no fue limpia; solo la semántica y la evidencia de aplicación determinan qué efectos permanecen. Reducir cualquier error a un booleano reintentable elimina esa distinción.
Los errores también afectan la divulgación. Una respuesta fallida puede incluir texto de página, consola o archivos de diagnóstico ausentes en el caso correcto. Debe revisarse la política de salida del fallo además de la respuesta normal. Guardar errores completos en una conversación duradera puede crear otra copia de información de cuenta aunque la salida habitual sea deliberadamente breve.
Elegir una representación y un límite de divulgación
El README fijado distingue las instantáneas de accesibilidad browser_snapshot y las capturas browser_take_screenshot, con opciones que controlan la representación. Un árbol de accesibilidad sirve para nombres, roles y referencias de controles; una captura conserva la distribución visual. Ninguno es un registro completo del estado. La captura puede omitir contenido fuera de su región y la representación accesible no garantiza la presentación visual exacta.
La elección depende de la decisión autorizada. Leer un estado público puede requerir un valor estructurado pequeño y su contexto de observación, no una imagen completa. Comparar diseños necesita evidencia visual, no una frase diciendo que se veía bien. Investigar una petición fallida requiere sus campos pertinentes depurados, no todas las peticiones del navegador. La minimización empieza en la salida del servidor, antes de que el host pueda recortarla.
El servidor no es el único control. El host puede seleccionar, reformatear o resumir la respuesta antes de añadirla al contexto del modelo. Hay que distinguir el resultado recibido del material realmente reenviado. Una petición más corta al modelo no elimina el archivo completo guardado antes por servidor u host. El almacenamiento y el reenvío requieren responsables separados.
La documentación fijada dice expresamente que Playwright MCP no es un límite de seguridad. También presenta la sustitución de secretos como una comodidad, no una función de seguridad, y las restricciones de archivos como medidas preventivas, no un sandbox seguro. Esas aclaraciones impiden tratar una interfaz amigable como un límite de permisos del sistema operativo. La autoridad del despliegue debe limitarse mediante permisos reales de proceso, archivos y cuentas.
Una comprobación local puede usar una página propia con un estado público, un campo deliberadamente ausente y un enlace inocuo. Deben inspeccionarse por separado la respuesta MCP sin procesar y el contexto ensamblado. Un resultado correcto puede demostrar que ese servidor devolvió la representación prevista y que ese host envió el subconjunto previsto en esa configuración. No certifica todas las herramientas, fallos desconocidos o la conservación de otro host. No se afirma haber ejecutado tal prueba de navegador o MCP; los ejemplos y figuras derivan de especificaciones y documentación fijada.
Preguntas frecuentes
¿MCP es lo mismo que Chrome DevTools Protocol?
No. MCP expone capacidades al cliente de una aplicación de IA. El servidor de navegador puede usar una biblioteca de automatización o un protocolo de navegador por debajo. El sobre MCP no obliga a entregar al llamador todos esos comandos o eventos.
¿Un enlace a recurso significa que el modelo recibió el archivo?
No necesariamente. Devolver un enlace, obtenerlo e incluirlo en contexto son operaciones diferentes. Hay que revisar el tratamiento de recursos del host y la petición real al modelo, no deducir la entrega del enlace.
¿Pueden dos clientes compartir un contexto con seguridad?
Solo cuando la política de tareas y cuentas permite compartirlo. Dos conexiones MCP no establecen por sí solas almacenamiento, pestañas o autorización separados. Una opción de contexto compartido debe evaluarse en la capa de estado del navegador.
¿Un esquema de salida vuelve confiable el texto de página?
No. outputSchema limita la forma del contenido estructurado. No convierte instrucciones de página en autoridad, no establece actualidad ni aprueba modificaciones. Validación de esquema y decisiones de confianza resuelven problemas distintos.
Fuentes
- Arquitectura MCP, revisión 2025-06-18
- Herramientas MCP, revisión 2025-06-18
- README de Playwright MCP fijado en a62ea28698af6d9bc89438bcec50c63377cef957
- Integración Playwright de BotBrowser
Conclusión práctica
MCP para automatización transporta invocaciones con nombre y representaciones seleccionadas, no una copia universal del navegador. Comprobar el esquema descubierto, validar la estructura devuelta y distinguir fallos de ejecución de efectos inciertos permite interpretar la respuesta. Antes de conectar un navegador con cuenta, hay que establecer qué herramientas exponen su estado, qué salidas reenvía el host y qué copias permanecen al cerrar la conexión.
Este artículo forma parte de la guía: Despliegue y versión del navegador: mapa operativo
Artículos Relacionados
Navegadores headless para agentes de IA
DesplieguePlaywright MCP con un build propio de Chromium
DespliegueServidor MCP de Puppeteer con un build propio
DespliegueAutomatización de navegador con Stagehand
DespliegueActualizaciones de service worker y coherencia de los clientes
Primeros pasosQué es un rastreador web: cinco etapas del rastreo
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.