Scraping legal y términos: qué debe decidir un equipo primero
Un registro de decisiones antes de recopilar: términos de la fuente, alcance de datos, carga de solicitudes y retención, con el punto exacto de revisión legal.
BotBrowser Team
Quieres la documentación estructurada de Primeros pasos?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
La mayoría de los proyectos de scraping empiezan con una pregunta técnica y descubren la pregunta de permiso más tarde, normalmente cuando alguien pregunta por qué la fuente bloqueó el trabajo. BotBrowser documenta automatización de navegador para trabajo autorizado y exige operar en sistemas propios o con permiso escrito explícito para probar. No decide si una recopilación es lícita, no concede permiso para recopilar y no sustituye una revisión de términos ni un asesoramiento jurídico.
TL;DR
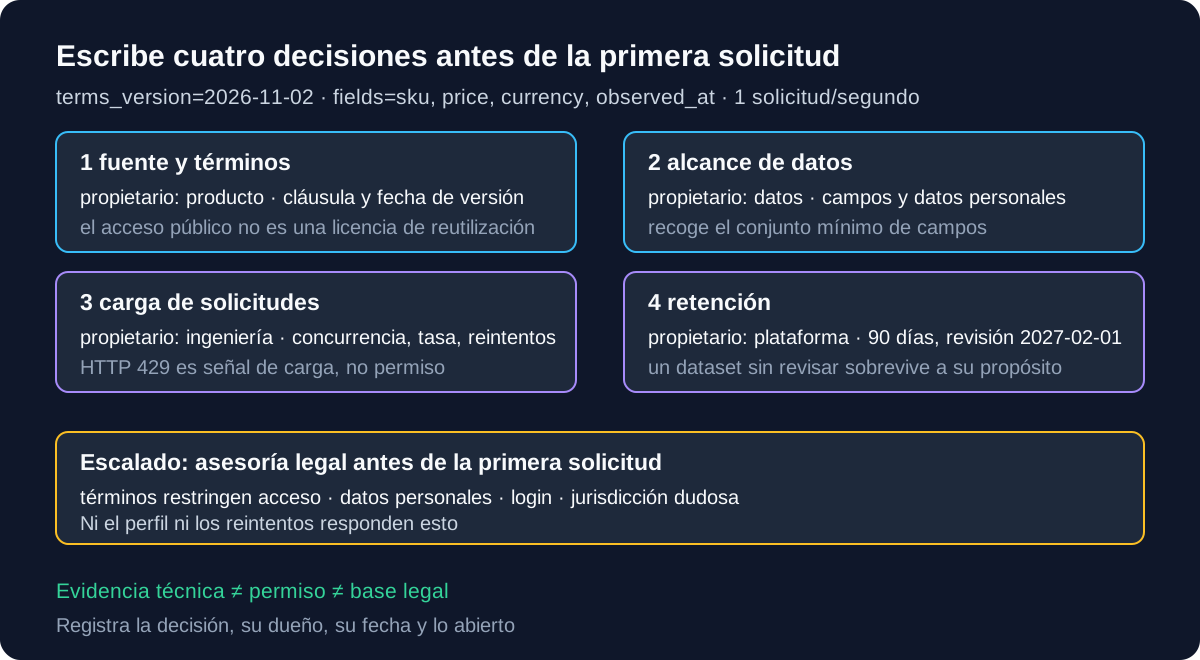
- Escribe cuatro decisiones antes de la primera solicitud: qué fuente y qué términos, qué datos, cuánta carga y cuánto tiempo se conservan.
- Una regla de robots, un límite de velocidad, un inicio de sesión y una decisión de autorización son cuatro cosas distintas. Superar una no dice nada de las otras.
- Un control técnico es evidencia sobre el comportamiento. No es una licencia, una cláusula contractual ni una base legal.
- Registra la versión de los términos de la fuente y la fecha en que los leíste, para que un cambio posterior sea visible en lugar de recordado.
- Escala a asesoría legal cuando la fuente restrinja el acceso automatizado, cuando los datos incluyan información personal o cuando la respuesta dependa de la jurisdicción. No resuelvas esas preguntas con un ajuste del navegador.
Contenido
- Cuatro decisiones antes de la primera solicitud
- Lee los términos a nivel de cláusula
- Escribe el registro de decisiones
- Separa el control técnico del permiso
- Conoce el punto de escalado
- Conclusión práctica
Cuatro decisiones antes de la primera solicitud
La primera decisión es de qué fuente recopilas y qué términos se le aplican. Los términos de servicio, un acuerdo de API, una política para desarrolladores y una licencia de datos públicos pueden decir cosas distintas, y pueden cambiar sin aviso. Registra el documento que leíste, su versión o fecha de actualización y la cláusula que importa. «El sitio parecía público» no es un registro de una decisión.
La segunda es qué datos necesita realmente el trabajo. Una página puede contener un precio, una reseña, una foto de perfil, un identificador de usuario y una marca de tiempo. Cada uno tiene una sensibilidad y una necesidad de retención distintas. Decide los campos antes del rastreo, no después de la exportación, porque una exportación amplia es difícil de reducir una vez que existe. Conserva el conjunto de campos más pequeño que responda la pregunta de negocio.
La tercera es la carga de solicitudes. La concurrencia, la política de reintentos, la ventana de rastreo y la tasa por origen pertenecen al registro, junto con los límites publicados por la fuente si existen. Una respuesta 429 es una señal sobre la carga, y la capacidad técnica de reintentar no hace aceptable una tasa más alta. El artículo sobre límites de velocidad y concurrencia para scrapers cubre la mecánica; este registro decide el presupuesto que la mecánica debe respetar.
La cuarta es la retención y el borrado. Decide dónde viven los datos, quién puede leerlos, cuánto tiempo permanecen y qué activa el borrado. Una recopilación sin decisión de retención tiende a volverse permanente por accidente. Registra el propietario y la fecha de revisión, porque un conjunto de datos sin revisar sobrevive al proyecto que lo justificó.
| Decisión | Registro | Atajo equivocado |
|---|---|---|
| Fuente y términos | Nombre del documento, fecha de versión, cláusula relevante, revisor | Suponer que el acceso público implica uso sin restricciones |
| Alcance de datos | Lista de campos, marca de datos personales, finalidad, nota de minimización | Exportar la página completa y decidir después |
| Carga de solicitudes | Concurrencia, tasa, ventana, tope de reintentos, límite de la fuente | Reintentar hasta que funcione |
| Retención | Ubicación de almacenamiento, lista de acceso, disparador de borrado, fecha de revisión | Conservar todo indefinidamente |
Lee los términos a nivel de cláusula
Una página de términos no es una sola frase. Suele contener una concesión de acceso, una lista de conductas prohibidas, una cláusula de propiedad intelectual, una limitación de responsabilidad y una cláusula de cambios. La cláusula que gobierna la recopilación automatizada puede estar en una lista de conductas prohibidas, en una sección de API o en un acuerdo para desarrolladores separado. Leer el titular no es lo mismo que leer la cláusula, y un resumen escrito por otra persona no es el documento.
Lee buscando cuatro cosas. Primero, ¿el documento aborda el acceso automatizado y usa palabras como rastrear, scrape, robot, medios automatizados o tasa? Segundo, ¿restringe la reutilización del contenido de forma separada al acceso, por ejemplo prohibiendo la redistribución o la creación de una base de datos derivada? Tercero, ¿exige una cuenta, una clave de API o un acuerdo escrito para los datos que quieres? Cuarto, ¿se reserva el derecho a cambiar los términos y dice cómo se notifica un cambio? Cada respuesta pertenece al registro con el número de cláusula y la fecha de versión.
Una licencia de datos públicos es un instrumento distinto de una página de términos. Una licencia abierta puede conceder derechos de reutilización que la página de términos no concede, y una página de términos puede restringir conductas que la licencia no menciona. Cuando existen ambas, registra ambas y anota cuál cree el equipo que gobierna el uso previsto. Esa creencia es una pregunta para asesoría legal cuando los documentos entran en conflicto; no es algo que un rastreador pueda resolver eligiendo la lectura más permisiva.
La misma disciplina se aplica a una API. Un acuerdo de API puede permitir las llamadas que documenta y prohibir otra recopilación, y un límite de tasa en la documentación es un límite operativo, no una afirmación sobre la reutilización legal. Registra la versión de la API, el endpoint, la cuota y la cláusula que permite el uso. Si el trabajo necesita un campo que la API no devuelve, eso es una pregunta de alcance, no una razón para volver al scraping de páginas sin una nueva decisión.
Las reglas de robots también merecen una lectura precisa. RFC 9309 define un mecanismo de coordinación para rastreadores que eligen participar. No crea una licencia, un contrato ni una base legal, y no anula una página de términos. Una línea Disallow puede indicar a un rastreador declarado que se mantenga fuera de una ruta; una línea Allow puede indicarle que la ruta no está prohibida. Ninguna de las dos respuestas resuelve si la recopilación está permitida, y por eso la decisión de robots y la de permiso ocupan filas separadas.
Escribe el registro de decisiones
Un registro útil es lo bastante corto para revisarlo y lo bastante específico para auditarlo. Una fila por decisión, un propietario nombrado, una fecha. El registro debe mostrar qué se decidió, qué evidencia lo sustentó y qué queda abierto. Un elemento abierto no es un fracaso; un supuesto no registrado sí lo es.
project=price-watch
source=https://shop.example.test
terms_version=2026-11-02
terms_clause=sections 4 and 9
fields=sku,list_price,currency,observed_at
personal_data=false
load=2 concurrent, 1 request/second, window 02:00-04:00 UTC
retention=90 days, owner=data-platform, review=2027-02-01
counsel_review=not_required (no personal data, no access restriction)
El registro es una afirmación sobre una decisión, no una prueba de que la decisión sea correcta. Si la fuente añade después una cláusula, o si el trabajo empieza a recopilar un campo que no fue aprobado, el registro queda desactualizado y el trabajo debe pausarse hasta revisarlo.
Un registro con un elemento abierto es más útil que un registro con una conjetura segura. Marca el elemento abierto, nombra a la persona que responderá y fija la fecha en la que el trabajo continúa o se detiene. Un trabajo que empieza mientras un elemento está abierto debe limitarse a un fixture sintético o a datos que el equipo ya posee, para que la pregunta sin resolver no se convierta en una recopilación de producción.
Mantén el registro legible por máquina donde el equipo ya tenga un esquema. Los nombres de campo siguientes bastan para un proyecto pequeño y pueden ampliarse sin cambiar el significado de los existentes.
| Campo | Tipo | Finalidad |
|---|---|---|
source | URL | El origen exacto y el alcance de rutas que el trabajo puede solicitar |
termsVersion | date | La versión o fecha de actualización del documento leído |
termsClause | string | La cláusula que gobierna el acceso automatizado o la reutilización |
fields | list | El conjunto de campos aprobado, no la página completa |
personalData | boolean | Si algún campo aprobado puede relacionarse con una persona |
load | object | Concurrencia, tasa, ventana y tope de reintentos |
retentionDays | integer | Cuánto tiempo pueden permanecer los datos recopilados |
owner | string | El rol responsable, no un buzón compartido |
reviewDate | date | Cuándo debe releerse el registro |
counselStatus | enum | not-required, requested, answered o stop |
El campo counselStatus es el que los equipos omiten. Sin él, un trabajo puede pasar de «preguntamos una vez» a «supusimos que estaba bien» sin que nadie lo note. Registra la pregunta que se hizo y la respuesta que llegó, incluida una respuesta de parada. Una respuesta de parada es un resultado válido y debe terminar el trabajo en lugar de provocar otro rodeo técnico.
Separa el control técnico del permiso
Los ingenieros suelen recurrir a una señal técnica como si resolviera la pregunta de permiso. No lo hace. Una solicitud exitosa muestra que el servidor entregó una respuesta. Una evaluación de robots aprobada muestra lo que dicen las reglas publicadas para un token declarado. Un inicio de sesión muestra que una cuenta se autenticó. Ninguno de esos es una licencia, un derecho contractual ni una base legal, y cada uno puede ser cierto mientras la recopilación sigue siendo inapropiada.
Lo contrario también es cierto. Una solicitud bloqueada no prueba que la recopilación esté prohibida, y un límite de tasa no establece un límite legal. El resultado técnico y la pregunta de permiso necesitan propietarios y evidencias separados. El registro de decisiones de robots.txt cubre el lado de las reglas del rastreador, y los límites de scraping de bolsas de empleo muestran la misma separación para una fuente concreta; mantiene explícitamente el permiso y la entrega HTTP como decisiones separadas, y esa separación es también el punto aquí.
La política de uso responsable de BotBrowser exige operar en sistemas propios o con permiso escrito para probar, y el aviso legal sitúa en el usuario el cumplimiento de la ley aplicable y los términos del servicio. Esos son límites de política del producto. No son una opinión legal sobre una fuente concreta, y leerlos no crea permiso para un trabajo.
Un control técnico también puede crear una falsa sensación de diligencia. Añadir un proxy, un retraso o un perfil rotativo cambia el aspecto de la solicitud; no cambia lo que el equipo tiene permitido hacer. Si un trabajo necesita esos controles para evitar una restricción declarada por la fuente, la restricción es la pregunta a resolver, no el control que hay que ajustar. La visión general de configuración de proxy explica qué puede y qué no puede cambiar una ruta; ninguno de esos cambios es un permiso.
Mantén tres conjuntos de evidencia separados en el registro. El conjunto técnico contiene códigos de respuesta, observaciones de tasa y resultados de fixtures. El conjunto contractual contiene la versión de los términos, la cláusula y cualquier aprobación escrita. El conjunto legal contiene la respuesta de asesoría, si se solicitó. Un revisor debe poder ver qué conjunto sustenta cada decisión, y ningún conjunto debe usarse para llenar el hueco de otro. Una respuesta 200 no puede llenar una cláusula ausente, y una cláusula no puede probar que una solicitud tuvo éxito.
Cuando una fuente publica una política legible por máquina, úsala como entrada, no como sustituto. Un archivo robots, una cabecera de cuota de API o una ventana de rastreo documentada indican lo que la fuente espera operativamente. Esas entradas pertenecen al plan de carga y a la decisión de robots. No eliminan la necesidad de leer los términos ni responden la pregunta sobre datos personales.
Conoce el punto de escalado
Algunas preguntas pertenecen a asesoría legal, y fingir lo contrario desperdicia tiempo de ingeniería y crea riesgo. Escala cuando los términos de la fuente restrinjan el acceso o la reutilización automatizados, cuando los datos incluyan información personal, cuando la recopilación cruce un inicio de sesión o un control de acceso, o cuando la respuesta dependa de la jurisdicción aplicable. Esas no son decisiones que puedan tomar un perfil de navegador, un proxy o una política de reintentos.
Lleva a asesoría una pregunta estrecha y la evidencia ya reunida: la fuente, la versión y cláusula de los términos, la lista de campos, el plan de carga, el plan de retención y la finalidad del negocio. Una pregunta precisa obtiene una respuesta útil; «¿podemos hacer scraping de esto?» invita a una advertencia general. Registra la respuesta y su fecha en el mismo registro de decisiones.
El escalado no es solo para la primera solicitud. Un campo nuevo, una fuente nueva, un periodo de retención más largo o un cambio en los términos pueden reabrir una decisión que estaba cerrada. Trata el registro como un documento vivo con fecha de revisión, y pausa la recopilación cuando cambie una entrada material.
La pregunta de escalado es más fácil de responder con ejemplos. La tabla siguiente muestra el disparador, la evidencia que hay que llevar y la decisión que queda con asesoría legal. Es una ayuda de enrutamiento, no una prueba legal, y un equipo debe añadir sus propios casos a medida que surjan.
| Disparador | Evidencia que llevar | Quién decide |
|---|---|---|
| Los términos prohíben el acceso automatizado | Cláusula, fecha de versión, uso previsto | Asesoría legal, con el propietario del producto |
| Los campos aprobados pueden identificar a una persona | Lista de campos, finalidad, plan de retención | Asesoría legal y el propietario de privacidad |
| El trabajo necesita un inicio de sesión o un control de acceso | Rol de la cuenta, alcance del permiso, cláusula de la fuente | Asesoría legal y el propietario de la cuenta |
| La fuente está en más de una jurisdicción | Ubicación de la fuente, del equipo y de las personas | Asesoría legal |
| La fuente ofrece una API para los mismos datos | Términos de la API, cuota, campos ausentes | Propietario del producto, luego asesoría si los términos chocan |
Un equipo puede preparar todo esto sin un abogado y aun así llegar al punto en que solo un abogado puede responder. Esa es la frontera prevista. El trabajo de ingeniería es hacer precisa la pregunta, reunir la evidencia y detener el trabajo mientras la respuesta está abierta. El trabajo legal es decidir la base aplicable. Mezclar ambos produce una recopilación no autorizada o un proyecto estancado que nunca recibe una respuesta clara.
Hay un segundo disparador de escalado que los equipos pasan por alto: un cambio en la fuente. Una cláusula nueva, un muro de inicio de sesión nuevo, una versión nueva de API o un cambio en los datos devueltos pueden invalidar una decisión que era correcta el trimestre pasado. Pon la fecha de revisión en el registro y trata el registro como caducado en esa fecha hasta que alguien relea la fuente. Un registro caducado no es una razón para seguir ejecutando; es una razón para pausar.
Conclusión práctica
Antes de la primera solicitud, escribe la fuente y su versión de términos, los campos y su sensibilidad, el presupuesto de solicitudes y la regla de retención. Asigna un propietario a cada uno. Mantén separadas la evidencia técnica y la de permiso, y envía a asesoría legal las preguntas que dependan de la ley o del contrato con el registro adjunto. Esa práctica no hará lícita una recopilación por sí sola, y no es asesoramiento jurídico, pero convierte un supuesto implícito en una decisión que un equipo puede revisar.
Preguntas frecuentes
¿Una página pública significa que los datos son libres de recopilar?
No. La disponibilidad pública describe quién puede ver una página, no lo que un equipo puede hacer con su contenido. Los términos de servicio, los derechos sobre bases de datos, las reglas de datos personales y los límites contractuales pueden aplicarse de forma independiente. Lee los documentos aplicables y registra la cláusula que gobierna el uso previsto.
¿Puede una regla Allow de robots.txt servir como permiso?
No. Una regla de robots es una instrucción de coordinación de rastreadores para un token declarado. No concede una licencia, un derecho de uso de datos ni una base legal, y no dice nada sobre datos personales. Mantén la decisión de la regla y la decisión de permiso en campos separados del registro.
¿Basta con detenerse cuando el sitio devuelve 403?
Detenerse es la respuesta operativa correcta, pero no es un análisis de permiso. Un 403 muestra que el servidor rechazó una solicitud; no establece por qué ni indica si otra ruta sería apropiada. Diagnostica el rechazo y luego revisa la decisión de permiso, en lugar de probar variantes hasta que una funcione.
¿Cuándo debe un equipo involucrar a un abogado?
Cuando los términos restrinjan el acceso o la reutilización automatizados, cuando haya datos personales, cuando la recopilación cruce un inicio de sesión o un control de acceso, o cuando la jurisdicción aplicable no esté clara. Lleva el registro de decisiones y una pregunta concreta; una solicitud general de aprobación rara vez produce una respuesta utilizable.
Fuentes
Este artículo forma parte de la guía: Primeros pasos con automatización de navegador: mapa inicial
Artículos Relacionados
Scraping con robots.txt: reglas, bloqueos y fallos de acceso
IdentidadRevisión de privacidad para proyectos de medición web
DespliegueScraping de bolsas de empleo: límites del navegador
Primeros pasosScraping con Playwright: navegador y perfil
ComparaciónRevisión de privacidad del navegador antes del lanzamiento
Primeros pasosScraping con Selenium: capacidades y registros
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.