TextDecoder y TextEncoder: bytes frente a cadenas
Decodifica bytes fijos con varias etiquetas: alias, BOM, byte inválido, por qué un trozo partido pierde un carácter y por qué difieren las longitudes de bytes y de cadena.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
BotBrowser soporta repetir un fixture autorizado del mismo origen bajo un perfil declarado y conservar observaciones acotadas sobre los bytes que una página codificó y la cadena que devolvió un decodificador, pero no puede hacer que TextEncoder emita una etiqueta distinta de UTF-8, no cambia a qué decodificador resuelve una etiqueta y no convierte un resultado de decodificación en una señal de identidad. Esta revisión decodifica un conjunto fijo de secuencias de bytes con varias etiquetas y registra cuáles son alias, cómo se trata una marca de orden de bytes, cuándo lanza el modo fatal en lugar de sustituir, por qué un límite de trozo pierde un carácter multibyte y por qué una longitud de bytes y una longitud de cadena discrepan para el mismo texto.
Resumen
TextEncoderes siempre UTF-8 e ignora cualquier etiqueta que se pase a su constructor;new TextEncoder({encoding:"latin1"}).encodingigual imprimeutf-8.- Las etiquetas
latin1,iso-8859-1ywindows-1252resuelven al mismo decodificador, así quecaféen bytes UTF-8 vuelve comocaféy no hay forma de saber qué etiqueta se escribió. - La marca de orden de bytes UTF-8 se elimina por defecto y solo se conserva con
ignoreBOM: true, así que los mismos bytes decodifican a una cadena o a dos según una opción que casi nadie fija. - Una decodificación no fatal sustituye un byte inválido por U+FFFD, mientras que
fatal: truelanzaTypeError; una secuencia multibyte truncada se convierte en un carácter de reemplazo sin error alguno. - Partir un carácter multibyte entre dos llamadas lo pierde salvo que se active
stream: true, y el resultado en flujo vuelve a unirse con la cadena original. - Un sustituto suelto se codifica como un único U+FFFD, así que un ida y vuelta puede cambiar el valor aunque cada llamada tenga éxito;
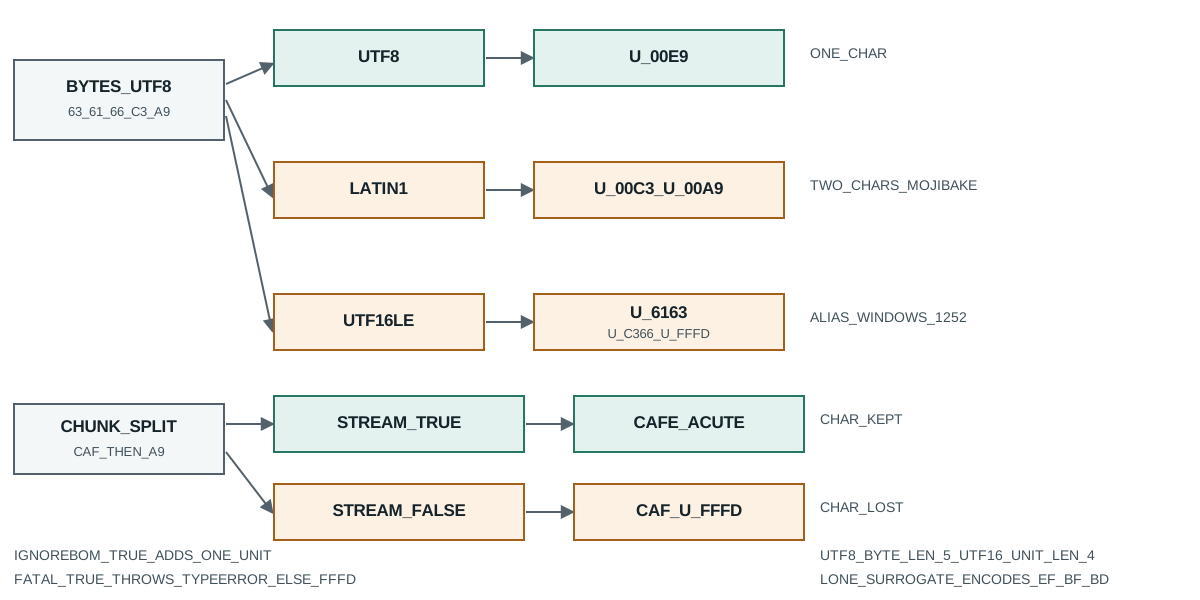
caféson cuatro unidades UTF-16 y cinco bytes UTF-8.
Contenido
- Qué etiqueta resuelve a qué decodificador
- Cómo se tratan una marca de orden de bytes y una secuencia inválida
- Por qué un límite de trozo pierde un carácter
- Dónde discrepan la longitud de bytes y la de cadena
- Registra una lectura de códec
Qué etiqueta resuelve a qué decodificador
El constructor recibe una etiqueta, no un nombre exacto de codificación, y el estándar asigna muchas etiquetas a un solo decodificador. La sonda decodifica los cinco bytes UTF-8 de café (63 61 66 c3 a9) con cuatro etiquetas e imprime la cadena que devuelve cada una:
TextDecoder=function TextEncoder=function node=v26.9.0
TextEncoder.encoding = "utf-8"
encode("café") -> 63 61 66 c3 a9
encode("😀") -> f0 9f 98 80
new TextEncoder({encoding:"latin1"}) -> "utf-8"
new TextDecoder("utf-8").decode(0x63 61 66 c3 a9) -> "café"
new TextDecoder("latin1").decode(0x63 61 66 c3 a9) -> "café"
new TextDecoder("iso-8859-1").decode(0x63 61 66 c3 a9) -> "café"
new TextDecoder("windows-1252").decode(0x63 61 66 c3 a9) -> "café"
new TextDecoder("utf-16le").decode(0x63 61 66 c3 a9) -> "慣썦�"
Dos hechos están en esas líneas. Primero, TextEncoder informa utf-8 sin importar qué etiqueta se pase; el objeto simplemente no tiene otra codificación, así que quien escribe latin1 y espera salida de un byte recibe salida multibyte y ningún aviso. Segundo, las tres etiquetas de un byte colapsan en un decodificador. latin1, iso-8859-1 y windows-1252 son alias en la tabla de etiquetas del estándar, y windows-1252 es el decodificador al que resuelven las tres. Decodificar bytes UTF-8 con cualquiera de ellas lee cada byte como un carácter, así que la secuencia de dos bytes c3 a9 se convierte en los dos caracteres à y ©.
Ese colapso es el origen del defecto clásico de texto mal codificado: un productor escribió UTF-8 y un consumidor declaró Latin-1, o al revés. El defecto no es un error de un lado solo; es una discordancia entre la etiqueta que usó un productor y la que asumió un consumidor. El resultado de dos caracteres es determinista y reversible, por lo que volver a decodificar los mismos bytes con UTF-8 restaura café exactamente. La comprobación que lo detecta es comparar la cadena decodificada con el texto esperado, no comparar longitudes de bytes, porque ambas formas del texto mal codificado ocupan el mismo número de bytes.
La cuarta etiqueta muestra lo que cuesta una familia equivocada. utf-16le lee los mismos bytes de dos en dos como unidades de 16 bits little-endian, así que 63 61 se convierte en un carácter, 66 c3 en otro, y el a9 sobrante en un carácter de reemplazo. Nada lanza. Quien recibe bytes de una fuente que produjo realmente UTF-16 y declara LE obtiene una cadena, solo que no la buscada, y quien declara el orden de bytes equivocado para UTF-16 real obtiene otra cadena distinta. La etiqueta forma parte del contrato de datos, así que un fixture que decodifica sin registrar la etiqueta ha registrado un resultado no verificable.
Hay una segunda lectura de esa línea que importa igual: el decodificador consumió un número impar de bytes. Un decodificador UTF-16 lee una unidad por cada dos bytes, así que una entrada de cinco bytes deja un byte sin pareja, y el decodificador convierte el byte suelto en U+FFFD en vez de descartarlo. El recuento de caracteres del resultado dice algo sobre la paridad de la entrada aunque la etiqueta pareciera válida. Un flujo que decodifica un cuerpo UTF-8 de longitud par con la familia de dos bytes equivocada ocultará esta señal, porque un recuento de bytes par no deja nada suelto y la sustitución que habría delatado la discordancia nunca aparece. La discordancia de etiqueta solo es barata de ver cuando además rompe la paridad de bytes, lo que es una forma frágil de detección.
Una etiqueta desconocida es el único caso que falla de forma ruidosa y no silenciosa:
new TextDecoder("utf-99") -> THREW RangeError
El constructor rechaza una etiqueta que no está en la tabla del estándar con RangeError, antes de leer un byte. Esa es la forma en la que un fixture debería confiar para una errata, porque nombra el problema en la construcción. Toda otra discordancia anterior devuelve una cadena y sigue, así que la única defensa fiable contra una etiqueta válida pero equivocada es afirmar el valor decodificado.
Cómo se tratan una marca de orden de bytes y una secuencia inválida
Una marca de orden de bytes son tres bytes al inicio de datos UTF-8 (EF BB BF) o dos al inicio de datos UTF-16 (FF FE para little-endian). El estándar trata la marca UTF-8 de forma especial: por defecto el decodificador la quita de la salida, y con ignoreBOM: true la deja. La sonda muestra ambos resultados para la misma entrada:
decode(EF BB BF 41) default -> "A"
decode(EF BB BF 41) ignoreBOM:true -> "A"
decode(FF FE 41 00) as utf-16le -> "A"
La primera línea decodifica una marca seguida del byte 41 (A) y devuelve el único carácter A. La segunda devuelve dos caracteres: un U+FEFF invisible seguido de A, así que result.length es 2 en vez de 1. Una comparación de las dos cadenas falla, una comparación de sus longitudes difiere en uno, y ninguna está mal; la opción decidió el resultado. Un consumidor que toma ignoreBOM de una configuración y un productor que no lo hace es exactamente la división que convierte una cadena correcta en dos desiguales.
La línea UTF-16 muestra la marca tratada por la misma regla dentro de otro decodificador: FF FE es la marca little-endian, el decodificador la consume, y el 41 00 restante decodifica a A. Un decodificador UTF-16 que espera el otro orden de bytes lee FF FE como una única unidad y produce un primer carácter distinto, así que la marca y el orden de bytes tienen que coincidir antes de que el texto lo haga.
Una secuencia inválida es una decisión aparte de una marca, y fatal la fija:
decode(A FF B) non-fatal -> "A�B"
decode(A FF B) fatal -> THREW TypeError
decode(E4 B8) truncated -> "�"
El byte FF no es válido en ningún punto de UTF-8. Sin fatal, el decodificador emite un U+FFFD en su lugar y continúa, así que el resultado es A, un carácter de reemplazo y luego B: tres caracteres para tres bytes de entrada, con uno sustituido. Con fatal: true los mismos bytes lanzan TypeError. Un flujo que no debe recibir texto corrupto debería fijar fatal, porque el resultado no fatal es una cadena válida que difiere en silencio de la entrada.
El caso truncado es el que más sorprende. E4 B8 son los dos primeros bytes de un carácter de tres bytes, y el decodificador no puede completarlo al final de la entrada, así que emite un carácter de reemplazo. No se lanza ningún error aunque los datos estuvieran cortos. Por eso una comprobación de recuento de bytes pasa con entrada truncada: el decodificador siempre devuelve una cadena, y solo el valor revela que se perdió un carácter.
Por qué un límite de trozo pierde un carácter
Una respuesta de red, una lectura de archivo y un mensaje de worker llegan en trozos, y un límite de trozo puede caer en medio de un carácter multibyte. TextDecoder tiene dos modos para eso, y la sonda parte los cinco bytes UTF-8 de café tras cuatro bytes, así que el primer trozo termina en el primer byte del é de dos bytes:
stream split mid-sequence: first="caf" second="é"
non-stream split mid-sequence -> "caf�"
La ruta sin flujo decodifica cada trozo como una unidad completa. El primer trozo es caf más el byte c3, que inicia un carácter de dos bytes cuyo resto el trozo no contiene, así que el decodificador convierte el c3 suelto en un carácter de reemplazo y devuelve caf seguido de U+FFFD. La é desaparece. La ruta en flujo con stream: true guarda el c3 final en vez de sustituirlo, así que la primera llamada devuelve caf, la segunda recibe a9 y devuelve é, y los dos resultados concatenan a café.
Por eso cualquier decodificador que lea un flujo debe pasar stream: true en cada trozo menos el último, y llamar al decodificador una vez más sin argumento para vaciar el resto. Un bucle que decodifica cada trozo sin la opción pierde un carácter en cada límite que cae dentro de una secuencia multibyte, y la pérdida es silenciosa: la longitud total encoge en una o más unidades y cada llamada devuelve una cadena. Un fixture que compara el resultado concatenado con la cadena original lo detecta; uno que solo comprueba que la decodificación tuvo éxito no.
El mismo mecanismo aparece cuando una página lee un ReadableStream y decodifica de forma incremental, y cuando un worker reensambla un mensaje. En ambos casos la solución es la misma opción y un vaciado final, y el fallo sin él es un número fijo de caracteres de reemplazo igual al número de secuencias partidas. El recuento es un diagnóstico útil: un carácter de reemplazo en un límite de trozo significa una partición, y una serie de ellos significa que los trozos no estaban alineados con el ancho del carácter.
Un vaciado final es fácil de olvidar porque cada llamada intermedia ya devolvió una cadena. Tras el último trozo, un decodificador que aún guarda bytes finales debe llamarse una vez sin entrada, y solo esa llamada emite el carácter que completan los bytes guardados. Un bucle que se detiene tras el último trozo deja el resto dentro del decodificador, así que la salida unida queda corta en los caracteres que esos bytes habrían producido. Un fixture que compara la salida unida con el original detecta la omisión; uno que solo comprueba que ninguna llamada lanzó no, porque ninguna lo hizo.
Dónde discrepan la longitud de bytes y la de cadena
TextEncoder escribe UTF-8, así que la longitud de bytes de una cadena es su longitud UTF-8, no su longitud UTF-16. Las dos coinciden solo para texto hecho de caracteres por debajo de U+0080. La sonda mide cuatro cadenas de ambas formas:
"hello" stringLength=5 byteLength=5
"café" stringLength=4 byteLength=5
"中文" stringLength=2 byteLength=6
"😀" stringLength=2 byteLength=4
Para hello, cinco caracteres ASCII cuestan cinco bytes porque cada punto de código ASCII es una unidad y un byte. Para café, las cuatro letras cuestan cinco bytes porque é es una unidad UTF-16 pero dos bytes UTF-8. Para los dos caracteres CJK, dos unidades cuestan seis bytes porque cada uno es tres bytes en UTF-8. Para el emoji, dos unidades UTF-16 (un par sustituto) cuestan cuatro bytes, porque un punto de código por encima del plano básico son cuatro bytes UTF-8. Un límite de almacenamiento expresado en bytes y un límite de visualización expresado en caracteres por eso discrepan por un factor distinto para cada escritura, y un presupuesto escrito para ASCII rechaza o acepta la cantidad equivocada de texto no ASCII.
El productor de esos bytes suele ser una vista sobre un ArrayBuffer, y ArrayBuffer y TypedArray muestra por qué los mismos ocho bytes informan longitud de bytes 8 bajo un Uint8Array pero longitud de elementos 2 bajo un Uint32Array, y por qué un alias subarray guardado muere cuando el búfer del origen se reutiliza.
El caso del sustituto lleva una segunda discrepancia, porque un sustituto suelto no es texto válido y TextEncoder lo reescribe:
encode(lone high surrogate) -> ef bf bd
round trip lone surrogate length=1 equal=false
Los bytes codificados son ef bf bd, un U+FFFD, porque un sustituto suelto no tiene forma UTF-8. Decodificar esos bytes devuelve un único carácter de reemplazo, así que la longitud de cadena coincide con la longitud de entrada de uno, pero el valor difiere y la comprobación de igualdad es falsa. Un ida y vuelta puede por eso conservar la longitud y cambiar el valor a la vez, y por eso una comparación de longitudes no es una prueba de ida y vuelta. Partir una cadena en un índice arbitrario crea exactamente esta forma, porque un corte dentro de un par sustituto deja una mitad suelta.
Registra una lectura de códec
Una lectura de códec sostiene una afirmación estrecha: este entorno, esta etiqueta, esta opción, esta entrada produjeron esta cadena. Seis campos la mantienen verificable, y ninguno guarda texto que un decodificador pudiera reinterpretar:
- La etiqueta pasada al decodificador y el orden de bytes que implica, porque varias etiquetas son alias y una etiqueta puede leer bytes de dos formas.
- La entrada como secuencia de bytes, no como texto renderizado, porque dos secuencias de bytes distintas pueden renderizar igual y una secuencia puede leerse con varias etiquetas.
- Si se fijó
ignoreBOM, porque cambia la longitud de cadena en uno para los mismos bytes. - Si se fijó
fatal, porque decide entre un error lanzado y un carácter de reemplazo sustituido. - Si se fijó
streampor trozo y si corrió un vaciado final, porque ambos deciden si sobrevive un carácter partido. - La longitud de bytes UTF-8 y la longitud de unidades UTF-16 registradas por separado, porque los dos números responden preguntas distintas sobre el mismo texto.
Lo que tal lectura no puede mostrar es nada sobre los bytes antes de llegar. Un decodificador recibe una secuencia de bytes; no dice si el productor escribió UTF-8, Latin-1 o UTF-16, y una discordancia entre productor y consumidor es la causa más común del texto mal codificado de arriba. Para la pregunta más amplia de cómo una página informa texto que vino de otra capa, consulta normalización Unicode y señales de identidad de texto, que cubre por qué dos representaciones del mismo texto visible comparan desiguales, y límites de btoa y atob, que cubre la ruta de codificación de un byte más antigua que lanza con el mismo texto no ASCII que UTF-8 acepta.
Dos hábitos mantienen la lectura honesta con el tiempo. Primero, registra la etiqueta y las opciones junto a la cadena decodificada en vez de la cadena sola, porque una cadena desnuda no se puede volver a derivar sin saber qué opciones la produjeron. Segundo, compara el valor decodificado con el esperado y, para un ida y vuelta, compara la cadena original con el resultado decodificado en vez de comparar longitudes, porque un carácter de reemplazo y la unidad original pueden ocupar la misma longitud difiriendo en valor.
Fuentes públicas
- MDN: TextEncoder
- MDN: TextDecoder
- MDN: TextDecoderStream
- Estándar WHATWG Encoding
- Anexo 15 del Estándar Unicode: formas de normalización
- BotBrowser: referencia de consistencia de automatización
Conclusión
Trata la etiqueta como parte del contrato de datos: latin1, iso-8859-1 y windows-1252 resuelven a un solo decodificador, TextEncoder es siempre UTF-8 e ignora cualquier etiqueta que pases, y una etiqueta desconocida es la única que lanza en la construcción. Elige ignoreBOM a propósito y elige fatal cuando el texto corrupto no deba pasar en silencio. Decodifica flujos con stream: true y vacía el resto, o un carácter multibyte partido se vuelve un carácter de reemplazo. Registra la etiqueta, los bytes, las opciones y ambas longitudes por separado, y compara el valor decodificado en vez de la longitud para que un sustituto suelto que se codifica como un U+FFFD no pase una comprobación verde.
Lectura siguiente
Para ahondar en la capa de texto, normalización Unicode y señales de identidad de texto da las varias longitudes y órdenes de una cadena visible, y límites de btoa y atob da la forma más antigua de meter bytes en una cadena y dónde falla con texto no ASCII.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
btoa y atob: límites Latin-1 y la verdad sobre el relleno
Huella digitalArrayBuffer y TypedArray: un búfer, muchas vistas
Huella digitalUnicode: cuatro identidades de texto que lee una página
Huella digitalua-parser-js: Client Hints, bots y un tope de 500
Huella digitalAnálisis de URL y search params: qué cambia el viaje
Huella digitalKeyboard Layout API, preferencias regionales y privacidad
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.