Análisis de URL y search params: qué cambia el viaje
Analiza URL raras y cadenas de consulta para ver dónde lanza new URL, qué reescribe la normalización, cómo van las claves duplicadas y el orden, y por qué set no es asignar.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
BotBrowser soporta repetir un fixture autorizado del mismo origen bajo un perfil declarado y conservar observaciones acotadas sobre qué URL analizó una página y qué reescribió el analizador, pero no cambia cómo un entorno implementa el algoritmo URL de WHATWG, no puede resolver una cadena relativa sin base y no convierte una URL normalizada en una señal de identidad. Esta revisión analiza un conjunto de URL y cadenas de consulta incómodas, y luego registra exactamente dónde lanza new URL, qué caracteres reescribe la normalización, cómo sobreviven las claves duplicadas y los signos más, y por qué fijar un parámetro de búsqueda difiere de asignar una cadena de búsqueda cruda.
Resumen
new URLcon una cadena relativa y sin base lanzaTypeError. La misma cadena se resuelve contra una base, y los espacios en la ruta se vuelven%20.- Analizar es normalizar, no identidad:
HTTPS://Example.TEST:443/a/../b/./cse vuelvehttps://example.test/b/c, quitando el puerto por defecto y resolviendo los segmentos con punto. URLSearchParamsconserva claves duplicadas, trata+como espacio y codifica&e=dentro de un valor al serializar.sort()reordena por clave; el orden de inserción se conserva hasta que se llama, así que un viaje puede cambiar la cadena sin cambiar los datos.searchParams.setcodifica un valor de forma distinta a asignarurl.searchen crudo: el primero codifica los espacios con porcentaje, el segundo los deja al analizador.
Contenido
- Dónde lanza new URL y dónde lo salva una base
- Qué reescribe la normalización
- Claves duplicadas, signos más y codificación de valores
- Orden y el coste de un viaje
- Fijar un parámetro frente a asignar search
- Registra una lectura de URL
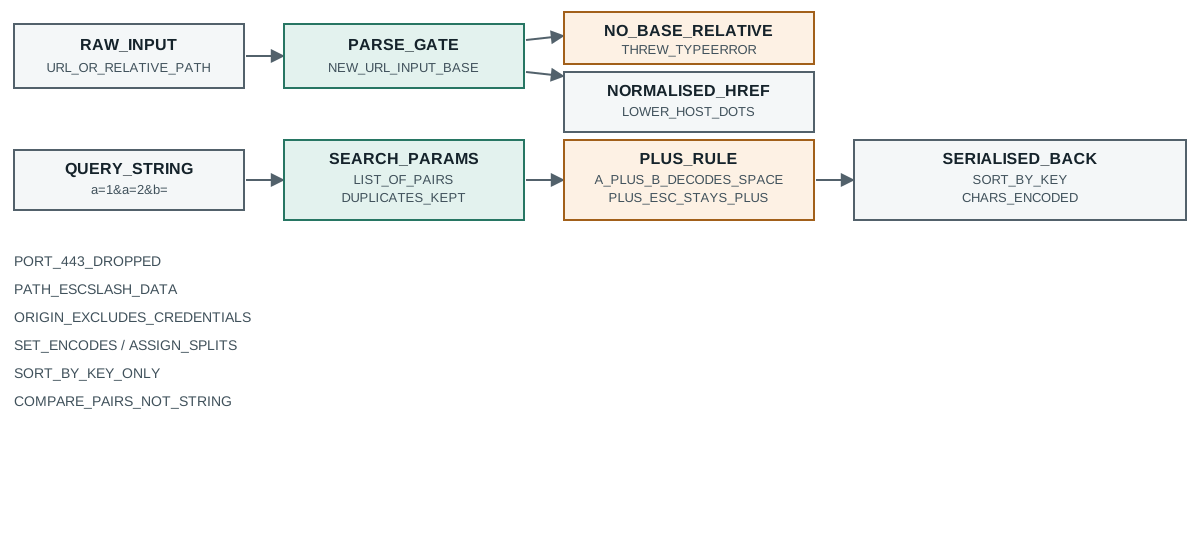
Dónde lanza new URL y dónde lo salva una base
El constructor tiene dos formas, y solo una puede resolver una referencia relativa. Sin base, la entrada ya debe ser una URL absoluta; una cadena de solo ruta no tiene a qué unirse y el analizador lanza: Una URL analizada también es un valor que debe copiarse antes de guardarse, y structuredClone frente a JSON muestra qué tipos y referencias conserva una copia profunda y cuáles descarta un viaje por JSON en silencio.
new URL("/a/b?x=1", undefined) -> "THREW TypeError"
new URL("/a/b?x=1", "https://example.test") -> "https://example.test/a/b?x=1"
new URL("a b", "https://example.test/dir/") -> "https://example.test/dir/a%20b"
new URL("../../x", "https://example.test/a/b/c") -> "https://example.test/x"
La primera línea es el defecto común: el código que recibe un valor de configuración, de un campo de formulario o de un enlace y llama new URL(valor) sin base lanzará para toda ruta relativa, y un bloque try que se traga el error convierte una URL equivocada en un undefined silencioso. La segunda línea muestra la solución, resolviendo la misma cadena contra una base.
La tercera y cuarta línea muestran que la resolución no es concatenación de cadenas. Un espacio en una ruta relativa se codifica con porcentaje a %20, y ../../x sube tres niveles desde /a/b/c para producir /x, no un añadido literal. Quien espere que la entrada cruda sobreviva a un viaje por el constructor se sorprende en ambos casos, porque la salida es una URL normalizada, no la cadena que se pasó.
Esa distinción importa para las comparaciones de igualdad. Dos cadenas que direccionan el mismo recurso pueden analizarse al mismo href, y una cadena puede analizarse a un href distinto tras la normalización. Un fixture que compara la cadena de entrada con la de salida para probar que nada cambió fallará en cualquier entrada que necesitara normalización, mientras que uno que compara dos URL analizadas para probar que son equivalentes puede pasar aunque las entradas parecieran distintas.
Qué reescribe la normalización
El analizador pasa a minúsculas el esquema y el host, quita un puerto por defecto, resuelve segmentos con punto y codifica con porcentaje los caracteres no permitidos en cada componente. Cuatro entradas muestran las reescrituras lado a lado:
raw="HTTPS://Example.TEST:443/a/../b/./c"
  href="https://example.test/b/c"
  origin="https://example.test" protocol="https:" port=""
raw="https://example.test/a%2Fb?q=a b#frag ment"
  href="https://example.test/a%2Fb?q=a%20b#frag%20ment"
  pathname="/a%2Fb" search="?q=a%20b" fragment="#frag%20ment"
raw="https://user:[email protected]/x"
  username="user" password="pass"
La primera entrada pierde tres cosas a la vez: el esquema y el host en mayúsculas pasan a minúsculas, el :443 explícito desaparece porque es el puerto por defecto de https, y /a/../b/./c colapsa a /b/c. Quien guardó la cadena original y la compara con href verá una diferencia que es enteramente normalización.
La segunda entrada muestra un punto más sutil. La barra codificada %2F en la ruta sobrevive sin cambios, porque es un escape deliberado de un carácter que de otro modo cambiaría la estructura de la ruta; el espacio crudo en la consulta y el fragmento se vuelve %20; y el espacio en el fragmento también se codifica. Así que la ruta conserva una barra codificada mientras la consulta y el fragmento codifican un espacio literal. Una pasada ingenua de «codificar todo» o «decodificar todo» sobre la URL entera corrompería el %2F, que es exactamente por lo que el analizador trata cada componente con sus propias reglas.
La tercera entrada muestra que las credenciales se analizan en username y password y se vuelven a serializar en el href, mientras origin las excluye. Eso importa para el registro: origin es seguro de guardar y comparar, mientras href puede llevar un nombre de usuario y una contraseña que no deberían escribirse en un registro ni en un fixture. Una lectura que guarda href para una URL con credenciales guarda el secreto; una que guarda origin y pathname no.
Cada componente tiene su propio conjunto de reglas, y esa es la razón por la que una sola pasada de codificación o decodificación sobre una URL entera es insegura. El esquema y el host se comparan y guardan en minúsculas; el puerto se quita cuando iguala el valor por defecto del esquema; la ruta resuelve segmentos con punto y conserva una barra codificada como dato; la consulta aplica la regla de + a espacio y codifica los caracteres reservados; y el fragmento codifica un espacio crudo pero conserva la estructura del fragmento. Quien toma el href entero, le aplica decodeURIComponent y pasa el resultado a new URL normalmente obtendrá una URL distinta, porque el paso de decodificación convierte barras y ampersands codificados en caracteres que el analizador luego lee como estructura. La unidad segura es el componente, no la cadena entera.
Ese modelo por componente también explica por qué dos URL que parecen distintas pueden ser idénticas tras el análisis. HTTPS://Example.TEST:443/b/c y https://example.test/b/c producen el mismo href, porque el analizador pasa a minúsculas y quita el puerto por defecto antes que nada. Un paso de deduplicación que compara cadenas crudas las tratará como distintas y guardará ambas, mientras que uno que compara href analizados las colapsa. Cuál es correcto depende del objetivo: una clave de caché quiere la forma colapsada para que ambas grafías golpeen la misma entrada, mientras un registro de auditoría puede querer la forma cruda para preservar la entrada original. La lectura debe decir qué forma guarda.
Claves duplicadas, signos más y codificación de valores
URLSearchParams es una lista de pares, no un mapa, y varias conductas se siguen de eso. Las claves duplicadas sobreviven, un valor vacío está presente pero vacío, y un valor que contiene & o = se codifica con porcentaje al serializar la lista:
params.getAll(a) -> ["1","2"]
params.get(b) -> ""
params.get(c) -> "&="
params.toString() -> "a=1&a=2&b=&c=<encoded ampersand><encoded equals>"
getAll devuelve ambos valores de a, así que quien usa get('a') ve solo el primero y descarta el resto en silencio. get('b') devuelve una cadena vacía, que es distinta de null para una clave ausente: un b= suelto está presente con un valor vacío, y el código que comprueba if (valor) trata ambos como falsos. Un valor que decodificó a &= se vuelve a serializar con su ampersand y su igual codificados de nuevo, así que la cadena cruda viaja pero el valor decodificado muestra los caracteres que el llamador realmente quería.
El signo más es la otra trampa. En una cadena de consulta, + significa espacio, así que un valor que contiene legítimamente un signo más debe codificarse con porcentaje como %2B:
searchParams from a+b -> "a b"
Map-like set round trip -> "q=a%2Bb"
La primera línea muestra new URLSearchParams('q=a+b').get('q') devolviendo "a b", porque el analizador leyó el más como espacio. La segunda muestra que construir la misma lista desde un objeto con el valor a+b lo serializa a q=a%2Bb, así que el más se conserva como dato. La asimetría es el defecto: quien construye una consulta por concatenación escribe q=a+b y luego lee a b, mientras quien pasa por URLSearchParams y un objeto de valores conserva el más. Los dos caminos discrepan sobre el mismo valor pretendido, y solo uno hace el viaje.
Tres escapes distintos decodifican a dos caracteres distintos, y solo una lectura que los enumera por separado captura la diferencia. Un + crudo decodifica a espacio, un %20 decodifica a espacio, y un %2B decodifica a más. Así que q=a+b, q=a%20b y q=a%2Bb son tres codificaciones distintas: las dos primeras llevan el valor a b, y la tercera lleva a+b. Quien normalice una consulta decodificándola y recodificándola con un codificador genérico colapsa las dos primeras en una forma y puede perder o inventar el más en la tercera, según qué codificador use. La forma registrada ?a=%2B+%20 de la salida del análisis es exactamente ese triplete en un parámetro: un signo más, luego un espacio, luego un espacio, decodificados de %2B, + y %20 respectivamente, y una recodificación que trata los tres como dato cambiaría la cadena aunque el valor decodificado no cambie.
Las claves duplicadas interactúan con la misma decodificación. Una consulta a=1&a=2&b= se analiza a tres pares, dos con la clave a y uno con la clave b y un valor vacío, y se vuelve a serializar a la cadena idéntica a=1&a=2&b=. Esa identidad vale la pena registrarla porque es la excepción y no la regla: esta cadena ya está en la serialización canónica, así que un análisis y reserialización la deja igual, mientras una cadena con un espacio crudo o un escape no canónico cambiaría. Un fixture que usa solo entradas ya canónicas nunca verá la normalización, por eso al menos una entrada no canónica pertenece al conjunto.
Orden y el coste de un viaje
La lista tiene un orden de inserción, y sort() la reordena por clave. Hasta que se llama sort(), el orden es el que se añadió:
insertion order -> "k9=9&k8=8&k7=7&k6=6&k5=5&k4=4&k3=3&k2=2&k1=1&k0=0"
sorted order -> "k0=0&k1=1&k2=2&k3=3&k4=4&k5=5&k6=6&k7=7&k8=8&k9=9"
Diez claves añadidas en orden descendente se serializan en ese orden, y sort() las convierte en orden ascendente. Los datos son idénticos antes y después; solo cambia la cadena serializada. Ese es el coste de un viaje: si un fixture construye una consulta, la serializa, la analiza de nuevo y compara cadenas, la comparación puede fallar solo por el orden. Un fixture que compara el conjunto de pares, no la cadena, es estable.
Hay una segunda consecuencia para claves duplicadas. sort() es estable para claves que comparan igual, así que dos entradas con la misma clave conservan su orden de inserción tras ordenar. Quien espere que sort() también ordene los valores dentro de una clave duplicada no lo obtendrá; los valores quedan en el orden en que se añadieron, y solo cambia la agrupación de claves.
Esa estabilidad es comprobable y vale la pena decirla claramente: tras sort(), a=1&a=2 sigue siendo a=1&a=2, no a=2&a=1, porque las dos claves comparan igual y el orden es estable. Quien quiere los valores ordenados dentro de una clave duplicada tiene que ordenarlos por separado antes de añadirlos, y quien asume que sort() hizo eso publicará una salida inestable que cambia entre ejecuciones al variar el orden de inserción. La regla a registrar es que sort() ordena solo por clave, y que las claves iguales conservan su orden de entrada.
La longitud es otra razón por la que un viaje no es una conversión. Analizar una consulta a una lista y serializarla de vuelta puede cambiar la longitud de la cadena aunque los pares sean idénticos, porque un %20 se vuelve un + y un espacio crudo se vuelve %20 según el camino tomado. Un fixture que afirma una longitud de bytes fija tras un viaje pasará con algunas entradas y fallará con otras por razones que nada tienen que ver con un defecto. Medir el número de pares y el conjunto de claves mantiene la afirmación estable entre las opciones de codificación que son todas correctas.
Fijar un parámetro frente a asignar search
Hay dos formas de cambiar la consulta en un objeto URL, y codifican de modo distinto:
set("q","a b+c&d=e") href -> "https://example.test/?q=a+b%2Bc%26d%3De"
search = "?q=a b+c&d=e" href -> "https://example.test/?q=a%20b+c&d=e"
La primera línea pasa por searchParams.set, que codifica el valor con las reglas de la cadena de consulta: el espacio se vuelve +, el más se vuelve %2B, y & e = se vuelven %26 y %3D, así que el valor entero queda dentro de un parámetro. La segunda línea asigna url.search directamente con una cadena cruda, así que el analizador ve & e = como separadores: el valor se vuelve a b (con el espacio codificado a %20), y c y d se vuelven parámetros separados.
Los dos resultados no son la misma URL, y la diferencia no es cosmética. set mantiene intacto el valor pretendido; la asignación cruda lo parte en tres parámetros porque los caracteres que separan parámetros son los que el llamador quería como dato. Quien construye una cadena de búsqueda a mano y la asigna debe codificar con porcentaje cada carácter reservado antes de asignar, mientras quien usa set entrega el valor crudo y deja que la API lo codifique.
También hay una diferencia de espaciado que vale notar. set produjo + para el espacio, mientras la asignación cruda produjo %20. Ambos decodifican a espacio, pero las dos serializaciones difieren, así que una comparación byte a byte de los dos valores href falla aunque lleven el mismo parámetro lógico. Es otra razón para comparar valores analizados en lugar de cadenas serializadas.
Registra una lectura de URL
Una lectura de URL que sobrevive a una revisión dice qué analizó y qué cambió. Seis campos cubren la parte observable, y ninguno guarda una credencial:
- La cadena de entrada y la base usada, o el hecho de que no se dio base y el análisis lanzó.
- El
origin,pathname,searchyfragmentresultantes, registrados por separado en vez de como un únicohref, para que credenciales y normalización sean visibles. - La lista de pares de consulta como entradas
[clave, valor], incluidas duplicadas y vacías, en vez de una sola cadena reconstruida. - Si un espacio fue un
+o un%20en la consulta serializada, porque ambos decodifican igual pero serializan distinto. - El orden de los pares y si se llamó
sort(), ya que el orden cambia la cadena sin cambiar los datos. - Cómo se cambió la consulta, mediante
searchParams.seto una asignación cruda desearch, porque ambos codifican los caracteres reservados de forma distinta.
Lo que tal registro no puede mostrar es nada sobre cómo un servidor o un proxy interpretará la misma URL. Un cliente analiza de una forma, un framework de servidor puede decodificar y reanalizar la consulta con sus propias reglas, y una redirección puede reescribir la cadena en tránsito. Para la pregunta más amplia de cómo interactúa la URL analizada de una página con las cadenas que informa, consulta detección de protocolo URL y privacidad y límites de btoa y atob, que cubre la capa de codificación por la que pasan los valores de consulta.
Dos hábitos mantienen la lectura honesta con el tiempo. Primero, registra origin y la lista de pares en vez de un único href, para que normalización y credenciales sean visibles en lugar de fundirse en una cadena opaca. Segundo, compara pares analizados en lugar de cadenas serializadas, para que el orden y la elección de + frente a %20 no conviertan un viaje correcto en un falso fallo.
Fuentes públicas
- MDN: URL
- MDN: URLSearchParams
- Estándar URL de WHATWG
- RFC 3986: sintaxis de identificador de recurso uniforme
- MDN: encodeURIComponent
Conclusión
Da siempre una base cuando una URL pueda ser relativa, y espera que el analizador normalice en lugar de preservar la cadena de entrada. Trata URLSearchParams como una lista de pares, para que claves duplicadas y valores vacíos sobrevivan, y recuerda que + decodifica a espacio. Usa searchParams.set para cambiar un valor y deja que codifique los caracteres reservados, o codifica tú mismo cada carácter reservado antes de asignar search. Registra origin y la lista de pares en vez de un único href, y compara pares analizados en lugar de cadenas serializadas.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
btoa y atob: límites Latin-1 y la verdad sobre el relleno
Huella digitalua-parser-js: Client Hints, bots y un tope de 500
Huella digitalstructuredClone frente a JSON: qué conserva una copia profunda
Huella digitalUnicode: cuatro identidades de texto que lee una página
Huella digitalGestión segura de URL externas en perfiles
Huella digitalwebgl_debug_renderer_info: qué revela tu GPU a las páginas
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.