btoa y atob: límites Latin-1 y la verdad sobre el relleno
Ejecuta btoa y atob sobre textos acentuados, CJK y emoji para ver dónde lanza cada uno, qué devuelve atob, si el relleno es opcional y qué alfabeto se rechaza.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
BotBrowser soporta repetir un fixture autorizado del mismo origen bajo un perfil declarado y conservar observaciones acotadas sobre qué API de codificación llamó una página y qué error lanzó, pero no cambia cómo un entorno implementa btoa o atob, no puede hacer que un codificador solo Latin-1 acepte caracteres astrales y no convierte un error de codificación en una huella. Esta revisión ejecuta ambas funciones sobre textos acentuados, CJK y emoji, y luego registra dónde lanza cada una, qué devuelve atob y qué entradas se decodifican sin relleno.
Resumen
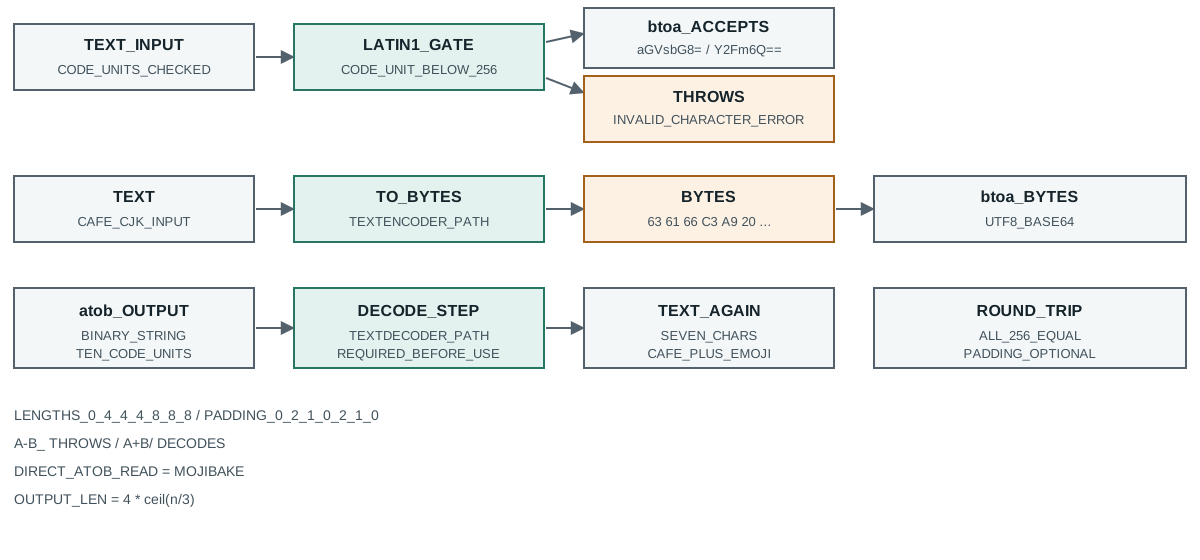
btoaacepta solo unidades de código menores que 256."café"codifica,"ÿ"codifica, pero"Ā"(U+0100) y"😀"lanzanInvalidCharacterError.- El enfoque estándar es convertir el texto a bytes primero con
unescape(encodeURIComponent(texto)), y luego pasar esos bytes abtoa. El resultado iguala entonces los bytes UTF-8 del original. atobdevuelve una cadena binaria, no texto. Leerla directamente da texto corrupto; un segundo paso de decodificación devuelve los mismos bytes al original.atobacepta entrada sin relleno y rechaza el alfabeto seguro para URL:"a-b_"lanza mientras"a+b/"se decodifica.- La longitud de salida es
4 * ceil(n / 3), así que los recuentos de 0 a 6 bytes dan longitudes 0, 4, 4, 4, 8, 8, 8 con su relleno.
Contenido
- Dónde rechaza btoa una entrada
- El envoltorio que convierte texto en bytes
- Qué devuelve atob y por qué hace falta un segundo paso
- Relleno, omisión de relleno y el alfabeto seguro para URL
- Aritmética de longitud y el viaje completo de todos los bytes
- Registra una lectura de codificación
Dónde rechaza btoa una entrada
El estándar HTML define btoa sobre unidades de código, y la restricción es más estrecha de lo que la mayoría de quienes llaman esperan. Cada unidad de código de la cadena de entrada debe ser menor que 256, lo que significa que solo pasa texto Latin-1. La medición sobre seis cadenas hace exacto el límite:
btoa("hello") -> ok aGVsbG8=
btoa("café") -> ok Y2Fm6Q==
btoa("ÿ") -> ok /w==
btoa("Ā") -> THREW InvalidCharacterError
btoa("😀") -> THREW InvalidCharacterError
btoa("中文") -> THREW InvalidCharacterError
Dos resultados sorprenden. "café" codifica sin queja, porque la letra acentuada de ese literal es el único punto de código U+00E9, que está por debajo de 256, así que no se dispara ninguna excepción. "ÿ" es U+00FF, la última unidad de código que aún cabe, y también codifica. El primer rechazo es "Ā" en U+0100, justo pasado el límite, y la excepción es InvalidCharacterError.
La fila del emoji muestra por qué el fallo no se trata de "no ASCII" como categoría aproximada. Un emoji está fuera del Plano Básico Multilingüe, así que se guarda como par sustituto, y ambas mitades son unidades de código por encima de 255. btoa ve una unidad de código de 0xD83D y rechaza antes de mirar la segunda mitad. Quien pruebe solo con texto de Europa occidental ("café" es el favorito) puede publicar un camino que funciona en cada prueba manual y falla la primera vez que llega un emoji o un nombre CJK.
El objeto de error merece registrarse porque es la única señal que recibe una página. No hay salida parcial ni estado devuelto, así que quien envuelve btoa en un bloque try solo puede distinguir una violación Latin-1 de una función ausente por el nombre. El texto del mensaje es corto y no especificado, así que un fixture debe afirmar sobre error.name y no sobre el mensaje.
Nada de este límite depende de la versión del entorno. La restricción está escrita en el algoritmo, así que un navegador y Node coinciden, y una prueba que reproduce el lanzamiento en Node lo reproducirá en el navegador que ejecute la misma página.
Hay una segunda razón por la que el límite se lee mal: la fila acentuada y la fila que rechaza se parecen en pantalla. "café" y "Ā" se leen ambos como "una letra con una marca", pero uno codifica y el otro lanza, porque la propiedad decisiva es el punto de código numérico y no la forma visual. Una é compuesta es un punto de código por debajo de 256; una Ā compuesta es un punto de código por encima; y una é descompuesta escrita como e más un acento combinante son dos puntos de código, el segundo de los cuales es U+0301 y sigue por debajo de 256, así que también codifica. Quien razone por apariencia y no por puntos de código predecirá el resultado equivocado en al menos uno de estos tres casos.
Por eso también una API orientada a bytes se lleva mal con texto que llega de un formulario, un portapapeles o una URL. Esas fuentes entregan con rutina formas descompuestas, uniones de ancho cero y secuencias de emoji, y cada una cambia qué unidades de código llegan a btoa. Registrar los puntos de código de la entrada que falla, no solo su texto renderizado, es lo que permite a un lector posterior reproducir la excepción.
El envoltorio que convierte texto en bytes
La solución ampliamente copiada es un modismo de dos pasos. encodeURIComponent convierte el texto en una cadena con codificación porcentual de bytes UTF-8, y unescape devuelve cada %XX al byte que representa, dejando una cadena cuyas unidades de código son exactamente los bytes UTF-8. Pasar esa cadena a btoa produce el Base64 de los bytes UTF-8.
wrap("café") -> Y2Fmw6k= byteCount=5 btoaMatchesUtf8=true
wrap("😀") -> 8J+YgA== byteCount=4 btoaMatchesUtf8=true
wrap("中文") -> 5Lit5paH byteCount=6 btoaMatchesUtf8=true
Tres hechos salen de esas líneas. Los recuentos de bytes coinciden con la longitud UTF-8, no con la longitud de la cadena JavaScript: "café" son cuatro unidades de código pero cinco bytes, "😀" son dos unidades de código pero cuatro bytes, y "中文" son dos unidades de código pero seis bytes. El Base64 producido iguala el Base64 del mismo texto codificado por el codificador UTF-8 del propio entorno, lo que la sonda comprueba directamente con la bandera btoaMatchesUtf8. Y el envoltorio nunca lanza para estas entradas, porque cuando btoa se ejecuta, cada unidad de código ya es un byte.
El modismo funciona, y también trae dos riesgos que vale nombrar. unescape está obsoleto, y un linter configurado para JavaScript moderno lo marcará, así que una base de código que aplique esa regla no puede usar esta forma exacta. Y el viaje por la codificación porcentual asigna tres cadenas intermedias, lo que importa si la llamada está en un bucle caliente que codifica miles de valores pequeños. El reemplazo moderno construye la cadena de bytes con TextEncoder:
function btoaUtf8(text) {
  const bytes = new TextEncoder().encode(text);
  let binary = '';
  for (const byte of bytes) binary += String.fromCharCode(byte);
  return btoa(binary);
}
Esa versión evita unescape y produce el mismo Base64, porque TextEncoder emite directamente los bytes UTF-8. Es la forma que hay que enseñar, ya que el modismo obsoleto solo sobrevive porque es anterior a TextEncoder en entornos más antiguos.
Qué devuelve atob y por qué hace falta un segundo paso
atob es la inversa de btoa, no la inversa de btoaUtf8. Devuelve una cadena binaria cuyas unidades de código son los bytes decodificados, y no sabe ni le importa que el original fuera texto UTF-8. Leer esa cadena binaria como si fuera texto es el defecto que produce el texto corrupto, y la medición muestra los bytes exactos:
atob(b64) is a binary string of 10 code units: 63 61 66 c3 a9 20 f0 9f 98 80
  read as text directly -> "café ð.." equalToOriginal=false
  after escape/decode  -> "café 😀" equalToOriginal=true
Diez bytes, y cada uno coincide con la codificación UTF-8 de "café 😀": 63 61 66 es caf, c3 a9 es la secuencia de dos bytes de é, 20 es el espacio, y f0 9f 98 80 es la secuencia de cuatro bytes del emoji. Los bytes decodificados son correctos. El fallo ocurre cuando alguien trata la cadena binaria de diez bytes como si fuera el original de diez caracteres, que no lo es: el original tiene siete caracteres y el recuento de bytes es diez.
Esa brecha es por lo que una implementación ingenua parece funcionar hasta que deja de hacerlo. Para ASCII puro, un byte iguala un carácter, así que atob seguido de uso directo da la respuesta correcta y toda prueba con texto inglés pasa. En el momento en que el valor contiene un carácter multibyte, la cadena de bytes y la cadena de texto divergen, y quien se saltó el segundo paso guarda datos corruptos. La sonda hace concreto el daño en una cadena CJK:
wrong-path round trip of "中文测试" -> "ä¸æ..." equal=false
El camino correcto refleja al codificador: toma la cadena binaria de atob, reconstruye los bytes y los decodifica como UTF-8. El emparejamiento obsoleto es decodeURIComponent(escape(binario)); el moderno construye un Uint8Array desde la cadena binaria y ejecuta TextDecoder:
function atobUtf8(encoded) {
  const binary = atob(encoded);
  const bytes = Uint8Array.from(binary, char => char.charCodeAt(0));
  return new TextDecoder().decode(bytes);
}
Ambas formas devuelven diez bytes a siete caracteres. La lección que un fixture debe registrar es que atob tuvo éxito en ambos casos, así que una comprobación que solo afirma "no lanzó" no detecta el texto corrupto. El registro tiene que comparar el texto decodificado con el original, que es una afirmación distinta a comprobar que la llamada devolvió.
Una comparación numérica hace imposible perder de vista la brecha. La cadena original tiene siete caracteres; la cadena binaria de atob tiene diez unidades de código. Las tres extra vienen enteramente de los dos caracteres multibyte, é sumando un byte y el emoji sumando dos, que son tres en total. Quien valide un valor decodificado comparando longitudes con el texto original verá entonces un desajuste para cada cadena que contenga cualquier carácter fuera de ASCII, y quien se salte la comparación guardará la cadena de bytes más larga y solo lo notará cuando un analizador posterior la rechace.
La misma aritmética explica por qué el defecto sobrevive a pruebas informales. Un fixture que solo codifica y decodifica "hello" ve cinco bytes de entrada, una cadena Base64 de ocho caracteres y cinco caracteres de salida, así que el original y el texto decodificado coinciden y el viaje parece exacto. En el momento en que un carácter acentuado entra en el valor, el recuento de bytes y el de caracteres se separan, y el fallo aparece después en lugar de en la suite que nunca le dio una cadena no ASCII.
Relleno, omisión de relleno y el alfabeto seguro para URL
Base64 rellena su salida hasta un múltiplo de cuatro con caracteres =, y quienes llaman suelen suponer que el decodificador exige ese relleno. La medición muestra que atob acepta ambas formas:
atob("aGVsbG8") -> ok "hello"
atob("aGVsbG8=") -> ok "hello"
La primera cadena pierde su = final, y atob igual devuelve "hello". Esa indulgencia es útil cuando un servidor elimina el relleno para una URL más corta, pero también significa que un decodificador no puede usarse para validar que una entrada estuviera bien rellenada. Si un fixture debe rechazar entrada sin relleno, esa comprobación va antes de atob, no dentro de él.
El alfabeto es otra cosa. Base64 estándar usa + y /; la variante segura para URL usa - y _. atob implementa solo el alfabeto estándar, así que los caracteres seguros para URL lanzan:
atob("a-b_") -> THREW InvalidCharacterError
atob("a+b/") -> ok "kæÿ"
La segunda línea decodifica cuatro caracteres en tres bytes, que resultan formar una cadena válida de tres caracteres. La primera lanza en el primer carácter seguro para URL que encuentra. Quien recibe un token de una URL, un segmento JWT o un slug de nombre de archivo sostiene entonces Base64 seguro para URL, y pasarlo directo a atob falla justo en las entradas que usan los dos caracteres sustituidos. La solución es una traducción de dos líneas antes de decodificar: reemplazar - por + y _ por /, y luego restaurar el relleno si la longitud no es múltiplo de cuatro. Esa traducción es barata, y su ausencia es una causa común de "funciona para algunos tokens, falla para otros", porque un token corto puede no contener ninguno de los caracteres sustituidos.
Aritmética de longitud y el viaje completo de todos los bytes
La longitud de salida sigue una regla fija que permite dimensionar un búfer o detectar una cadena truncada sin decodificarla. Cada grupo de tres bytes de entrada se convierte en cuatro caracteres de salida, y un grupo final de uno o dos bytes se rellena hasta ese ancho:
bytes=0 base64Len=0 padding=0
bytes=1 base64Len=4 padding=2
bytes=2 base64Len=4 padding=1
bytes=3 base64Len=4 padding=0
bytes=4 base64Len=8 padding=2
bytes=5 base64Len=8 padding=1
bytes=6 base64Len=8 padding=0
El patrón se repite cada tres bytes: un múltiplo de tres no tiene relleno, un byte sobrante tiene dos =, y dos bytes sobrantes tienen uno. Así que la longitud de salida es 4 * ceil(n / 3), y el recuento de relleno es (3 - n mod 3) mod 3. Quien llama puede predecir el tamaño codificado antes de codificar, lo que importa cuando el valor debe caber en un límite de columna o un presupuesto de URL: cada tres bytes cuestan cuatro caracteres, así que una codificación de un recuento conocido tiene un techo conocido.
Esa previsibilidad tiene un uso práctico más allá de dimensionar búferes. Como la longitud codificada es una función pura del recuento de bytes, un decodificador puede rechazar una cadena truncada sin analizarla: si un valor afirma codificar cierto número de bytes pero su longitud no es 4 * ceil(n / 3), algo se cortó. El relleno por sí solo no es una señal fiable, ya que atob acepta una cadena sin relleno, pero la longitud total aún delimita lo que la cadena puede representar.
El rango completo de bytes cierra el círculo. Codificar los 256 valores de byte posibles con btoa y decodificarlos de vuelta con atob devuelve una cadena idéntica byte a byte:
all 256 bytes via btoa/atob: byteIdentical=true length=256
Ese resultado es la garantía que alguien realmente necesita del par: los bytes que entran vuelven sin cambios, para todo el rango Latin-1, sin pérdida ni sustitución. También muestra el límite de la sección anterior en reversa. btoa maneja cada valor de byte de 0 a 255, por lo que el texto Latin-1 codifica, y rechaza solo unidades de código por encima de 255, por lo que cualquier texto fuera de Latin-1 necesita primero la conversión a bytes. Las dos mitades del artículo describen el mismo límite desde lados opuestos.
Registra una lectura de codificación
Una lectura de codificación que sobrevive a una revisión nombra el límite y lo demuestra. Seis campos cubren la parte observable, y ninguno guarda el valor secreto:
- El entorno y los nombres de las funciones, para que un lector sepa que los resultados vienen de
btoayatobestándar y no de un polyfill. - Las cadenas exactas que codificaron y las exactas que lanzaron, con el nombre del error, para que el límite Latin-1 sea reproducible.
- Si se aplicó el envoltorio de texto a bytes y qué recuento de bytes produjo, comparado con el codificador UTF-8 del propio entorno.
- Si el paso de decodificación se ejecutó, y si el resultado iguala el original como texto, no solo si
atobdevolvió. - El alfabeto en uso, estándar o seguro para URL, y si el relleno estaba presente.
- El recuento de bytes y la longitud de salida resultante, para poder comprobar la regla
4 * ceil(n / 3).
Lo que tal registro no puede mostrar es nada sobre la confidencialidad de los datos. Base64 es una codificación, no un cifrado, y un lector puede revertirla en un paso, así que el registro debe guardar la igualdad del viaje y los recuentos de bytes en lugar del contenido decodificado. Para la pregunta más amplia de cómo interactúan el manejo de texto y codificación de una página con las cadenas que informa, consulta Normalización Unicode e identidades de texto, y para ver cómo las decisiones de bytes de un entorno afloran en otra API, consulta la comparación de la fuente aleatoria de crypto-js.
Dos hábitos mantienen la lectura honesta con el tiempo. Primero, afirma sobre el nombre del error y los recuentos de bytes, no sobre el texto del mensaje, porque el límite está estandarizado y el mensaje no. Segundo, incluye al menos una cadena no Latin-1 y un token seguro para URL en cada fixture que toque estas funciones, para que los dos fallos silenciosos más comunes no pasen una suite verde.
Fuentes públicas
- MDN: función global btoa()
- MDN: función global atob()
- Estándar HTML: decodificación base64 indulgente
- RFC 4648: codificaciones de datos Base16, Base32 y Base64
- MDN: TextEncoder
Conclusión
Comprueba que cada unidad de código sea menor que 256 antes de llamar a btoa, y convierte el texto a bytes con TextEncoder en lugar de confiar en la entrada. Trata atob como la inversa de una cadena de bytes y siempre decodifica el resultado de vuelta a texto antes de usarlo. Traduce el Base64 seguro para URL al alfabeto estándar y restaura el relleno, registra los recuentos de bytes y el nombre del error, y mantén una cadena no Latin-1 y un token seguro para URL en el fixture para que los fallos silenciosos sigan visibles.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
Unicode: cuatro identidades de texto que lee una página
Huella digital¿Qué es la huella de fuentes? Coherencia de texto entre plataformas
Huella digitalFuente aleatoria de crypto-js: qué rama usa tu build
Huella digitalua-parser-js: Client Hints, bots y un tope de 500
Huella digitalObservabilidad de aleatoriedad criptográfica y huellas del navegador
Huella digitalFingerprinting por medicion de texto: rastreo subpixel
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.