ua-parser-js: Client Hints, bots y un tope de 500
Ejecuta el bundle fijado de ua-parser-js sobre user agents y Client Hints fijos: qué identidad informa, qué marcadores descarta y cómo el tope de 500 caracteres oculta un token.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
BotBrowser soporta repetir un fixture autorizado del mismo origen bajo un perfil declarado y conservar observaciones acotadas sobre lo que informa una página, pero no puede hacer que un analizador de terceros coincida con el navegador que mide, cambiar el tope de 500 caracteres de entrada de una biblioteca, ni convertir una etiqueta analizada en un veredicto sobre quién está al otro lado. Esta revisión fija el árbol público de ua-parser-js en el commit bd7480198cd0d237b43a24a964f424727abb78e9 (versión 2.0.10 del paquete), ejecuta su analizador empaquetado sobre una lista fija de cadenas de user agent y conjuntos de cabeceras Client Hints, e informa lo que el código devolvió realmente.
TL;DR
- El analizador fijado etiqueta un user agent headless como
Chrome Headlessy su propio clasificador de bots sigue respondiendoisBot=falsepara la misma cadena. - Un user agent de aplicación Electron se informa como
Chromesimple; el nombre de navegador del analizador no lleva ahí ninguna señal de automatización. - Al dar una cadena de user agent, el analizador ignora una lista de marcas
sec-ch-uacontradictoria, así que Client Hints no anula lo que ya dijo la cadena. - La entrada se recorta a 500 caracteres, y un token de bot que empieza en el índice 500 es invisible para el clasificador mientras uno que empieza en 490 sí se encuentra.
- Todo esto describe un commit y un bundle; no es una afirmación sobre cómo puntúa una sesión ningún sitio.
Contents
- Qué incluye realmente el paquete fijado
- Ejecutar el analizador sobre cadenas de user agent fijas
- Dónde el clasificador de bots discrepa del nombre de navegador
- Dónde Client Hints deja de importar
- Dónde el tope de 500 caracteres oculta un token
- Qué listas de reglas alimentan el clasificador
- Qué mostraría y qué no una prueba de mutación
- Leer una identidad analizada sin exagerar
Qué incluye realmente el paquete fijado
La versión 2.0.10 reparte src/ en siete directorios. src/main guarda el analizador, src/bot-detection guarda el clasificador, src/browser-detection y src/device-detection guardan comparadores separados, src/extensions guarda las listas de bots, rastreadores y fetchers, src/enums guarda los vocabularios y src/helpers guarda las utilidades pequeñas. El bundle publicado dist/ua-parser.pack.js exporta UAParser, VERSION y cinco enumeraciones (BROWSER, CPU, DEVICE, OS, ENGINE); el submódulo de bots es una entrada aparte que exporta isBot, isAIAssistant e isAICrawler.
Las dos mitades leen la misma cadena por rutas de código distintas, y esa diferencia es el tema de esta revisión. UAParser aplica expresiones regulares al texto del user agent y, cuando recibe un objeto de cabeceras, también a las cabeceras Client Hints. isBot hace algo más estrecho: analiza el user agent a través del registro de extensiones y luego pregunta si el type de navegador resultante es cli, crawler, fetcher o library. Una biblioteca que produce un nombre de navegador plausible puede por tanto convivir con un clasificador que dice que la cadena no es un bot, y los dos resultados responden a preguntas distintas.
Dos constantes en src/main/ua-parser.js deciden cuánto texto puede ver cada mitad. El analizador declara UA_MAX_LENGTH = 500, y setUA aplica trim(ua, UA_MAX_LENGTH) antes de cualquier coincidencia. Todo lo que viene después, incluida la cadena que el clasificador de bots vuelve a analizar, trabaja por tanto sobre los primeros 500 caracteres como mucho de lo que se le dio.
Ejecutar el analizador sobre cadenas de user agent fijas
La sonda carga el bundle publicado y el submódulo de bots fijado, y luego imprime una línea por entrada. Lee una lista fija; no carga ninguna página, no abre ningún perfil y no contacta ningún servicio:
node /tmp/uap-full-probe.mjs
La salida observada, sección por sección:
section: user-agent parse
chrome-win: browser=Chrome/155.0.0.0 engine=Blink os=Windows device=desktop
safari-mac: browser=Safari/18.4 engine=WebKit os=macOS device=desktop
headless-linux: browser=Chrome Headless/155.0.0.0 engine=Blink os=Linux device=desktop
edge-win: browser=Edge/155.0.0.0 engine=Blink os=Windows device=desktop
electron-win: browser=Chrome/155.0.0.0 engine=Blink os=Windows device=desktop
googlebot: browser=undefined/undefined engine=undefined os=undefined device=desktop
iphone-safari: browser=Mobile Safari/18.4 engine=WebKit os=iOS device=mobile
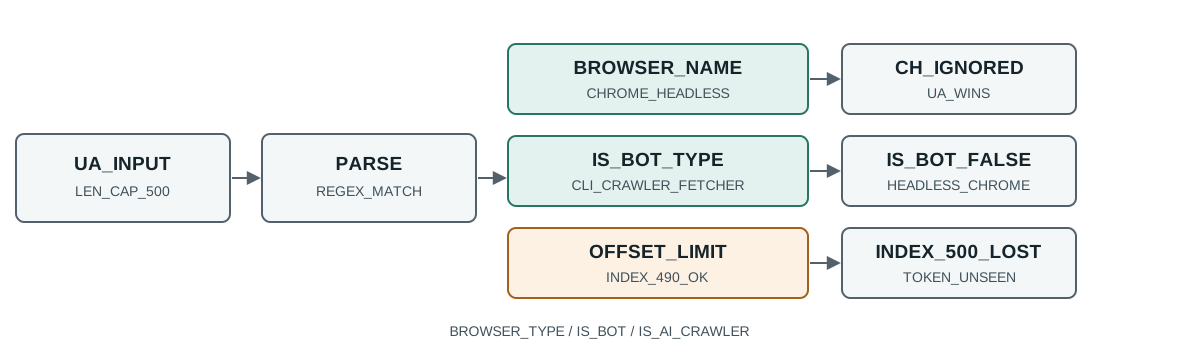
Tres detalles de ese bloque importan más que el resto. La línea headless-linux informa un nombre de navegador distinto, Chrome Headless, lo que significa que el analizador sí lleva una etiqueta con forma de automatización para esa cadena. La línea electron-win informa Chrome simple, así que una aplicación construida sobre Electron es indistinguible de un navegador de escritorio en este campo. Y googlebot informa undefined para navegador, motor y sistema operativo mientras sigue informando device=desktop, lo que muestra que "sin coincidencias" se expresa como campos ausentes y no como un error.
El campo device merece su propia nota porque es fácil leerlo como una afirmación más fuerte de lo que es. googlebot y chrome-win vuelven ambos como desktop, y headless-linux también; el campo es un cajón de reserva, no una medición. Quien lee device=desktop como "esto es realmente una máquina de escritorio" ha leído un valor por defecto como evidencia.
Dónde el clasificador de bots discrepa del nombre de navegador
La segunda sección de la misma ejecución pregunta al clasificador por todas las cadenas; el bloque de abajo es un extracto de la salida completa que figura en el archivo de evidencia:
section: bot classifier
chrome-win: isBot=false isAIAssistant=false isAICrawler=false
headless-linux: isBot=false isAIAssistant=false isAICrawler=false
electron-win: isBot=false isAIAssistant=false isAICrawler=false
googlebot: isBot=true isAIAssistant=false isAICrawler=false
La fila headless-linux es la interesante. El analizador llama a esa cadena Chrome Headless, y el clasificador la llama no es un bot. Ambas son afirmaciones correctas sobre su propio conjunto de reglas: el clasificador no consulta el nombre de navegador para HeadlessChrome; consulta el type de navegador, y una compilación Chromium headless sigue declarando el tipo de navegador ordinario. Un informe que cita una de esas dos respuestas e insinúa la otra está informando mal sobre la biblioteca.
La fila electron-win repite el patrón desde la otra dirección. El analizador no da etiqueta de automatización alguna, y el clasificador coincide en que no hay bot. Una aplicación Electron es por tanto invisible a ambos campos a menos que otra parte del sistema mire el token Electron/ directamente, cosa que este bundle no hace en ninguna de las dos rutas que la sonda ejercitó.
La fila googlebot muestra el resultado más fuerte del clasificador, isBot=true, mientras el analizador no devuelve nada. Ese es el caso inverso: la lista de rastreadores reconoce la cadena aunque el comparador genérico de navegadores no tenga patrón para ella. Leer solo browser.name haría que esa fila pareciera un fallo de análisis en lugar de una coincidencia de bot.
Como contraste, las listas orientadas a IA se comportan distinto de la lista genérica de bots. En la sonda más estrecha el clasificador respondió isAICrawler=true para GPTBot y ClaudeBot, e isAIAssistant=true para ChatGPT-User y Claude-User, con isBot=true en los cuatro. Una cadena HeadlessChrome simple y una cadena Electron quedaron false en los tres predicados, lo que concuerda con la tabla anterior.
Dónde Client Hints deja de importar
La tercera sección alimenta una lista de marcas estilo Chromium y cabeceras de plataforma, y luego cambia solo la cadena de user agent:
section: client hints
hints-only: browser=undefined/undefined os=undefined device=desktop
ua-safari-plus-chrome-hints: browser=Safari/18.4 os=macOS device=desktop
La primera fila es la esperada: sin user agent y solo con cabeceras sec-ch-ua, el analizador no devuelve nada en esta ruta de llamada. Las cabeceras por sí solas no bastan para producir un nombre de navegador aquí, porque la lista de marcas la consume el paso de análisis de Client Hints y no el comparador genérico, y la sonda llamó al resultado simple.
La segunda fila es la sorpresa. La cadena de user agent dice Safari, las cabeceras dicen Chromium y Google Chrome en Windows, y el resultado es Safari/18.4 en macOS. En esta ruta gana la cadena y la lista de marcas contradictoria se ignora, así que una página cuyo user agent y cuyas cabeceras Client Hints discrepan se informa como lo que la cadena afirmó. Esa es una propiedad útil de conocer antes de tratar una etiqueta del analizador como verificación cruzada: un desajuste que esperabas que se detectara puede pasar de largo.
La razón de que la segunda fila conserve la cadena es visible en parseCH(). Cuando hay una lista de marcas, el bucle recorre cada marca, omite cualquier nombre que case con /not.a.brand/i, y solo sobrescribe el nombre actual bajo una condición estrecha: el nombre previo debe empezar por Chrom, o el nombre previo debe ser Edge y la marca nueva debe ser WebView2. Con un nombre previo Safari no se cumple ninguna, así que todas las marcas se examinan y ninguna reemplaza al nombre analizado. La entrada Chromium se usa solo para la versión del motor cuando el tipo de elemento es ENGINE, no para el nombre de navegador.
getBrowser().withClientHints() existe y sí consulta las cabeceras, y devuelve un thenable en lugar de un objeto simple. La sonda confirmó esa forma, y también confirmó que esperarlo sobre las entradas contradictorias seguía devolviendo Safari/18.4, porque la misma regla de reconciliación conserva el nombre no Chromium. La advertencia importante para el lector es que un getResult() síncrono y un withClientHints() esperado son formas de llamada distintas con respuestas distintas, y un informe debería decir cuál produjo la etiqueta.
Una etiqueta de analizador es solo una lectura de la misma sesión. Cuando la pregunta es qué hace un detector con los nombres con forma de automatización que produjo esta ejecución, la revisión del registro de detectores de BotD ejecuta otro detector público sobre estados explícitos, y detección y prevención de automatización enumera el conjunto más amplio de superficies que una página puede inspeccionar. Leerlas juntas evita que una sola biblioteca sustituya a todo el sistema.
Dónde el tope de 500 caracteres oculta un token
La última sección prueba la constante nombrada en src/main/ua-parser.js:
section: marker position vs 500-char cap
pad=430: totalLength=500 markerStart=490 isBot=true
pad=440: totalLength=510 markerStart=500 isBot=false
Dos cadenas difieren solo en cuánto relleno hay antes de un token GPTBot/1.2. Con una longitud total de 500 y el token empezando en el índice 490, el clasificador lo encuentra. Con 510 caracteres y el token empezando en el índice 500, el clasificador no lo encuentra. La frontera está exactamente donde trim(ua, UA_MAX_LENGTH) corta la cadena, así que el token no se analiza mal; simplemente nunca se ve.
Ese es un modo de fallo concreto y con forma clara: una página puede reconocerse como bot cuando su token cae dentro de los primeros 500 caracteres y pasar en silencio cuando el mismo token es empujado justo más allá de la frontera por un comentario largo o una lista de extensiones. Nada del token cambió, solo su desplazamiento. Una prueba que añade un marcador a un user agent largo realista y luego informa "no detectado" está midiendo el tope, no el token.
La mitigación no es elevar la constante en una copia de la biblioteca, porque el comportamiento fijado es aquel contra el que se escribió el resto del código del sistema. Es mantener honesta la observación: registra la longitud de la entrada junto al veredicto y, cuando se espera un marcador, confirma que su desplazamiento cae dentro del tope. Un token de 10 caracteres en el índice 500 y el mismo token en el 490 son el mismo contenido de cadena y evidencia distinta.
Qué listas de reglas alimentan el clasificador
El clasificador no es una lista; son tres envoltorios sobre tres registros. BotTypes lee el type de navegador que produce la extensión Bots y trata cli, crawler, fetcher y library como tipos de bot. AIAssistants nombra entradas concretas del registro Fetchers, y AICrawlers nombra entradas concretas del registro Crawlers. Las listas son largas de una forma que importa: solo el array AICrawlers fijado nombra 53 entradas de rastreador distintas de proveedores tan diversos como Anthropic, ByteDance, Cloudflare, Hugging Face, Meta, OpenAI, Semrush y Zhipu, y el array AIAssistants nombra 8 entradas, una por cada uno de Amazon, Anthropic, Cohere, DuckDuckGo, Google, Mistral, OpenAI y Perplexity.
Esa estructura explica por qué la misma cadena puede ser isBot=true e isAICrawler=false. isBot pregunta solo si el tipo analizado es un tipo de bot, mientras isAICrawler pregunta si el nombre de navegador analizado casa con uno de 53 nombres enumerados. Un rastreador que casa con la extensión Bots por tipo pero falta en la lista enumerada de rastreadores de IA es bot y no es rastreador de IA. Ninguna de las dos respuestas está mal; son dos consultas contra dos conjuntos distintos.
Las listas además envejecen. Un nombre que existe hoy en el array fijado de 53 entradas puede eliminarse o renombrarse en una versión posterior, y un rastreador nuevo que aparece después de este commit es invisible a todos los predicados por construcción. Es la misma razón por la que la revisión fija un commit en lugar de una rama: la respuesta es una propiedad de la revisión de la lista tanto como de la cadena de entrada.
Qué mostraría y qué no una prueba de mutación
Un siguiente paso tentador es cambiar un carácter de un user agent y afirmar que el analizador es frágil. La sonda ya sugiere por qué sería una afirmación débil. El token Electron/33.0.0 estaba presente en la cadena y no cambió nada, porque ninguna de las dos rutas que la sonda ejercitó lo busca; una mutación que quitara el token tampoco cambiaría nada, y la prueba parecería una demostración de robustez en lugar de un campo sin uso.
Lo inverso es más informativo. Añadir un token GPTBot/1.2 a una cadena de Chrome cambió isBot de false a true en la sonda más estrecha, así que una mutación sobre ese token demuestra que el clasificador lo lee. Probar el mismo token en dos desplazamientos, 490 y 500, aísla entonces el tope en lugar del token. Una sola mutación no puede separar "el analizador ignora este texto" de "el analizador nunca vio este texto", y solo un par de desplazamientos puede.
La misma lógica aplica a las cabeceras. Una ejecución que añade una lista de marcas sec-ch-ua contradictoria a un user agent de Safari y no observa cambio es evidencia de que la cadena tomó precedencia en esa ruta de llamada. Una ejecución que quita el user agent por completo y observa undefined es evidencia de que las cabeceras solas no las consume la llamada de resultado simple. Dos ejecuciones, dos afirmaciones distintas; una sola ejecución las habría confundido.
Leer una identidad analizada sin exagerar
El resultado de un analizador sostiene una afirmación estrecha: este commit, dada esta cadena y estas cabeceras, produjo esta etiqueta. No sostiene una afirmación de que la sesión sea un navegador, un bot o una persona, ni de que otro sitio llegará a la misma conclusión, porque otro sitio puede fijar otra versión, pasar otras cabeceras o hacer otra pregunta.
Guarda cuatro campos juntos y el registro sigue siendo usable. El commit, porque tanto las listas de patrones como el tope se editan entre versiones. La entrada, literal y con su longitud, porque el tope hace del desplazamiento parte de la entrada. La forma de llamada, porque getResult() y withClientHints() pueden discrepar. Y el predicado, porque isBot, isAIAssistant e isAICrawler son tres respuestas separadas que la sonda mostró dividiéndose sobre la misma familia de cadenas.
La página de docs sobre propiedades de navigator describe cómo BotBrowser mantiene navigator.platform, navigator.userAgentData y valores relacionados alineados con el perfil cargado. Esta revisión añade el lado de la lectura: qué hace un analizador muy usado con las cadenas que producen esos valores, dónde discrepan su nombre de navegador y su clasificador de bots, y dónde su propio tope de entrada vuelve invisible un marcador. La coherencia de los valores informados y la corrección de un análisis de terceros son preguntas separadas.
Para cualquier decisión sobre una sesión real, usa un resultado de integración autorizado del sistema que decide en lugar de extrapolar desde esta revisión de código. Una etiqueta analizada registrada en un fixture y un veredicto de producción son tipos distintos de evidencia, y la brecha entre ambos es donde ocurre la exageración.
Practical conclusion
Fija el commit, ejecuta el analizador sobre entradas fijas y registra la longitud, la forma de llamada y el predicado concreto junto a cada etiqueta. En este commit un user agent headless se llama Chrome Headless mientras el clasificador de bots responde false, una cadena Electron se llama Chrome, una lista de marcas Client Hints contradictoria se ignora cuando hay una cadena de user agent, y un token que empieza en el índice 500 es invisible mientras el mismo token en el 490 se encuentra.
Sources
- Analizador principal de ua-parser-js en el commit fijado
- Submódulo de detección de bots de ua-parser-js
- Registro de extensiones de ua-parser-js
- MDN: API de User-Agent Client Hints
- MDN: navigator.userAgentData
- Documentación de propiedades de navigator de BotBrowser
Next reading
Usa fingerprinting con Client Hints para cómo varía el conjunto de cabeceras, y reducción del user agent y migración a Client Hints para lo que los navegadores quitaron de la cadena.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
BotD: qué detectores se ejecutan de verdad
Huella digitalClient Hints Fingerprinting: encabezados HTTP e identidad
PlataformaMigración de User-Agent Reduction a Client Hints
IdentidadUser-Agent y Client Hints: una identidad coherente
IdentidadSuperficies de identidad del navegador: panorama de coherencia
IdentidadCambio de marca: Chrome, Edge, Brave, Opera
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.