ArrayBuffer y TypedArray: un búfer, muchas vistas
Lee un ArrayBuffer como Uint8Array, Uint32Array y DataView: bytes frente a elementos, por qué slice copia y subarray comparte, orden de bytes y transfer desprende el origen.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
BotBrowser soporta repetir un fixture autorizado del mismo origen bajo un perfil declarado y conservar observaciones acotadas sobre los bytes que una página leyó a través de una vista y los números que produjo, pero no puede cambiar el orden de bytes del host contra el que lee un DataView, no puede hacer que una copia y un alias se comporten igual y no convierte la longitud de una vista en una señal de identidad. Esta revisión toma un ArrayBuffer y lo lee con Uint8Array, Uint32Array y DataView, y luego registra por qué los mismos ocho bytes llevan tres longitudes distintas, por qué slice copia mientras subarray comparte, cómo difieren una lectura big-endian y una little-endian de los mismos bytes, cómo se comportan el acceso fuera de rango y el desbordamiento de enteros, y cómo un transfer deja el origen desprendido.
Resumen
- Un búfer de 8 bytes tiene
.byteLength8 para toda vista, peroUint8Array.lengthes 8,Uint32Array.lengthes 2 yFloat64Array.lengthes 1; la longitud cuenta elementos, no bytes. - Las tres vistas comparten los mismos bytes, así que una escritura por una se ve por las otras, porque envuelven un búfer en vez de copiarlo.
slicedevuelve una copia sobre un búfer nuevo, así que una escritura sobre ella deja el origen intacto;subarraydevuelve una vista sobre el mismo búfer, así que una escritura sobre ella cambia el origen.DataView.setUint32(0, 0x01020304, false)escribe01 02 03 04, y leer los mismos bytes big-endian da0x01020304mientras little-endian da0x04030201.- Un
Uint32Arraylee en el orden del host, que en esta máquina es little-endian, así que los mismos bytes dan0x04030201, igual a la lectura little-endian delDataViewy no a la big-endian. - Una escritura fuera de rango se descarta y una lectura fuera de rango es
undefined;Uint8Arrayda 0 para 256,Int8Arrayda -56 para 200 yUint8ClampedArraylimita 300 a 255. buffer.transfer(4)desprende el origen (byteLengthpasa a 0) y devuelve una copia de 4 bytes; usar el origen desprendido lanzaTypeError.
Contenido
- Por qué un búfer tiene tres longitudes distintas
- Por qué slice copia y subarray comparte
- Cómo los mismos bytes se leen big-endian y little-endian
- Dónde caen el acceso fuera de rango y el desbordamiento
- Dónde la ventana de una vista y un transfer cambian el origen
- Registra una lectura binaria
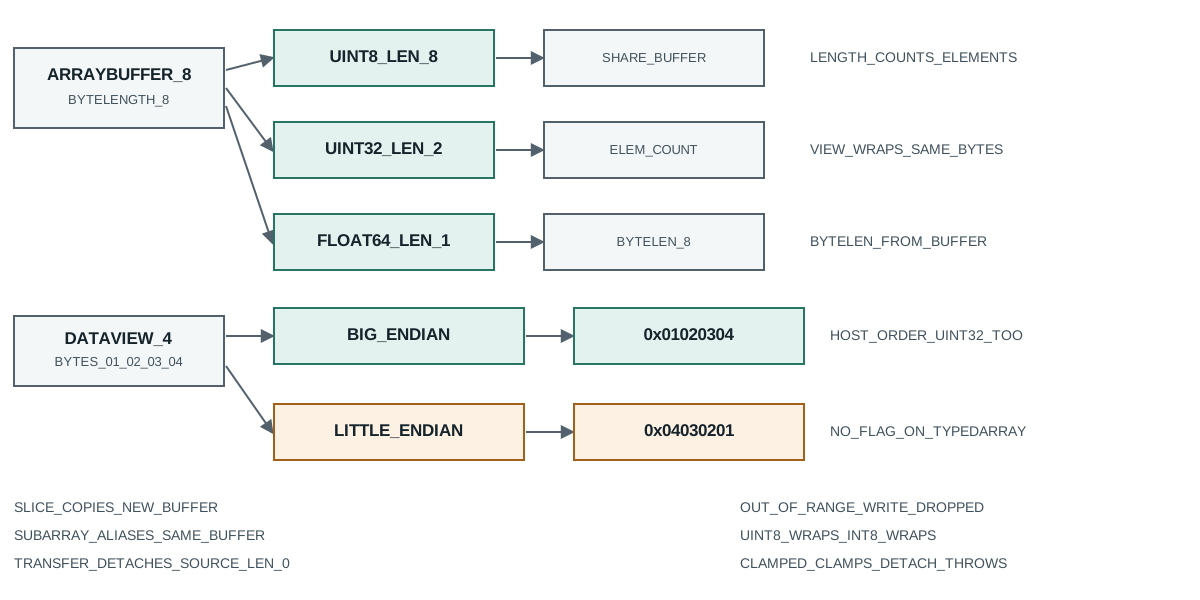
Por qué un búfer tiene tres longitudes distintas
Un búfer es un bloque de bytes sin noción de qué significan los bytes. Una vista aporta ese significado, y el tamaño de elemento que usa decide cuántos elementos caben en el mismo bloque. La sonda asigna un búfer de 8 bytes y construye tres vistas sobre él:
ArrayBuffer=function DataView=function node=v26.9.0
new ArrayBuffer(8): byteLength=8
same buffer: Uint8Array.length=8 Uint32Array.length=2 Float64Array.length=1
all share bytes: u8.buffer===u32.buffer true
El búfer informa byteLength 8 sin importar qué vista lo lea. El Uint8Array lee un byte por elemento, así que su length es 8. El Uint32Array lee cuatro bytes por elemento, así que su length es 2. El Float64Array lee ocho bytes por elemento, así que su length es 1. Tres números que describen los mismos ocho bytes, y solo uno de ellos es un conteo de bytes.
Esa distinción es el primer defecto en una ruta de código binaria: quien lee view.length y lo multiplica por un byte por elemento obtiene el conteo de bytes equivocado para toda vista salvo la de bytes. La propiedad byteLength es la que siempre cuenta bytes, y coincide en las tres vistas porque es una propiedad de la ventana del búfer, no del tipo de elemento. La comprobación de identidad de .buffer confirma que las tres vistas envuelven una sola asignación, así que una escritura por la vista de bytes se ve por la vista de 32 bits, que es justo lo que un decodificador usa cuando llena bytes y luego los lee como enteros.
La consecuencia práctica es que una longitud escrita en un registro debe nombrar qué vista la produjo. Un registro que dice "longitud 8" es ambiguo: es una longitud de bytes o una longitud de Uint8Array, pero un Uint32Array sobre los mismos bytes diría dos. Ambas son correctas y responden preguntas distintas, así que el registro necesita el tamaño de elemento junto al número.
El mismo razonamiento decide cómo informa una vista un conteo de bytes cuando el búfer no es un múltiplo entero del tamaño de elemento. Un Uint32Array sobre un búfer de 10 bytes expone solo los dos elementos completos de cuatro bytes que caben, y los dos bytes finales quedan fuera de todo elemento que pueda direccionar. El byteLength de la vista refleja solo los bytes que cubre, así que los dos bytes sobrantes no son legibles ni escribibles por ella, y un analizador que asume que todo byte del búfer es alcanzable por la vista descarta la cola en silencio. Elegir el tipo de elemento para un búfer que no está alineado a él es por eso una decisión sobre qué bytes son direccionables, no solo sobre cuántos elementos informa una longitud.
Por qué slice copia y subarray comparte
Dos métodos se parecen y se comportan al revés. slice devuelve una vista nueva respaldada por un búfer nuevo, y subarray devuelve una vista nueva respaldada por el mismo búfer. La sonda muta cada una y comprueba si el origen cambió:
slice then mutate: src[1]=2 sliced[0]=99
subarray then mutate: src[1]=42 sub[0]=42
slice shares buffer: false; subarray shares buffer: true
Tras slice(1, 4), escribir 99 en la copia deja src[1] en su 2 original, y la comprobación de identidad del búfer informa que la copia no comparte el búfer del origen. Tras subarray(1, 4), escribir 42 en la subvista cambia src[1] a 42, y la comprobación informa que la subvista comparte el búfer del origen. Los dos métodos toman los mismos argumentos y producen vistas de los mismos tres elementos, pero uno es una copia y el otro es un alias.
Un decodificador que lee un cuadro, toma un slice para el cuerpo y lo guarda puede reutilizar el búfer del origen para el cuadro siguiente, porque la copia posee sus propios bytes. Un decodificador que toma un subarray para lo mismo y luego reutiliza el búfer del origen para el cuadro siguiente sobrescribe el cuerpo que guardó, porque la subvista sigue apuntando al búfer que acaba de cambiar. Es un defecto clásico de alias: el código parece correcto, el conteo de elementos es correcto, y los bytes guardados son en silencio los del cuadro siguiente.
La solución es decidir a propósito cuál necesita un registro. Una copia cuesta una asignación y sobrevive a que el origen se reutilice; un alias no cuesta nada y queda invalidado en el momento en que el origen cambia. Un registro que guarda un subarray debe mantener vivo e intacto el búfer del origen o copiar los bytes con slice antes, y debería decir cuál de las dos hizo, porque un alias guardado y una copia guardada son indistinguibles solo por el conteo de elementos.
Cómo los mismos bytes se leen big-endian y little-endian
El orden de bytes decide qué extremo de un número multibyte va primero. DataView toma un argumento explícito littleEndian, y la sonda escribe un valor de 32 bits y lo lee de ambas formas:
setUint32 big-endian bytes: 01 02 03 04
DataView read BE -> 0x1020304
DataView read LE -> 0x4030201
Uint32Array (host order) -> 0x4030201
host is little-endian: true
Escribir 0x01020304 con littleEndian en falso (big-endian) coloca los bytes como 01 02 03 04. Leerlos con getUint32(0, false) reconstruye 0x01020304, y leer los mismos cuatro bytes con getUint32(0, true) reconstruye 0x04030201, el valor con los bytes invertidos. Los bytes no cambiaron; solo cambió la interpretación, y ambas son correctas bajo su propia opción.
La línea del Uint32Array muestra la trampa. Una vista de arreglo tipado no tiene argumento de orden de bytes; lee en el orden nativo del host. Esta máquina es little-endian, así que el Uint32Array lee 0x04030201, igual a la lectura little-endian del DataView. Un decodificador que analiza una cabecera de red por un Uint32Array en vez de por un DataView obtiene por eso una respuesta correcta en un host little-endian y una incorrecta en un host big-endian, sin cambio de código. Por eso un formato binario siempre nombra su orden de bytes y por eso un decodificador que debe seguir la especificación usa DataView con una opción explícita en vez de una vista de arreglo tipado.
La línea host is little-endian es la forma barata de registrar hacia dónde se inclina la máquina: asigna un Uint16Array con 1, lee su búfer como bytes y comprueba si el primer byte es 1. Un registro que guarda enteros analizados sin registrar el orden del host no se puede volver a ejecutar a los mismos números en otra máquina, porque los mismos bytes solo reproducen el valor bajo el orden que se asumió.
Hay una segunda consecuencia más callada de cómo informa una vista un número. Uint32Array produce un entero sin signo, así que un valor cuyo bit alto está puesto se lee como un número positivo grande en vez de negativo, y un formato que usa un campo de 32 bits con signo necesita Int32Array o una llamada DataView.getInt32 para leerlo bien. Dos vistas sobre bytes idénticos pueden discrepar en la magnitud y en el signo del mismo campo, porque el tipo de elemento lleva el signo además del ancho. Un registro que captura los bytes crudos y el tipo de elemento juntos se puede releer como cualquiera de los dos, mientras que uno que captura solo el número ya se comprometió con una interpretación.
Dónde caen el acceso fuera de rango y el desbordamiento
Los arreglos tipados no crecen y no lanzan en un índice más allá de su longitud. La sonda escribe más allá del final y lee más allá del final:
write index 10 on length 3: undefined length=3
Float64Array out-of-range read index 5 -> undefined
Escribir 5 en el índice 10 de un arreglo de longitud 3 no hace nada: la longitud sigue en 3 y el índice se lee como undefined, porque la escritura estaba fuera de la ventana de elementos y se descartó. Una lectura fuera de rango en un Float64Array también devuelve undefined en vez de NaN, porque leer más allá de la longitud no es una lectura numérica. Un analizador que confía en desplazamientos dados por el usuario y escribe en un índice calculado puede por eso perder datos en silencio, con cada llamada exitosa, y solo una comprobación de longitud antes de la escritura lo detecta.
Escribir un valor que no cabe tiene su propio comportamiento, y tres tipos de arreglo muestran tres resultados:
Uint8Array 256 -> 0; Int8Array 200 -> -56
Uint8ClampedArray 300 -> 255
Uint8Array guarda los 8 bits bajos, así que 256 se vuelve 0; Int8Array guarda un valor de 8 bits con signo, así que 200 se vuelve -56. Ambos envuelven módulo el rango del elemento sin error. Uint8ClampedArray limita en vez de envolver, así que 300 se vuelve 255 y un valor negativo se volvería 0. Un búfer de píxeles que espera limitación y recibe un Uint8Array envuelve, así que un valor brillante desborda a uno oscuro, mientras el mismo valor en un Uint8ClampedArray satura a blanco. El tipo de elemento es parte del contrato de datos, y un registro que dice "un arreglo de bytes" sin nombrar si limita o envuelve no ha descrito la aritmética.
Dónde la ventana de una vista y un transfer cambian el origen
Una vista puede cubrir un subrango de un búfer, y un búfer puede transferirse. Ambos cambian qué es el origen, y la sonda mide cada uno:
view window: byteOffset=4 byteLength=4 buffer.byteLength=16
after transfer(4): source.byteLength=0 moved.byteLength=4
source use after detach -> THREW TypeError
La línea de la ventana muestra un Uint8Array construido sobre un búfer de 16 bytes con un desplazamiento de 4 y una longitud de 4. El byteLength de la vista es 4 y su byteOffset es 4, pero el buffer.byteLength subyacente sigue en 16. Un registro que guarda solo la longitud de la vista subestima el búfer, y uno que guarda solo la longitud del búfer sobreestima la vista; los dos números describen ventanas distintas sobre la misma memoria, y ambos son necesarios para localizar los bytes.
La línea del transfer muestra lo que hace. Antes de la llamada el origen es de 8 bytes; tras buf.transfer(4) el byteLength del origen es 0 y el búfer devuelto tiene 4 bytes. El origen queda desprendido, y cualquier uso posterior de una vista sobre él lanza TypeError, que la sonda captura. Un transfer mueve los bytes a un búfer nuevo y deja el antiguo inutilizable, así que el código que sostiene una referencia al búfer viejo y lo lee tras un transfer obtiene una excepción en vez de datos obsoletos. Es un fallo ruidoso y por eso fácil de detectar, pero el código que transfiere un búfer que otra parte del programa todavía espera leer fallará en la siguiente lectura, así que la propiedad de un búfer transferido debe registrarse.
Una frontera relacionada es que la salida del codificador es una vista Uint8Array, no un arreglo normal: TextEncoder.encode("café") devuelve un objeto cuyo byteLength es 5 y que pasa instanceof Uint8Array. Esa vista es la entrada que mide la sección de longitud de arriba, así que el conteo de bytes que un decodificador lee después es el mismo número que un registro debería guardar.
Registra una lectura binaria
Una lectura binaria sostiene una afirmación estrecha: este entorno, este orden de bytes, esta vista y esta entrada produjeron estos números. Seis campos la mantienen verificable, y ninguno guarda un valor que otra vista reinterpretaría:
- El
byteLengthdel búfer y, para una vista, subyteOffsetybyteLength, porque la ventana y el búfer son rangos distintos. - El tipo de elemento de cada vista usada para leer los bytes, porque un búfer lleva 8, 2 o 1 elementos según el tamaño de elemento.
- El orden de bytes del host, porque una vista de arreglo tipado lee el orden nativo mientras un
DataViewtoma una opción explícita. - Si una vista derivada es una copia
sliceo un aliassubarray, porque solo el alias cambia cuando el búfer del origen se reutiliza. - El comportamiento de limitar o envolver del tipo de elemento, porque un valor fuera del rango del elemento o envuelve módulo el rango o satura al límite.
- Si el búfer se transfirió y qué le pasó a su
byteLength, porque un origen desprendido lanza en el uso siguiente en vez de leer bytes obsoletos.
Lo que tal lectura no puede mostrar es nada sobre de dónde vinieron los bytes. Un búfer lo llena algún productor, y quien lo analiza no sabe si el productor escribió UTF-8, una cabecera de red en big-endian o un número serializado en el orden del host. Para el lado de texto de los mismos bytes, TextDecoder y TextEncoder muestra por qué los mismos cuatro bytes UTF-8 decodifican a una cadena bajo una etiqueta y a una cadena mal codificada bajo otra. Para el lado de la copia, structuredClone frente a JSON muestra qué tipos de contenedor sobreviven a una copia profunda y qué colapsa un viaje por JSON, que es la decisión a nivel de contenedor que precede a una lectura a nivel de bytes.
Dos hábitos mantienen la lectura honesta con el tiempo. Primero, registra el tipo de elemento y el orden de bytes junto a los números, porque un entero leído de los mismos bytes difiere bajo cada uno. Segundo, guarda si una vista es una copia o un alias, y compara los bytes en vez de solo el conteo de elementos, porque un alias que apunta a un búfer reutilizado tiene el mismo conteo de elementos que la copia que reemplazó mientras sostiene bytes distintos.
Fuentes públicas
- MDN: ArrayBuffer
- MDN: TypedArray
- MDN: DataView
- MDN: ArrayBuffer.prototype.transfer
- ECMAScript: objetos DataView
- BotBrowser: referencia de consistencia de automatización
Conclusión
Trata la vista como parte del contrato de datos: byteLength cuenta bytes, length cuenta elementos, y un búfer de 8 bytes lleva 8, 2 o 1 elementos según la vista. Sabe que slice copia y subarray comparte, así que un alias guardado muere cuando el búfer del origen se reutiliza. Lee los formatos binarios por DataView con un orden de bytes explícito, no por una vista de arreglo tipado que sigue el orden del host, y registra si el host es little-endian. Espera que una escritura fuera de rango se descarte y que una lectura fuera de rango sea undefined, y espera que Uint8ClampedArray limite donde Uint8Array envuelve. Registra la ventana, el tipo de elemento, el orden de bytes, la elección de copia o alias y el resultado del transfer, y compara los bytes en vez del conteo de elementos para que un alias obsoleto no pase una comprobación verde.
Lectura siguiente
Para qué significan los mismos bytes como texto, lee TextDecoder y TextEncoder; para qué tipos de contenedor sobreviven a una copia profunda antes de que se lea cualquier byte, lee structuredClone frente a JSON.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
TextDecoder y TextEncoder: bytes frente a cadenas
Huella digitalUnicode: cuatro identidades de texto que lee una página
Huella digitalICU: alias de zona horaria y la TZ que informas
Huella digitalbtoa y atob: límites Latin-1 y la verdad sobre el relleno
Huella digitalstructuredClone frente a JSON: qué conserva una copia profunda
Huella digitalFuente aleatoria de crypto-js: qué rama usa tu build
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.