Unicode: cuatro identidades de texto que lee una página
Ejecuta el ICU del host sobre cadenas precompuestas, descompuestas, emoji y hangul para ver las cuatro longitudes que una página lee del mismo texto y por qué falla una clave.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
BotBrowser soporta repetir un fixture autorizado del mismo origen bajo un perfil declarado y conservar observaciones acotadas sobre lo que reporta la página, pero no puede hacer que una página devuelva una cadena canónica sobre la que nunca llamó a normalize(), cambiar qué versión de Unicode trae un ICU concreto, ni hacer que la cuenta de grafemas coincida con la longitud en unidades. Esta revisión ejecuta el ICU del runtime de Node sobre un conjunto fijo de cadenas y reporta cuatro números distintos que una página puede leer para el mismo texto visible: longitud en unidades, cuenta de puntos de código, cuenta de clústeres de grafema y longitud normalizada.
TL;DR
éescrito como un punto de código y comoemás acento combinante no son iguales como cadenas, sí son iguales tras NFC, y producen dos valores distintos deString.length.- Un
Setcon las dos grafías tiene tamaño dos; el mismo conjunto tras NFC tiene tamaño uno, así que una búsqueda por clave puede fallar sobre texto que un lector ve idéntico. - Los emoji agrandan la brecha: un emoji de familia es ocho unidades, cinco puntos y un clúster de grafema.
- Un sustituto suelto falla
isWellFormed()yTextEncoderescribe un carácter de reemplazo, así que una codificación con pérdida es observable sin ningún error. - Colación, capitalización y segmentación dependen del locale que se les pasa, y el
sort()por defecto no usa colador alguno. - Cada número viene de una compilación de ICU y una versión de Unicode; otra compilación puede discrepar.
Contents
- Qué runtime y versión de Unicode usó esta ejecución
- Cuatro longitudes para el mismo texto visible
- Dónde falla una clave sobre texto idéntico
- Dónde un sustituto suelto se vuelve carácter de reemplazo
- Dónde la capitalización cambia la longitud
- Dónde la colación y la segmentación dependen del locale
- Registrar una lectura de texto sin exagerar
Qué runtime y versión de Unicode usó esta ejecución
La sonda imprime el runtime, ICU y Unicode antes de cualquier medición, porque cada número de abajo es una propiedad de ese trío. Esta ejecución informó node=v26.9.0, icu=78.3, unicode=17.0 y tz=2026a. Otra compilación de ICU puede traer otras tablas de capitalización, otra tabla de colación y otro conjunto de reglas de segmentación, así que una lectura sin esas versiones no es reproducible. Esa misma regla de alcance la aplica la revisión de alias de zonas horarias de ICU, donde la cadena resuelta es una búsqueda en una tabla distribuida y no una lectura del reloj.
La versión de Unicode importa más de lo que parece. Nuevas secuencias de emoji, nuevas marcas combinantes y correcciones de propiedades llegan con un salto de versión, y cada una cambia al menos una de las cuatro longitudes de abajo para alguna cadena. Un registro que dice "la página informó longitud 8" sin la versión de Unicode no se puede comparar con otra máquina, porque el mismo texto visible puede ser ocho unidades en una compilación y nueve en otra cuando una secuencia nueva gana una propiedad que cambia su segmentación.
Cuatro longitudes para el mismo texto visible
La primera sonda mide cada cadena de cuatro formas: length cuenta unidades de código UTF-16, [...s].length cuenta puntos de código, un Intl.Segmenter con granularidad de grafema cuenta lo que un lector percibe como un carácter, y normalize('NFC').length cuenta unidades tras composición canónica.
e-acute-precomposed: units=1 points=1 nfc=1 nfd=2 cps=U+00E9
e-acute-decomposed: units=2 points=2 nfc=1 nfd=2 cps=U+0065 U+0301
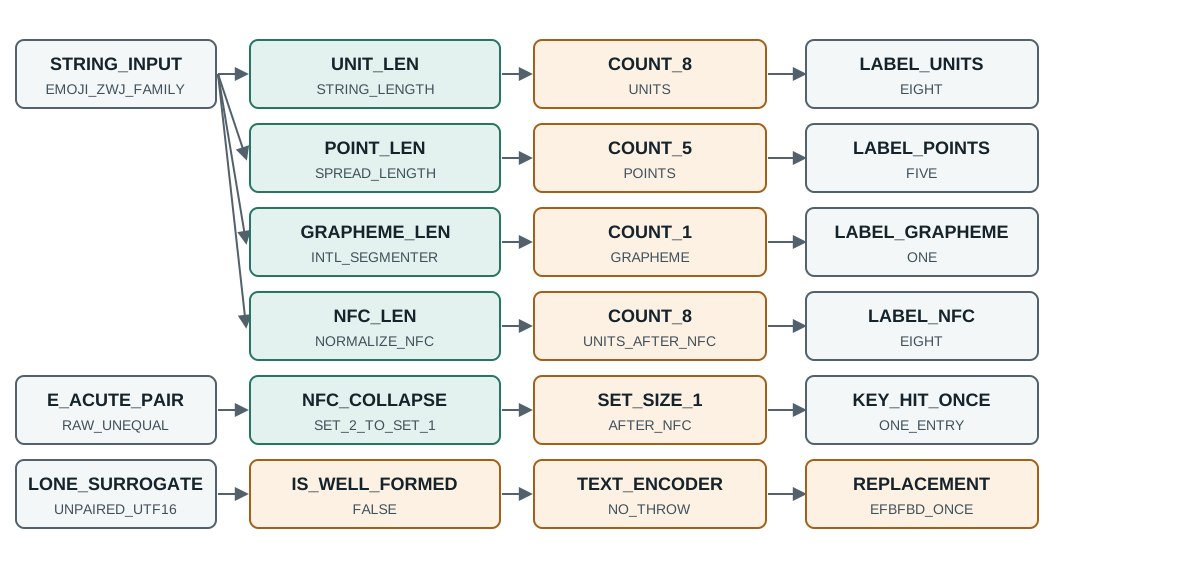
emoji-zwj-family: units=8 points=5 nfc=8 nfd=8 cps=U+1F468 U+200D U+1F469 U+200D U+1F467
emoji-skin-tone: units=4 points=2 nfc=4 nfd=4 cps=U+1F44D U+1F3FD
hangul-syllable: units=1 points=1 nfc=1 nfd=2 cps=U+AC00
hangul-jamo: units=2 points=2 nfc=1 nfd=2 cps=U+1100 U+1161
Seis filas, con cuatro tuplas distintas entre ellas: la fila de é precompuesta y la de hangul precompuesto comparten una, y las dos filas descompuestas comparten otra. Las dos filas de é difieren en unidades y puntos pero coinciden tras NFC, el caso clásico. La fila del emoji de familia muestra la mayor dispersión: ocho unidades, cinco puntos y un grafema. Las filas de hangul muestran que NFC compone dos jamo en una sílaba, así que la longitud normalizada coincide exactamente con la fila precompuesta.
La consecuencia práctica es que "longitud" no es una sola medida. Una página que registra str.length de un nombre visible registra unidades UTF-16, que para un nombre cargado de emoji puede ser el doble de lo que un lector llamaría número de caracteres. Una página que registra [...str].length registra puntos de código, que aún cuentan cinco veces el emoji de familia. Solo el segmentador coincide con el lector.
La cuenta de grafemas es la que coincide con la percepción, y la sonda lo hace explícito:
segmenter graphemes=1 units=8 points=5
segmenter graphemes=1 units=4 points=2
segmenter graphemes=1 units=2 points=2
segmenter graphemes=1 units=4 points=2
Cuatro cadenas distintas, tres cuentas de unidades distintas, un grafema cada una. Un validador que limita un nombre a veinte unidades rechazaría cinco emoji de familia que un humano lee como cinco caracteres; un validador que limita a veinte grafemas los aceptaría y guardaría cuarenta unidades y veinticinco puntos de código. El límite y el lector miden cosas distintas, y ambos son defendibles si el registro dice cuál se usó.
Dónde falla una clave sobre texto idéntico
Las dos filas de é ya implican un modo de fallo, y la segunda sonda lo mide directamente:
NFC equal: true
raw equal: false
name keys equal raw: false | nfc equal: true
Set size with two spellings: 2
Set size after NFC: 1
Dos grafías del mismo nombre son desiguales como cadenas e iguales tras NFC. Metidas en un Set como claves producen dos entradas; mapeadas primero por normalize('NFC') producen una. Ese es todo el mecanismo detrás de una cuenta duplicada que una herramienta de soporte no encuentra, una caché que falla en cada petición porque el cliente manda la otra grafía, y una lista de bloqueo que falla porque la entrada se escribió en un teclado que compone y el tráfico llega de uno que no.
Nada de ese fallo es exótico. Un teclado de macOS suele producir texto descompuesto para letras latinas acentuadas, uno de Windows suele producir texto precompuesto, y un copiar y pegar desde un PDF puede producir cualquiera según el mapeo de glifos de la fuente. Las dos grafías se ven idénticas en pantalla y comparan desigual en todo idioma que compare cadenas por unidad de código.
La solución no es normalizar todo en todas partes, porque NFKC cambia caracteres que algunos sistemas tratan como distintos y la normalización también puede romper una firma exacta en bytes. La solución es normalizar en la frontera donde se decide la identidad: la clave de una búsqueda, el valor de una entrada de caché, la comparación en una comprobación de duplicados. Un registro debería decir qué forma guardó, porque una cadena guardada normalizada no se puede comparar con una que no lo fue sin normalizar otra vez.
Dónde un sustituto suelto se vuelve carácter de reemplazo
La normalización no repara texto inválido. Una cadena con un sustituto suelto no está bien formada, y la sonda muestra la comprobación y la pérdida:
lone-surrogate isWellFormed=false units=3
lone-surrogate bytes=61 ef bf bd 62
replacement count=1
isWellFormed() devuelve false, y TextEncoder escribe ef bf bd en lugar de la unidad mala: un carácter de reemplazo U+FFFD. La codificación no lanza. Una página que envía esa cadena a un servidor envía una cadena distinta de la que tenía, y nada en la llamada informó de la sustitución.
Esa sustitución silenciosa es la razón de que un viaje de ida y vuelta pueda cambiar un valor. Codificar, transmitir, decodificar y el texto devuelto ya no es igual al de entrada, y aun así cada paso tuvo éxito. Un fixture que solo comprueba "la petición se completó" no lo notará; un fixture que compara la cadena antes de codificar con la cadena tras decodificar sí, y la diferencia son exactamente los caracteres de reemplazo.
La sustitución también tiene una consecuencia de conteo fácil de pasar por alto. Una cadena con un sustituto suelto y una cadena con un carácter de reemplazo ocupan ambas tres unidades en la entrada de la sonda, así que una comprobación de longitud pasa mientras el valor difiere. Dos caracteres de reemplazo de dos unidades malas producen una cadena que ya no viaja de ida y vuelta, y un ciclo repetido de codificar y decodificar no añade más reemplazos, lo que significa que un fixture que codifica dos veces y compara da un falso aprobado sobre datos que ya eran con pérdida en la primera pasada.
Dividir cadenas es la forma más común de crear esta figura por accidente. Cortar una cadena de tres unidades en el índice dos, o tomar las primeras cuatro de una de cinco, puede partir un par sustituto y dejar una mitad suelta. La cadena resultante sigue siendo una cadena JavaScript válida de la longitud esperada, así que nada lanza; solo isWellFormed() o una comparación de bytes tras codificar lo revela. Un fixture que trunca texto de usuario a un presupuesto de visualización sin comprobar la frontera producirá exactamente este defecto en cualquier entrada con un carácter no BMP cerca del corte.
Dónde la capitalización cambia la longitud
El mapeo de mayúsculas no es una sustitución por carácter que preserve longitud, y tres caracteres comunes muestran tres comportamientos distintos:
case "ß" upper="SS" upperUnits=2 lower="ß" lowerUnits=1
case "İ" upper="İ" upperUnits=1 lower="i̇" lowerUnits=2
case "Dž" upper="DŽ" upperUnits=1 lower="dž" lowerUnits=1
La eszett alemana se expande a dos letras en mayúscula. La I mayúscula con punto turca conserva una unidad en mayúscula pero se expande a dos en minúscula en un locale inglés, porque la forma minúscula es i más un punto combinante. El dígrafo titulcase cambia un carácter por otro sin cambiar la longitud. Tres caracteres, tres resultados, y solo uno preserva el conteo de unidades.
Un sistema que guarda una clave insensible a mayúsculas pasando a mayúscula cambiará por tanto la longitud de algunos identificadores, y un sistema que impone un máximo de longitud antes de capitalizar puede rechazar un identificador que se vuelve más largo después. Ambos son fáciles de arreglar una vez conocida la expansión, y ambos son invisibles si la única entrada de prueba es ASCII.
La dimensión de locale empeora esto de una forma fácil de pasar por alto, porque la misma letra mapea distinto según el locale que se pase:
case "I" lower(tr)="ı" upper(tr)="I" lower(en)="i"
case "i" lower(tr)="i" upper(tr)="İ" lower(en)="i"
case "İ" lower(tr)="i" upper(tr)="İ" lower(en)="i̇"
case "ı" lower(tr)="ı" upper(tr)="I" lower(en)="ı"
En turco I pasa a minúscula como ı sin punto e i pasa a mayúscula como İ con punto, mientras en inglés ambas mapean al par habitual. La tercera fila es la más nítida: İ pasa a minúscula como una unidad en turco y como dos en inglés. Una comparación insensible a mayúsculas que fija un locale obtiene un comportamiento; una que confía en el locale por defecto obtiene el que eligió el runtime, que puede diferir del que reporta el perfil.
El texto también llega a una página a través de una pila de fuentes antes de que ninguno de estos conteos importe, y la misma cadena puede medir distinto cuando los glifos vienen de otra cara. Renderizado de fuentes CJK cubre cómo la pila cambia la medición, y datos de locale de la API Intl y formato portable cubre el lado de formato de la misma dependencia del locale que trata esta sección.
Dónde la colación y la segmentación dependen del locale
Ordenar es un tercer lugar donde el locale cambia la respuesta, y la sonda muestra tres órdenes distintos para las mismas cuatro palabras:
sort en: apple < äpple < zebra < Zebra
sort sv: apple < zebra < Zebra < äpple
sort default: Zebra < apple < zebra < äpple
en compare zebra/Zebra: -1
El inglés coloca äpple justo después de apple, el sueco lo coloca al final porque ä es una letra separada después de z, y el orden por defecto coloca Zebra primero porque compara unidades de código y la Z mayúscula ordena antes que la a minúscula. Una lista que una página renderiza ordenada diferirá por tanto entre dos sesiones que solo difieren en locale, y una comparación de capturas de esa lista reportará una diferencia que es enteramente colación.
El mismo comparador también decide igualdad cuando un mapa tiene claves de texto ordenado, porque Intl.Collator devuelve cero para cadenas que la comparación por defecto trata como distintas. La sonda también lo mide, en cuatro niveles de sensibilidad:
sensitivity base: e-acute vs e=0 a vs A=0
sensitivity accent: e-acute vs e=1 a vs A=0
sensitivity case: e-acute vs e=0 a vs A=-1
sensitivity variant: e-acute vs e=1 a vs A=-1
En sensibilidad base ambos pares comparan iguales, así que una clave construida con ese comparador fusionaría é con e y a con A. En sensibilidad de acento los dos pares se separan en direcciones opuestas. Una función de "detección de duplicados" construida sobre un colador con la sensibilidad equivocada fusiona o separa exactamente los casos que debía manejar, y el ajuste es invisible en la salida.
La segmentación de palabras añade otro número que discrepa con el tokenizador obvio:
word segments=5 ["Version","155.0.0","ships","café","file"]
whitespace tokens=6 vs segmenter words=5
Dividir por espacios da seis tokens mientras el segmentador da cinco segmentos tipo palabra, y toda la diferencia es el dígito circulado ①, que el segmentador marca con isWordLike falso. Quitarlo hace que ambas cuentas sean cinco, y cambiar la ligadura fi por f también deja ambas en cinco, así que la ligadura no es la causa. Una "cuenta de palabras" registrada en un fixture depende por completo de qué método la produjo.
La colación numérica es el último interruptor que cambia el orden, y lo cambia sustancialmente:
numeric on: 1.2.0 < 1.9.0 < 1.10.0
numeric off: 1.10.0 < 1.2.0 < 1.9.0
Con comparación numérica activada, las versiones ordenan como espera una página de lanzamientos. Sin ella ordenan como texto, y 1.10.0 va antes que 1.2.0. Una lista de versiones ordenada con un comparador sin la opción numérica se ve mal a cualquier lector y sigue siendo internamente consistente, lo que la hace difícil de detectar en un diff.
Registrar una lectura de texto sin exagerar
Una lectura de texto soporta una afirmación estrecha: este runtime, este ICU, esta versión de Unicode y este locale, con esta entrada, produjeron estos cuatro números. No dice que un lector vea lo mismo, que otra compilación coincida ni que un servidor normalizara la cadena igual.
Guarda seis campos y el registro sigue siendo comprobable. Las versiones de runtime, ICU y Unicode, porque las tablas de capitalización, colación y segmentación vienen con ellas. La entrada tal como se aportó, idealmente como puntos de código y no como texto renderizado, porque dos entradas pueden verse idénticas. Las cuatro longitudes, con el método nombrado para cada una. El locale y la sensibilidad del colador, porque ambos cambian la respuesta. La forma de normalización aplicada en la frontera. Y si la ruta del codificador produjo un carácter de reemplazo, porque esa sustitución cambia el valor sin error.
La página de docs correspondiente cubre cómo BotBrowser alinea las superficies de fuentes y navigator con el perfil cargado. Esta revisión añade el lado de la lectura: qué hace el runtime con el texto que esas superficies llevan, cuál de las cuatro longitudes devuelve cada API y dónde un locale decide una comparación que un lector supone fija. Configuración consistente y lectura correcta de la cadena resultante son preguntas separadas.
Para cualquier decisión sobre una sesión real, usa un resultado de integración autorizado del sistema que decide en lugar de extrapolar desde esta sonda. Una longitud registrada en un fixture y un veredicto de producción son tipos distintos de evidencia.
Practical conclusion
Registra las versiones de runtime, ICU y Unicode, la entrada como puntos de código, las cuatro longitudes con sus métodos, el locale y la sensibilidad del colador, la forma de normalización en la frontera, y si el codificador escribió un carácter de reemplazo. En esta compilación é tiene dos cuentas de unidades distintas, un conjunto de dos entradas colapsa a una tras NFC, un emoji de familia es ocho unidades y un grafema, un sustituto suelto se codifica como un carácter de reemplazo sin error, la capitalización puede duplicar una longitud, y el orden de colación cambia con el locale.
Sources
- MDN: String.prototype.normalize
- MDN: Intl.Segmenter
- MDN: Intl.Collator
- Unicode Standard Annex 15: formas de normalización
- Unicode Standard Annex 29: segmentación de texto
- MDN: TextEncoder
- Documentación de fuentes de BotBrowser
Next reading
Usa renderizado de fuentes CJK para cómo el mismo texto mide distinto según la pila de fuentes, y datos de locale de la API Intl y formato portable para el lado de formato de la misma dependencia del locale.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
ICU: alias de zona horaria y la TZ que informas
Huella digitalua-parser-js: Client Hints, bots y un tope de 500
Huella digitalReproducibilidad de la semilla de ruido en ejecuciones repetibles
Huella digitalCómo hardwareConcurrency revela los núcleos reales de tu CPU
Huella digitalFingerprinting por medicion de texto: rastreo subpixel
Huella digitalModo determinista: huellas reproducibles del navegador
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.